NVIDIA DGX B300 представляет собой готовый 10U AI-сервер на восьми GPU B300 Blackwell Ultra. В актуальном руководстве системы указано 288 GB HBM3e на каждый ускоритель, всего 2 304 GB GPU-памяти, два Intel Xeon Platinum 6776P, 2 TB оперативной памяти с расширением до 4 TB, восемь ConnectX-8, два BlueField-3 DPU и локальная NVMe-подсистема.
Главное отличие DGX B300 от обычного сервера с восемью видеокартами состоит не в логотипе на корпусе. NVIDIA поставляет согласованную аппаратную и программную систему: B300, NVLink, NVSwitch, CPU, RAM, storage, сеть, BMC, firmware, DGX OS и средства диагностики проверяются как единая конфигурация. За это заказчик платит фиксированностью архитектуры и меньшей свободой кастомизации по сравнению с OEM-сервером на HGX B300.
Система рассчитана на крупное обучение и дообучение моделей, высоконагруженный LLM-инференс, reasoning workloads, рекомендательные модели, аналитику и подходящие GPU-ускоренные HPC-задачи. Покупать ее только ради максимальной цифры PFLOPS не стоит. До выбора нужно подтвердить, что workload использует восемь GPU, помещается в 2,3 TB HBM3e, получает выигрыш от NVLink и не упрется в сеть, storage либо инфраструктуру ЦОД.
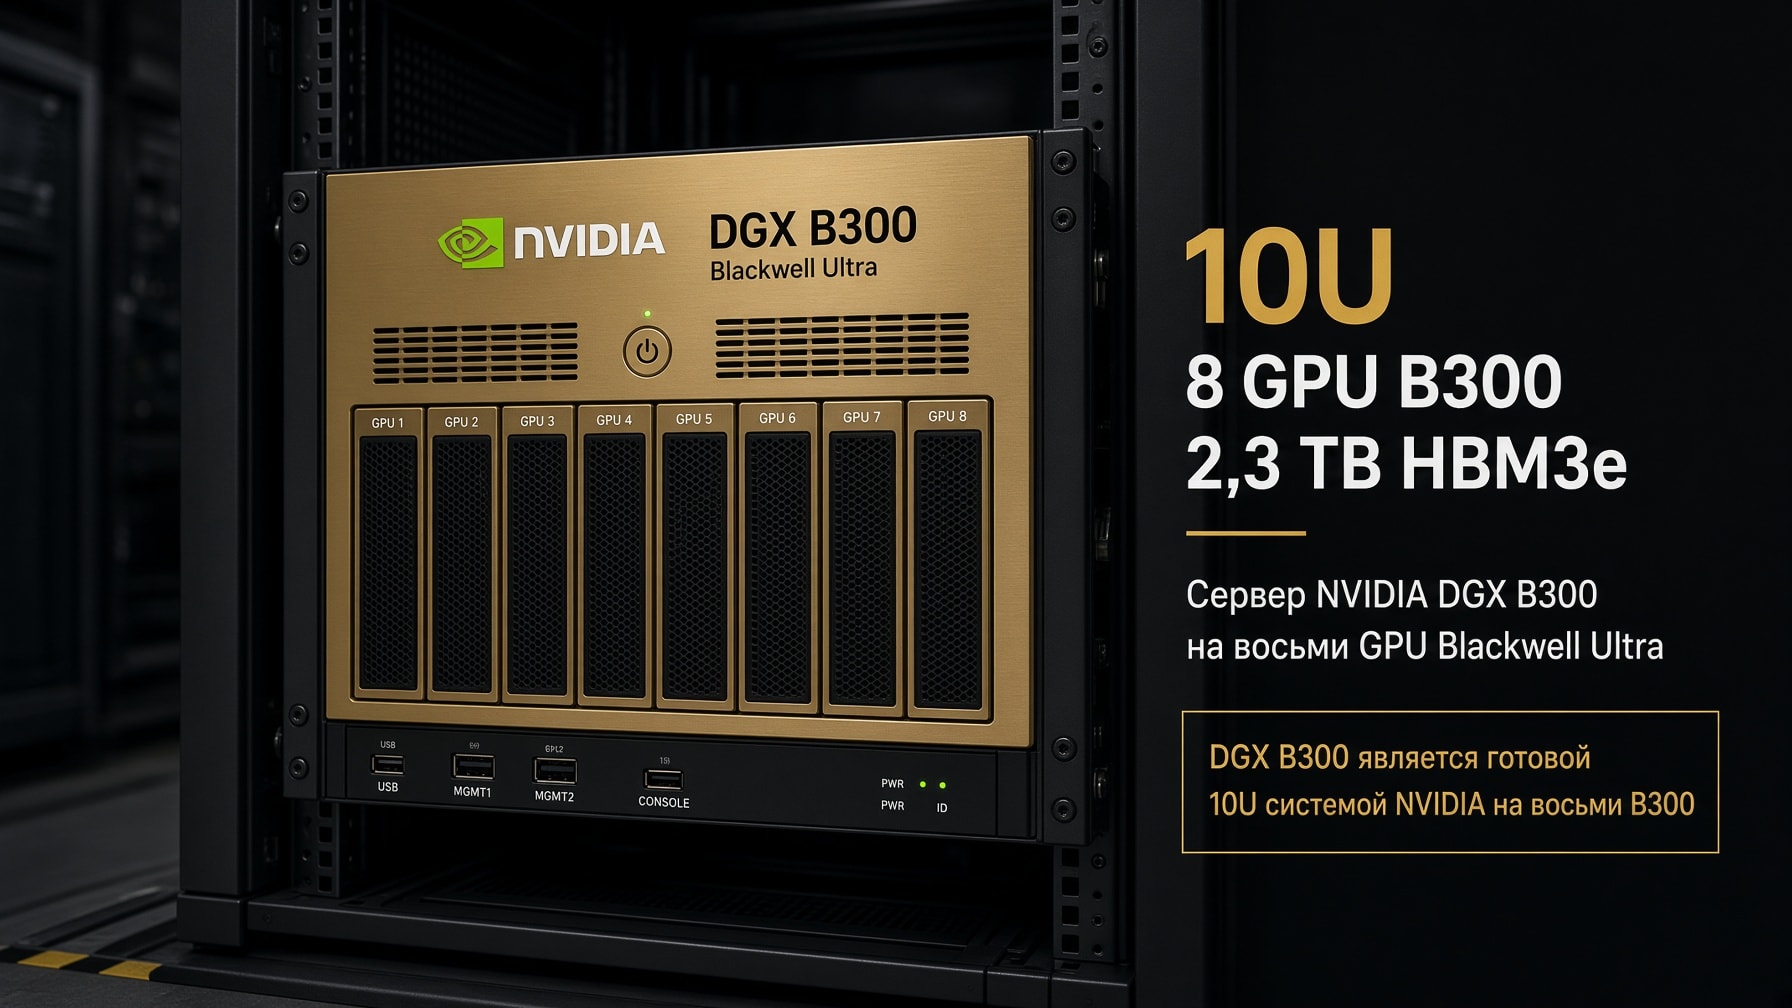
Что такое NVIDIA DGX B300
DGX B300 является x86-системой NVIDIA для обучения, инференса и аналитики. Ее вычислительный модуль построен на восьми B300 SXM, соединенных NVLink пятого поколения и NVSwitch. Хостовая часть использует два Intel Xeon, системную DDR5-память и NVMe. Сетевой контур разделен между ConnectX-8 для масштабирования вычислений, BlueField-3 для storage и management traffic, а также отдельным BMC-интерфейсом для управления сервером.
Название важно читать по уровням:
B300обозначает отдельный GPU Blackwell Ultra;HGX B300обозначает восьми-GPU базовую платформу с NVLink и NVSwitch для интеграции в сервер;DGX B300обозначает законченную систему NVIDIA с фиксированными CPU, RAM, NVMe, сетью, корпусом и программным стеком;GB300относится к Superchip с Grace CPU и B300, это другая архитектурная ветвь.
Что входит в готовую систему
В поставляемую конфигурацию входят:
8 GPU NVIDIA B300 Blackwell Ultra в форм-факторе SXM;
два NVLink Switch System для объединения GPU;
2 процессора Intel Xeon Platinum 6776P;
2 TB RAM по умолчанию, поддерживается расширение до 4 TB;
8 накопителей E1.S NVMe по 3,84 TB для cache;
2 загрузочных M.2 NVMe по 1,92 TB;
8 сетевых адаптеров ConnectX-8 с OSFP;
2 двухпортовых BlueField-3 DPU;
отдельные интерфейсы host management и BMC;
DGX OS 7 и компоненты NVIDIA для управления, диагностики, контейнеров и сети;
10U корпус с AC/PDU либо DC/busbar питанием в зависимости от варианта.
Сетевые кабели и адаптеры в систему не входят. Их подбирают отдельно по прошивке ConnectX-8, типу fabric, разъемам коммутатора, длине линии и списку поддерживаемых NVIDIA компонентов.
Характеристики NVIDIA DGX B300
Параметр | Спецификация DGX B300 | Что учитывать при проектировании |
|---|---|---|
GPU | 8 x NVIDIA B300 Blackwell Ultra SXM | фиксированная восьми-GPU конфигурация |
GPU-память | 8 x 288 GB HBM3e, всего 2 304 GB | в другой публичной таблице NVIDIA встречается 2,1 TB, точный SKU нужно закрепить в договоре |
Заявленная tensor performance | 72 PFLOPS FP8 для training, 144 PFLOPS FP4 для inference | это спецификация вычислительного формата, а не скорость конкретной модели |
GPU interconnect | NVLink пятого поколения, 2 x NVLink Switch System | один высокоскоростной scale-up домен внутри узла |
Совокупная полоса NVLink | 14,4 TB/s | не равна полосе внешней сети и не гарантирует линейное ускорение workload |
CPU | 2 x Intel Xeon Platinum 6776P | CPU обслуживают host code, preprocessing, I/O, orchestration и часть коммуникаций |
Системная RAM | 2 TB по умолчанию, до 4 TB | расширение выполняют поддерживаемыми 128 GB DIMM с корректной population |
Cache storage | 8 x 3,84 TB E1.S NVMe SED | 30,72 TB raw до RAID, файловой системы и резерва |
Boot storage | 2 x 1,92 TB M.2 NVMe | загрузочный контур можно организовать как software RAID 1 |
Compute network | 8 x ConnectX-8, 8 x OSFP, до 800 Gb/s InfiniBand или Ethernet на интерфейс | нужны совместимые кабели, коммутаторы и спроектированная topology |
Storage и management network | 2 x dual-port BlueField-3 DPU, в сводке указано 2 x 400 Gb/s InfiniBand или Ethernet | режим по умолчанию для BlueField-3 в DGX: NIC mode |
Удаленное управление | BMC, отдельный 1GbE RJ-45, KVM, remote storage, Redfish и IPMI | management network проектируют отдельно от compute fabric |
Операционная система | DGX OS 7 на Ubuntu 24.04 LTS | минимальный DGX OS ISO для DGX B300 2,3 TB: 7.3.0 |
Форм-фактор | 10U | проверяют доступную высоту, глубину, rails, сервисные зоны и нагрузку на стойку |
Размеры | 442 x 482,6 x 904,2 mm | глубина 904,2 mm без учета кабельных радиусов и сервисного пространства |
Масса системы | 168 kg для AC/PSU, 123 kg для DC/busbar | масса стойки и пола рассчитывается вместе с PDU, кабелями и остальным оборудованием |
Питание | 200-240 V AC либо 54 V DC busbar | варианты нельзя считать взаимозаменяемыми без проекта стойки |
Потребление | 14,5 kW в эксплуатационной таблице, до 15 kW system max в разделе питания | электрика и охлаждение проектируются по верхней границе с требуемым резервом |
Блоки питания AC | 12 PSU, схема N+N | для штатной эксплуатации требуются минимум 6 рабочих PSU, слоты нельзя оставлять пустыми |
Тепловыделение | до 49 476 BTU/h | значение используют как исходное для HVAC, затем проверяют фактический режим |
Температура входящего воздуха | 10-30 °C | контролируется температура именно на входе системы |
Воздушный поток при 70% PWM | 1 500 CFM для AC, 1 350 CFM для busbar | стойка и холодный коридор должны обеспечивать нужный поток без рециркуляции |
Почему в источниках встречаются 2,1 и 2,3 TB
На публичной продуктовой странице NVIDIA для DGX B300 указано 2,1 TB общей GPU-памяти. Актуальное руководство конкретной системы приводит 8 x 288 GB, то есть 2 304 GB, и именно вариант DGX B300 2.3 TB присутствует в таблице поддержки DGX OS 7.
Редакционно корректно не усреднять эти цифры и не объявлять одну опечаткой без официального разъяснения. При подготовке закупки нужно закрепить:
полный manufacturer part number;
объем HBM3e каждого GPU;
суммарную установленную память;
данные, которые показывает
nvidia-smiпосле ввода системы;версию DGX OS, driver, firmware и CUDA stack;
критерий приемки при несовпадении спецификации и фактической конфигурации.
Для оценки memory budget используйте именно доступную память целевого SKU. Общая методика расчета весов, activations и KV-cache приведена в статье сколько VRAM нужно для AI, LLM и обучения.
Как устроена DGX B300
Архитектуру удобно рассматривать как шесть связанных контуров: GPU compute, scale-up interconnect, host, local storage, внешняя сеть и управление. Ошибка в любом из них способна оставить дорогие GPU без данных или затруднить эксплуатацию.
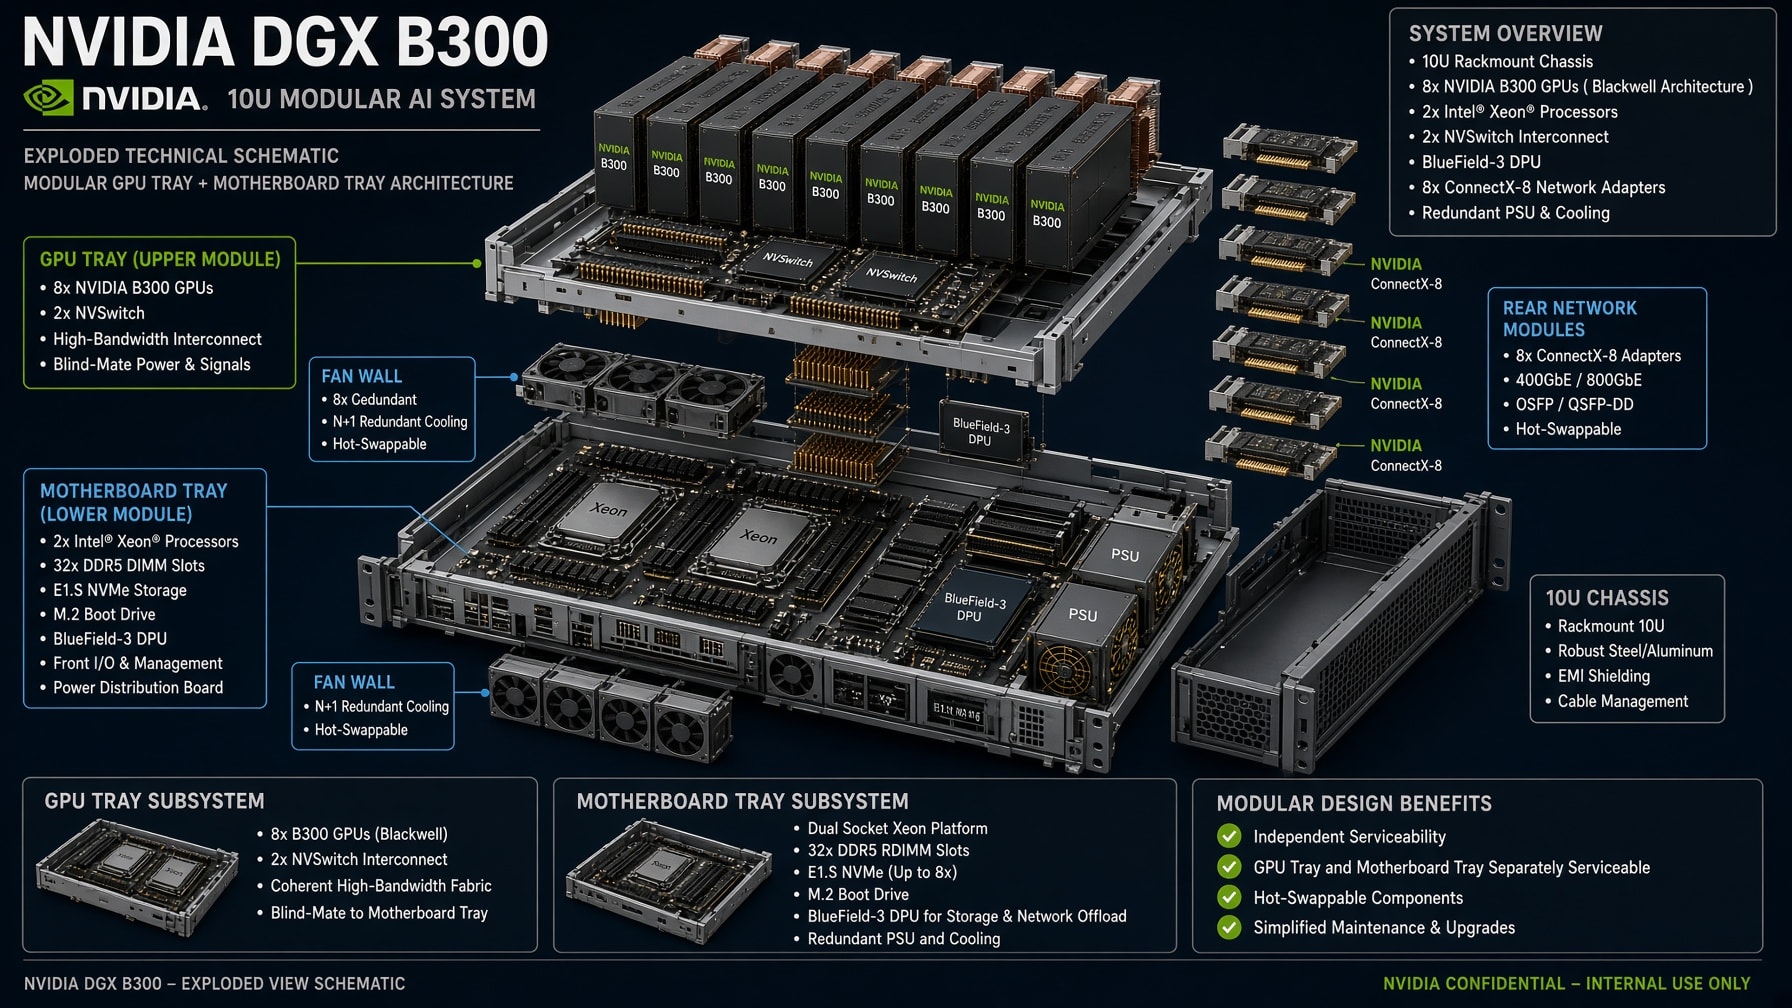
Восемь B300 Blackwell Ultra
Каждый B300 предоставляет 288 GB HBM3e в конфигурации, указанной руководством DGX B300. Восемь GPU дают большой общий memory pool для распределенного workload, но это не единая автоматически общая память. Framework по-прежнему распределяет weights, activations, gradients, optimizer states или KV-cache между устройствами.
Выигрыш зависит от схемы параллелизма:
tensor parallelism интенсивно использует обмен внутри слоя;
pipeline parallelism передает activations между стадиями;
expert parallelism создает характерный all-to-all traffic;
data parallelism синхронизирует gradients между replicas;
inference replicas могут почти не обмениваться данными, если каждая модель помещается на своей группе GPU.
NVLink и NVSwitch
Пятый NVLink и два NVLink Switch System объединяют восемь B300 в высокоскоростной GPU-домен с совокупной полосой 14,4 TB/s. Это внутренний scale-up fabric одного узла. Он используется для GPU-to-GPU traffic, но не заменяет InfiniBand или Ethernet между серверами.
Разделение принципиально:
Уровень | Технология в DGX B300 | Что переносит |
|---|---|---|
Внутри GPU | HBM3e | веса, activations, cache и рабочие буферы конкретного GPU |
Между 8 GPU узла | NVLink и NVSwitch | tensor, pipeline, expert и другие GPU-to-GPU обмены |
Между DGX-узлами | ConnectX-8 через InfiniBand или Ethernet | distributed collectives и межузловой RDMA traffic |
Storage и service traffic | BlueField-3 и отдельная инфраструктура | доступ к данным, сервисные и инфраструктурные потоки |
Out-of-band управление | BMC 1GbE | питание, health, KVM, Redfish и IPMI |
Модель может хорошо масштабироваться на восьми GPU внутри одного DGX и плохо масштабироваться на 16 либо 32 GPU, если межузловой collective становится критическим путем. Поэтому переход к нескольким DGX требует отдельного network benchmark.
Два Intel Xeon и системная память
DGX B300 использует два Intel Xeon Platinum 6776P. CPU не выполняют основную матричную работу модели, но участвуют в подготовке данных, decompression, tokenization, host-side runtime, storage I/O, networking, orchestration и задачах управления.
Система поставляется с 2 TB RAM и поддерживает до 4 TB. Больший объем нужен не автоматически. Его обосновывают через:
CPU-side preprocessing и dataset cache;
memory mapping крупных наборов данных;
staging checkpoints;
большое число параллельных workers;
retrieval, feature processing или симуляцию рядом с GPU workload;
требования конкретной distributed runtime.
Локальные E1.S и загрузочные M.2
Восемь E1.S NVMe SED по 3,84 TB дают 30,72 TB raw cache capacity. Два M.2 по 1,92 TB предназначены для загрузочного контура. Эти группы решают разные задачи, и объединять их в одну цифру дисковой емкости неправильно.
Типичная логика размещения выглядит так:
M.2: операционная система и системные разделы, обычно с software RAID 1;
E1.S: локальный dataset cache, промежуточные данные, staging и временные checkpoints;
внешняя СХД: исходные датасеты, общие checkpoints, model registry, архив и совместный доступ нескольких узлов.
Cache drives можно конфигурировать, например, через RAID 0 или RAID 5, если это соответствует режиму и политике надежности. RAID 0 увеличивает доступную емкость и throughput, но потеря одного накопителя разрушает массив. Он приемлем только для воспроизводимого cache. Уникальные checkpoints требуют защищенного локального или внешнего размещения.
Локальные 30,72 TB не отменяют проектирование общей системы хранения данных. Для кластера важны aggregate throughput, metadata performance, число одновременных readers, checkpoint bursts, сеть хранения и время восстановления после сбоя.
ConnectX-8 и BlueField-3
В DGX B300 восемь ConnectX-8 подключены к GPU через PCIe Gen6. NVIDIA вынесла compute network interfaces в GPU tray и разместила восемь OSFP на передней стороне системы. Каждый интерфейс поддерживает до 800 Gb/s InfiniBand или Ethernet, но скорость приложения зависит от кабелей, switch fabric, breakout, rails, oversubscription и GPU-to-NIC mapping.
Два двухпортовых BlueField-3 DPU обслуживают storage и management networks. В DGX по умолчанию они работают в NIC mode. Переход в DPU mode является отдельным эксплуатационным решением и требует проверки software stack, provisioning и ответственности команды.
Восемь портов по 800 Gb/s дают 6,4 Tb/s номинальной суммы line rate, но складывать их в обещание приложению нельзя. Данные распределяются по rail topology, а результат NCCL зависит от collective, message size, congestion и числа узлов. Методика sizing разобрана в материале как выбрать сеть 100, 200 или 400 Гбит/с для GPU-кластера, где 800G рассматривается как отдельный современный класс соединений.
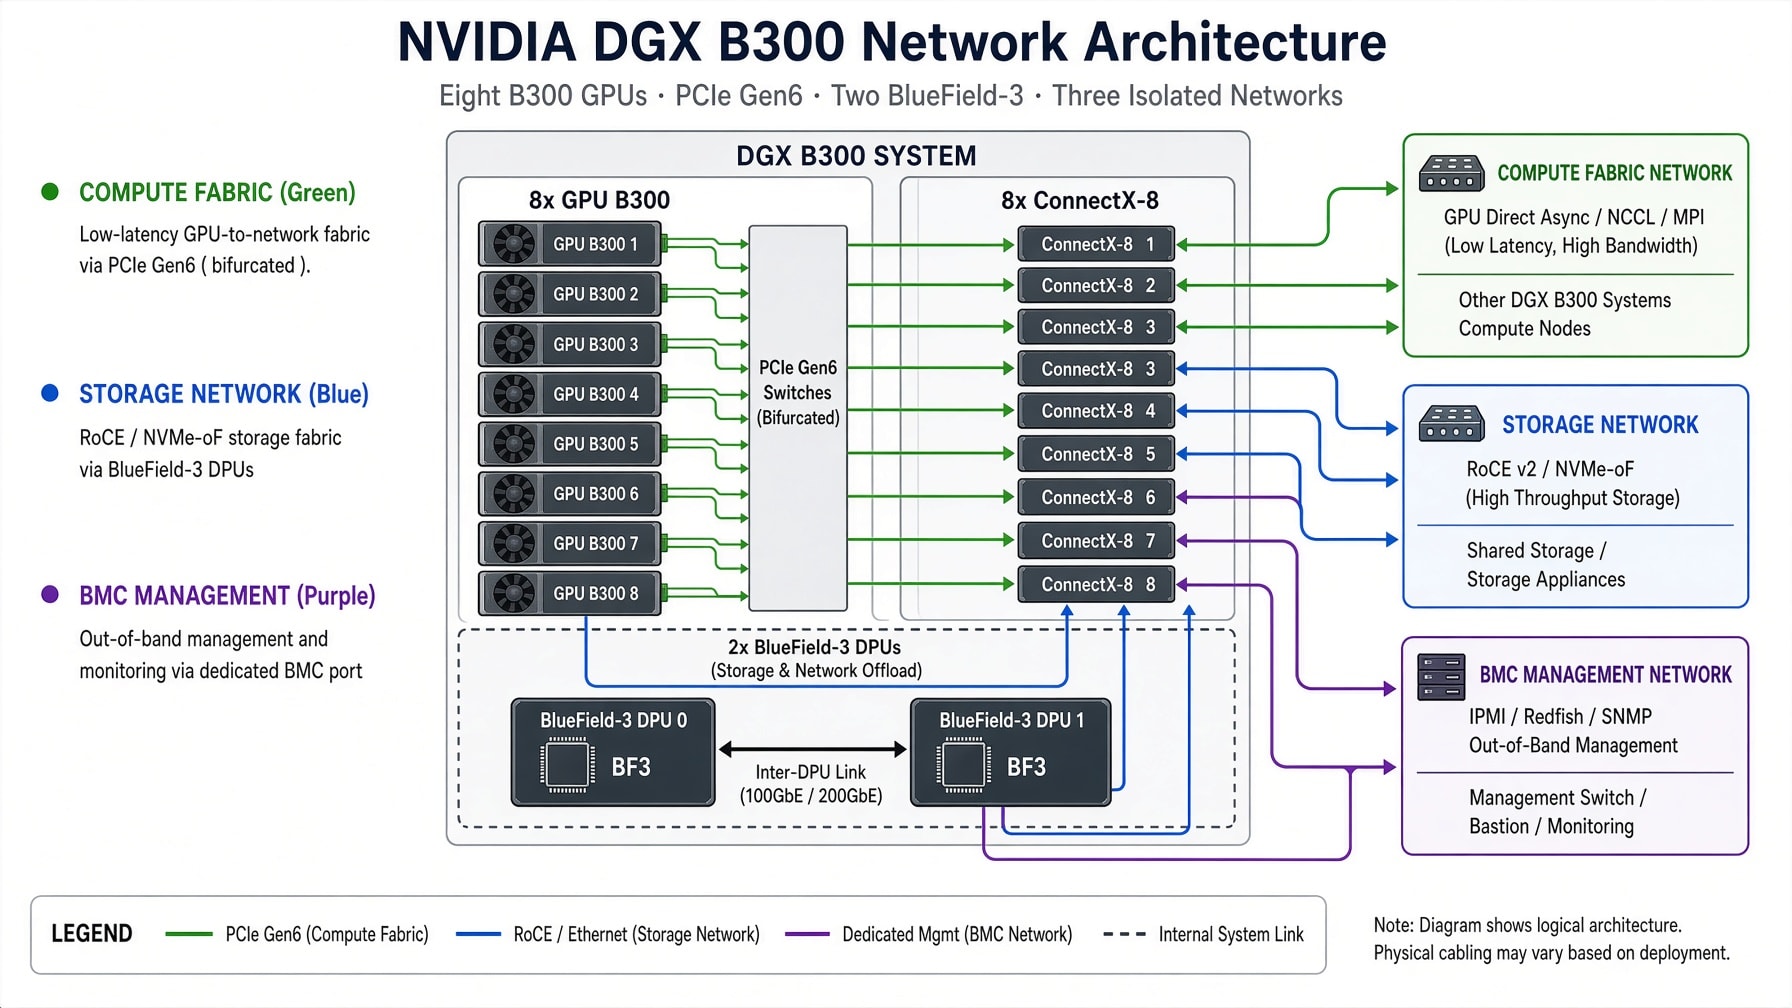
BMC и сервисная архитектура
Для удаленного управления доступны BMC, отдельный 1GbE RJ-45, KVM, remote storage, Redfish и IPMI. Motherboard tray и GPU tray установлены на направляющих, а вентиляторы доступны для обслуживания. Модульность сокращает время некоторых сервисных операций, но не превращает 168-килограммовую систему в оборудование, которое можно перемещать без процедуры и подготовленного персонала.
Программный стек DGX B300
DGX B300 поставляется с DGX OS 7 на базе Ubuntu 24.04 LTS. Это не отдельный несовместимый Linux, а поддерживаемая NVIDIA конфигурация с системными оптимизациями, драйверами, диагностикой и репозиториями для DGX.
Предустановленный стек включает:
оптимизированную серверную Ubuntu и системные пакеты DGX;
NVIDIA GPU driver и CUDA components;
NVIDIA System Management, или NVSM;
Data Center GPU Manager, или DCGM;
Docker Engine;
NVIDIA Container Toolkit;
DOCA-OFED для сетевых адаптеров;
NVIDIA Networking Software Tools, или MST;
cachefilesdдля управления cache data;пакеты поддержки конкретной системы.
Как выбирать версию ОС и драйверов
Минимальный DGX OS ISO для варианта DGX B300 2,3 TB указан как 7.3.0. Это нижняя граница совместимости, а не рекомендация устанавливать именно эту версию на новый сервер. На дату развертывания выбирают текущий поддерживаемый release с учетом driver, CUDA, framework, container, firmware и известных ограничений.
Для B300 связанные компоненты NVLink fabric нельзя обновлять независимо по принципу новее всегда лучше. Driver, Fabric Manager, NVLink Subnet Manager и связанные библиотеки должны образовывать поддерживаемый набор. Перед production-обновлением проверяют:
матрицу совместимости DGX OS и firmware;
CUDA runtime внутри контейнера и host driver;
версии PyTorch, TensorRT-LLM, vLLM или другого runtime;
NCCL и сетевой стек;
сторонние kernels, quantization libraries и extensions;
rollback plan и сохранение диагностических данных;
smoke test, GPU diagnostics, network benchmark и workload regression.
Принцип работы CUDA и значение compute capability для B300 раскрыты в статье CUDA: что это и какие GPU поддерживает. Для B300 NVIDIA указывает compute capability 10.3, поэтому готовые binaries и extensions должны содержать совместимый код.
Можно ли использовать другую ОС
Руководство системы указывает поддержку DGX OS 7, Ubuntu, Red Hat Enterprise Linux 8 и 9, а также Rocky Linux. Сам факт поддержки дистрибутива не означает, что произвольная комбинация kernel, driver, OFED и firmware будет эквивалентна DGX OS.
Другая ОС оправдана, если у организации есть обязательный корпоративный baseline, автоматизированное развертывание или требования безопасности. Тогда в проект включают установку DGX software stack, проверку репозиториев, hardware management, network stack и процедуру поддержки. Для air-gapped площадки заранее готовят mirror, container registry, ключи, пакеты обновления и перенос диагностических bundle.
Для каких задач подходит DGX B300
Обучение и дообучение крупных моделей
Восемь B300 и 2,3 TB HBM3e позволяют размещать крупный распределенный training state внутри одного узла. Практическая емкость зависит от precision, optimizer, activations, gradient checkpointing, sequence length и схемы параллелизма. Нельзя оценивать допустимый размер модели только делением 2,3 TB на число байт одного параметра.
Для multi-node training существенны уже два fabric:
NVLink и NVSwitch внутри DGX;
ConnectX-8 и внешняя InfiniBand либо Ethernet fabric между DGX.
LLM-инференс и reasoning
Большая HBM3e полезна для крупных weights, длинного контекста, KV-cache и высокой concurrency. FP4 ориентирован на inference, но применимость конкретной точности проверяется по качеству модели, поддержке runtime и latency SLA.
Для инференса нужно зафиксировать минимум:
точную модель и revision;
формат weights и quantization method;
context length distribution;
число одновременных sequences;
target TTFT, inter-token latency и throughput;
tensor и pipeline parallel size;
prefix cache, speculative decoding и batching policy;
запас памяти на runtime и фрагментацию.
Одна большая модель может использовать все восемь GPU. Другой сервис эффективнее разложить на несколько независимых replicas. Паспортная FP4 performance не подсказывает, какой вариант даст лучший business throughput.
Рекомендательные системы, аналитика и HPC
DGX B300 применим к workloads с интенсивными матричными вычислениями, крупными embeddings, графовой аналитикой и GPU-ускоренными научными кодами. Но слово HPC не гарантирует соответствие. Для приложения могут быть критичны FP64, memory bandwidth, CPU-to-GPU path, MPI, storage latency или лицензирование коммерческого solver.
Когда DGX B300 избыточна
Система, скорее всего, избыточна, если:
модель и требуемая concurrency уверенно помещаются на одном или двух меньших GPU;
приложение не умеет использовать multi-GPU;
latency определяется внешней базой данных или API;
объем данных мал, а GPU большую часть времени простаивают;
нужен тестовый контур, который выгоднее запустить на менее дорогой платформе;
площадка не поддерживает 15 kW на узел и соответствующий отвод тепла;
команда не готова эксплуатировать RDMA fabric, контейнерный стек и системную телеметрию;
требуются другие CPU, объем локальных дисков или форма сервера, недоступные в фиксированном DGX.
Выбор начинается не с бренда системы, а с профиля нагрузки. Пошаговый переход от модели и SLA к GPU, VRAM, RAM, storage и сети дан в материале как выбрать сервер для ИИ.
Требования к стойке, питанию и охлаждению
DGX B300 занимает 10U, но высота является только первым ограничением. AC-версия весит 168 kg, имеет глубину 904,2 mm, потребляет 14,5 kW по эксплуатационной таблице и до 15 kW по power specification. Максимальное тепловыделение указано как 49 476 BTU/h.
AC или DC busbar
Доступны два варианта:
Вариант | Подключение | Что нужно на площадке | Особенность |
|---|---|---|---|
AC/PSU | 200-240 V AC, 12 входов питания | подходящие PDU, разнесенные power feeds, розетки и расчет токов | внутри установлены 12 PSU с N+N redundancy |
DC/busbar | 54 V DC | совместимая rack busbar и внешние power shelves | power shelves не входят в DGX и проектируются как часть стойки |
В AC-версии NVIDIA требует не эксплуатировать систему с вынутыми PSU. Для полной штатной N+N схемы используются все 12 блоков. Минимум шесть должны быть рабочими для требуемой эксплуатации, а отказавший модуль следует заменить без затягивания. Тот факт, что BMC или система способны частично запускаться при меньшем числе PSU, не является допустимым production design.
Почему нельзя считать только юниты
В 42U стойку геометрически помещаются четыре системы по 10U. Это не означает, что такая стойка готова к четырем DGX B300. Только серверы дадут:
до 60 kW system max;
672 kg массы для четырех AC-систем без учета стойки, PDU, кабелей и сетевого оборудования;
до 6 000 CFM по опубликованному воздушному потоку при 70% PWM;
32 compute network connections ConnectX-8 плюс storage и management links.
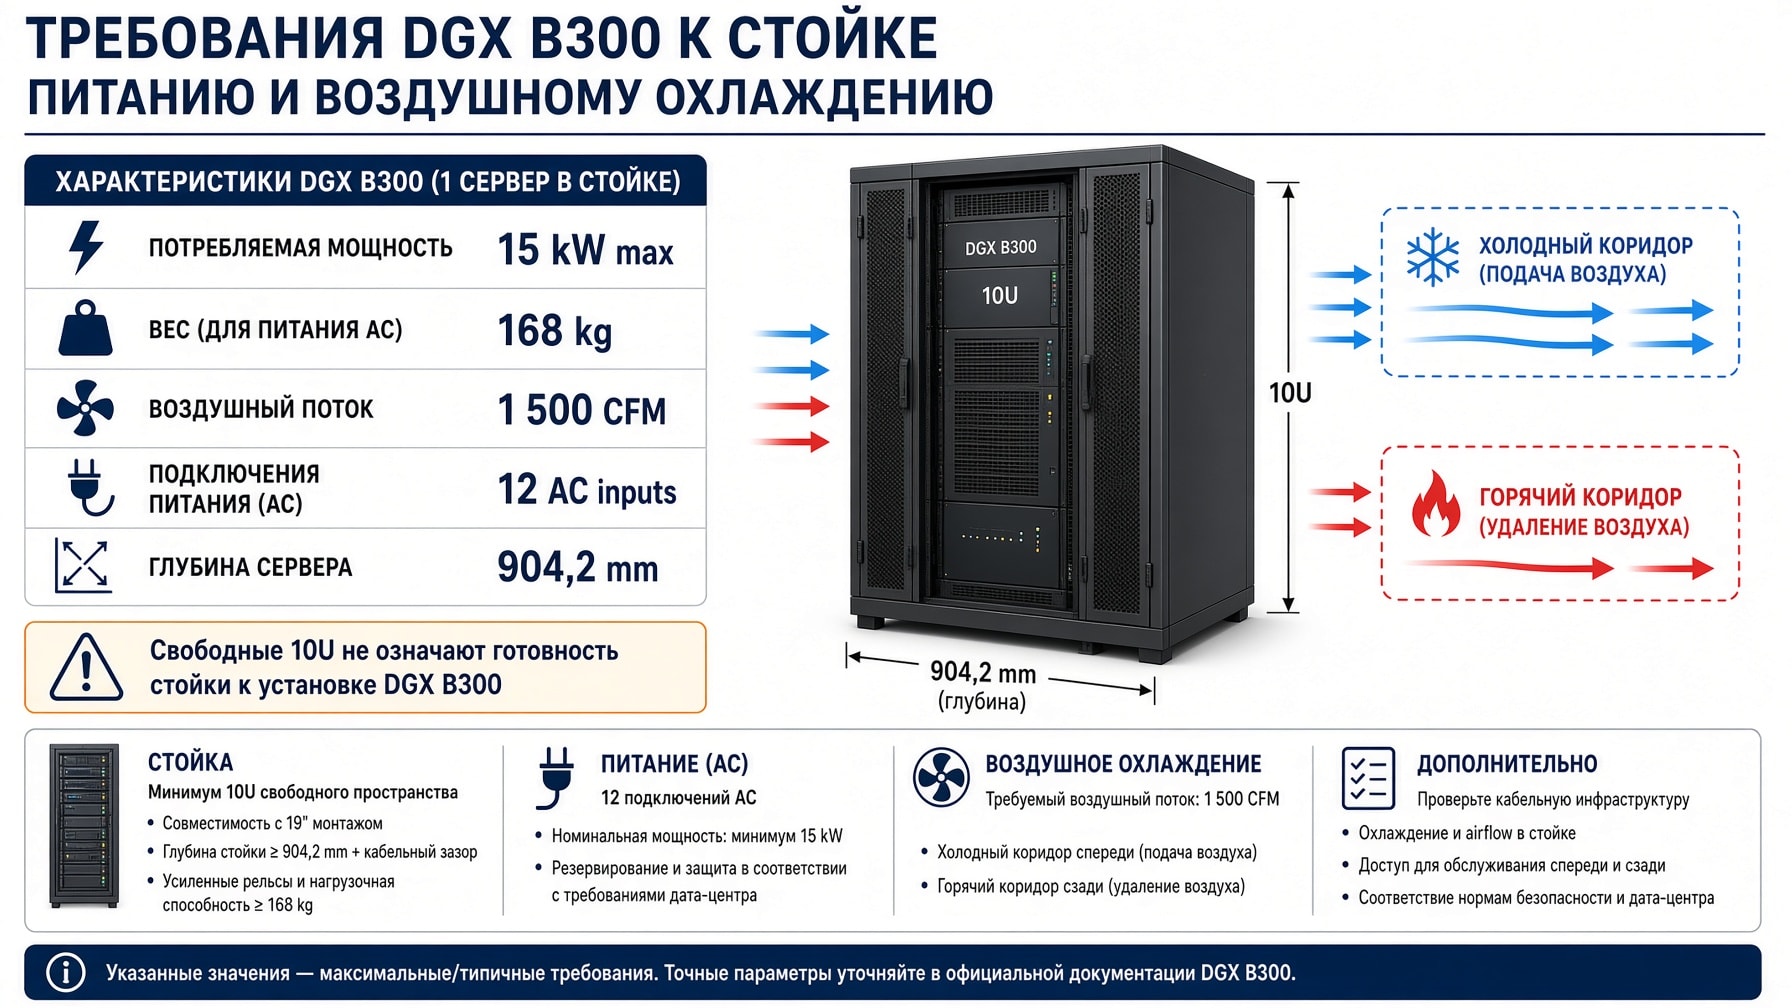
Что проверить до заказа
До фиксации поставки площадка должна подтвердить:
полезную глубину и ширину стойки;
совместимость rails и сервисный доступ;
допустимую статическую и динамическую нагрузку;
маршрут заноса оборудования и грузоподъемные средства;
AC или DC power architecture;
разнесение A и B feeds;
port count и тип PDU;
охлаждающую способность на стойку и зал;
температуру воздуха на входе 10-30 °C;
отсутствие рециркуляции горячего воздуха;
compute, storage и management кабельные планы;
место для leaf switches и радиусы изгиба OSFP кабелей;
политику аварийного отключения и graceful shutdown.
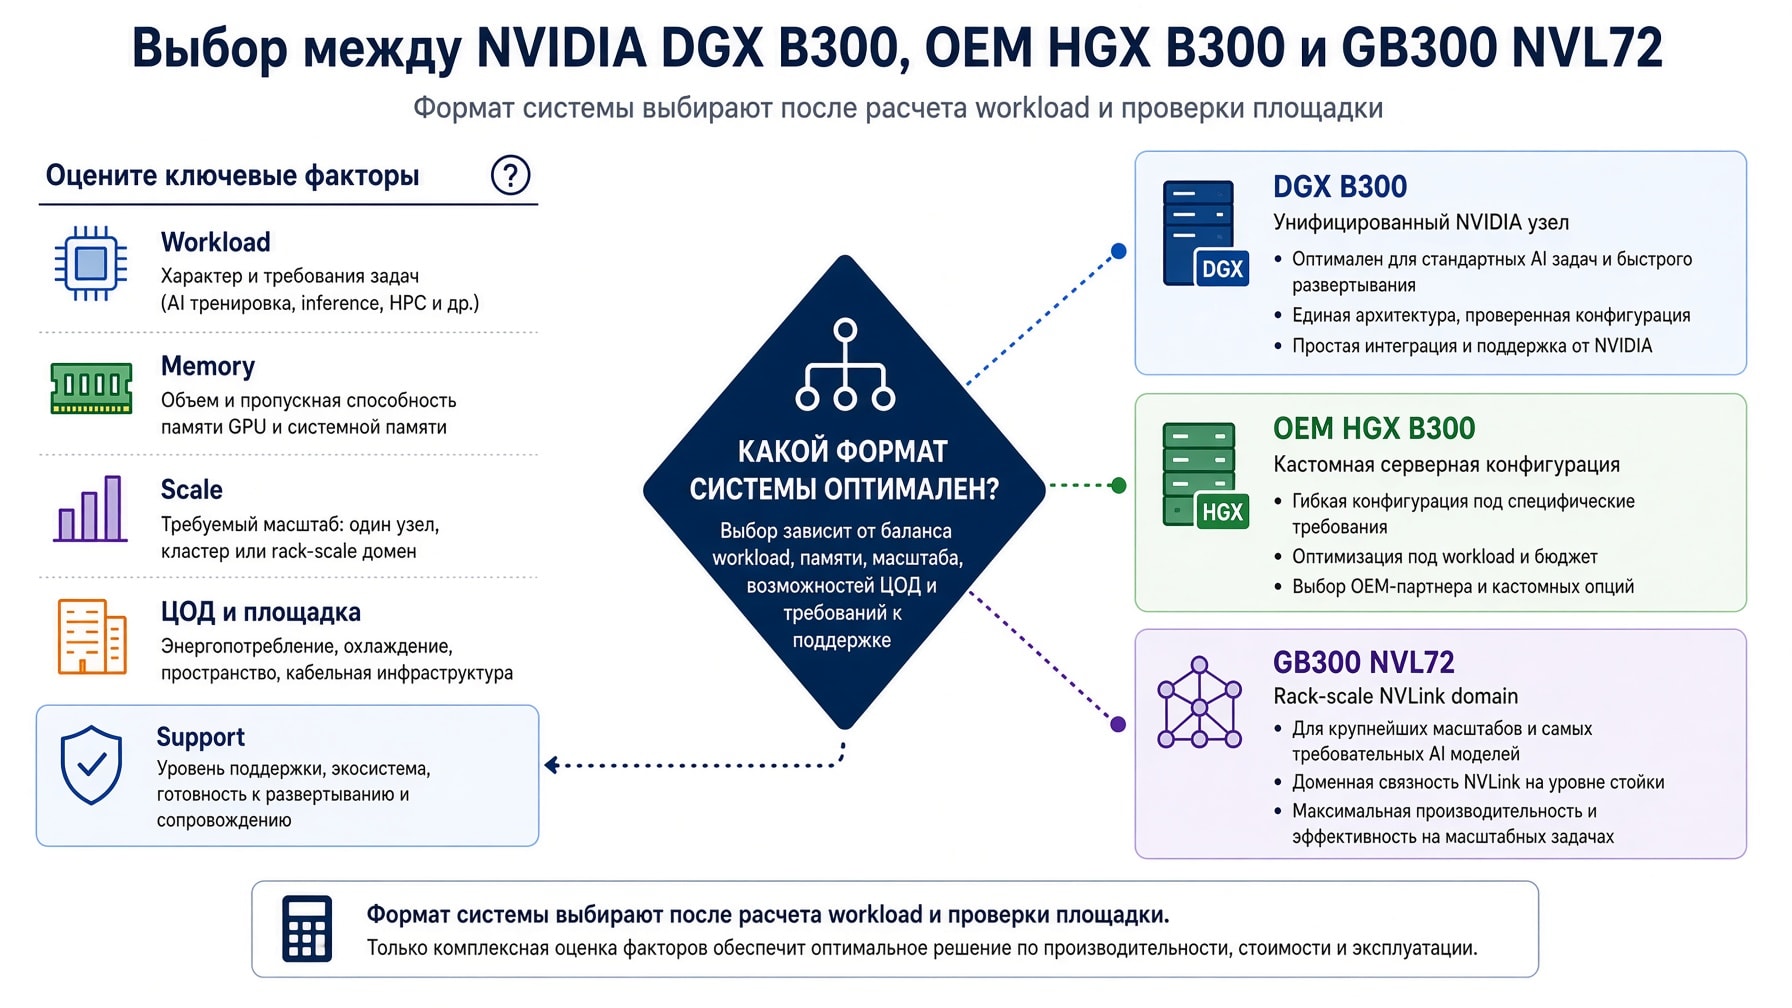
DGX B300, OEM HGX B300 или GB300 NVL72
Все три решения используют технологии Blackwell Ultra, но решают разные задачи закупки.
Критерий | NVIDIA DGX B300 | OEM-сервер HGX B300 | NVIDIA GB300 NVL72 |
|---|---|---|---|
Единица закупки | готовый 10U x86 узел NVIDIA | готовый сервер OEM на HGX baseboard | rack-scale система |
GPU-домен | 8 B300 через NVLink и NVSwitch | 8 B300 через HGX NVLink fabric | большой rack-scale NVLink-домен |
CPU | фиксированные 2 x Xeon 6776P | зависит от модели, возможны Intel или AMD | Grace CPU как часть Grace Blackwell architecture |
RAM и local storage | фиксированная базовая архитектура с поддерживаемыми изменениями | больше вариантов у конкретного OEM | определяется rack-scale architecture |
Программный baseline | DGX OS и DGX software stack | OEM validation плюс NVIDIA stack | NVIDIA rack-scale stack |
Кастомизация | ограниченная | выше, зависит от OEM | низкая на уровне отдельного узла, проектируется стойка целиком |
Инженерный порог площадки | высокий, воздушное охлаждение и до 15 kW на узел | зависит от выбранного корпуса и cooling | очень высокий, rack-scale deployment и жидкостная инфраструктура |
Основной аргумент | унифицированная система и единая модель поддержки | выбор CPU, storage, форм-фактора, cooling и OEM-сервиса | максимальное scale-up решение для очень крупных workloads |
Когда выбирать DGX B300
DGX B300 сильна, если организации нужны:
референсная законченная система NVIDIA;
одинаковые узлы для стандартизованного кластера;
DGX OS, NVSM, DCGM и проверенный NVIDIA software baseline;
единая аппаратная конфигурация для повторяемого deployment;
Enterprise Support и понятная эскалация по системе целиком;
восемь B300 в одном узле без самостоятельной OEM-компоновки.
Это снижает архитектурную вариативность. Снижение вариативности полезно там, где важнее быстро получить повторяемые узлы, чем выбирать каждый CPU, drive bay или тип шасси отдельно.
Когда рассматривать OEM-сервер HGX B300
OEM-система может быть рациональнее, если нужны:
другой CPU vendor или конкретная модель CPU;
иной объем RAM либо схема DIMM;
больше локальных накопителей или другой storage controller;
другой форм-фактор и плотность;
liquid cooling либо конкретная инженерная реализация;
интеграция с принятым BMC, fleet management и сервисным контрактом;
единый поставщик с существующим парком серверов.
Слово HGX не гарантирует одинаковые характеристики законченного сервера. Для сравнения используют категории GPU-серверов NVIDIA HGX и серверов с GPU NVIDIA B300, затем нормализуют CPU, RAM, drives, NIC, cooling, warranty и программу испытаний.
Когда нужен rack-scale вариант
Если одна workload должна работать в NVLink-домене, который значительно больше восьми GPU, сравнение отдельных DGX B300 уже не закрывает архитектурный вопрос. Тогда рассматривают GB300 NVL72 и связанные rack-scale решения. Они требуют другой площадки, другого cooling design и другой модели ввода в эксплуатацию.
Как выбрать конфигурацию и не переплатить
DGX B300 имеет фиксированную основу, но проект вокруг нее все равно нужно рассчитать.
1. Зафиксируйте workload
Нужны не общие слова обучение нейросети, а измеримые параметры:
model family, число параметров и revision;
training, fine-tuning, inference или смешанный режим;
precision и quantization;
sequence length и batch;
concurrency и профиль запросов;
текущие метрики на baseline hardware;
целевые latency, throughput и time-to-train;
размер dataset и суточный поток новых данных;
требования к доступности и изоляции tenants.
2. Рассчитайте GPU memory budget
Для training учитывают weights, gradients, optimizer states, activations, communication buffers и резерв. Для inference нужны weights, KV-cache, runtime workspace, CUDA graphs и запас на фрагментацию. После расчета определяют tensor parallel size и число replicas.
Если workload занимает только небольшую долю одной B300, покупка восьми-GPU DGX требует отдельного экономического обоснования. Если workload не помещается в 2,3 TB либо требует большого общего NVLink domain, один узел тоже не решит задачу.
3. Проверьте scale-up и scale-out
Сначала измеряют работу на одном GPU и внутри одного восьми-GPU узла. Затем отдельно проверяют multi-node режим. Полезные метрики:
GPU utilization вместе с application throughput;
HBM occupancy и memory bandwidth;
NVLink traffic и errors;
NCCL collective latency,
algbwиbusbw;non-overlapped communication time;
tokens/s, samples/s или step time;
CPU utilization и dataloader wait;
storage read throughput и checkpoint duration.
Высокий GPU utilization без достижения application SLA не подтверждает правильность конфигурации. Низкий utilization тоже не доказывает аппаратную проблему. Связь application SLI, runtime и аппаратных показателей разобрана в статье о мониторинге GPU-сервера.
4. Спроектируйте data path
Путь данных выглядит так:
СХД -> storage network -> BlueField-3 или выбранный interface -> RAM и local cache -> GPU HBM
Для нескольких узлов добавляется compute path:
GPU -> PCIe Gen6 -> ConnectX-8 -> leaf/spine fabric -> ConnectX-8 -> remote GPU
Каждый переход имеет собственные ограничения. Нельзя компенсировать слабое storage увеличением NVLink bandwidth. Нельзя исправить oversubscribed network добавлением RAM. Нельзя решить нехватку HBM более быстрым NVMe без изменения модели исполнения.
5. Считайте полную систему, а не цену коробки
В TCO входят:
DGX B300 и support contract;
доставка, страхование, занос и монтаж;
стойка, rails, PDU или busbar и power shelves;
электрическая мощность и охлаждение;
ConnectX-8 cables, transceivers и switches;
storage network и СХД;
management network;
software integration и security hardening;
приемочные испытания;
запасные компоненты и регламент обслуживания;
время простоя и стоимость резервирования.
NVIDIA DGX B300: цена и покупка
Запросы NVIDIA DGX B300 купить и NVIDIA DGX Blackwell B300 цена относятся к конфигурации целиком. Цена зависит не только от восьми GPU. На итог влияют вариант AC или DC, память, support, условия поставки, логистика, сеть, storage и работы на площадке.
Фиксировать цену из статьи рискованно: карточка товара и коммерческое предложение меняются быстрее технического обзора. Актуальная конфигурация представлена на странице NVIDIA DGX B300 с восемью B300 SXM 288 GB. Другие системы NVIDIA собраны в категории NVIDIA DGX.
В запросе поставщику следует указать:
точный workload и план масштабирования;
число систем сейчас и на втором этапе;
AC/PDU или DC/busbar;
2 или 4 TB RAM;
требуемый support level и срок;
InfiniBand или Ethernet;
модели switch, кабели, transceivers и breakout;
требования к СХД;
адрес, условия разгрузки и маршрут заноса;
параметры стойки, питания и cooling;
состав монтажа, настройки и приемки;
требования к air-gapped deployment, security и registry.
Коммерческое предложение без этих полей может выглядеть дешевле только потому, что из него исключены обязательные части решения.
Установка, ввод в эксплуатацию и приемка
NVIDIA требует, чтобы DGX B300 устанавливали сотрудники партнерской сети NVIDIA или field service engineers. В руководстве прямо указано, что иная установка лишает аппаратную гарантию силы. Самостоятельный занос и монтаж нельзя рассматривать как способ сэкономить.
До доставки
Команда должна подготовить:
утвержденный site survey;
rack elevation и проверку нагрузки;
power schedule для всех вводов;
cooling capacity и airflow validation;
cable matrix с part number;
IP plan для host, BMC, compute и storage networks;
DNS, NTP, identity и security policy;
доступ к репозиториям или air-gap bundle;
NGC и NVIDIA Enterprise Support registration plan;
программу и критерии приемки.
После физической установки
При первом вводе проверяют:
совпадение serial number, SKU и состава поставки;
восемь B300 и 288 GB на каждом GPU для заявленного варианта;
CPU, 2 или 4 TB RAM и корректную memory population;
SMART и encryption state NVMe;
RAID загрузочного и cache-контуров;
firmware, BMC, DGX OS, driver и CUDA versions;
NVLink topology и состояние NVSwitch fabric;
ConnectX-8 и BlueField-3 modes, link rate и errors;
redundant power feeds и поведение при отказе по согласованной процедуре;
temperature, fan, power и alert telemetry;
NVSM health check и diagnostics;
NCCL tests внутри узла и между узлами;
storage throughput;
целевой application benchmark.
Что сохранить в акте приемки
Результат приемки должен включать не только отметку сервер включился. Сохраняют:
hardware inventory и serial numbers;
версии BIOS, BMC, firmware, DGX OS, driver, CUDA и NCCL;
topology outputs;
health reports и логи diagnostics;
условия теста, продолжительность и ambient temperature;
метрики compute, memory, NVLink, network и storage;
параметры benchmark и версии workload;
список допустимых отклонений;
открытые замечания, ответственных и сроки устранения.
Такой baseline нужен для расследования будущих регрессий. Без него команда не сможет доказать, изменилась ли производительность после обновления или проблема существовала с первого дня.
Частые вопросы о NVIDIA DGX B300
Что такое NVIDIA DGX B300?
Это готовый 10U AI-сервер NVIDIA с восемью GPU B300 Blackwell Ultra, NVLink и NVSwitch, двумя Intel Xeon Platinum 6776P, 2-4 TB RAM, локальными NVMe, ConnectX-8, BlueField-3 и DGX OS 7.
Сколько GPU установлено в NVIDIA DGX B300?
В системе установлено восемь NVIDIA B300 Blackwell Ultra в форм-факторе SXM. Они объединены NVLink пятого поколения и двумя NVLink Switch System в один внутрисерверный GPU-домен.
Сколько видеопамяти у DGX B300?
Актуальное руководство DGX B300 указывает 8 x 288 GB HBM3e, всего 2 304 GB, или 2,3 TB. На публичной продуктовой странице одновременно встречается 2,1 TB, поэтому в заказе фиксируют exact SKU и проверяют фактическую память при приемке.
Чем NVIDIA DGX B300 отличается от HGX B300?
HGX B300 является GPU baseboard и платформой, которую OEM встраивает в собственный сервер. DGX B300 является законченной системой NVIDIA с конкретными CPU, RAM, NVMe, сетевыми адаптерами, корпусом, питанием, DGX OS и support model.
Какое питание требуется серверу NVIDIA DGX B300?
AC-версия работает от 200-240 V и использует 12 PSU с N+N redundancy. DC-вариант подключается к 54 V busbar и требует внешних power shelves. Для расчета площадки следует использовать до 15 kW system max и согласованную схему резервирования.
Можно ли установить DGX B300 в обычную серверную стойку?
Одной свободной высоты 10U недостаточно. Нужно проверить глубину, массу, floor loading, rails, сервисные зоны, питание, PDU, 1 500 CFM airflow для AC-варианта, отвод до 49 476 BTU/h и кабельную инфраструктуру. Установку выполняет авторизованный персонал.
Входят ли сетевые кабели в комплект DGX B300?
Нет. Руководство NVIDIA указывает, что network cables и adapters не поставляются с системой. Их выбирают по типу InfiniBand или Ethernet, firmware ConnectX-8, портам switch, breakout, длине и validated compatibility list.
Какая операционная система используется в DGX B300?
Базовый вариант использует DGX OS 7 на Ubuntu 24.04 LTS. Минимальный DGX OS ISO для DGX B300 2,3 TB указан как 7.3.0. Поддерживаются также Ubuntu, RHEL 8 и 9, Rocky Linux при корректной установке DGX software stack.
Сколько стоит NVIDIA DGX B300?
Цена зависит от даты, состава поставки, варианта питания, RAM, support, логистики и инфраструктуры проекта. Для сравнения предложений нужно отделить цену сервера от switch fabric, кабелей, СХД, стойки, питания, охлаждения, монтажа и приемки.
Где купить NVIDIA DGX B300?
Выбирать поставщика стоит по способности поставить не только сервер, но и согласовать support, логистику, авторизованную установку, сеть, storage, площадку и программу испытаний. Карточка системы и запрос конфигурации доступны в каталоге Start Server.
Как заказать DGX B300 под конкретную задачу
Start Server может рассчитать поставку NVIDIA DGX B300 как часть полного AI-контура: compute nodes, InfiniBand или Ethernet fabric, СХД, management network, стойки, питание, охлаждение, монтаж, настройка и приемочные тесты.
Для первичного расчета достаточно передать модель, режим training или inference, memory budget, число пользователей либо размер dataset, текущий baseline, план роста и параметры площадки.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


