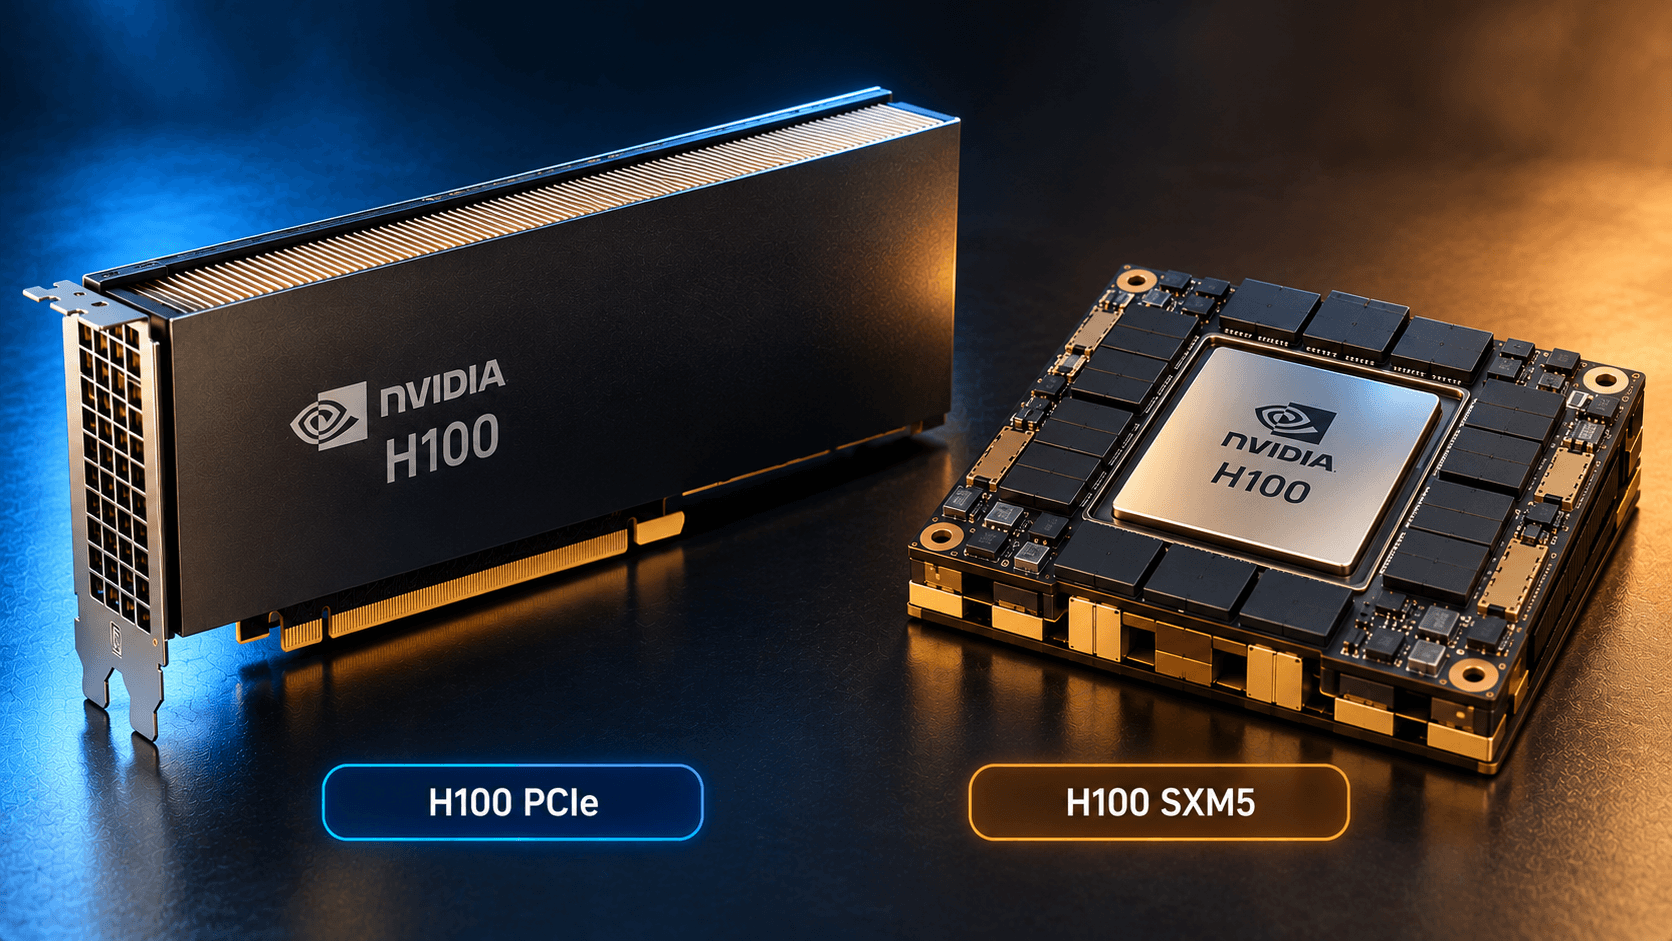
NVIDIA H100 представляет собой серверный GPU-ускоритель архитектуры Hopper для обучения нейросетей, инференса, аналитики и высокопроизводительных вычислений. В поставках встречаются H100 PCIe на 80 ГБ, H100 SXM5 на 80 ГБ и H100 NVL на 94 ГБ на GPU. Эти варианты различаются памятью, мощностью, связностью и требованиями к серверу.
Поэтому формулировки «сервер с H100» недостаточно для сравнения предложений. Нужно знать исполнение ускорителей, количество GPU, топологию их соединения и конфигурацию CPU, RAM, накопителей и сети. Особенно это важно для LLM: одинаковые 80 ГБ памяти не означают одинаковую скорость, но и более высокий вычислительный пик не устраняет нехватку VRAM.
Что дает архитектура Hopper
H100 использует Tensor Cores четвертого поколения и Transformer Engine. Они рассчитаны на ускорение поддерживаемых матричных операций, в том числе с использованием FP8. Практический эффект зависит от реализации модели и программных библиотек.
Transformer Engine не является переключателем, который ускоряет любую нейросеть одинаково. Выбранный фреймворк должен использовать соответствующие операции, а результат необходимо проверить на контрольных данных. Изменение числового формата может влиять на точность и устойчивость вычислений.
H100 также поддерживает вычисления других форматов и научные приложения. Но пиковая производительность FP8, обычного FP64 и FP64 Tensor Core описывает разные типы операций. Их нельзя ставить в одну колонку сравнения без пояснений.
Характеристики H100 PCIe, SXM5 и NVL
В таблице показатели памяти и мощности приведены на один GPU, а не на сервер или пару карт. Это принципиально для H100 NVL, которую часто описывают как двухкарточное решение.
Параметр | H100 PCIe 80GB | H100 SXM5 80GB | H100 NVL 94GB |
|---|---|---|---|
Архитектура | Hopper | Hopper | Hopper |
Память на GPU | 80 ГБ HBM2e | 80 ГБ HBM3 | 94 ГБ HBM3 |
Полоса памяти | 2,0 ТБ/с | 3,35 ТБ/с | 3,9 ТБ/с |
Максимальный TDP | 350 Вт | До 700 Вт, настраиваемый | 350-400 Вт, настраиваемый |
Форм-фактор | PCIe, двухслотовый | Модуль SXM5 | PCIe, двухслотовый |
Интерфейс CPU-GPU | PCIe 5.0 | PCIe 5.0 в составе платформы | PCIe 5.0 |
NVLink, агрегированная полоса на GPU | До 600 ГБ/с | До 900 ГБ/с | До 600 ГБ/с |
MIG | До 7 экземпляров | До 7 экземпляров | До 7 экземпляров |
Для H100 PCIe 80GB использован официальный product brief NVIDIA, для SXM и NVL сверена текущая страница спецификаций H100. В ранних материалах встречается округленная полоса SXM 3 ТБ/с; в текущей таблице NVIDIA указано 3,35 ТБ/с. При закупке фиксируют показатели конкретного артикула и платформы.
Чем H100 NVL отличается от обычной PCIe-версии
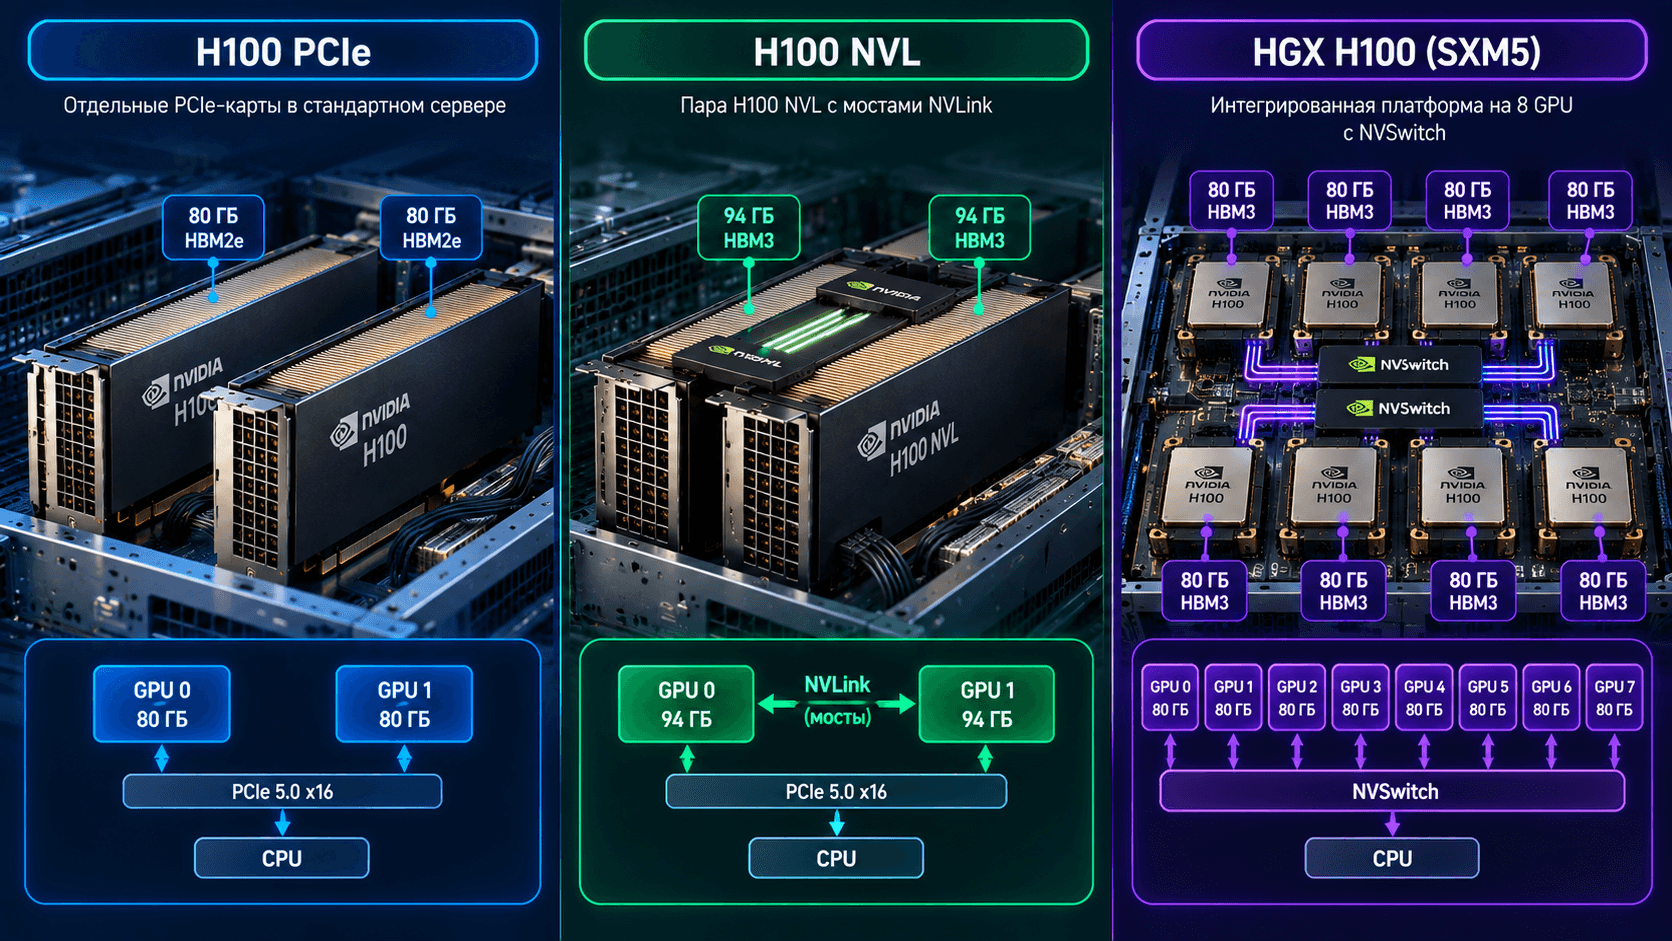
H100 NVL на 94 ГБ не является той же самой H100 PCIe 80GB с другим названием. У нее другая емкость и полоса памяти, а также свой диапазон TDP. Две карты NVL дают 188 ГБ суммарной физической памяти, но не автоматически единое адресное пространство для любого приложения.
Для связанной пары необходимы предусмотренные платформой мосты NVLink. Проверяют, входят ли они в поставку, подходят ли к расстоянию между слотами и какие схемы соединения поддерживает сервер. Количество карт и количество комплектов мостов должны быть отражены в спецификации отдельно.
PCIe или SXM: что выбрать для сервера
H100 PCIe для отдельных ускорителей и совместимых платформ
PCIe-карты рассматривают, когда платформа рассчитана на такую установку, задачи можно распределять между отдельными GPU либо нужна конкретная поддерживаемая конфигурация с несколькими картами.
Это не означает совместимость с любым сервером. Проверяются список поддерживаемых GPU, питание, механика, охлаждение, ширина PCIe, райзеры и версии BIOS. Пассивно охлаждаемому ускорителю нужен спроектированный поток воздуха. Открытый корпус и свободный слот не являются достаточными условиями.
Пример серверной платформы: Supermicro SYS-221GE-NR с четырьмя H100 80GB. Возможности конкретной поставки, сетевые адаптеры и мосты уточняют отдельно. Само число GPU не описывает их связность.
H100 SXM5 для интегрированных многопроцессорных систем
SXM5-модули работают в составе специальной GPU-платформы. В HGX H100 они образуют интегрированную систему с высокоскоростной связностью. Сервер включает необходимые платы, питание, охлаждение и служебную инфраструктуру.
Такой подход рассматривают для нагрузок, которые действительно используют взаимодействие нескольких ускорителей: распределенного обучения или разделения крупной модели. Если работа состоит из независимых небольших заданий, необходимость дорогой внутрисерверной сети нужно подтвердить отдельно.
HGX и DGX не обозначают одинаковую поставку
HGX является платформой для систем производителей серверов. DGX представляет собой семейство готовых систем NVIDIA. Покупатель должен сравнивать полный состав, поддержку и программные условия, а не только количество установленных GPU. Подробности линейки вынесены в обзор NVIDIA DGX.
Сколько памяти нужно для LLM на H100
Для инференса оценивают веса модели, KV-кэш, временные буферы и резерв. Для обучения дополнительно нужны градиенты, состояния оптимизатора и активации. Поэтому одна и та же модель может помещаться для инференса, но не помещаться для полного дообучения.
Рассмотрим арифметический пример. Условные 70 млрд параметров в FP16 требуют около 140 млрд байт только для весов. Одна H100 на 80 ГБ такой объем не вмещает. При четырехбитном представлении теоретическая нижняя оценка весов составит 35 млрд байт, но к ней добавятся структуры квантизации и память выполнения.
Этот пример не является обещанием, что любая 70B-модель с любым контекстом заработает на одной H100 после квантизации. Нужно проверить формат модели, поддержку движка, качество, длину входа и число одновременно обслуживаемых запросов.
Почему суммарная VRAM не равна памяти одной задачи
Восемь H100 по 80 ГБ дают 640 ГБ суммарной физической емкости. Чтобы использовать ее для одной модели, программный стек должен распределить веса и рабочие данные между GPU. У каждого ускорителя остаются собственные ограничения.
При некоторых вариантах параллелизма модель дублируется, а не делится. При других обмены между GPU могут существенно влиять на скорость. Поэтому запрос «нужна модель на 640 ГБ» недостаточен для выбора восьмикарточной системы.
Как оценить скорость обучения и инференса
У обучения и инференса разные критерии успеха. Для обучения измеряют время до согласованного качества, продолжительность шага, размер пакета и устойчивость процесса. Для инференса важны задержка первого ответа, скорость дальнейшей генерации, число завершенных запросов и хвостовые задержки под нагрузкой.
Сравнивать системы нужно при одинаковых условиях:
одной версии модели и одинаковой проверке качества;
одинаковом формате весов и вычислений;
одинаковых входных и выходных длинах;
сопоставимых batch size и параллельности;
зафиксированных версиях драйвера, движка и библиотек;
одинаковых ограничениях по задержке и правилах учета ошибок.
Число токенов в секунду без этих условий почти ничего не говорит о пригодности системы. Показатель суммарного потока всех запросов нельзя выдавать за скорость генерации одного пользователя.
Какие CPU, RAM, накопители и сеть нужны H100
CPU и оперативная память
Процессор обслуживает приложение, подготовку данных, сетевые операции и часть вычислений. Его выбирают по профилю нагрузки и расположению устройств относительно NUMA-узлов. Максимальное число ядер не гарантирует лучшую подачу данных к GPU.
RAM рассчитывают для загрузчика, CPU-части модели, кэшей и параллельных задач. Нельзя назначить универсальный множитель «RAM должна быть ровно вдвое больше VRAM». Для одной задачи это окажется лишним, для другой недостаточным.
Накопители и СХД
При обучении важны чтение датасета и запись checkpoint. При обслуживании моделей добавляются время их загрузки, хранение нескольких версий и конкуренция сервисов за I/O. Если GPU простаивает в ожидании данных, увеличение числа ускорителей не решит проблему.
Отдельно определяют, какие данные временные, какие должны пережить отказ узла и какие необходимо резервировать. Локальный NVMe может ускорить рабочую область, но не заменяет систему хранения важных результатов.
Межузловая сеть
NVLink внутри сервера не заменяет сеть между серверами. При распределенном обучении значение имеют сетевые адаптеры, топология, коммуникационные библиотеки и поддерживаемый путь передачи данных.
Питание и охлаждение: почему TDP нельзя читать как расход сервера
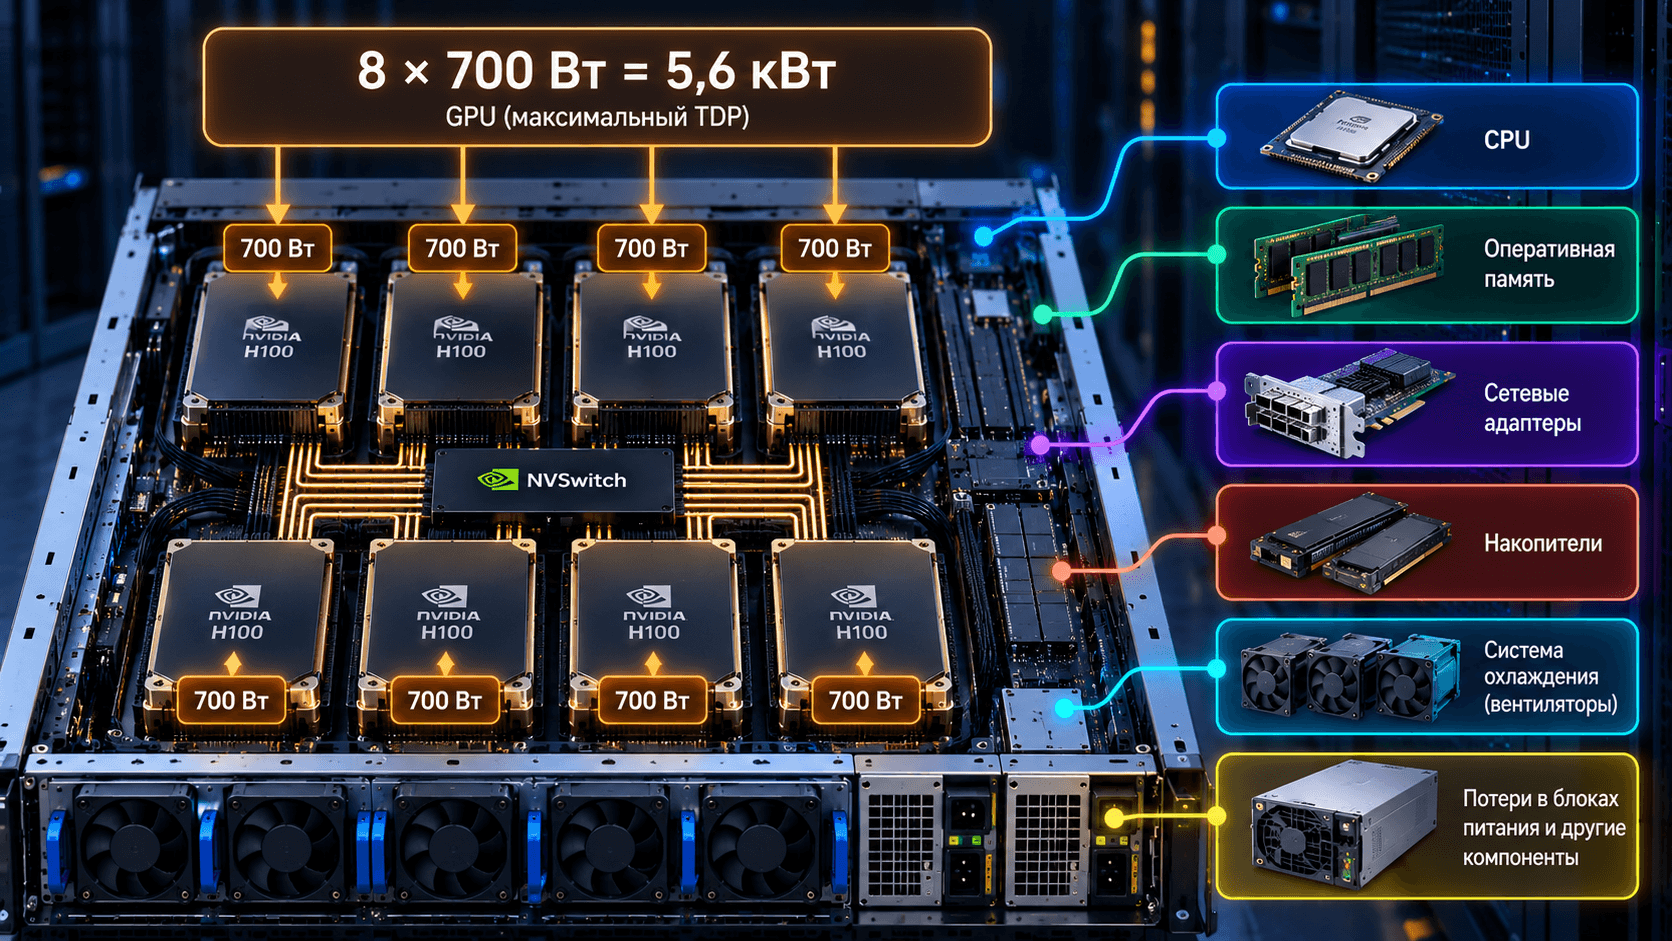
Восемь H100 SXM с максимальным TDP 700 Вт соответствуют 5,6 кВт только для GPU. В эту сумму не входят CPU, RAM, коммутаторы внутри платформы, накопители, вентиляторы и потери преобразования питания. Это расчет по предельным паспортным значениям, а не измерение потребления конкретного сервера.
Для площадки используют спецификацию всей поставляемой конфигурации. Проверяют допустимые режимы блоков питания, подключение к независимым вводам, нагрузку на PDU, массу и глубину шасси, направление потоков и сервисное пространство.
Наличие резервных блоков питания не означает, что любой режим нагрузки сохранится при потере одного ввода. Резервирование проверяют для выбранного состава и мощности, а не по количеству установленных PSU.
MIG, виртуализация и несколько пользователей
H100 поддерживает MIG второго поколения с разделением GPU на аппаратные экземпляры. Максимальное количество составляет семь, но допустимые профили памяти и вычислений зависят от версии GPU и программного окружения.
MIG полезен, если несколько небольших нагрузок не используют весь ускоритель и требуется выделить им ресурсы. Для одной крупной модели, которой нужна вся VRAM, разделение не увеличит доступную память.
Выделение GPU контейнеру, проброс PCIe-устройства виртуальной машине, vGPU и MIG представляют разные механизмы. Их совместимость, лицензирование, изоляцию и ограничения миграции необходимо проверять отдельно. Нельзя считать все способы взаимозаменяемыми только потому, что они используют одну H100.
Когда H100 подходит, а когда нужно другое решение
Сценарий | С чего начать | Что может изменить выбор |
|---|---|---|
Модель помещается на одном GPU | Проверка одного H100 на целевой параллельности | Более экономичный GPU может обеспечить те же целевые задержки и доступность |
Много независимых моделей | Размещение по GPU или допустимым MIG-профилям | Потребность в памяти каждого сервиса и изоляции |
Модель не помещается в 80 ГБ | Проверка квантизации, нескольких GPU или более емкого ускорителя | Качество, KV-кэш и стоимость обменов |
Распределенное обучение | Тест масштабирования внутри сервера, затем между узлами | Сеть, размер задачи, время checkpoint и бюджет площадки |
По сравнению с A100 H100 дает другую архитектуру и новые возможности вычислений. Однако H100 80GB не удваивает память A100 80GB: емкость совпадает. Если проект ограничен именно VRAM, замена поколения без изменения объема может не решить задачу.
Как купить H100-сервер без неоднозначной спецификации
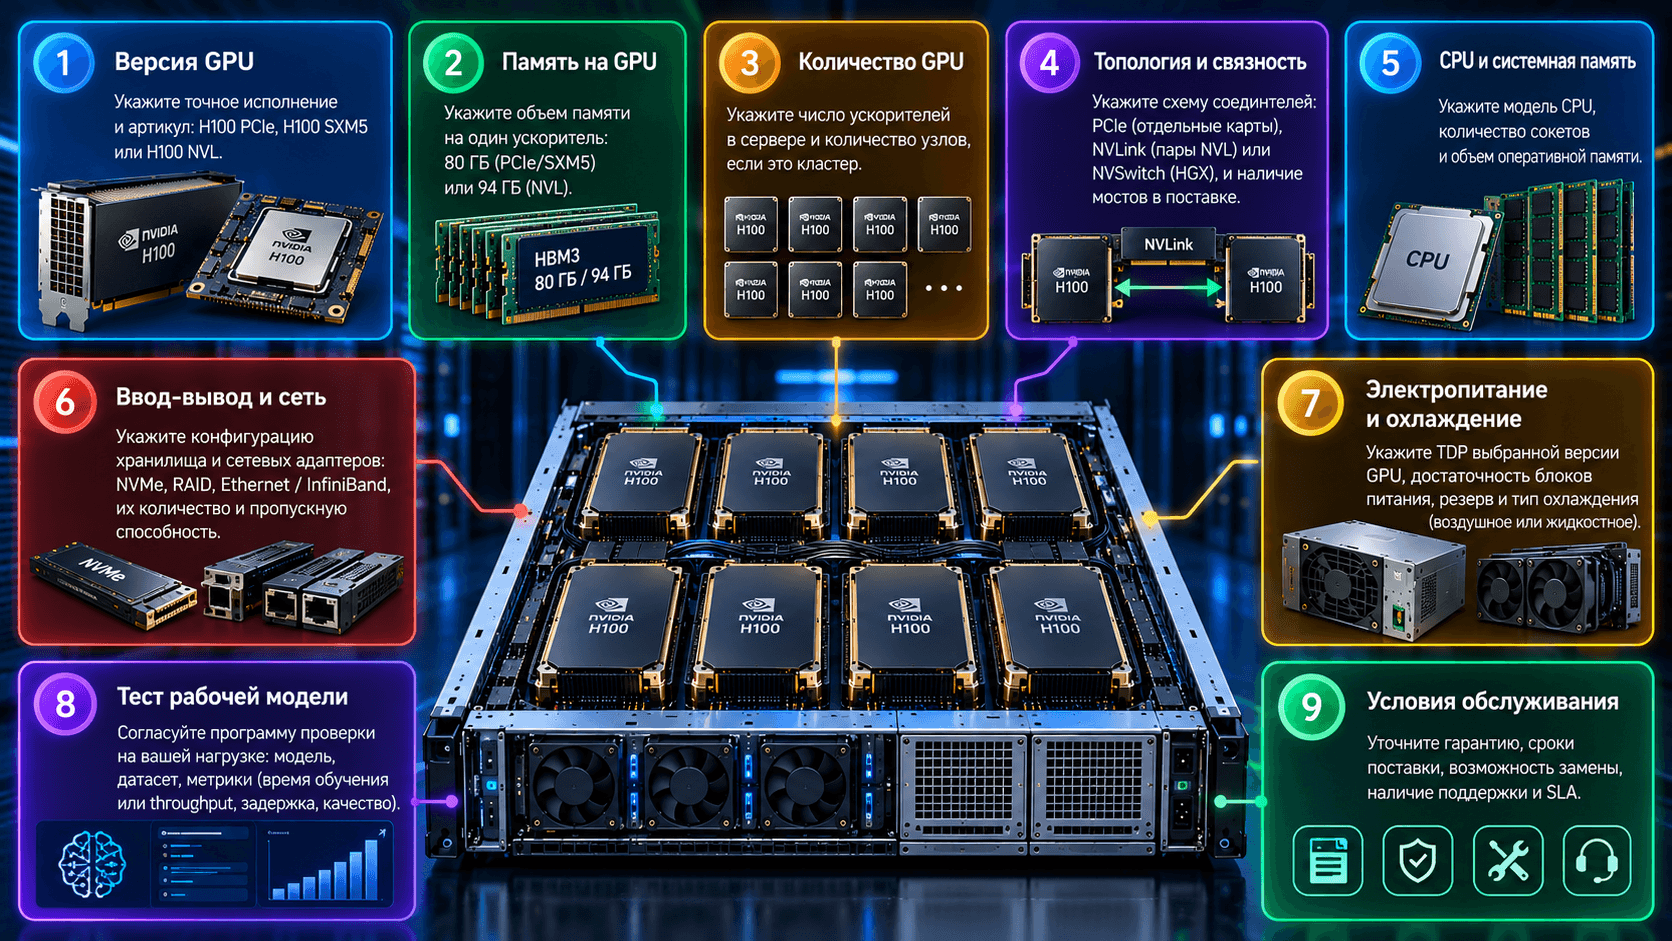
Зафиксируйте точное исполнение и количество GPU, память на устройство, модель сервера, CPU, схему RAM, накопители, сетевые адаптеры и комплект соединений. Для NVL укажите количество карт и мостов, для SXM уточните состав GPU-платформы.
Далее согласуйте условия гарантии, поддержки, поставки и программу испытаний. Для оборудования бывшего в эксплуатации дополнительно нужны история обслуживания и проверка состояния, но заявление продавца не заменяет тест.
Приемка должна включать идентификацию компонентов, аппаратные ошибки, длительную нагрузку, проверку связности и рабочую модель. Фиксируются температура, частоты, ограничения питания и результаты с согласованными параметрами. Успешный запуск nvidia-smi подтверждает обнаружение устройства, но не качество всей системы.
Частые вопросы о NVIDIA H100
У всех H100 память HBM3?
Нет. У рассматриваемой H100 PCIe 80GB используется HBM2e, у H100 SXM5 80GB и H100 NVL 94GB используется HBM3. Версию необходимо указывать полностью.
188 ГБ у H100 NVL принадлежат одной карте?
Нет. Это сумма двух GPU по 94 ГБ. Использование такой емкости одной моделью зависит от поддержки распределенного выполнения.
Что означает H100 96GB?
Указание 96 ГБ может относиться к GPU в составе Grace Hopper GH200 или к неточному описанию. Его нельзя автоматически считать стандартной H100 PCIe 80GB или H100 NVL 94GB. Нужны точный артикул и документация системы.
Можно ли заменить A100 на H100?
Только после проверки платформы. SXM4 и SXM5 не взаимозаменяемы, а PCIe-система должна поддерживать питание, охлаждение и программное окружение нового ускорителя. Совпадение внешнего размера карты не является подтверждением.
H100 всегда быстрее A100 в несколько раз?
Нет универсального множителя. Эффект зависит от вычислительного формата, модели, памяти, сети и программной реализации. Сравнивают одинаковую задачу при одинаковых требованиях к качеству и задержке.
Сколько стоит NVIDIA H100?
Актуальную цену запрашивают по исполнению, количеству, составу поставки и условиям поддержки. Цена отдельного модуля, пары NVL и готового восьмикарточного сервера относится к разным предметам закупки.
Нужно ли сразу покупать восемь H100?
Нет. Сначала проверяют, сколько GPU нужно для памяти и производительности. Восемь ускорителей оправданы, если приложение или поток независимых задач способны полезно загрузить систему.
Подбор сервера с H100 под рабочую нагрузку
Для расчета конфигурации передайте модель или приложение, режим обучения либо инференса, точность, контекст и параллельность. Укажите требования к времени, задержкам, доступности и размещению оборудования.
В каталоге серверов с NVIDIA H100 можно выбрать системы для предметного сравнения. Итогом должны стать полная спецификация и проверяемый критерий приемки, а не только количество терафлопс в описании GPU.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


