CUDA представляет собой платформу ускоренных вычислений и программную модель NVIDIA. Она позволяет приложению передавать параллельную часть работы с CPU на совместимый GPU: матричные операции нейросети, моделирование, обработку изображений, рендеринг, анализ данных и другие задачи, где одни и те же вычисления выполняются над большим числом элементов.
CUDA работает только с CUDA-capable GPU NVIDIA. В актуальный список входят серверные ускорители B300, B200, H200, H100, L40S, L4, A100, A30 и T4, профессиональные RTX PRO и RTX Ada, а также потребительские GeForce RTX 50, 40, 30 и 20. Старые Volta, Pascal и Maxwell аппаратно поддерживают CUDA, но CUDA Toolkit 13 уже не компилирует для них код и не поставляет для них библиотеки. Для таких GPU обычно нужен стек CUDA 12.x или более ранний.
Одного совпадения названия видеокарты со списком недостаточно. Рабочая конфигурация складывается из GPU, compute capability, драйвера, CUDA runtime или Toolkit, сборки PyTorch либо другого фреймворка и архитектур, включенных в готовые библиотеки. Поэтому ответ на вопрос «поддерживает ли видеокарта CUDA» состоит из аппаратной и программной частей.
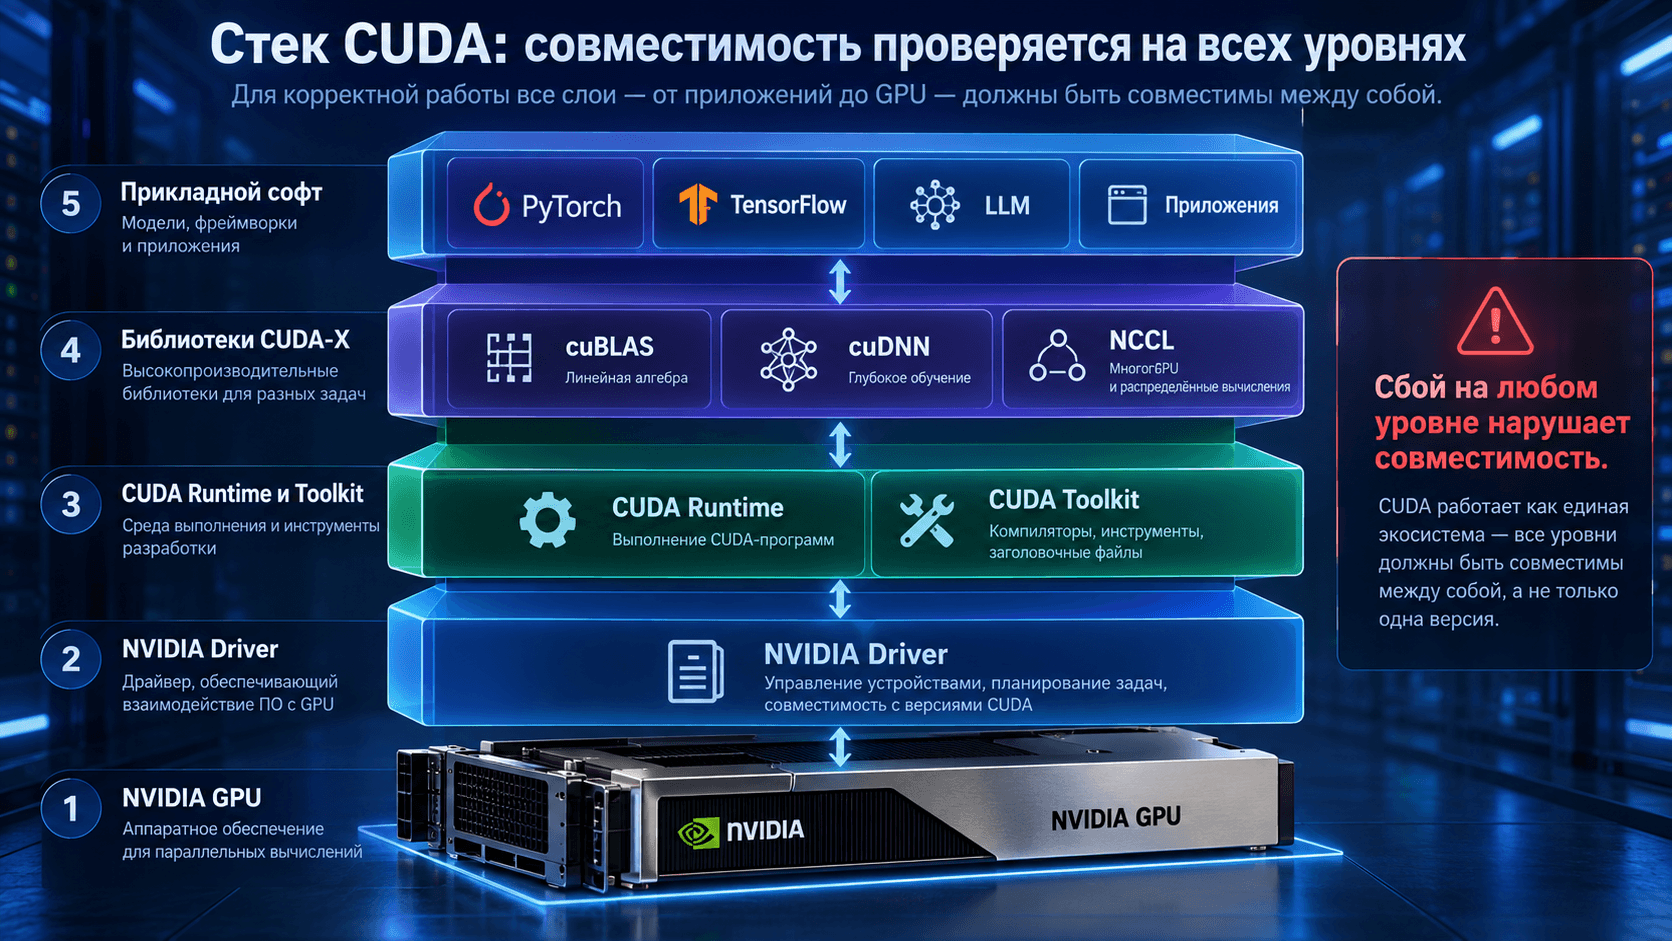
Что такое CUDA простыми словами
CPU рассчитан на выполнение разнообразной логики, последовательного кода и задач с ветвлениями. GPU содержит много вычислительных блоков и способен одновременно обрабатывать большое число похожих операций. CUDA дает программе инструменты, чтобы подготовить данные на CPU, разместить их в памяти GPU, запустить параллельную функцию и получить результат.
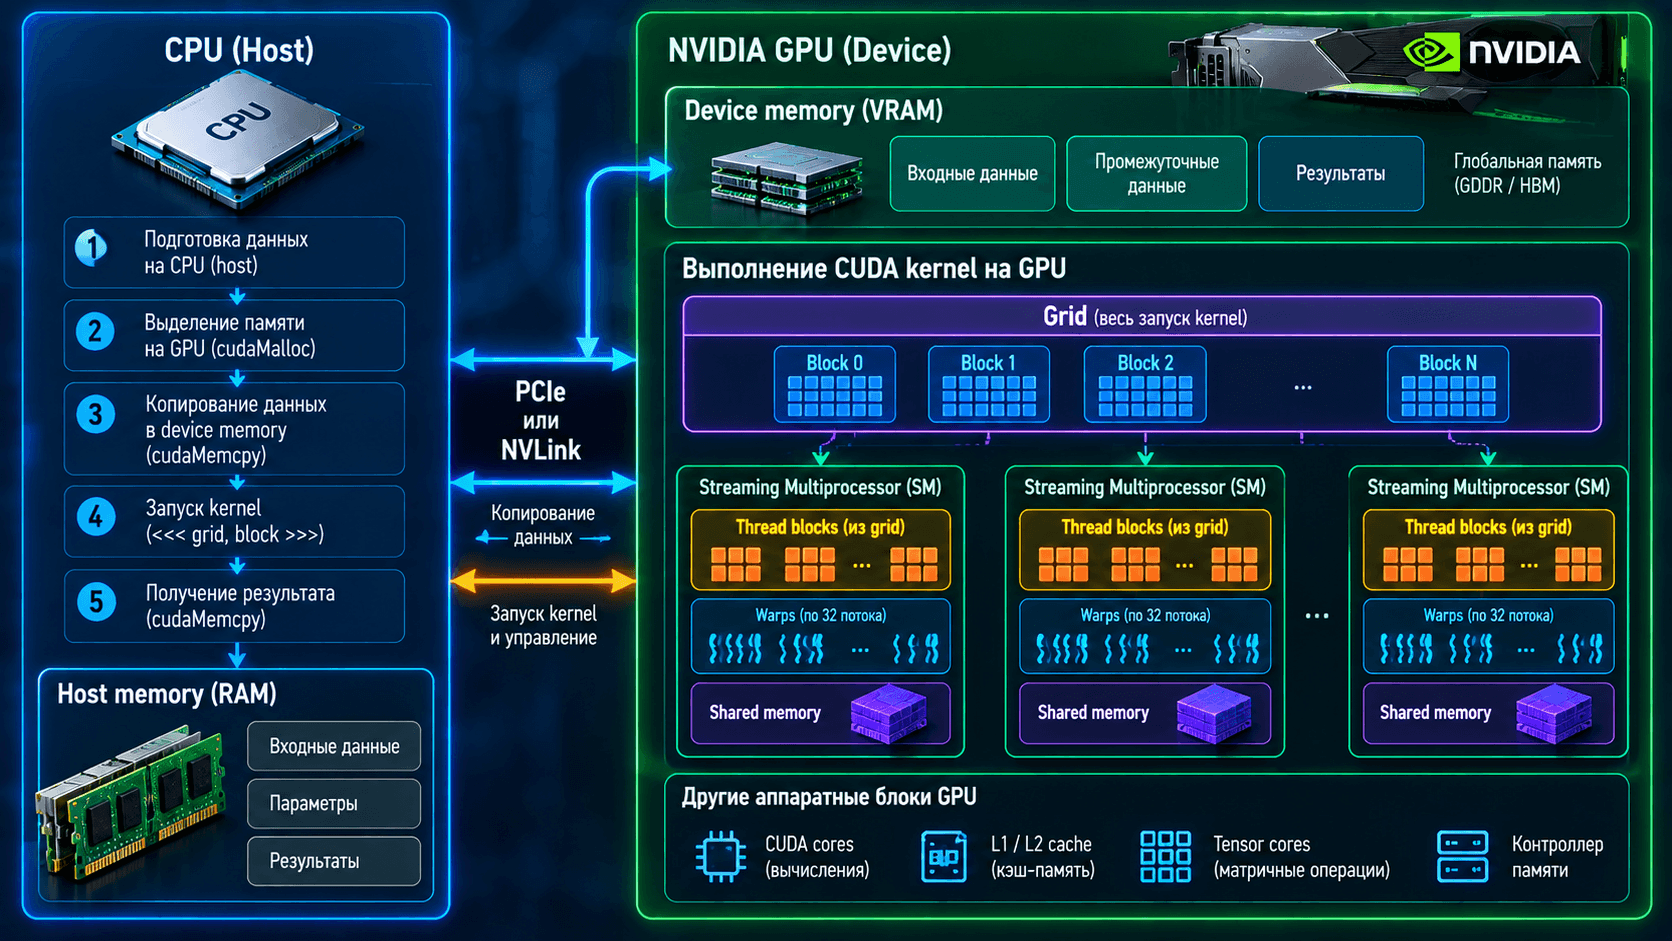
Такая функция называется kernel. Приложение запускает много CUDA threads, группирует их в blocks, а блоки объединяет в grid. GPU распределяет блоки по streaming multiprocessors, или SM. Внутри SM потоки исполняются группами по 32, которые называются warps. Если потоки одного warp расходятся по разным веткам кода, часть вычислительных ресурсов временно простаивает. Поэтому GPU ускоряет не любой код автоматически.
В документации и интерфейсах встречаются три разных значения слова CUDA:
CUDA platform, то есть общая программно-аппаратная экосистема NVIDIA для GPU computing.
CUDA programming model и API, с помощью которых приложение управляет вычислениями и памятью GPU.
CUDA Toolkit, то есть комплект компилятора, runtime-компонентов, библиотек, заголовков, отладчиков и профилировщиков для разработки.
Как работает CUDA
Типичный цикл вычисления состоит из пяти этапов:
Программа на host, обычно на CPU, подготавливает входные данные.
Runtime выделяет device memory на GPU или использует подходящую модель общей памяти.
Данные передаются в видеопамять, если они еще не находятся там.
Host запускает kernel с заданным числом blocks и threads.
После завершения результат остается на GPU для следующей операции или копируется обратно в системную RAM.
Ускорение возникает, когда полезная параллельная работа перекрывает расходы на запуск kernels, перемещение данных и синхронизацию. Небольшая задача с частыми копированиями между RAM и VRAM может работать на GPU медленнее, чем на CPU. Крупное умножение матриц, свертка, attention или обработка миллионов независимых элементов обычно используют параллелизм гораздо лучше.
Threads, blocks, grids и warps
CUDA thread является логической единицей работы. Thread block объединяет потоки, которые выполняются на одном SM, могут синхронизироваться и использовать shared memory. Grid содержит все блоки одного запуска kernel. Такая иерархия позволяет одному и тому же коду выполняться на GPU с разным числом SM.
Warp объединяет 32 потока. Планировщик выдает им инструкцию, а каждый активный поток применяет ее к своим данным. Модель называется SIMT, Single Instruction, Multiple Threads. Число CUDA-ядер в спецификации нельзя напрямую приравнивать к числу одновременно исполняемых независимых программ: реальное выполнение определяется SM, warps, инструкциями, регистрами, памятью и планированием.
Где хранятся данные
У CUDA есть несколько пространств памяти с разной областью видимости и стоимостью доступа:
Память | Где находится и кому доступна | Практический смысл |
|---|---|---|
Registers | внутри SM, принадлежат потоку | самый быстрый рабочий набор, но объем ограничен |
Shared memory | внутри SM, общая для threads одного block | обмен и повторное использование данных внутри блока |
Global memory | основная VRAM, доступна всем kernels устройства | большая емкость, но доступ дороже и зависит от схемы обращений |
Constant memory | read-only область с кэшированием | параметры, одинаковые для множества потоков |
Host memory | системная RAM рядом с CPU | источник данных и место работы CPU |
Unified Memory | управляемое адресное пространство | упрощает доступ, но миграция страниц и oversubscription могут влиять на задержку |
VRAM нельзя заменить обычной RAM без компромиссов. Если модель, batch или рабочие buffers не помещаются в видеопамять, перенос страниц либо offload способен резко снизить скорость. Для AI-нагрузок полезно заранее рассчитать объем видеопамяти для модели, контекста и batch size.
Из чего состоит NVIDIA CUDA
NVIDIA driver
Драйвер дает операционной системе доступ к GPU и содержит CUDA user-mode driver. Без совместимого драйвера CUDA-приложение не создаст context и не запустит kernel. Версия драйвера определяет максимальную ветку CUDA, которую он способен обслуживать.
CUDA runtime
Runtime предоставляет API для выделения памяти, копирования данных, запуска kernels, streams, events и управления устройствами. Готовое приложение или Python wheel может принести нужные runtime-библиотеки с собой. Поэтому локально установленный полный Toolkit требуется не во всех сценариях.
CUDA Toolkit
CUDA Toolkit нужен прежде всего для разработки и сборки CUDA-кода. В него входят compiler driver nvcc, headers, runtime, математические библиотеки и инструменты разработки. Команда nvcc --version показывает версию доступного compiler toolkit, но не гарантирует, что выбранный PyTorch использует именно его.
На дату фактчека актуальное установочное руководство NVIDIA относится к CUDA 13.4. Номер быстро меняется, поэтому перед обновлением нужно проверять текущие release notes. CUDA 12.4, CUDA 12.8, CUDA 13.0 и CUDA 13.4 не являются взаимозаменяемыми ярлыками: у каждой версии есть требования к driver, operating system, host compiler, libraries и целевым GPU architectures.
Библиотеки CUDA-X
Прикладные frameworks опираются на оптимизированные библиотеки, поэтому разработчик часто не пишет собственный kernel:
cuBLAS выполняет операции линейной алгебры;
cuDNN предоставляет primitives для нейросетей, включая convolution, attention, normalization и matmul;
NCCL выполняет коллективные операции между GPU и узлами;
cuFFT ускоряет преобразования Фурье;
cuSPARSE работает с разреженными матрицами;
TensorRT оптимизирует и исполняет inference graphs;
Nsight Systems и Nsight Compute помогают находить простои и узкие места.
PyTorch, TensorFlow, JAX, RAPIDS, LLM runtimes и инженерные приложения используют разные части этой экосистемы. Поддержка NVIDIA CUDA в названии framework не означает, что любая его сборка содержит код для любой старой или только что выпущенной архитектуры GPU.
Какие видеокарты поддерживают CUDA
Короткий ответ: официально CUDA поддерживают только совместимые GPU NVIDIA. AMD Radeon и Instinct, Intel Arc и Data Center GPU, а также Apple Silicon не являются CUDA devices. У них есть другие вычислительные стеки, а проекты совместимости и трансляции не превращают их в официально поддерживаемые CUDA GPU.
Для современных моделей надежный источник проверки представляет собой официальная таблица NVIDIA CUDA GPU Compute Capability. Точная модель важнее общего бренда. Например, слова GeForce, RTX или Tesla сами по себе не указывают compute capability и допустимую ветку Toolkit.
Актуальные поколения NVIDIA GPU
Таблица отражает официальные семейства на дату фактчека. Она не перечисляет каждую мобильную и OEM-модификацию.
Архитектура и класс | Примеры GPU | Compute capability | Практический статус CUDA |
|---|---|---|---|
Blackwell data center | B200, GB200 | 10.0 | актуальная поддержка Toolkit и драйвера |
Blackwell Ultra | B300, GB300 | 10.3 | актуальная поддержка, нужна свежая сборка software stack |
Blackwell workstation и GeForce | RTX PRO Blackwell, GeForce RTX 5090, 5080, 5070 Ti, 5070, 5060 Ti, 5060, 5050 | 12.0 | актуальная поддержка, старый framework wheel может не содержать нужного GPU-кода |
GB10 | NVIDIA GB10 в DGX Spark | 12.1 | актуальная поддержка, проверяется конкретный platform stack |
Hopper | H100, H200, GH200 | 9.0 | актуальная поддержка для AI и HPC |
Ada Lovelace | L4, L40, L40S, RTX 6000 Ada, RTX 5000 Ada, GeForce RTX 40 | 8.9 | актуальная поддержка |
Ampere data center | A100, A30 | 8.0 | актуальная поддержка |
Ampere server, workstation и GeForce | A40, A10, A16, A2, RTX A6000, RTX A5000, GeForce RTX 30 | 8.6 | актуальная поддержка |
Turing | T4, Quadro RTX, GeForce RTX 20, поддерживаемые GTX 16 | 7.5 | актуальная архитектурная поддержка, но проверяется конкретная модель и framework build |
Jetson | T5000, T4000, AGX Orin, Orin NX, Orin Nano | 11.0 или 8.7 | поддержка зависит также от версии JetPack и платформы Jetson |
В каталоге Start Server собраны серверные видеокарты и GPU-ускорители NVIDIA и AMD. Фильтр по производителю помогает отделить CUDA-устройства NVIDIA от ускорителей AMD, которые работают через ROCm и другие backends.
Поддерживают ли RTX 50, RTX 40, RTX 30 и RTX 20 CUDA
Да. GeForce RTX 50 основаны на Blackwell и в официальной таблице имеют compute capability 12.0. Серии RTX 40 относятся к Ada с CC 8.9, RTX 30 к Ampere с CC 8.6, RTX 20 к Turing с CC 7.5.
При этом новая RTX 5090 или RTX 5060 может не заработать со старым PyTorch wheel. Причина не в отсутствии CUDA: бинарный пакет мог быть выпущен до появления архитектуры и не содержать совместимого cubin или PTX. Для новой GPU проверяют не только драйвер, но и список архитектур в framework, container image и custom extensions.
Поддерживают ли GTX CUDA
Многие GTX поддерживают CUDA аппаратно, но их программный статус различается. Turing-модели GTX 16 находятся ближе к актуальному стеку. GeForce GTX 10 построены на Pascal, а GTX 900 на Maxwell. Для Pascal и Maxwell новым пределом сборки остается CUDA Toolkit 12.x: в CUDA 13 offline compilation и CUDA libraries для этих архитектур удалены.
Покупать старую GTX только потому, что у нее есть CUDA, рискованно. Следует проверить необходимую версию framework, compute capability, объем VRAM, поддерживаемые data types и жизненный цикл драйвера. Для локального эксперимента такая карта иногда пригодна, для новой production-системы она создает технический долг.
Tesla, Quadro и RTX PRO
Tesla является историческим брендом серверных ускорителей и охватывает разные поколения: T4 относится к Turing, V100 к Volta, P100 к Pascal, а K-серия к Kepler. Слово Tesla не гарантирует поддержку современным Toolkit.
Legacy GPU и предел поддержки
Текущая матрица Toolkit, driver и архитектур NVIDIA отделяет способность старого чипа выполнять CUDA от поддержки новым software stack.
Архитектура | Примеры | Compute capability | Последняя ветка Toolkit по матрице NVIDIA | Последняя ветка драйвера по матрице NVIDIA |
|---|---|---|---|---|
Volta | V100, Titan V, Quadro GV100 | 7.0 | CUDA 12.x | R580 |
Pascal | P100, P40, P4, GeForce GTX 10 | 6.0 или 6.1 | CUDA 12.x | R580 |
Maxwell | M60, M40, GeForce GTX 900 | 5.0, 5.2 или 5.3 | CUDA 12.x | R580 |
Kepler, поздние модели | K40 и часть K-серии | 3.5 или 3.7 | CUDA 11.x | R470 |
Kepler, ранние варианты | часть GPU с CC 3.0 или 3.2 | 3.0 или 3.2 | CUDA 10.2 | R470 |
Фраза «GPU поддерживает CUDA» для V100 или GTX 1080 остается верной на аппаратном уровне. Фраза «GPU поддерживает CUDA 13» уже неверна для компиляции и библиотек под эту архитектуру. Практическое решение состоит в фиксации совместимой старой ветки или замене ускорителя.
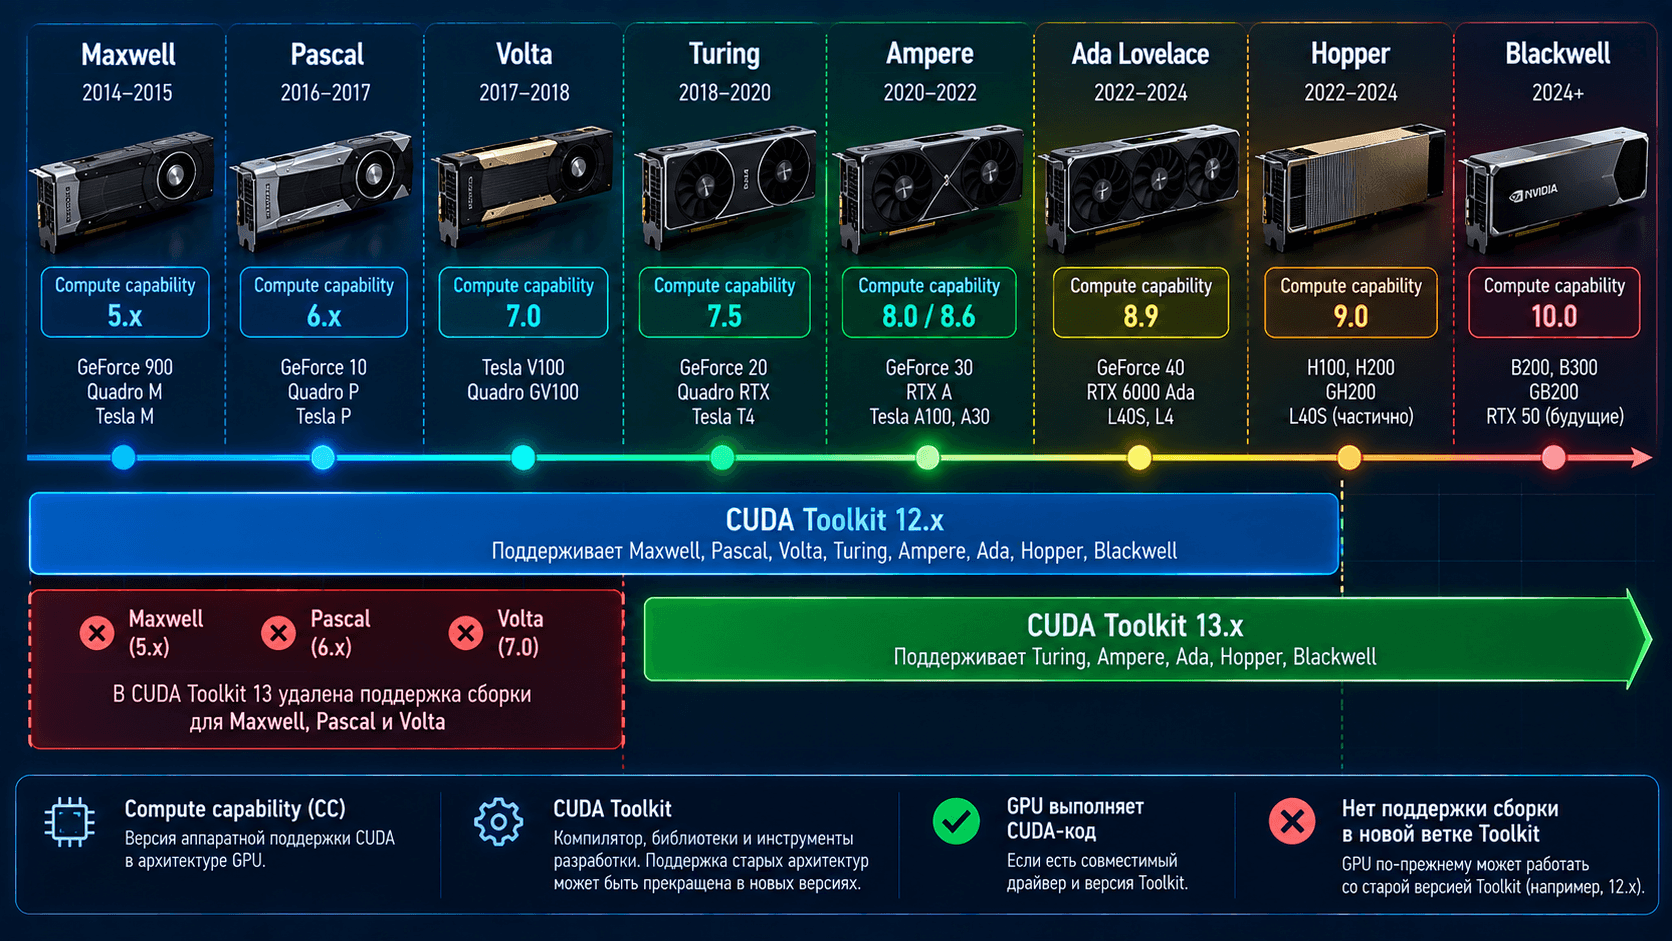
Что такое compute capability
Compute capability, или CC, обозначает набор аппаратных возможностей и инструкций архитектуры NVIDIA GPU. Значение записывается как major.minor, например 8.0 для A100, 8.9 для L40S и RTX 4090, 9.0 для H100, 10.0 для B200 или 12.0 для GeForce RTX 5090.
В параметрах компилятора та же архитектура записывается как sm_80, sm_89, sm_90 или sm_120. Готовый бинарный код GPU называется cubin. Пакет приложения может содержать cubins для нескольких архитектур и промежуточный код PTX для JIT-компиляции драйвером.
До выбора версии CUDA полезно ответить на три разных вопроса:
поддерживает ли Toolkit генерацию кода для compute capability GPU;
содержит ли готовая библиотека cubin или PTX, подходящий этому GPU;
способен ли установленный driver загрузить и выполнить этот код.
GPU одной major-ветки имеют определенные правила бинарной совместимости, но перенос между разными major compute capabilities нельзя предполагать. Например, cubin для CC 8.6 не является бинарником для CC 9.0. PTX способен дать forward compatibility, если он включен в пакет и поддерживается установленным драйвером.
CUDA-ядра: что это и сколько их нужно
CUDA cores являются арифметическими исполнительными блоками внутри SM NVIDIA GPU. Они выполняют операции над числами в рамках запущенных warps. Это аппаратная характеристика, а не отдельные мини-процессоры с независимыми программами.
Количество CUDA-ядер полезно при сравнении близких моделей одного поколения, если остальные параметры похожи. Сравнивать только это число между Turing, Ampere, Ada и Blackwell некорректно. На скорость влияют архитектура SM, частоты, тип и ширина операций, пропускная способность памяти, размер кэшей, occupancy, характер kernels и эффективность libraries.
CUDA, Tensor и RT cores решают разные задачи:
Блок | Для чего предназначен | Когда важен |
|---|---|---|
CUDA cores | общие арифметические операции, FP32, integer и другие поддерживаемые инструкции | custom kernels, simulation, preprocessing, часть AI и graphics workloads |
Tensor Cores | ускоренные матричные операции в поддерживаемых форматах | обучение и инференс нейросетей, dense linear algebra |
RT Cores | аппаратное ускорение операций трассировки лучей | rendering, visualization, некоторые spatial workloads |
Четыре уровня совместимости CUDA
1. GPU и compute capability
Полная модель должна присутствовать в актуальной или legacy-таблице NVIDIA. Затем фиксируют CC. Это отвечает на аппаратный вопрос, но не определяет весь software stack.
2. Driver
Новая ветка CUDA требует минимальную версию NVIDIA driver. Более новый драйвер обычно способен запускать приложения, собранные старым Toolkit, благодаря backward compatibility. Запуск более нового runtime на старом драйвере допускается только в документированных режимах minor или forward compatibility и с ограничениями.
3. Runtime и Toolkit
Toolkit используется для сборки, а runtime нужен приложению при исполнении. Их версии могут различаться. Наличие /usr/local/cuda не доказывает, что Python-пакет использует именно эту установку.
4. Framework, container и extensions
PyTorch wheel, TensorFlow package, container image или LLM runtime поставляется со своим набором libraries и скомпилированных архитектур. Custom CUDA extension тоже имеет собственные build targets. Именно на этом уровне часто появляется ошибка на новом или очень старом GPU, хотя nvidia-smi исправно видит устройство.
Для production имеет смысл фиксировать весь baseline одной строкой:
GPU model + CC + driver + runtime/toolkit + framework + container digest + custom extensions
Такой baseline легче воспроизвести, протестировать и обновлять по одному контролируемому изменению.
Как проверить, поддерживает ли GPU CUDA
Шаг 1. Узнайте точную модель
В Linux устройство можно увидеть командой:
lspci | grep -i nvidiaДля установленного драйвера удобнее:
nvidia-smiЗапишите полное имя GPU, driver version и список устройств. В multi-GPU системе проверьте, что видны все ускорители.
Шаг 2. Найдите compute capability
Сопоставьте точную модель с официальной таблицей NVIDIA. Не определяйте CC по объему памяти, названию серии или числу CUDA-ядер. OEM и мобильные варианты тоже требуют точной идентификации.
Шаг 3. Не путайте версию в nvidia-smi с установленным Toolkit
Поле CUDA Version в nvidia-smi показывает последнюю версию CUDA, которую способен поддержать драйвер. Оно обычно, но не всегда совпадает с установленным Toolkit. Версию compiler toolkit проверяют отдельно:
nvcc --versionЕсли nvcc отсутствует, это не доказывает поломку CUDA. На inference-узле может быть установлен только driver, а runtime libraries приходят внутри container или Python environment.
Шаг 4. Проверьте CUDA в PyTorch
import torch

print("CUDA available:", torch.cuda.is_available())
print("PyTorch CUDA build:", torch.version.cuda)

if torch.cuda.is_available():
    print("GPU:", torch.cuda.get_device_name(0))
    print("Compute capability:", torch.cuda.get_device_capability(0))
    print("Devices:", torch.cuda.device_count())
torch.cuda.is_available() отвечает, доступен ли CUDA backend из текущего Python process. torch.version.cuda относится к CUDA-ветке сборки PyTorch, а не обязательно к локальному nvcc.
Шаг 5. Выполните реальную операцию
Успешное обнаружение устройства еще не проверяет kernels, память и необходимый data type. Минимальный smoke test должен создать tensor на GPU и выполнить операцию:
import torch

assert torch.cuda.is_available()
x = torch.randn((2048, 2048), device="cuda")
y = x @ x
torch.cuda.synchronize()
print(y.shape)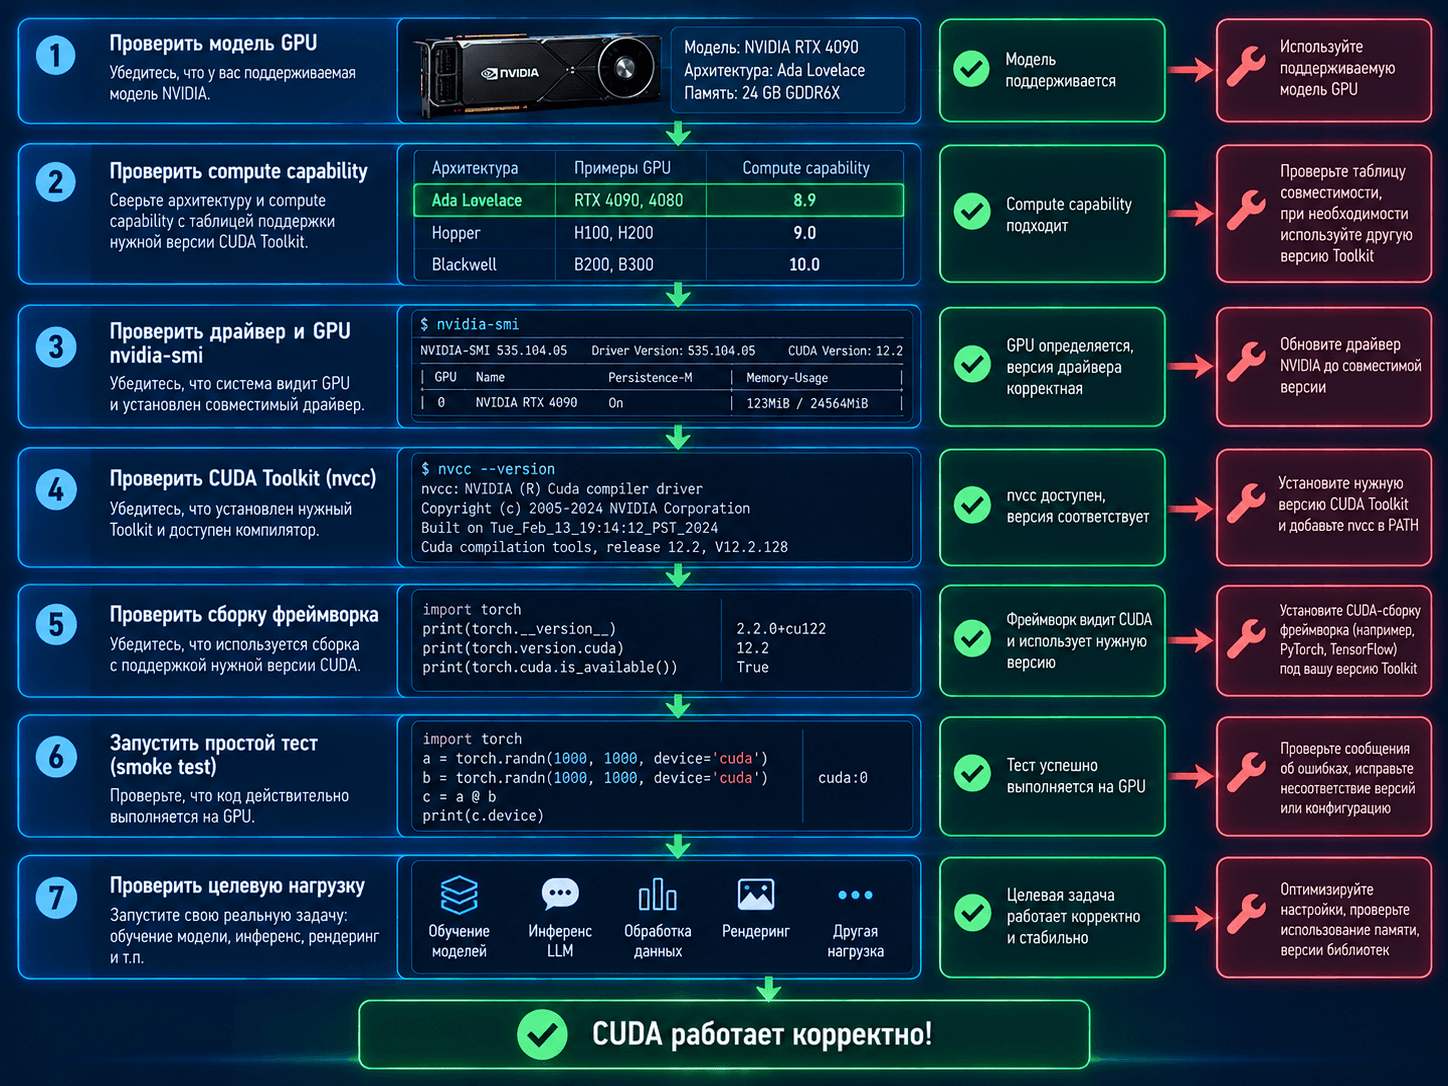
Нужно ли устанавливать CUDA Toolkit для PyTorch
Для готового PyTorch wheel полный локальный CUDA Toolkit часто не нужен. Пакет устанавливается под конкретную CUDA-ветку и получает необходимые runtime dependencies, а системе остается совместимый NVIDIA driver. Точную команду следует брать из официального селектора PyTorch для своей ОС и package manager.
Toolkit нужен, если команда компилирует собственные CUDA kernels, собирает extensions из исходников, использует nvcc, разрабатывает на CUDA C++ или применяет инструменты, которым требуется системная установка. В этом случае проверяют также поддерживаемый host compiler и build system.
Практический порядок для Linux или Windows:
Определить модель GPU и compute capability.
Выбрать поддерживаемые версии ОС, driver и framework.
Установить NVIDIA driver официальным способом.
Установить PyTorch, container или другой runtime под выбранную CUDA-ветку.
Добавить Toolkit только при необходимости сборки.
Выполнить smoke test и тест целевой модели.
Зафиксировать версии в deployment manifest.
Одновременное смешение package manager, standalone installer, Conda, pip и нескольких путей /usr/local/cuda-* усложняет диагностику. Для сервера лучше заранее выбрать один управляемый способ развертывания и отделить host driver от versioned containers.
Частые ошибки CUDA и их смысл
torch.cuda.is_available() возвращает False
Проверяют, видит ли ОС GPU, загружен ли NVIDIA driver, установлена ли CUDA-сборка PyTorch и не скрыты ли устройства переменной CUDA_VISIBLE_DEVICES. CPU-only wheel не начнет использовать GPU после одной установки Toolkit.
PyTorch not compiled with CUDA enabled
Текущая сборка PyTorch не содержит CUDA backend. Требуется установить официальный CUDA-enabled package, совместимый с платформой. Обновление драйвера само по себе не превращает CPU-сборку в CUDA-сборку.
CUDA driver version is insufficient
Runtime или приложение требует более новый driver. Сначала сверяют официальную матрицу минимальных версий, затем обновляют driver либо используют совместимую ветку runtime. Случайная замена системных libraries может замаскировать проблему и нарушить другие environments.
No kernel image is available for execution on the device
В пакете нет подходящего GPU-кода для compute capability устройства. Ошибка характерна для нового GPU со старым wheel и для legacy GPU, исключенного из свежей сборки. Решение выбирают по поддерживаемым architectures: другая версия пакета, пересборка с нужным target или замена GPU.
CUDA out of memory
VRAM не хватает для текущего набора weights, activations, KV cache, batch, workspace и служебных allocations. Переустановка CUDA редко решает такую проблему. Нужна диагностика CUDA Out of Memory при инференсе LLM с измерением владельцев памяти и воспроизводимого workload.
Все компоненты видны, но приложение медленное
Проверяют загрузку GPU, CPU feeding, transfers, batch size, memory bandwidth, kernel occupancy, precision, thermal или power throttling и multi-GPU communication. Рабочий CUDA context подтверждает совместимость, но не производительность. Для production полезен постоянный мониторинг GPU utilization, VRAM, power, clocks и ошибок.
CUDA для искусственного интеллекта
В AI CUDA служит базовым слоем, через который frameworks обращаются к NVIDIA GPU. Пользователь пишет модель в PyTorch, а ниже работают CUDA runtime, cuBLAS, cuDNN, специализированные kernels, Tensor Cores и memory allocator. Для нескольких GPU добавляются NCCL, topology и transport между ускорителями.
Типичные CUDA-нагрузки:
обучение и fine-tuning нейросетей;
инференс LLM, vision и speech models;
embeddings и reranking;
компьютерное зрение и обработка видео;
генерация изображений, аудио и видео;
научные расчеты, simulation и HPC;
data analytics и GPU-ускоренные pipelines;
rendering и профессиональная визуализация.
CUDA облегчает доступ к зрелой экосистеме, но не гарантирует, что любая NVIDIA GPU подходит задаче. Для LLM часто первым ограничением становится VRAM, для distributed training важны NVLink, NVSwitch и сеть, для video inference также учитываются media engines, а для double precision HPC нужны соответствующие вычислительные возможности.
CUDA или ROCm, OpenCL, SYCL и Metal
CUDA привязана к NVIDIA. Для других производителей и переносимого кода применяются альтернативы:
Платформа | Основной hardware | Что проверить |
|---|---|---|
CUDA | NVIDIA GPU | compute capability, driver, Toolkit/runtime, framework build |
ROCm | прежде всего поддерживаемые AMD GPU | точную support matrix GPU, ОС, kernel, ROCm и framework |
SYCL и oneAPI | несколько backends, включая Intel | реализацию, backend, device support и доступность библиотек |
OpenCL | разные CPU, GPU и accelerators | версию стандарта, качество драйвера и зрелость нужных libraries |
Metal | Apple platforms | версию macOS, Apple silicon и поддержку приложения |
Выбор по названию API дает слабый прогноз. Нужен тест конкретной модели, custom operators, precision, distributed stack и deployment tooling. Если проект рассматривает AMD вместо NVIDIA, до закупки стоит провести проверку переноса ML-нагрузки с CUDA на ROCm.
Как выбрать GPU и сервер под CUDA
Сначала зафиксируйте software stack
Составьте список frameworks, контейнеров, libraries и custom extensions. Укажите допустимые версии driver и runtime, нужные compute capabilities, precision и operating system. Если используется vendor container, сохраните точный tag или digest.
Затем рассчитайте память
Модель должна помещаться вместе с runtime overhead, activations, KV cache, batch и временными buffers. Для нескольких GPU заранее определяют data, tensor, pipeline или model parallelism. Суммарная VRAM нескольких карт не всегда образует один прозрачный пул.
Сравните вычислительные возможности
Проверяйте поддерживаемые data types и Tensor Core paths, memory bandwidth, throughput на целевой workload и ограничения конкретных libraries. Количество CUDA-ядер оставьте одной из характеристик, а не итоговым рейтингом.
Проверьте форм-фактор и платформу
PCIe-карта, SXM-модуль и rack-scale система не взаимозаменяемы. Пассивному серверному ускорителю нужен рассчитанный airflow. Для каждой конфигурации проверяют slots, lanes, bifurcation, NUMA, питание, connectors, размеры, cooling и vendor support matrix сервера.
Учтите связь между GPU
Одна GPU может общаться с CPU и storage через PCIe. Для нескольких ускорителей важны peer-to-peer paths, NVLink или NVSwitch, PCIe switches и расположение относительно CPU sockets. Между узлами добавляются NIC, GPUDirect, InfiniBand или Ethernet/RoCE и NCCL topology.
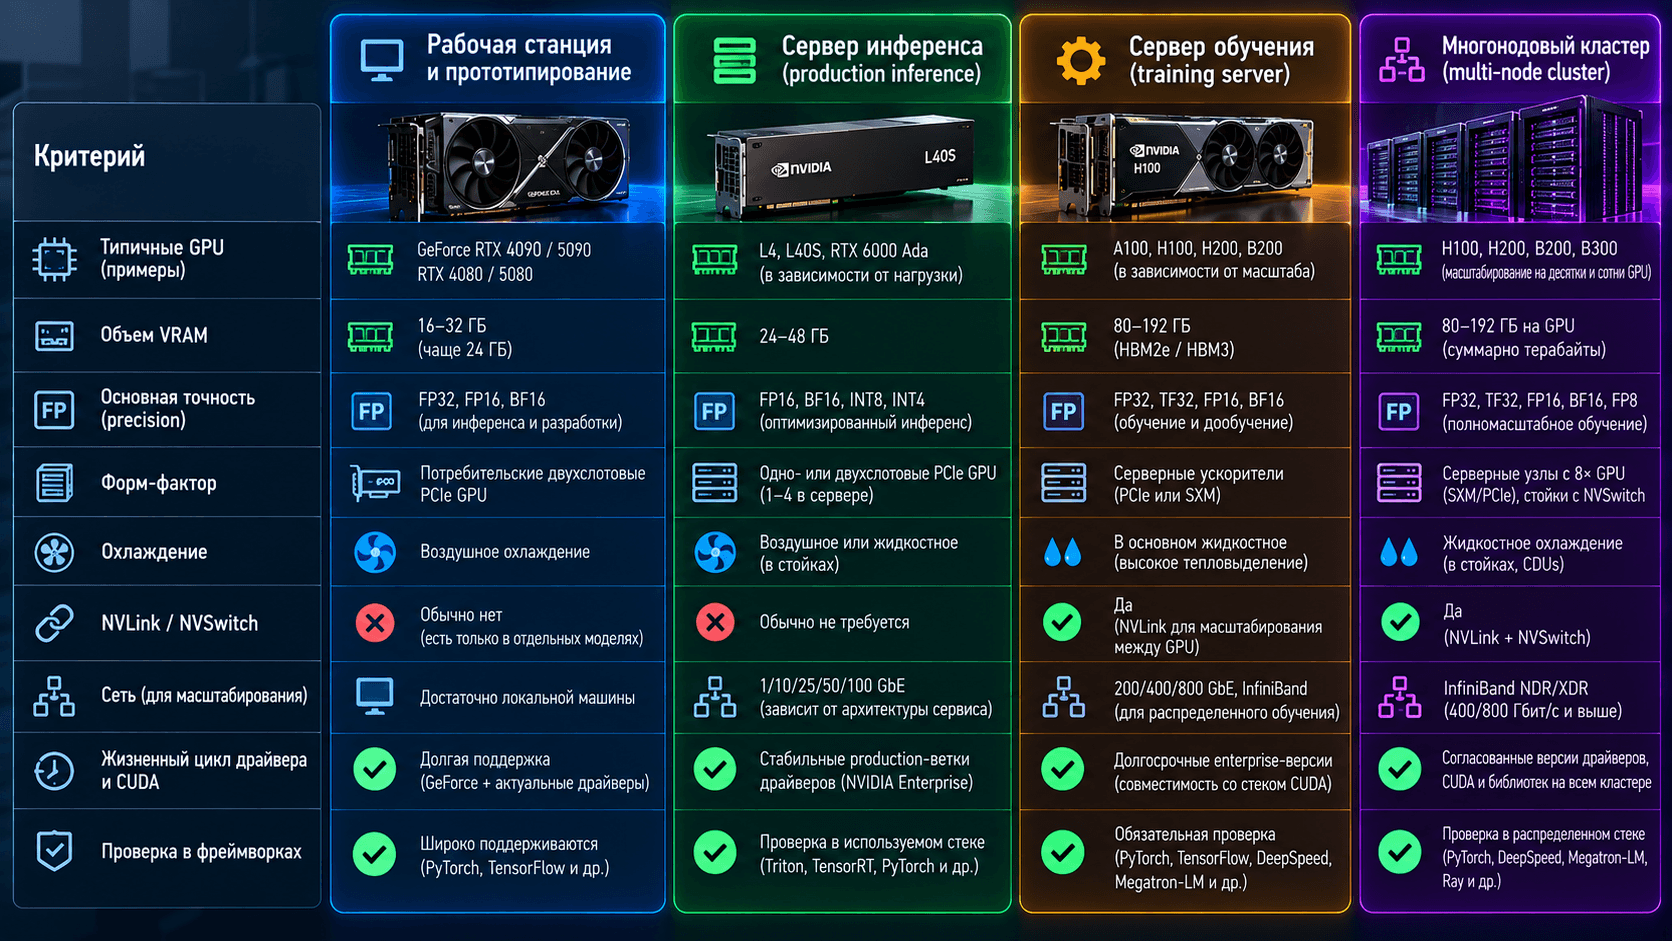
Разделите workstation и server use case
GeForce подходит для разработки, прототипов и части однопользовательских задач, если хватает VRAM и устраивают эксплуатационные ограничения. Профессиональные и data center GPU предлагают другие объемы памяти, форм-факторы, охлаждение, RAS, virtualization, MIG и lifecycle, причем набор функций зависит от модели.
Для умеренного inference и mixed workloads можно рассмотреть серверы с NVIDIA L40S и L4. Карточка NVIDIA L40 48 GB показывает класс PCIe-ускорителя с большой GDDR6-памятью. Для обучения и HPC доступны серверы с NVIDIA H100, а Ampere-системы могут использовать NVIDIA A100 SXM4 80 GB в совместимой HGX-платформе.
Выбирать GPU только по наличию CUDA не следует. Полный порядок сравнения VRAM, software support, topology, power и cooling приведен в материале как выбрать видеокарту для ИИ, нейросетей и LLM.
Чек-лист совместимости перед закупкой
Записана точная модель каждого NVIDIA GPU.
Найдено значение compute capability в официальной таблице.
Выбран Toolkit или runtime, который поддерживает архитектуру.
NVIDIA driver соответствует требованиям runtime и ОС.
Framework build содержит поддержку нужной архитектуры.
Custom CUDA extensions собираются с правильными targets.
Модель помещается в VRAM с запасом на runtime и рабочие buffers.
Нужные data types и Tensor Core paths поддерживаются hardware и libraries.
Сервер поддерживает GPU по механике, PCIe, firmware, питанию и охлаждению.
Для multi-GPU проверены P2P, NVLink или NVSwitch и NCCL topology.
Для кластера рассчитаны сеть, storage и коллективные операции.
Выполнен smoke test и benchmark целевой workload.
Зафиксированы driver, container, framework и extensions.
Подготовлен план обновления без одновременной замены всего стека.
Частые вопросы о CUDA
Что такое CUDA?
CUDA представляет собой платформу ускоренных вычислений и программную модель NVIDIA. Она позволяет приложениям запускать параллельный код на совместимых NVIDIA GPU и использовать оптимизированные библиотеки для AI, HPC, обработки данных и графики.
Какие видеокарты поддерживают CUDA?
CUDA поддерживают CUDA-capable GPU NVIDIA. К актуальным поколениям относятся Blackwell, Hopper, Ada, Ampere и Turing. Старые Volta, Pascal, Maxwell и Kepler являются legacy и требуют соответствующей старой ветки Toolkit и driver.
Поддерживает ли AMD CUDA?
Нет, AMD GPU не являются официальными CUDA devices. Для поддерживаемых AMD accelerators применяется ROCm, а также другие переносимые API. Слои трансляции имеют собственные ограничения и не равны нативной поддержке NVIDIA CUDA.
Что такое CUDA-ядра в видеокарте?
Это арифметические исполнительные блоки внутри streaming multiprocessors NVIDIA GPU. Они участвуют в выполнении CUDA threads, но не являются независимыми аналогами CPU cores. Сравнивать GPU только по их количеству нельзя.
Чем CUDA-ядра отличаются от Tensor Cores?
CUDA cores выполняют общие поддерживаемые арифметические инструкции. Tensor Cores специализированы на матричных операциях в определенных форматах и особенно важны для нейросетей. Наличие Tensor Cores не отменяет работу CUDA cores и memory subsystem.
Как узнать версию CUDA?
Сначала уточните, какую версию нужно узнать. nvidia-smi показывает максимальную CUDA-версию, поддерживаемую driver. nvcc --version показывает compiler toolkit. torch.version.cuda показывает CUDA-ветку, под которую собран текущий PyTorch.
Нужно ли устанавливать CUDA Toolkit для PyTorch?
Для официального готового wheel часто достаточно совместимого NVIDIA driver, потому что runtime dependencies устанавливаются вместе с Python environment. Полный Toolkit нужен для nvcc, сборки custom extensions и разработки CUDA-кода.
Почему PyTorch не видит GPU, хотя nvidia-smi работает?
Возможны CPU-only сборка PyTorch, неподходящий wheel, скрытое устройство, несовместимая architecture, проблема container runtime или конфликт libraries. Проверка идет от torch.cuda.is_available() и версии build к реальной операции на tensor.
Поддерживают ли GeForce RTX 5090 и RTX 5060 CUDA?
Да. GeForce RTX 50 входят в официальную таблицу NVIDIA и имеют compute capability 12.0. Для них нужен достаточно новый driver и framework build, содержащий код для Blackwell consumer GPU.
Поддерживает ли GeForce GTX 1080 CUDA 13?
GTX 1080 на Pascal аппаратно поддерживает CUDA, но CUDA Toolkit 13 удалил offline compilation и library support для Pascal. Для этой архитектуры последней поддерживаемой веткой Toolkit является CUDA 12.x.
Можно ли запускать CUDA на CPU?
CPU выполняет host-код CUDA-приложения, но CUDA kernels предназначены для совместимого NVIDIA GPU. CPU backend конкретного framework является отдельным путем исполнения и не превращает процессор в CUDA device.
Работает ли CUDA на ноутбуке?
Да, если в ноутбуке установлен совместимый NVIDIA GPU и подходящий driver. Следует проверить точную мобильную модель, compute capability, доступную VRAM, режим hybrid graphics, power limits и поддержку GPU приложением.
Подбор CUDA-совместимой конфигурации
Start Server подбирает отдельные NVIDIA GPU, готовые AI-серверы и multi-GPU системы под конкретный software stack. Для расчета нужны модель или workload, framework и container, режим training или inference, precision, необходимая VRAM, число пользователей, требования к latency и план масштабирования.
Инженерная проверка охватывает compute capability, driver и runtime, GPU form factor, PCIe-topology, CPU, RAM, NVMe, сеть, питание и cooling. Такой подход снижает риск получить формально CUDA-capable оборудование, на котором не собирается extension, не помещается модель или не достигается требуемый throughput.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


