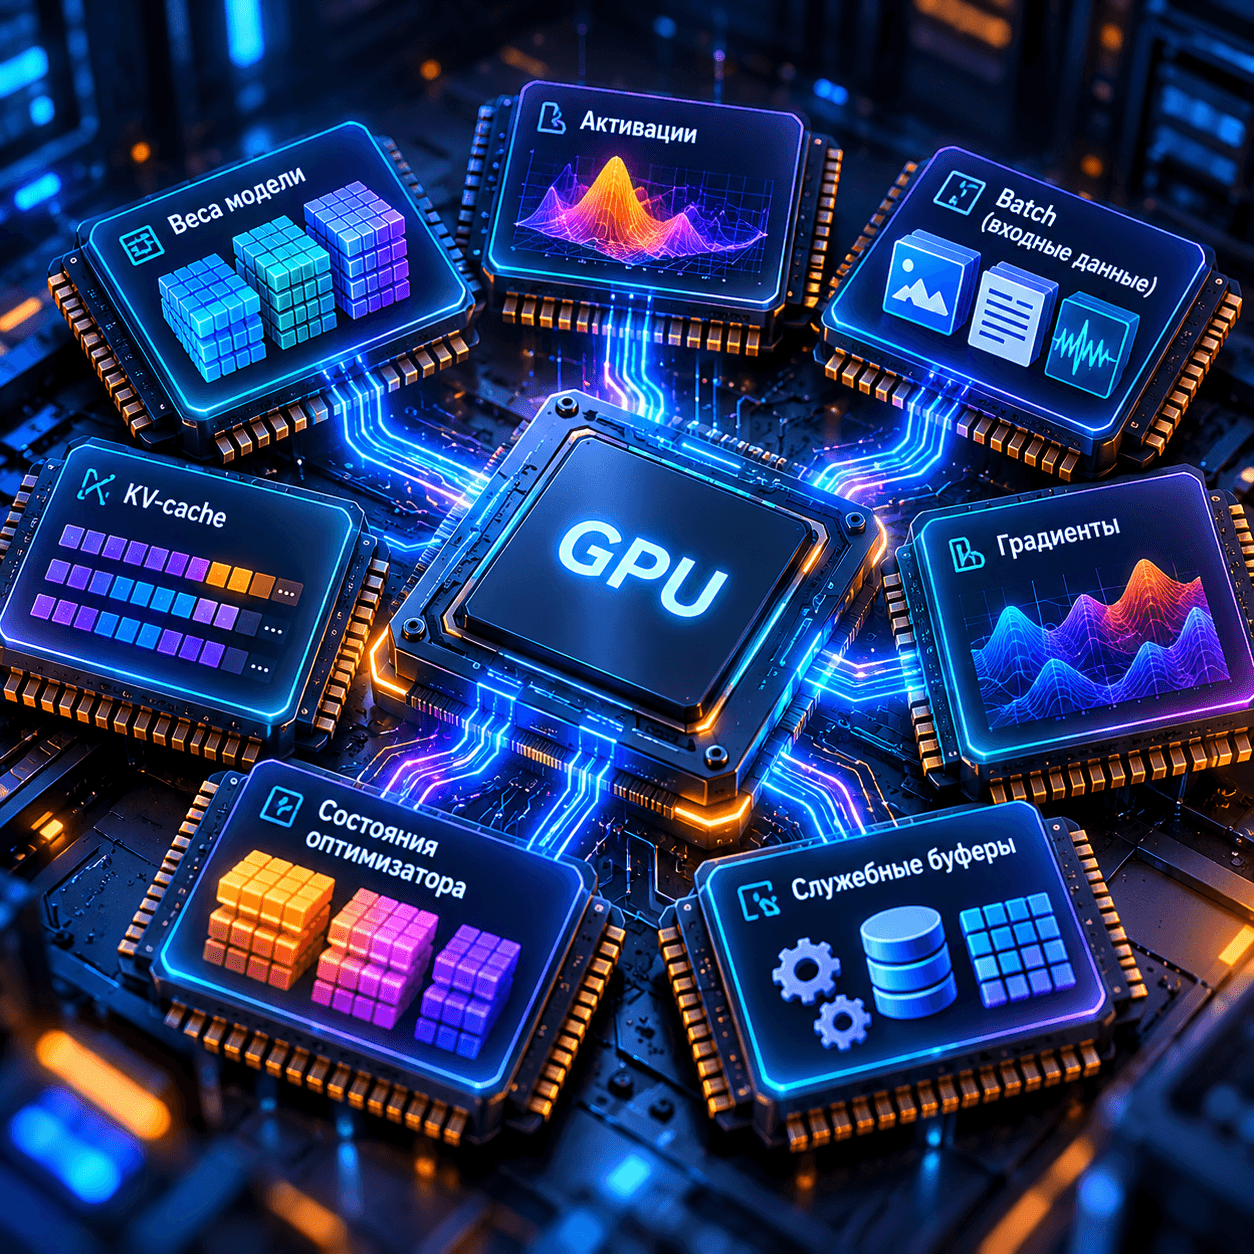
Видеопамять, или VRAM, это память, с которой графический процессор работает напрямую. В AI-нагрузках она хранит веса модели, входные тензоры, активации, рабочие буферы, а при обучении еще градиенты и состояния оптимизатора. Для LLM-инференса к этому добавляется KV-cache.
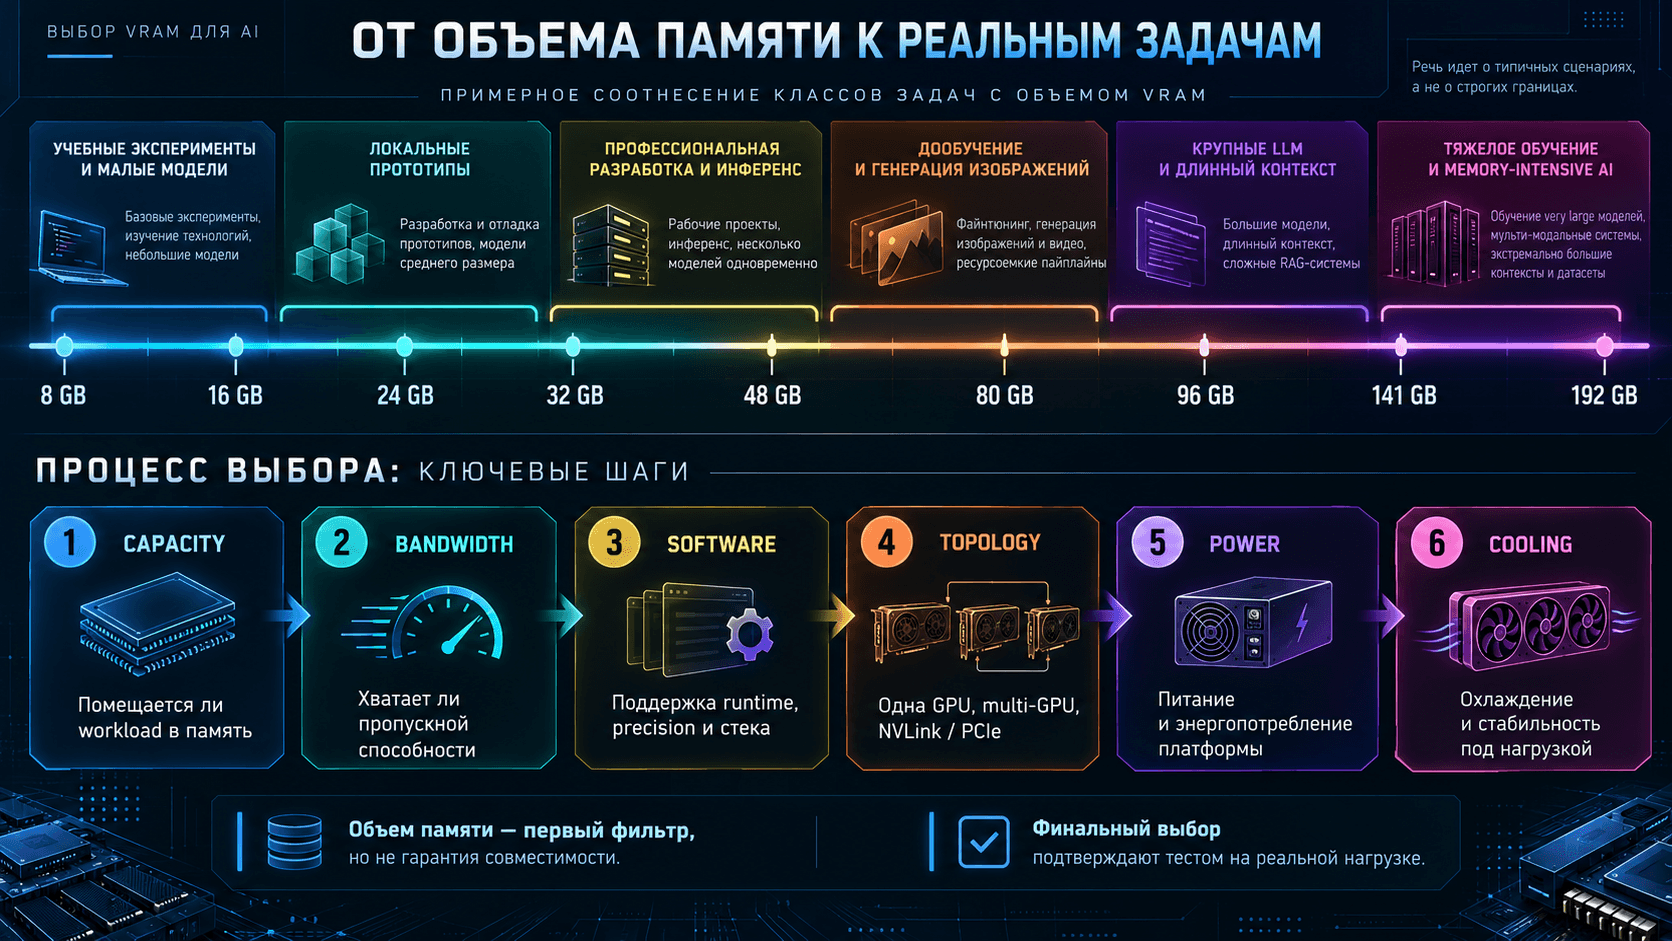
Короткий ответ по объему: 8-16 ГБ используют для учебных и локальных экспериментов с небольшими моделями, 24-48 ГБ дают больше пространства для профессиональной разработки, инференса и parameter-efficient fine-tuning, а 80-192 ГБ на один ускоритель рассматривают для крупных моделей, длинного контекста и тяжелого обучения. Это ориентиры для формирования shortlist, а не гарантия совместимости. Точный объем зависит от модели, формата весов, batch size, контекста, числа одновременных запросов и программного стека.
Если задача не помещается в VRAM, высокая вычислительная мощность GPU не устраняет ограничение. Запуск завершится с ошибкой out of memory, если не уменьшить рабочую нагрузку, не распределить ее или не настроить перенос части данных в системную RAM, обычно с потерей скорости. Поэтому при выборе видеокарты для ИИ, нейросетей и LLM сначала проверяют вместимость, затем производительность и экономику системы.
Что такое видеопамять VRAM
VRAM расшифровывается как Video Random Access Memory. Исторически этим названием обозначали конкретный тип двухпортовой памяти, но сегодня термин обычно используют шире: так называют память графического процессора, включая современные GDDR и HBM.
У дискретной видеокарты микросхемы памяти находятся на плате рядом с GPU или, в случае HBM, интегрированы в один высокоплотный модуль с вычислительным кристаллом. GPU читает и записывает данные без обязательного прохода через системную оперативную память. Локальность и высокая пропускная способность нужны потому, что нейросеть выполняет большие объемы параллельных операций над тензорами.
Что хранится в видеопамяти
Состав зависит от режима:
веса модели и дополнительные параметры адаптеров;
входной batch, изображения, токены и другие GPU tensors;
промежуточные активации слоев;
градиенты при обучении;
состояния оптимизатора и master weights, если их использует training stack;
KV-cache при авторегрессионном инференсе LLM;
временные workspace, CUDA graphs, kernels, коммуникационные и framework buffers;
контексты других процессов, если GPU используется совместно.
Полный датасет обычно не обязан находиться в VRAM. Конвейер читает данные с накопителя, готовит их в RAM и передает на GPU batch за batch. Размер видеопамяти определяет рабочий набор одного шага, а не общий объем файлов проекта.
Чем VRAM отличается от оперативной памяти RAM
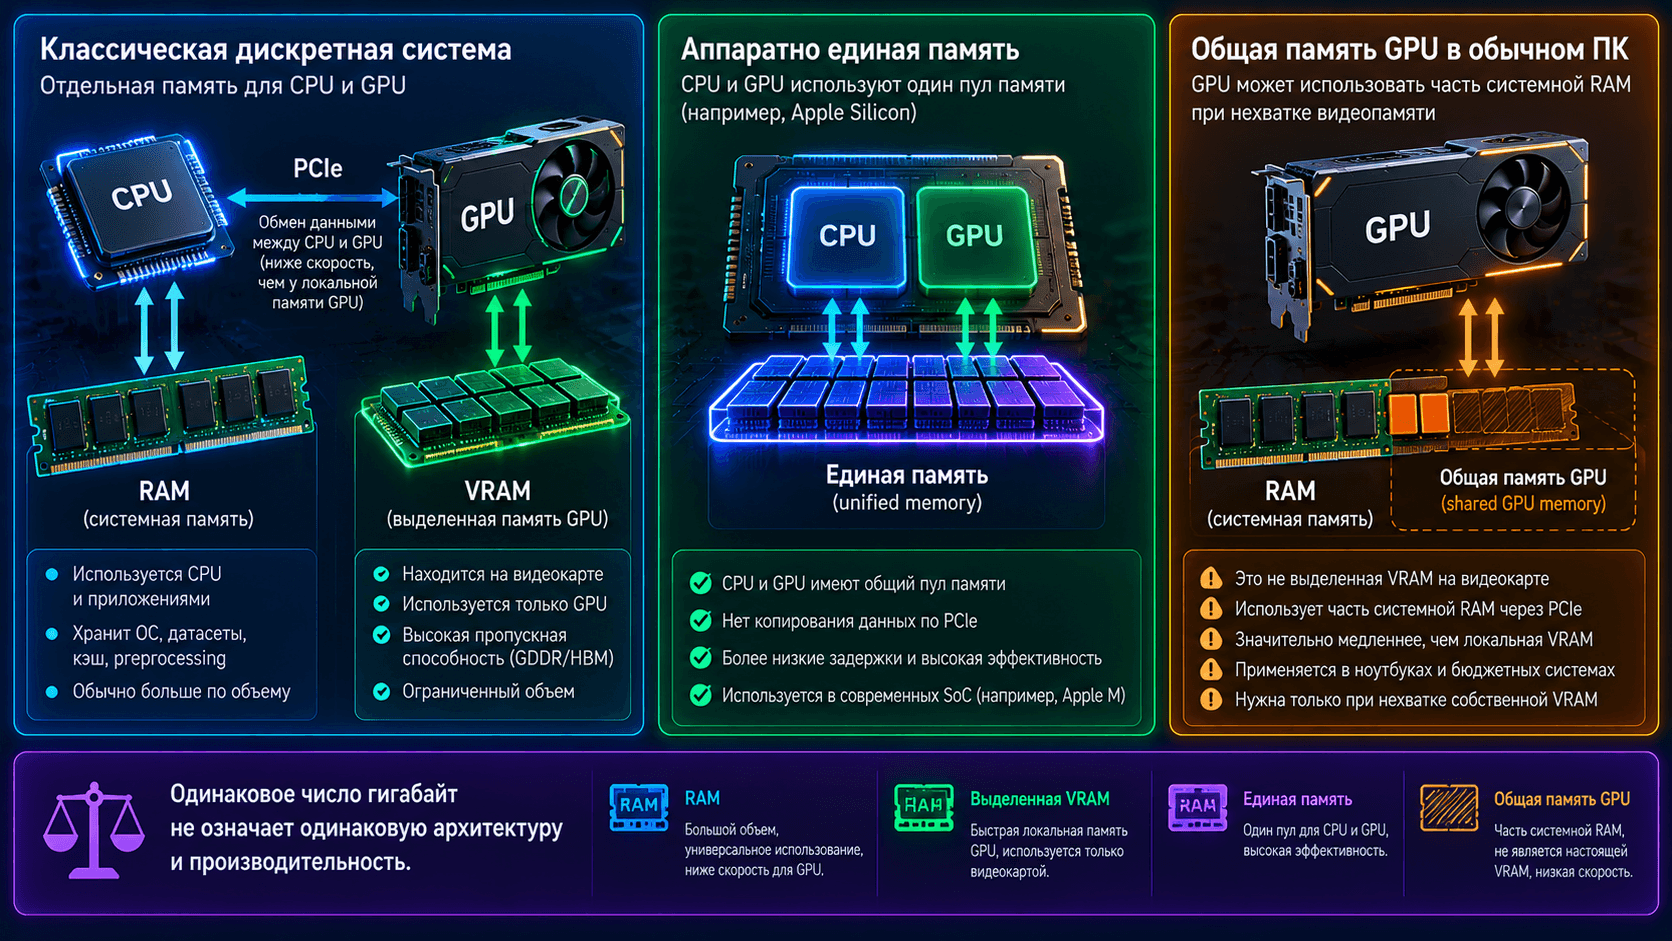
RAM и VRAM обе хранят рабочие данные, но обслуживают разные процессоры и участки pipeline.
Параметр | Системная RAM | VRAM GPU |
|---|---|---|
Основной потребитель | CPU, ОС и приложения | GPU kernels и AI runtime |
Что хранится в AI-системе | датасет, preprocessing, DataLoader, кэш файлов, API, offload | веса, тензоры, активации, KV-cache, градиенты и buffers |
Подключение | каналы памяти CPU | локальный интерфейс GPU, GDDR или HBM |
Типичное преимущество | большая емкость и универсальный доступ | высокая локальная пропускная способность для GPU |
Что происходит при нехватке | swap, завершение процесса или замедление | OOM, уменьшение нагрузки, sharding либо offload |
Большой объем RAM не превращается автоматически в дополнительную дискретную видеопамять. Offload позволяет хранить часть весов или состояний в RAM и передавать их по PCIe или другому межсоединению, но latency и bandwidth отличаются от локальной памяти GPU. Такой режим может помочь запустить модель, однако не обещает нужную скорость.
Подробный расчет памяти хоста вынесен в руководство сколько оперативной памяти нужно GPU-серверу для обучения и подготовки данных.
Выделенная, общая и единая память
В Windows встречаются показатели Выделенная память GPU и Общая память GPU. Первый обычно соответствует физической памяти дискретной видеокарты. Второй показывает часть системной RAM, которую графическая подсистема может использовать при необходимости. Складывать эти числа и считать результат эквивалентом локальной VRAM нельзя.
Интегрированная графика чаще использует системную память. В BIOS иногда можно изменить заранее зарезервированный объем, но такая настройка не добавляет физическую RAM и не превращает ее в GDDR или HBM.
Отдельный класс составляют аппаратно-когерентные системы с единой памятью CPU и GPU. Например, ASUS Ascent GX10 с 128 ГБ единой LPDDR5x дает процессору и GPU общий пул. Эти 128 ГБ нельзя описывать как обычные 128 ГБ выделенной GDDR или HBM: сравнивать нужно всю архитектуру, bandwidth, доступный приложению объем и реальную скорость модели.
Объем, тип и скорость видеопамяти
Характеристики видеопамяти нельзя свести к одному числу.
Объем VRAM
Объем задает максимальный рабочий набор, доступный GPU без переноса данных в другое место. Это жесткий фильтр вместимости: если веса и рабочие данные не помещаются, модель нужно сжимать, делить между ускорителями или выгружать часть состояний.
Производители обычно указывают десятичные гигабайты, где 1 GB равен миллиарду байт. Инструменты могут показывать двоичные GiB, где 1 GiB равен 1 073 741 824 байтам. Поэтому 24 GB соответствуют примерно 22,35 GiB. Это разница единиц измерения, а не исчезнувшая память.
GDDR и HBM
GDDR6 и GDDR7 применяются в потребительских, профессиональных и части серверных видеокарт. Микросхемы располагаются вокруг GPU на плате. HBM использует память с высокой плотностью и очень широким интерфейсом рядом с вычислительным кристаллом. Она характерна для дата-центровых ускорителей и дает большую пропускную способность, но требует специализированной платформы.
Частота, шина и пропускная способность
Частота видеопамяти без типа памяти и ширины интерфейса малоинформативна. Теоретическую пропускную способность можно представить так:
bandwidth = effective data rate × bus width / 8
Формула дает верхнюю аппаратную оценку, а не скорость конкретной модели. Реальная производительность зависит от паттерна доступа, кэшей, kernels, вычислительных блоков и того, является ли workload memory-bound.
ECC и надежность
ECC помогает обнаруживать и исправлять определенные ошибки памяти. Эта функция особенно уместна для долгих вычислений и серверной эксплуатации, но не заменяет мониторинг, проверку ошибок, корректное охлаждение и резервирование сервиса.
Что занимает VRAM при инференсе и обучении
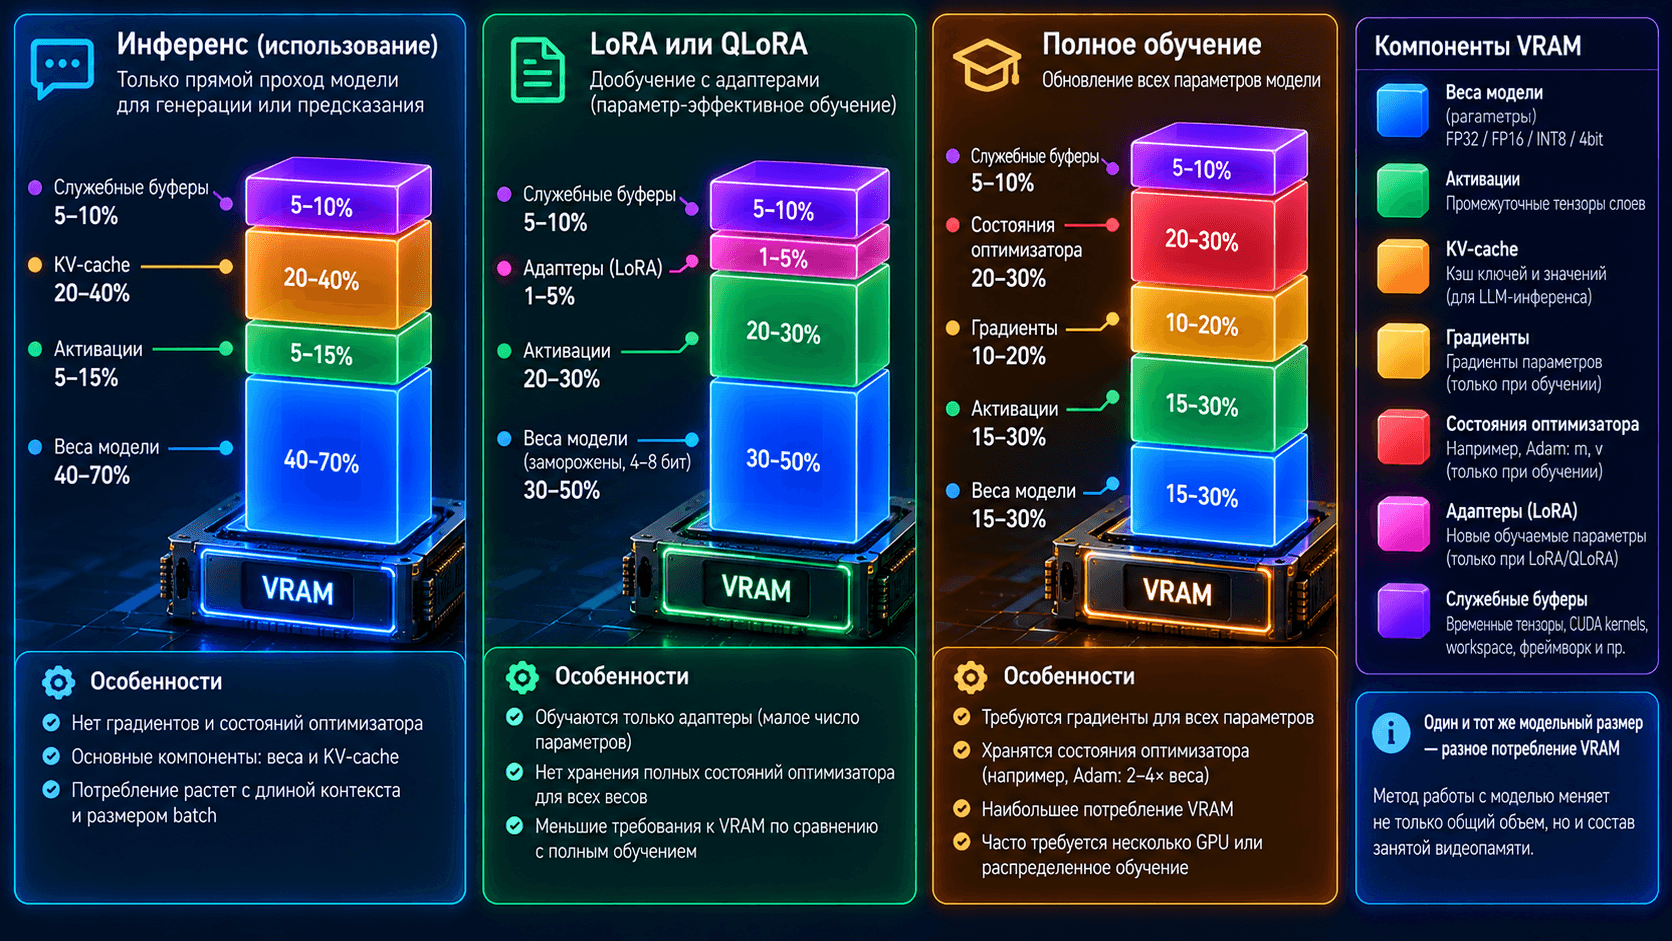
Одна и та же модель требует разный объем памяти в разных режимах.
Компонент | Инференс | Обучение |
|---|---|---|
Веса модели | нужны | нужны, иногда вместе с master copy |
Входные данные | один или несколько запросов | microbatch или batch |
Активации | временные данные forward pass | сохраняются для backward pass и часто занимают много памяти |
Градиенты | нет | нужны для обучаемых параметров |
Состояния оптимизатора | нет | нужны, объем зависит от optimizer и precision |
KV-cache LLM | растет с активными токенами и параллельностью | зависит от метода обучения, не равен production cache |
Runtime buffers | нужны | нужны, включая communication buffers при distributed training |
При обычном инференсе памяти требуется меньше, чем при полном обучении, поскольку нет градиентов и optimizer states. Но высокая параллельность, длинный контекст или большой batch способны сделать инференс memory-intensive.
В компьютерном зрении и диффузионных моделях заметную часть VRAM занимают активации. Они зависят от разрешения, batch size, архитектуры и precision. Увеличение стороны изображения повышает число пикселей по двум измерениям, поэтому переход на большее разрешение способен резко изменить memory footprint.
При полном обучении Transformer типичная mixed-precision схема с AdamW может использовать около 18 байт на параметр только под веса, градиенты и состояния оптимизатора, еще до активаций и временных буферов. Конкретное значение зависит от реализации. ZeRO, FSDP, другой optimizer, checkpointing или offload меняют раскладку памяти.
Сколько видеопамяти нужно для AI
Ни одна таблица по гигабайтам не заменяет запуск конкретной модели. Ее задача состоит в другом: отсеять явно неподходящие варианты и определить, что измерять на пилоте.
Объем | Для каких AI-сценариев рассматривают | Основное ограничение |
|---|---|---|
2-6 ГБ | учебные примеры, небольшие модели и легкий инференс | быстро заканчивается место под современные генеративные модели, batch и высокое разрешение |
8 ГБ | знакомство с локальным AI, малые quantized-модели, небольшой batch | ограниченный контекст, разрешение и пространство для обучения |
10-12 ГБ | локальные прототипы, небольшие LLM и задачи CV | нужно проверять точный checkpoint, precision и пик активаций |
16 ГБ | разработка, инференс малых и части средних quantized-моделей, небольшое дообучение | крупные модели и full fine-tuning обычно требуют иной схемы |
24 ГБ | профессиональная локальная разработка, image generation, CV, LLM-инференс и часть LoRA-задач | контекст, batch и параллельность способны исчерпать запас |
32 ГБ | более крупный рабочий набор на одной GPU, большие batch и модели | вместимость еще не означает достаточную скорость и совместимость |
40-48 ГБ | профессиональный инференс, CV training, quantized LLM и fine-tuning | для крупных моделей может потребоваться sharding или несколько GPU |
64 ГБ | серверные и профессиональные AI-нагрузки с увеличенным рабочим набором | выбор сильно зависит от software stack и межсоединений |
80-96 ГБ | крупные LLM, большой context или batch, тяжелое обучение и инференс | один ускоритель может не вместить полную модель вместе с runtime |
128 ГБ | высокоемкие ускорители или единые memory-системы | нужно различать dedicated VRAM и unified memory |
141-192 ГБ | крупные дата-центровые ускорители, memory-intensive AI и HPC | обучение или production-concurrency по-прежнему могут потребовать multi-GPU |
Объем видеопамяти 8 ГБ может быть достаточен для одного сценария и непригоден для другого. То же относится к 16, 24, 48 или 96 ГБ. Проверяется не абстрактная нейросеть, а точная комбинация model ID, revision, dtype, runtime, входных данных и режима работы.
Как рассчитать VRAM для модели
Расчет начинается не с выбора видеокарты, а с описания workload.
Зафиксируйте точную модель и версию checkpoint.
Укажите режим: инференс, LoRA, QLoRA или full fine-tuning.
Запишите dtype весов и вычислений, а для LLM также KV-cache dtype.
Определите batch, разрешение либо длину последовательности.
Для сервиса задайте число одновременно активных запросов.
Учтите runtime, parallelism, другие процессы и способ размещения модели.
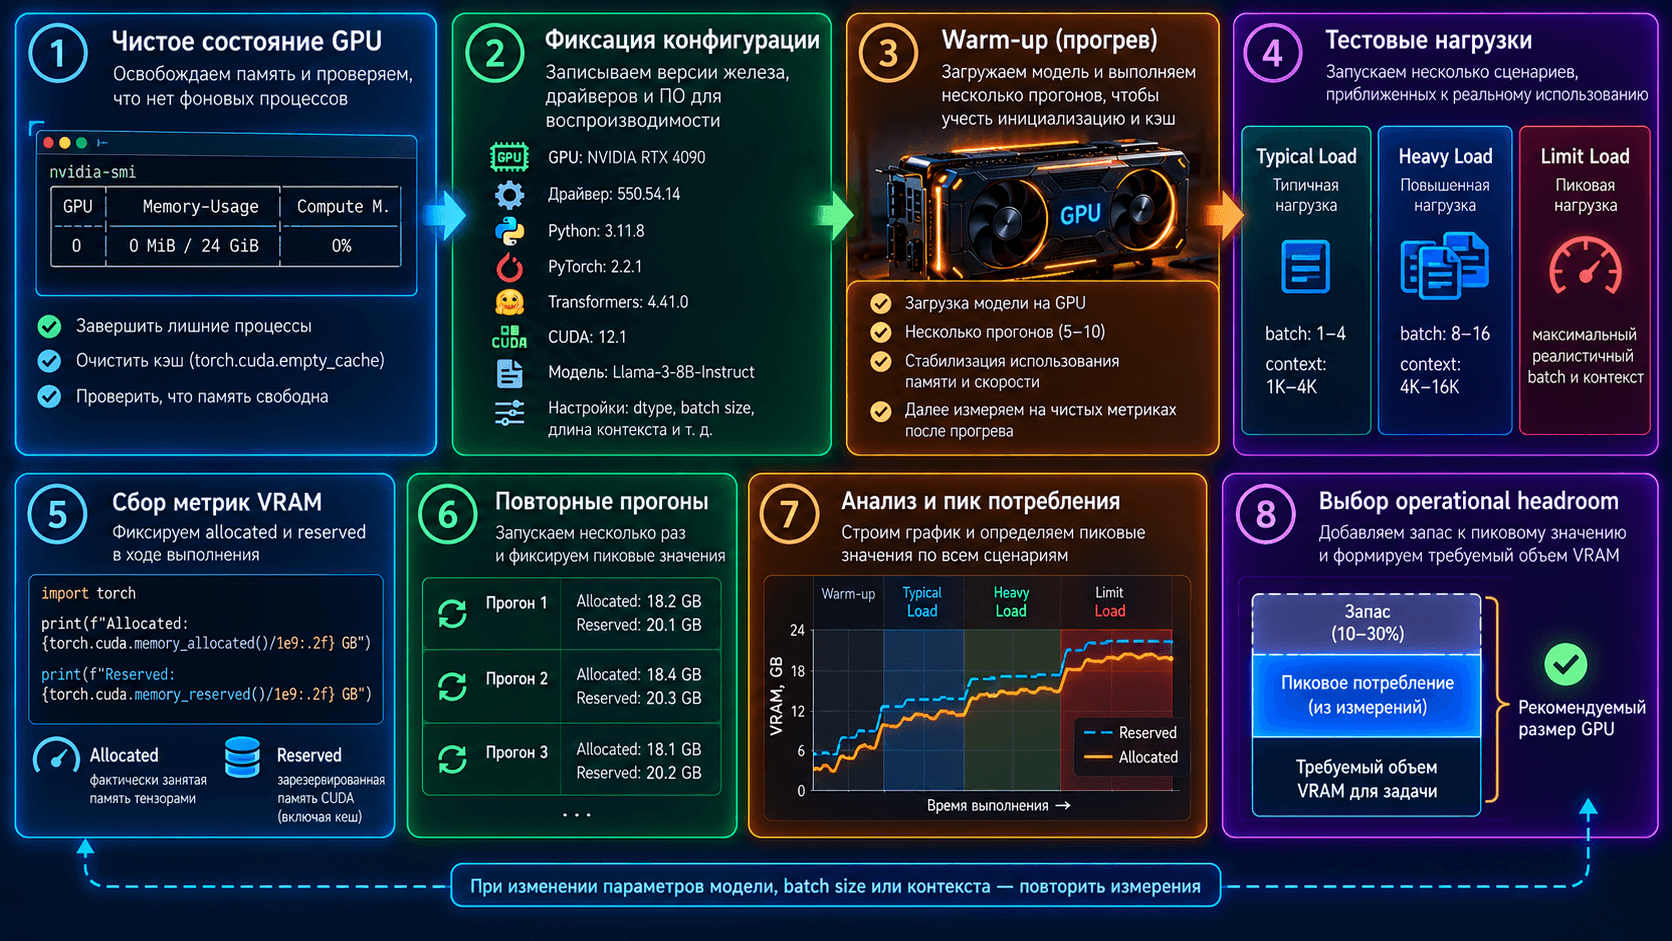
Измерьте пик на типичной, тяжелой и предельной нагрузке.
Нижняя оценка памяти весов
Для плотной модели грубая формула выглядит так:
память весов в байтах ≈ число параметров × байт на параметр
Класс модели | FP16 или BF16, 2 байта | 8-bit, около 1 байта | 4-bit, около 0,5 байта |
|---|---|---|---|
7B | 14 GB | 7 GB | 3,5 GB |
13B | 26 GB | 13 GB | 6,5 GB |
32B | 64 GB | 32 GB | 16 GB |
70B | 140 GB | 70 GB | 35 GB |
Это идеализированный payload весов. Quantized checkpoint хранит scales, metadata и иногда дополнительные tensors другого типа. Видеопамять также потребуется runtime, cache и рабочим данным. Поэтому вывод «70B в FP16 занимает 140 GB, значит подойдет GPU на 141 GB» неверен: после весов почти не остается места для выполнения запроса.
LLM: веса, KV-cache и параллельные запросы
При генерации KV-cache растет вместе с числом активных токенов. На него влияют layers, число KV-heads, head dimension, dtype, длина input и output, continuous batching и одновременные sequences. Максимальный context в model card не равен фактическому объему cache каждого запроса.
Подробная методика вынесена в отдельный расчет VRAM для LLM с учетом весов, KV-cache, контекста и параллельных запросов. В текущем хабе достаточно сохранить правило: весовая часть рассчитывается, cache определяется архитектурой и workload, а runtime overhead измеряется.
Обучение модели
Для обучения к весам добавляются градиенты, optimizer states, активации и коммуникационные buffers. В mixed precision могут одновременно существовать низкоточная копия для forward и backward и FP32 master weights для обновления. Умножать размер checkpoint на один универсальный коэффициент нельзя.
Для предварительной оценки отдельно посчитайте:
weights + master weights + gradients + optimizer states + saved activations + temporary buffers
После этого учтите распределение между GPU. Data parallel обычно реплицирует модель, а ZeRO и FSDP могут делить optimizer states, gradients и параметры. Activation checkpointing экономит память, повторно вычисляя часть forward pass и увеличивая время расчета.
Для parameter-efficient подходов базовая модель остается в памяти, но обучается только малая часть параметров. QLoRA дополнительно уменьшает весовую часть за счет квантования. Практические требования разобраны в руководстве по расчету сервера для LoRA и QLoRA.
Компьютерное зрение и генерация изображений
Здесь число параметров тоже не описывает весь расход. На пик влияют разрешение, batch size, размер feature maps, augmentation, число кадров, precision и сохраненные активации. Две модели с похожим checkpoint могут иметь разный peak VRAM.
Размер batch подбирают серией одинаковых запусков, меняя один параметр за раз. В статье об эксперименте с batch size для обработки документов на GPU описан порядок измерения без произвольного правила о запасе памяти.
Как посмотреть объем и использование видеопамяти
Паспортный объем отвечает на вопрос, сколько памяти установлено. Для AI-sizing нужен еще пик потребления на реальной нагрузке.
Windows
Откройте Диспетчер задач > Производительность > GPU. Смотрите отдельно выделенную и общую память GPU. Для дискретной видеокарты при расчете быстрой локальной памяти ориентируются на выделенную.
NVIDIA в Linux
Общий статус показывает команда:
nvidia-smiДля компактного вывода можно запросить емкость, занятое и свободное место:
nvidia-smi --query-gpu=index,name,memory.total,memory.used,memory.free --format=csvПоказатель memory.used включает не только tensors текущего Python-процесса. Память могут занимать CUDA context, другие приложения и runtime allocations.
AMD ROCm
В актуальном AMD SMI базовая сводка вызывается командой amd-smi, а непрерывный контроль VRAM доступен так:
amd-smi monitor --vram-usageВерсию CLI и названия флагов нужно сверять с установленным ROCm stack.
PyTorch
PyTorch различает память, занятую tensors, и память, зарезервированную caching allocator. Для одного прогона полезно сбросить счетчик пика и затем снять обе метрики:
import torch

torch.cuda.reset_peak_memory_stats()

# Здесь выполняется прогрев и измеряемый workload.

peak_allocated = torch.cuda.max_memory_allocated()
peak_reserved = torch.cuda.max_memory_reserved()
free_bytes, total_bytes = torch.cuda.mem_get_info()Как провести измерение
Освободите GPU от посторонних процессов и зафиксируйте исходное состояние.
Запишите точные версии модели, драйвера, runtime и библиотек.
Выполните прогрев, чтобы разовые инициализации не смешивались с установившимся режимом.
Запустите типичный workload, затем тяжелый и согласованный предельный сценарий.
Снимите peak allocated, peak reserved, общую занятую VRAM и момент OOM.
Повторите опыт, чтобы оценить разброс.
Определите эксплуатационный запас по наблюдаемой вариативности, росту нагрузки и требованиям к доступности.
Что делать, если не хватает видеопамяти
Сначала определите, какой компонент растет. Уменьшение batch не поможет, если почти всю память занимают веса. Квантование весов не устранит большой KV-cache при высокой параллельности.
Освободить память от лишних процессов
Проверьте процессы через nvidia-smi, AMD SMI или диспетчер задач. Завершать следует только известные приложения. Перезапуск процесса освобождает его контекст и утечки, но не исправляет систематически недостаточный объем.
В PyTorch empty_cache() освобождает неиспользуемый кэш allocator для других приложений. Память живых tensors функция не удаляет и сама по себе не увеличивает объем, доступный текущей модели.
Уменьшить рабочий набор
В зависимости от задачи можно снизить:
batch size или microbatch;
длину контекста и число одновременно активных sequences;
разрешение изображения или число кадров;
число параллельных workers на одной GPU;
размер временных buffers и параметры компиляции, если runtime это поддерживает.
Изменение способно повлиять на throughput, latency, сходимость или качество. После него нагрузку тестируют заново.
Использовать подходящий формат данных
FP16 и BF16 уменьшают многие tensors относительно FP32. INT8, FP8 и 4-bit quantization снижают память весов, но поддержка, скорость и влияние на качество зависят от GPU, runtime и конкретной модели. Формат checkpoint и формат вычислений являются разными параметрами.
Изменить метод обучения
Gradient accumulation позволяет сохранить эффективный batch при меньшем microbatch. Activation checkpointing обменивает память на повторные вычисления. LoRA и QLoRA сокращают число обучаемых параметров. ZeRO и FSDP делят model states между устройствами.
Применить offload
CPU или NVMe offload помогает разместить workload, который не помещается локально. Цена решения состоит в перемещении данных, большей RAM, нагрузке на PCIe и накопители, а иногда в резком росте времени шага. Offload нужно оценивать по времени выполнения, а не только по факту успешного запуска.
Перейти на GPU с большей памятью или multi-GPU
Если оптимизации нарушают требования к качеству или скорости, требуется более емкий ускоритель либо распределение модели. При повторяющейся CUDA OOM полезно пройти отдельную диагностику причин нехватки VRAM при инференсе LLM.
Складывается ли VRAM нескольких видеокарт
Физически у каждой дискретной GPU собственная память. Две карты по 24 ГБ не превращаются автоматически в одну универсальную область 48 ГБ.
Результат зависит от parallelism:
data parallel хранит копию модели на каждой GPU и делит batch, поэтому максимальный размер одной копии не увеличивается;
tensor parallel делит операции и параметры внутри слоев;
pipeline parallel распределяет группы слоев;
ZeRO и FSDP могут partition параметры, gradients и optimizer states;
независимые inference workers используют память каждой GPU отдельно и увеличивают число replicas, а не размер одной модели.
Даже при sharding суммарная VRAM не вся доступна полезной нагрузке. Нужны communication buffers, иногда реплицированные tensors и запас каждого rank. Скорость зависит от PCIe, NVLink, NVSwitch или сети между узлами.
Как выбрать видеопамять для AI-сервера
Порядок выбора выглядит так:
Capacity: помещается ли workload на одной GPU или в выбранной схеме sharding.
Bandwidth: успевает ли память подавать данные вычислительным блокам.
Compute и форматы: поддерживает ли ускоритель нужные kernels, precision и software stack.
Reliability: требуются ли ECC, RAS, partitioning и серверный режим эксплуатации.
Scale-up: как GPU связаны внутри узла и поддерживает ли приложение выбранный parallelism.
Host system: хватает ли CPU, RAM, PCIe, NVMe и сети.
Power и cooling: выдерживает ли платформа длительную расчетную нагрузку.
Для локальной разработки единая память может снять жесткую границу между RAM и VRAM, но ее производительность нужно измерять отдельно. Для дата-центровых задач применяются ускорители с выделенной HBM. Например, AMD Instinct MI300X с 192 ГБ HBM3 представляет высокоемкий OAM-класс и требует совместимой серверной платформы.
Выбрать конкретный ускоритель можно в категории видеокарт и GPU-ускорителей. Для задач дообучения собраны отдельные AI-серверы для fine-tuning моделей, но конфигурацию все равно нужно подтвердить тестом своего стека.
Частые ошибки при расчете VRAM
Считать только размер файла модели
Файл checkpoint не показывает KV-cache, активации, временные allocations и другие процессы. Для quantized-модели он также может состоять из нескольких типов tensors.
Считать максимальный context каждого пользователя
Это способно завысить оценку. Нужны распределение длины запросов, scheduler и число одновременно активных токенов. Для лимитного сценария максимальный context нужен, но его не следует выдавать за постоянную типичную нагрузку.
Складывать RAM и VRAM
Обычная системная память, dedicated VRAM и аппаратно единая память имеют разный путь доступа. Сумма гигабайт ничего не говорит о производительности.
Складывать память GPU без учета parallelism
Приложение должно уметь распределять модель или состояния. При data parallel каждая GPU по-прежнему хранит свою копию модели.
Смотреть только среднее потребление
OOM возникает на пике. Средние 18 ГБ на карте с 24 ГБ не доказывают, что редкий длинный запрос или тяжелый batch не потребует 25 ГБ.
Покупать максимальный объем без проверки скорости
Большая память полезна только тогда, когда система выполняет целевой workload с требуемым throughput и latency. После фильтра по capacity сравнивают bandwidth, compute, runtime и стоимость работы.
FAQ
Что такое VRAM простыми словами?
VRAM, или видеопамять, хранит данные, с которыми GPU работает прямо сейчас: веса модели, tensors, активации, cache и buffers. У дискретной карты это отдельная память GDDR или HBM.
На что влияет объем видеопамяти?
Он влияет на размер модели, batch, разрешение, длину контекста и число одновременных запросов, которые можно разместить без offload. После проверки вместимости на скорость влияют bandwidth и вычислительные возможности GPU.
Сколько видеопамяти нужно для нейросетей?
Для небольших экспериментов часто рассматривают 8-16 ГБ, для профессиональной локальной разработки 24-48 ГБ, для крупных моделей и тяжелого обучения 80-192 ГБ на ускоритель. Точный ответ дает измерение конкретного workload.
Хватит ли 8 ГБ VRAM для AI?
Для учебных экспериментов, небольших quantized-моделей и ограниченного инференса 8 ГБ могут быть достаточны. Большой context, batch, высокое разрешение или обучение современной генеративной модели быстро исчерпают память.
Достаточно ли 16 ГБ видеопамяти?
16 ГБ позволяют запускать больше локальных моделей и увеличивать batch относительно 8 ГБ. Совместимость зависит от checkpoint, quantization и runtime, поэтому одно число не гарантирует запуск.
Что можно делать с 24 ГБ VRAM?
24 ГБ часто используют для профессиональных прототипов, image generation, CV, инференса quantized LLM и части LoRA-задач. Предельный размер модели определяется не только весами, но и рабочими данными.
Чем видеопамять отличается от оперативной памяти?
VRAM обслуживает GPU и хранит его рабочие tensors. RAM обслуживает CPU, ОС, подготовку данных и другие сервисы. Offload связывает эти уровни, но системная RAM не становится локальной памятью дискретной GPU.
Можно ли увеличить видеопамять видеокарты?
У дискретной карты штатно добавить микросхемы VRAM нельзя. Можно уменьшить потребление, применить offload, заменить GPU или распределить совместимый workload. Настройка BIOS меняет резерв для встроенной графики, а не физическую емкость системы.
Как посмотреть, сколько VRAM занято?
В Windows используется диспетчер задач, для NVIDIA команда nvidia-smi, для AMD актуальный AMD SMI. В PyTorch дополнительно смотрят peak allocated и peak reserved, поскольку системный монитор не показывает структуру allocations фреймворка.
Почему VRAM занята после завершения операции?
Framework может сохранять свободные блоки в caching allocator для повторного использования. Память также занимают живые tensors, CUDA context или другой процесс. Сначала определяют владельца памяти, затем освобождают объект или завершают соответствующий процесс.
Что важнее для AI, объем или пропускная способность VRAM?
Сначала проверяют объем: непоместившийся workload не ускорить высокой bandwidth. Когда модель помещается, пропускная способность способна стать ограничением, особенно для memory-bound инференса и HPC.
Складывается ли видеопамять двух GPU?
Только если software stack распределяет модель или состояния между устройствами. Data parallel реплицирует модель, поэтому две карты по 24 ГБ не дают одной копии модели универсальный пул 48 ГБ.
Подбор GPU и сервера по реальному потреблению VRAM
Для расчета нужны точная модель и revision, режим работы, dtype или quantization, runtime и его версия, batch, контекст, параллельность, measured peak VRAM и требования к скорости. Для обучения дополнительно фиксируются optimizer, длина последовательности, activation checkpointing и схема distributed training.
Start Server сопоставит memory budget с GPU, количеством ускорителей, topology, CPU, RAM, NVMe, сетью, питанием и охлаждением. Начать можно с каталога AI-серверов, а финальную конфигурацию стоит выбирать после воспроизводимого теста на вашей нагрузке.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


