Скорость сети для распределённого обучения нельзя выбрать по количеству GPU. Сначала нужно определить, какая коммуникация действительно задерживает training step, какой объём данных обрабатывает критичная collective operation и за какое время она должна завершиться. Только после этого 100, 200 или 400 Гбит/с становятся кандидатами для проверки.
Практический порядок такой:
training step
↓
non-overlapped communication
↓
critical collective
↓
operation size
↓
communication time budget
↓
required effective bandwidth
↓
candidate NIC rate + NIC count
↓
topology / oversubscription
↓
NCCL или RCCL benchmark
↓
actual training step
100, 200 или 400 Гбит/с: короткий ответ
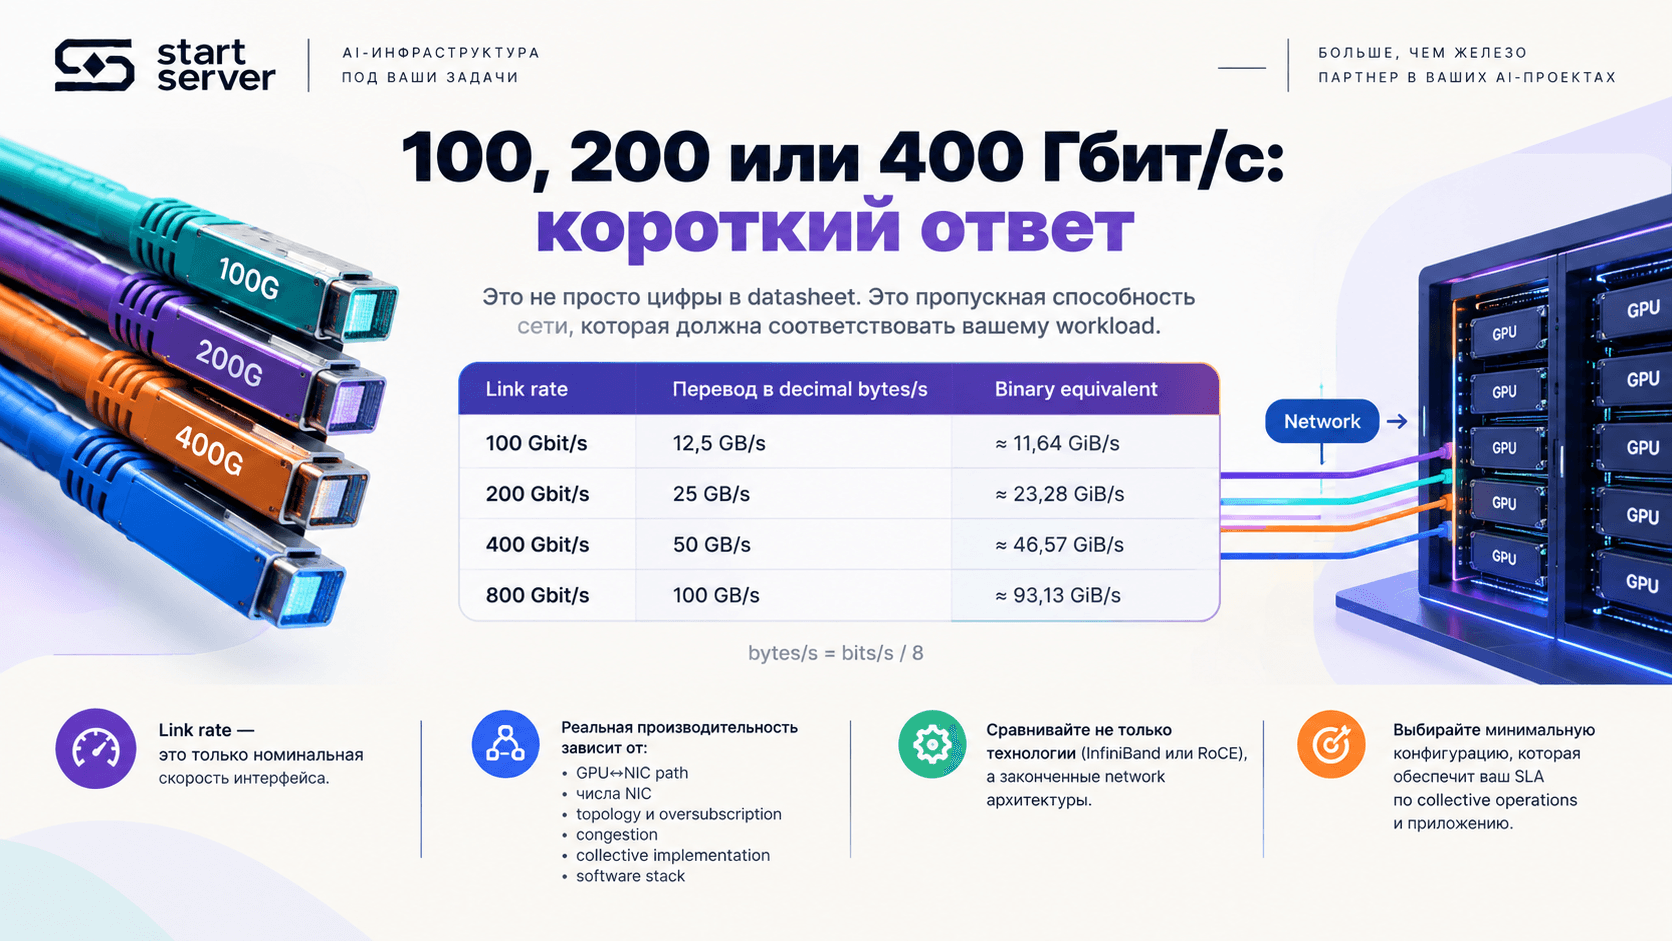
Числа 100G, 200G и 400G описывают прежде всего nominal link rate.
Арифметический перевод выглядит так:
Link rate | Перевод в decimal bytes/s | Binary equivalent |
100 Gbit/s | 12,5 GB/s | ≈ 11,64 GiB/s |
200 Gbit/s | 25 GB/s | ≈ 23,28 GiB/s |
400 Gbit/s | 50 GB/s | ≈ 46,57 GiB/s |
800 Gbit/s | 100 GB/s | ≈ 93,13 GiB/s |
Это только перевод единиц:
bytes/s = bits/s / 8
Из него нельзя сделать вывод:
400 Gbit/s NIC
=
50 GB/s NCCL AllReduce
Результат приложения зависит также от GPU↔NIC path, числа NIC, fabric topology, oversubscription, congestion, collective implementation и software stack.
Поэтому важно не смешивать четыре разных уровня:
NIC line rate
≠
application / algorithm bandwidth
≠
nccl-tests busbw
≠
training throughput
nccl-tests действительно отдельно выводит operation time, algorithm bandwidth (algbw) и bus bandwidth (busbw).
Почему количество GPU не задаёт требования к сети
Два кластера по 32 GPU могут создавать принципиально разную network load.
Один training step может выглядеть так:
долгий compute
↓
collective
↓
долгий compute
а другой:
короткий compute
↓
collective
↓
короткий compute
↓
collective
↓
...
Во втором случае latency и bandwidth сети способны значительно чаще попадать в critical path.
На traffic влияют и схемы parallelism. Data Parallelism, Tensor Parallelism, Pipeline Parallelism и Expert Parallelism создают разные communication phases. Для sizing нам не нужен полный tutorial по этим схемам — нужно зафиксировать, какие collectives и message sizes они создают именно в рассматриваемом workload.
До выбора сети нужно знать хотя бы:
Параметр | Что фиксируем |
Nodes | число compute nodes |
GPUs/node | ускорители на узле |
DP / TP / PP / EP | используемая схема parallelism |
Critical collectives | AllReduce, ReduceScatter, AllGather, AllToAll, P2P |
Operation/message size | объём релевантных операций |
Frequency | сколько раз они возникают за step |
Step time | время training step |
Compute/communication overlap | какая communication действительно задерживает step |
Количество GPU само по себе этих данных не содержит.
Если workload уже работает — сначала профилируйте его
Для существующего приложения measurement-first обычно надёжнее теоретической оценки «из размера модели».
Нас интересуют:
T_step
T_compute
T_comm
T_comm_nonoverlap
Особенно последняя величина.
Предположим:
training step = 1,20 s
NCCL operations = 0,50 s суммарно
Нельзя автоматически сказать, что сеть добавляет к step 0,50 s.
Если 0,35 s communication выполнялись одновременно с compute, непосредственно блокирующая часть может составлять около:
0,50 - 0,35 = 0,15 s
Именно non-overlapped communication ближе к той части времени, которую network optimization потенциально способна вернуть приложению.
Communication fraction показывает, насколько сеть вообще важна
Первый диагностический показатель:
F_comm =
T_comm_nonoverlap
/
T_step
Например:
T_step = 1,20 s
T_comm_nonoverlap = 0,36 s
F_comm = 0,36 / 1,20 = 30%
Это не означает, что workload требуется 400G.
Это означает, что заметная доля critical path связана с communication и дальнейший network sizing оправдан.
Другой пример:
T_step = 1,20 s
T_comm_nonoverlap = 0,036 s
F_comm = 3%
При неизменных остальных ограничениях даже очень большое ускорение network operations может дать небольшой end-to-end выигрыш.
Поэтому сначала важно понять, сколько step действительно ждёт сеть, а уже потом сравнивать NIC.
Найдите collective, который находится в critical path
Нельзя считать, что любой distributed training нужно принимать только по all_reduce_perf.
Релевантной операцией может быть:
AllReduce;
ReduceScatter;
AllGather;
AllToAll;
Send/Recv;
несколько разных collectives на разных фазах step.
nccl-tests имеет отдельные benchmarks для разных collective operations. RCCL также поддерживает multi-GPU и multi-node AllReduce, AllGather, ReduceScatter, AllToAll и point-to-point communication; актуальная документация описывает ring/tree implementations, topology awareness и inter-node работу через InfiniBand и RoCE.
Следовательно:
хороший all_reduce_perf
не означает:
сеть оптимальна для любого AI workload
Benchmark выбирают из communication profile приложения.
Message size так же важен, как тип collective
Результат вида:
AllReduce = 40 GB/s
без дополнительных условий почти ничего не говорит.
Нужно сохранить:
collective
message size
ranks
nodes
GPUs/node
operation time
algbw
busbw
test configuration
Документация nccl-tests отдельно отмечает: на малых размерах operation time сильнее отражает fixed overhead, а на крупных результат всё больше определяется bandwidth.
Как получить требуемую application bandwidth
После выделения critical collective нужен временной бюджет.
Пусть:
S_operation — logical size операции;
T_operation_budget — максимально допустимое время её выполнения.
Тогда:
B_app_required =
S_operation
/
T_operation_budget
Это требование на application/algorithm-level throughput.
Оно ещё не является требуемой скоростью NIC.
Учебный пример
Пусть collective обрабатывает:
S = 1 GiB
и должна завершиться за:
T_budget = 50 ms = 0,05 s
1 GiB = 1,073741824 GB, поэтому:
B_app_required =
1,073741824 / 0,05
≈ 21,47 GB/s
Для этого учебного примера target algorithm bandwidth составляет примерно 21,47 GB/s.
Теперь результат можно сопоставить с convention nccl-tests.
Что означают algbw и busbw
nccl-tests определяет algorithm bandwidth как:
algbw = S / t
где S — размер операции согласно semantics конкретного benchmark, а t — operation time.
Для collective tests вводится дополнительная нормализованная величина busbw.
Для AllReduce:
busbw =
algbw × 2(n - 1) / n
Для ReduceScatter, AllGather и AllToAll:
busbw =
algbw × (n - 1) / n
где n — количество ranks. Эти коэффициенты зафиксированы в текущей performance methodology nccl-tests.
Вернёмся к примеру с восемью ranks:
algbw ≈ 21,47 GB/s
n = 8
Коэффициент AllReduce:
2 × (8 - 1) / 8
=
1,75
Следовательно:
busbw target
≈ 21,47 × 1,75
≈ 37,58 GB/s
Такой результат делает 400G-class endpoint разумным кандидатом для испытания, поскольку арифметический nominal line rate 400 Gbit/s равен 50 GB/s.
Но запись:
37,58 < 50
→ 400G точно достаточно
некорректна.
Размер tensor нельзя просто делить на скорость NIC
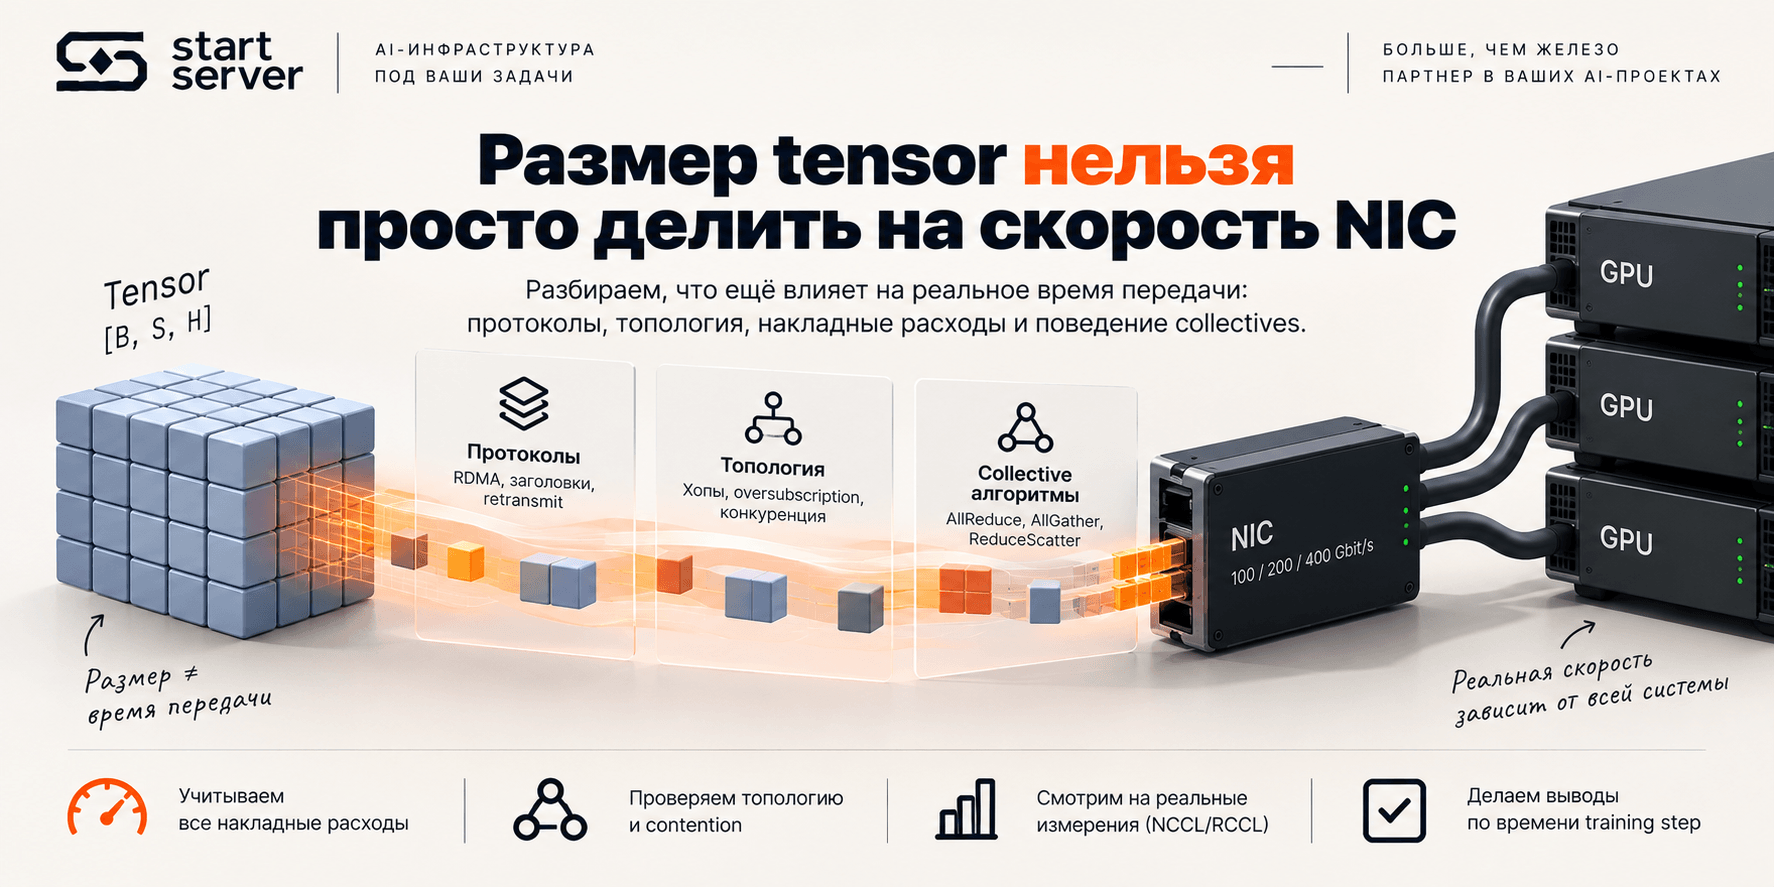
Наивная модель:
T =
tensor size
/
NIC rate
для collective недостаточна.
AllReduce — не одиночная point-to-point передача tensor из одного узла в другой. Collective semantics требуют обмена между несколькими ranks, поэтому nccl-tests и использует correction factor.
При этом нельзя превращать этот factor и в точную модель физических wire bytes любого production job.
Современный NCCL поддерживает несколько algorithm families: Ring, Tree, CollNetDirect, NVLS, NVLSTree, PAT и другие варианты в зависимости от версии. Если NCCL_ALGO не задан, NCCL автоматически выбирает доступные algorithms с учётом topology и architecture.
Поэтому в sizing нужно различать:
operation size
↓
application payload
algbw
↓
logical operation throughput
busbw
↓
normalized collective metric
wire traffic
↓
конкретная implementation / topology / offloads
Это одна из главных технических границ статьи.
Как рассматривать 100G, 200G и 400G
Для них нет корректной универсальной таблицы:
8 GPU → 100G
16 GPU → 200G
32 GPU → 400G
Правильнее проверять каждый класс одинаковым способом.
Candidate | Когда принимаем |
100G | выполняет critical collective SLA и application SLA в целевой topology |
200G | нужен, если 100G не проходит требования или даёт экономически значимый communication wait |
400G | нужен, если более слабая configuration не проходит collective/application SLA, включая production-relevant contention |
800G / multi-rail | рассматриваем, если рассчитанный и измеренный workload требует большей capacity или этого требует выбранная platform architecture |
Таким образом, переход 100 → 200 → 400G — это не лестница размера кластера.
Это последовательность candidate configurations.
Одна 400G NIC и несколько 400G NIC — не одно и то же
Фраза:
«узел подключён по 400G»
не описывает network architecture.
Это может быть:
1 × 400G NIC / node
или:
2 × 400G NIC / node
или несколько NIC/rails с отдельным GPU mapping.
Нужно фиксировать:
Поле | Что записать |
NIC exact SKU | точная модель |
NIC count | число адаптеров |
Link rate/NIC | скорость каждого интерфейса |
Nominal aggregate | арифметическая сумма |
GPU↔NIC mapping | какие GPU используют какие NIC |
Rails | логическая/физическая раскладка |
Например:
2 × 400 Gbit/s
=
800 Gbit/s nominal endpoint capacity
Но это всё ещё не гарантирует 800 Gbit/s приложению.
Выше по пути может находиться bottleneck:
GPU
↓
PCIe
↓
NIC
↓
leaf
↓
uplinks
↓
spine
↓
remote leaf
↓
remote NIC
400G уже не является современным абсолютным максимумом
100/200/400G сохраняются в статье, потому что это полезные и востребованные классы для sizing. Но считать 400G верхней границей в 2026 году уже нельзя.
Текущая NVIDIA Certification documentation включает HGX 2-8-9-400, а для B200/B300 — также 2-8-9-800 и 2-8-10-800 с 800 Gb/s average GPU networking.
В текущей HGX B300 Enterprise Reference Architecture ConnectX-8 описан с capability до 800 Gb/s. Для восьми-GPU node NVIDIA публикует minimum total compute-network bandwidth 400 GB/s как 8 × 400 Gb/s, а recommended configuration — 800 GB/s как 16 × 400 Gb/s с breakout. Это конкретная reference architecture, а не универсальная норма для любого восьми-GPU сервера.
То есть корректный вывод:
400G — один из candidate link classes. Современные GPU-платформы уже используют и 800G-class network designs.
Не:
каждому новому кластеру нужен 800G.
Topology может ограничить даже быстрые NIC
Предположим, сравниваются два варианта:
A
32 nodes
2 × NIC/node
nonblocking fabric
и:
B
32 nodes
2 × NIC/node
2:1 oversubscription
Одинаковая port speed не делает эти системы эквивалентными.
Нужно учитывать:
NIC count
rails
leaf/spine capacity
oversubscription
GPU↔NIC locality
concurrent jobs
shared storage traffic
failure mode
Именно здесь заканчивается задача SS-012.
Как проверить candidate network через NCCL
Расчёт сужает число вариантов, но не заменяет измерение.
Для NVIDIA-кластера в benchmark record нужно сохранить как минимум:
NCCL version
collective
message sizes
nodes
ranks
GPUs/node
NIC count
iterations
operation time
algbw
busbw
tail
У текущего nccl-tests стандартное значение --iters равно 20, а --warmup_iters — 1. При включённом per-iteration timing выводится в том числе i_p99; документация предупреждает, что при количестве samples менее 100 такой percentile может совпадать с maximum.
Поэтому:
20 iterations
p99 = X
не стоит выдавать за исчерпывающую характеристику production tail behavior.
Число повторов и длительность испытания должны соответствовать цели acceptance.
Для AMD-кластера sizing workflow тот же
RCCL использует другой runtime, но логика выбора network capacity остаётся:
critical collective
↓
operation size
↓
operation time
↓
overlap
↓
application impact
Актуальный RCCL поддерживает multi-node collective communication, ring/tree algorithms, topology awareness и работу через InfiniBand и RoCE.
Поэтому сама методика sizing не должна быть привязана исключительно к NVIDIA.
Меняется инструмент validation, но не вопрос:
какую communication performance должен обеспечить workload?
Baseline benchmark недостаточен для shared cluster
Тест одного job на пустой fabric показывает лучший сценарий.
В production одновременно могут работать:
training job A
+
training job B
+
checkpoint traffic
+
dataset/storage traffic
Если такие нагрузки реально делят fabric, acceptance желательно проводить минимум в двух режимах.
Baseline
target collective
+
свободная fabric
Contention
тот же target collective
+
production-relevant concurrent traffic
Сравниваются:
operation time;
algbw;
busbw;
tail behavior;
training step;
job throughput.
Synthetic benchmark — не финальный критерий
Допустим, после замены сети collective benchmark значительно вырос, но training step почти не изменился.
Это возможно, если bottleneck находится в другом месте:
communication overlap
CPU / dataloader
storage
GPU compute
synchronization
не тот collective
не тот message size
Поэтому окончательное правило:
Candidate accepted
⇔
collective SLA passed
AND
application SLA passed
Финальной метрикой могут быть:
step time
samples/s
tokens/s
time-to-train
в зависимости от приложения.
Рост busbw сам по себе не является доказательством эквивалентного роста training throughput.
Быстрая сеть имеет смысл только с учётом стоимости ожидания GPU
При закупке нельзя сравнивать только:
NIC price
+
switch price
Если более слабая сеть регулярно оставляет ускорители ждать collective completion, часть её стоимости скрывается в потерянном GPU time.
Для конкретного проекта можно оценить:
non-overlapped communication time
×
GPU count
×
число training steps / runs
и затем перевести это в экономику конкретной инфраструктуры.
Универсальную стоимость GPU-часа в статье использовать не нужно: она зависит от способа закупки, амортизации, энергопотребления и модели эксплуатации.
Вопрос должен звучать так:
Ответ снова получается из application benchmark, а не из datasheet NIC.
Worksheet для расчёта сети GPU-кластера
Перед выбором оборудования заполните следующие поля:
WORKLOAD
Model:
Framework:
Nodes:
GPUs/node:
PARALLELISM
DP:
TP:
PP:
EP:
STEP
Step time:
Compute time:
NCCL/RCCL time:
Non-overlapped communication:
Communication fraction:
CRITICAL COMMUNICATION
Collective:
Operation size:
Message-size distribution:
Frequency per step:
Ranks:
Measured operation time:
Algorithm/tuning if fixed:
TARGET
Target step time:
Allowed non-overlapped communication:
Collective time budget:
Required algbw:
Normalized busbw target:
NODE NETWORK
NIC exact SKU:
NIC count:
Line rate/NIC:
Nominal aggregate:
GPU↔NIC mapping:
Rails:
FABRIC
Technology:
Topology:
Oversubscription:
Baseline or contention:
Shared storage traffic:
VALIDATION
NCCL/RCCL version:
Message sweep:
Iterations:
Operation time:
algbw:
busbw:
Tail:
Actual training step:
Actual job throughput:
RESULT
100G passes SLA:
200G passes SLA:
400G passes SLA:
800G/multi-rail required:
Minimum accepted configuration:
Этот worksheet переводит запрос:
«Нам нужна сеть для 64 GPU»
в набор параметров, по которым уже можно принимать инженерное решение.
Итоговый алгоритм выбора сети
1. Измерить training step
↓
2. Выделить non-overlapped communication
↓
3. Определить critical collective
↓
4. Зафиксировать operation/message size
↓
5. Задать communication-time budget
↓
6. Рассчитать required algbw
↓
7. При необходимости получить target busbw
↓
8. Выбрать candidate NIC rate и NIC count
↓
9. Проверить topology и oversubscription
↓
10. Запустить NCCL/RCCL benchmark
↓
11. Повторить при production-relevant contention
↓
12. Проверить реальный training step
После этой последовательности можно обоснованно решить, что:
100G выполняет требования
или:
200G — минимально достаточная configuration
или:
400G даёт необходимый application-level выигрыш
или:
нужно рассматривать 800G / multi-rail
Что передать для подбора сети
Для проектирования GPU-кластера нужны:
число compute nodes
GPUs/node
точные модели GPU
framework
DP / TP / PP / EP
critical collectives
message sizes
step time
non-overlapped communication
target step time
NIC requirements
storage traffic
требования к отказоустойчивости
По этим данным можно определить candidate bandwidth, затем проверить количество NIC, topology и выбранную fabric architecture.
Рабочий CTA: Проверить пропускную способность сети.
Коммерческое обещание в этой формулировке всё ещё требует подтверждения командой Start Server: в паспорте проекта не заполнены verified services и approved offers, поэтому до публикации нельзя превращать CTA в обещание конкретной бесплатной услуги или срока ответа.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


