GPU-сервер приехал, включился, операционная система видит все accelerators, а nvidia-smi или AMD tooling не показывают очевидных ошибок.
Можно подписывать приёмку?
Не обязательно.
Эти проверки ещё не доказывают, что:
поставлена именно согласованная комплектация;
firmware и software соответствуют утверждённому baseline;
GPU memory и compute path устойчивы под нагрузкой;
PCIe и GPU-to-GPU fabric работают в ожидаемой topology;
целевая workload достигает согласованной производительности;
во время нагрузки не возникают hardware, driver, thermal или power-related incidents.
Поэтому программа приёмочных испытаний начинается не с выбора самого тяжёлого stress-test.
Она начинается с вопроса:
Какое требование мы проверяем, каким тестом, по какому критерию и каким evidence подтвердим результат?
Рабочая последовательность:
Agreed Requirement → Acceptance Matrix → As-Built Inventory → Firmware / Software Baseline → Passive Health → Active Diagnostics → PCIe / GPU Fabric → Target Workload → Stability → Tool Result → Project Disposition → Evidence Pack → Acceptance Decision.
Главный принцип:
Тест без заранее определённого критерия даёт результат измерения, но не объективное решение о приёмке.
Приёмка GPU-сервера: какие испытания включить в программу
Сначала зафиксируйте основание приёмки
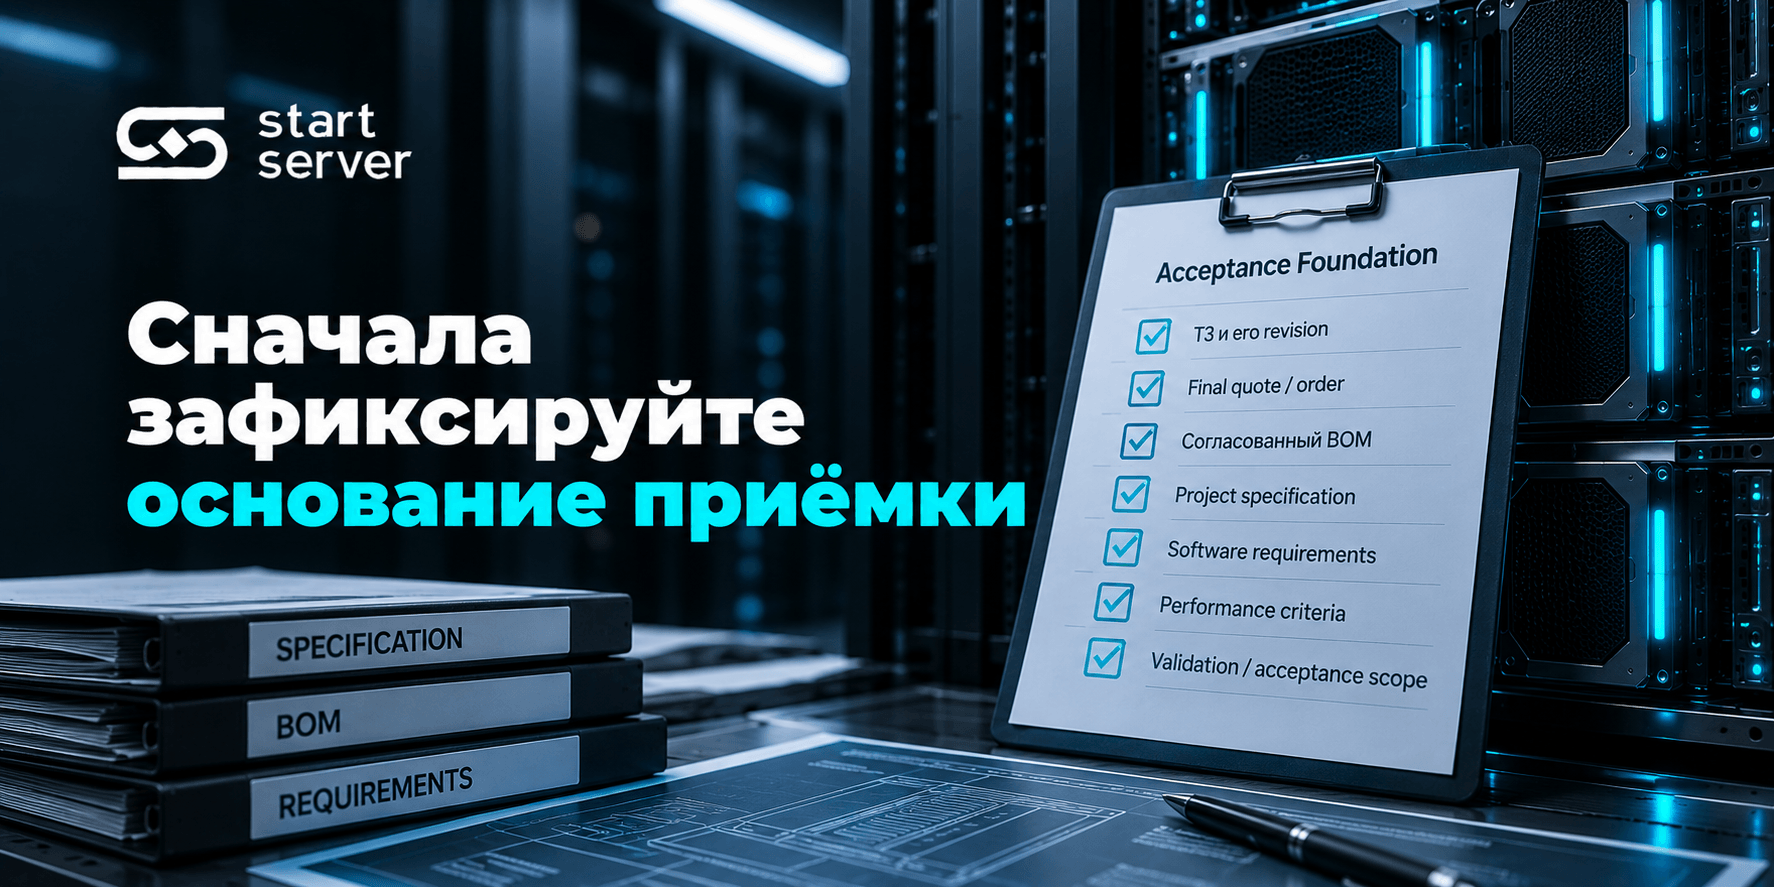
Программа испытаний не должна придумывать требования уже после поставки.
До запуска tests соберите документы, относительно которых будет оцениваться сервер:
ТЗ и его revision;
final quote/order;
согласованный BOM;
approved substitutions;
project specification;
software requirements;
performance criteria;
agreed validation/acceptance scope.
На этапе закупки нужно было зафиксировать:
что именно согласовано к поставке?
На этапе приёмки вопрос уже другой:
доказано ли теперь, что именно это поставлено и работает в согласованных условиях?
Главная формула:
Acceptance Tests Verify Agreed Requirements — They Do Not Invent Them after Delivery.
Переведите требования в Acceptance Matrix
Не каждое условие проверяется одним stress-test.
Одни требования подтверждаются inventory.
Другие — version check.
Третьи — active diagnostic.
Четвёртые — только target workload.
Пример:
Requirement | Test / Check | Evidence | PASS criterion |
|---|---|---|---|
8× exact GPU | Inventory | SKU/count/UUID | совпадает с agreed BOM |
Installed RAM | Inventory | DIMM/capacity | совпадает с agreed BOM |
Approved driver | Version check | version output | approved baseline |
GPU memory integrity | Vendor diagnostic | status/log | agreed result |
PCIe | Active diagnostic | link/test evidence | agreed criterion |
GPU fabric | Fabric test | path/topology evidence | agreed criterion |
Target workload | Application benchmark | throughput/latency | project target |
Stability | Controlled load | telemetry/errors | agreed criterion |
Documentation | Evidence review | complete files | complete package |
Если обязательное требование нельзя связать с проверкой и criterion, итоговый PASS становится субъективным.
Сначала докажите, что приехал именно согласованный сервер
До benchmark выполните inventory.
Проверьте:
server model;
serial;
CPU SKU/count;
фактически установленную RAM;
storage;
NIC/HBA;
GPU exact SKU;
GPU count;
GPU UUID/serial, где доступно;
PSU;
interconnect;
дополнительные cards/modules.
Проверять нужно фактически поставленный экземпляр, а не максимальные возможности platform manual.
Поэтому:
Supported Configuration ≠ Delivered Configuration.
Сформируйте As-Built BOM
На этапе закупки существовал agreed BOM.
При приёмке нужен:
As-Built BOM — фактическая configuration на момент проверки.
Component | Agreed | As-Built | Status |
|---|---|---|---|
GPU | |||
CPU | |||
RAM | |||
Storage | |||
NIC | |||
PSU | |||
Fabric |
Различия можно классифицировать как:
MATCH;
APPROVED DEVIATION;
UNAPPROVED DEVIATION;
UNKNOWN.
Если установлен другой PN, чем был согласован, не скрывайте это внутри общего:
«сервер работает».
Сначала фиксируется deviation. Затем принимается отдельное проектное решение.
Зафиксируйте firmware и software baseline
Сохраните:
BIOS;
BMC;
GPU firmware, где применимо;
NIC/HBA firmware;
OS;
kernel;
GPU driver;
CUDA или ROCm;
container/runtime;
inference/training engine;
diagnostic tool version.
Результат:
«diagnostics PASS»
намного слабее, чем:
«test X версии Y выполнен на baseline Z».
Поэтому:
Test Result without Version Baseline = Weak Evidence.
Не обновляйте всё до latest автоматически
Acceptance criterion должен быть связан с:
approved version;
tested baseline;
vendor-supported combination;
а не с принципом:
«обязательно поставить всё самое новое».
Если во время приёмки меняются:
BIOS;
driver;
firmware;
runtime;
это новая test configuration.
Нужно зафиксировать change и определить, какие tests следует повторить.
Passive health — только первый технический слой
Для NVIDIA DCGM Health анализирует retained telemetry для включённых watches и не создаёт специальную активную нагрузку.
То есть Healthy означает отсутствие обнаруженного incident в scope включённых health rules, но не прохождение compute, memory или fabric stress.
Поэтому:
Passive Health PASS ≠ Active Diagnostic PASS.
И:
No Passive Health Incident ≠ Target Workload PASS.
Почему зелёного health status недостаточно
До нагрузки GPU может:
не показывать XID;
не иметь текущих ECC incidents;
выглядеть нормально по temperature/power;
но под sustained workload проявить:
data corruption;
reset;
degraded path;
нестабильную performance.
Именно поэтому после passive health нужен active diagnostic layer.
Active diagnostics проверяют систему под создаваемой нагрузкой
DCGM Diagnostics включает отдельные plugins для:
GPU memory;
PCIe и peer paths;
sustained compute;
memory bandwidth;
targeted stress;
targeted power;
interconnect validation.
Но нужно помнить:
Diagnostic PASS ≠ Project Acceptance PASS.
PASS относится к конкретным checks конкретного plugin, а не к GPU-серверу вообще.
DCGM suites 1–4 имеют конкретный состав
В актуальном DCGM:
Level 1 — Quick
Deployment/software checks.
Level 2 — Medium
Добавляет:
memory;pcie.
Level 3 — Long
Добавляет:
diagnostic;memory_bandwidth;targeted_stress;targeted_power;доступные conditional plugins.
Level 4 — Extra Long
Дополнительно включает:
memtest;pulse_test.
Отдельно существует:
production_testing
Это самостоятельный production meta-suite на основе level-3 набора.
Он не является «Level 5» и автоматически не включает level-4 memtest и pulse_test.
Поэтому:
Extra Long ≠ Production Meta-Suite.
И:
More Tests ≠ Automatically Better Acceptance Plan.
Не выбирайте Level 4 просто потому, что он самый длинный
Программа приёмки должна строиться от требований проекта.
Нужно учитывать:
exact GPU;
доступность plugin;
agreed risks;
maintenance window;
требуемый evidence.
Самый длинный suite не обязательно наиболее релевантен.
Requested Test ещё не означает Executed Test
DCGM plugin может быть известен текущей версии инструмента, но фактически оказаться недоступен на конкретном host из-за:
unsupported hardware;
отсутствующего executable;
prerequisites;
environment;
resources;
configuration.
Поэтому:
Requested Test ≠ Test Actually Executed.
В отчёте нужно смотреть per-test status.
PASS, FAIL и SKIP нужно трактовать буквально
Это одна из самых важных границ.
В актуальной документации DCGM:
PASS
Plugin выполнил свой scope и не нашёл failure condition.
FAIL
Может означать:
реальный defect/threshold violation;
или:
setup/execution problem, из-за которого test не смог корректно завершиться.
SKIP
Plugin не дал health verdict.
Причинами могут быть:
disabled test;
unsupported hardware;
missing prerequisite;
incompatible mode;
insufficient resources;
interruption.
Отсюда:
SKIP ≠ PASS.
FAIL Status ≠ Hardware Failure by Definition.
Смотрите не только статус, но и diagnostic code/message
Например, compute diagnostic может FAIL из-за:
faulty data;
NaN;
threshold violation;
XID;
thermal violation.
Но также может FAIL из-за:
CUDA initialization;
context creation;
internal execution issue.
Поэтому интерпретируемый результат:
Status + Error Code + Message + Context.
Не просто:
FAIL.
Memory integrity и memory bandwidth — разные тесты
DCGM memory plugin проверяет allocation, доступ и data integrity GPU framebuffer.
memory_bandwidth измеряет local GPU memory throughput.
Это разные вопросы.
Поэтому:
Memory Integrity ≠ Memory Bandwidth.
Если для проекта значимы оба свойства, они получают две строки в Acceptance Matrix.
SKIP memory test не подтверждает исправность памяти
Memory diagnostic может не выполниться, если не хватает свободных resources или prerequisites.
В таком случае не было проверки, которую можно считать PASS.
Поэтому:
Memory SKIP = Memory Not Validated by This Test.
Дальше требуется:
устранить причину;
повторить;
либо оформить project disposition.
Не устанавливайте произвольный memory-bandwidth threshold
Если vendor diagnostic уже имеет SKU/platform-specific threshold, лучше использовать согласованную vendor methodology или заранее утверждённое проектное значение, а не общий показатель из случайного интернет-бенчмарка.
Главная идея:
threshold должен иметь источник.
Compute diagnostic — не application benchmark
DCGM diagnostic выполняет sustained matrix operations, проверяет correctness и может отслеживать cross-GPU differences по GFLOPS, clocks или board power.
При этом документация прямо указывает: GFLOPS tolerance здесь является сравнительным diagnostic threshold, а не абсолютной гарантией application performance.
Поэтому:
Diagnostic GFLOPS PASS ≠ Application Performance PASS.
PCIe path нужно проверять отдельно
То, что GPU обнаружена системой, ещё не означает ожидаемую работу data path.
DCGM PCIe diagnostic может проверять:
host↔GPU bandwidth;
peer-to-peer paths;
latency;
negotiated width/generation;
replay/error activity;
P2P data correctness.
Поэтому:
GPU Visible ≠ PCIe Path Validated.
При этом не нужно задавать единый универсальный GB/s threshold.
Criterion берётся из:
vendor/platform expectation;
diagnostic threshold;
project requirement.
Peer path может использовать не только PCIe
Название PCIe plugin не означает, что любой GPU-to-GPU traffic внутри него обязательно физически проходит только через PCIe.
Peer topology может использовать NVLink там, где он доступен.
Поэтому правильнее говорить:
проверка host/device и peer transfer paths.
А не:
«проверка только PCIe-линий между всеми GPU».
GPU fabric нужно проверять отдельным evidence
В multi-GPU configuration полезны разные layers.
PCIe plugin
Host/device и peer transfers.
nvbandwidth
Bandwidth/copy validation по доступным GPU interconnect paths.
nccl_tests
Single-node collective communication workload, если соответствующий NCCL Tests executable установлен и plugin доступен.
Поэтому:
All GPUs Visible ≠ GPU Fabric Validated.
Недоступный NCCL test не означает PASS fabric
DCGM NCCL test требует отдельный executable и соответствующую configuration.
Если он не найден или plugin disabled, usable NCCL health verdict не производится.
Значит:
NCCL Test Unavailable ≠ Collective Path PASS.
Active diagnostics выполняйте в контролируемом окне
Diagnostic workload может занимать:
compute;
GPU memory;
interconnect;
CPU;
power/cooling budget.
Конкурирующая workload способна искажать result и мешать diagnostic.
Поэтому acceptance tests выполняйте:
на выделенной системе;
либо в controlled maintenance window;
с заранее понятным stop condition.
AMD: ROCm Validation Suite имеет собственную структуру
Для AMD official validation branch можно строить вокруг ROCm Validation Suite — RVS.
Current RVS определяет пять predefined levels.
Level 1
Software validation.
Level 2
Hardware capability checks.
Level 3
Basic performance.
Level 4
Extended performance.
Level 5
Full stress / thorough pre-production validation.
При этом точный набор tests и thresholds зависит от GPU platform.
Поэтому:
RVS Level 5 ≠ Mandatory for Every AMD Acceptance.
Acceptance Matrix всё равно остаётся первичной.
Используйте platform-specific RVS configuration, если она доступна
Generic config удобна как fallback.
Но если AMD предоставляет configuration для конкретной GPU/platform, её стоит предпочесть generic profile.
Так test лучше соответствует supported environment.
RVS тоже состоит из отдельных независимых modules
В актуальном RVS доступны отдельные классы tests для:
PCIe;
P2P;
memory;
memory bandwidth;
GPU stress;
power stress;
thermal behaviour.
Поэтому один результат GST или memory test не должен превращаться в общий:
«RVS подтвердил исправность сервера».
AMD PCIe/P2P тоже должны быть отдельным acceptance layer
RVS позволяет отдельно проверять:
host↔GPU PCIe path;
GPU peer connectivity;
transfer throughput.
Следовательно, и в AMD branch действует:
GPU Visible ≠ PCIe/P2P Path Validated.
Beta diagnostic нельзя автоматически делать обязательным gate
RVS Pulse Stress Test сейчас прямо помечен как beta и не предназначен для production use; его pass/fail criteria ещё дорабатываются.
Поэтому:
Experimental / Beta Diagnostic ≠ Default Mandatory Acceptance Gate.
Если проект всё же хочет его использовать, это отдельное осознанное решение.
Vendor diagnostics не заменяют target workload
Vendor tests могут подтвердить:
memory integrity;
compute;
PCIe;
peer fabric;
stress behaviour.
Но они не знают:
вашу модель;
ваше приложение;
concurrency;
latency SLO;
job duration target.
Поэтому последний performance layer:
Target Workload Acceptance Test
Главная формула:
Vendor Diagnostic PASS ≠ Target Workload PASS.
Target workload опишите воспроизводимо
Для LLM зафиксируйте:
exact model/revision;
precision;
quantization;
input/output profile;
batch;
concurrency;
request rate;
GPU count;
parallelism;
runtime/version.
Для training:
model;
precision;
batch;
dataset/input;
optimizer/config;
GPU count;
collective settings.
Для другого GPU workload — аналогичный reproducible specification.
Criterion должен существовать до измерения
Плохой test plan:
запустим модель и посмотрим, сколько получится.
Хороший:
при workload X и configuration Y должно выполняться criterion Z.
Это может быть:
minimum throughput;
maximum TTFT;
maximum latency;
maximum job duration;
accuracy requirement.
Главное:
Criterion Before Measurement.
Public benchmark не становится acceptance target автоматически
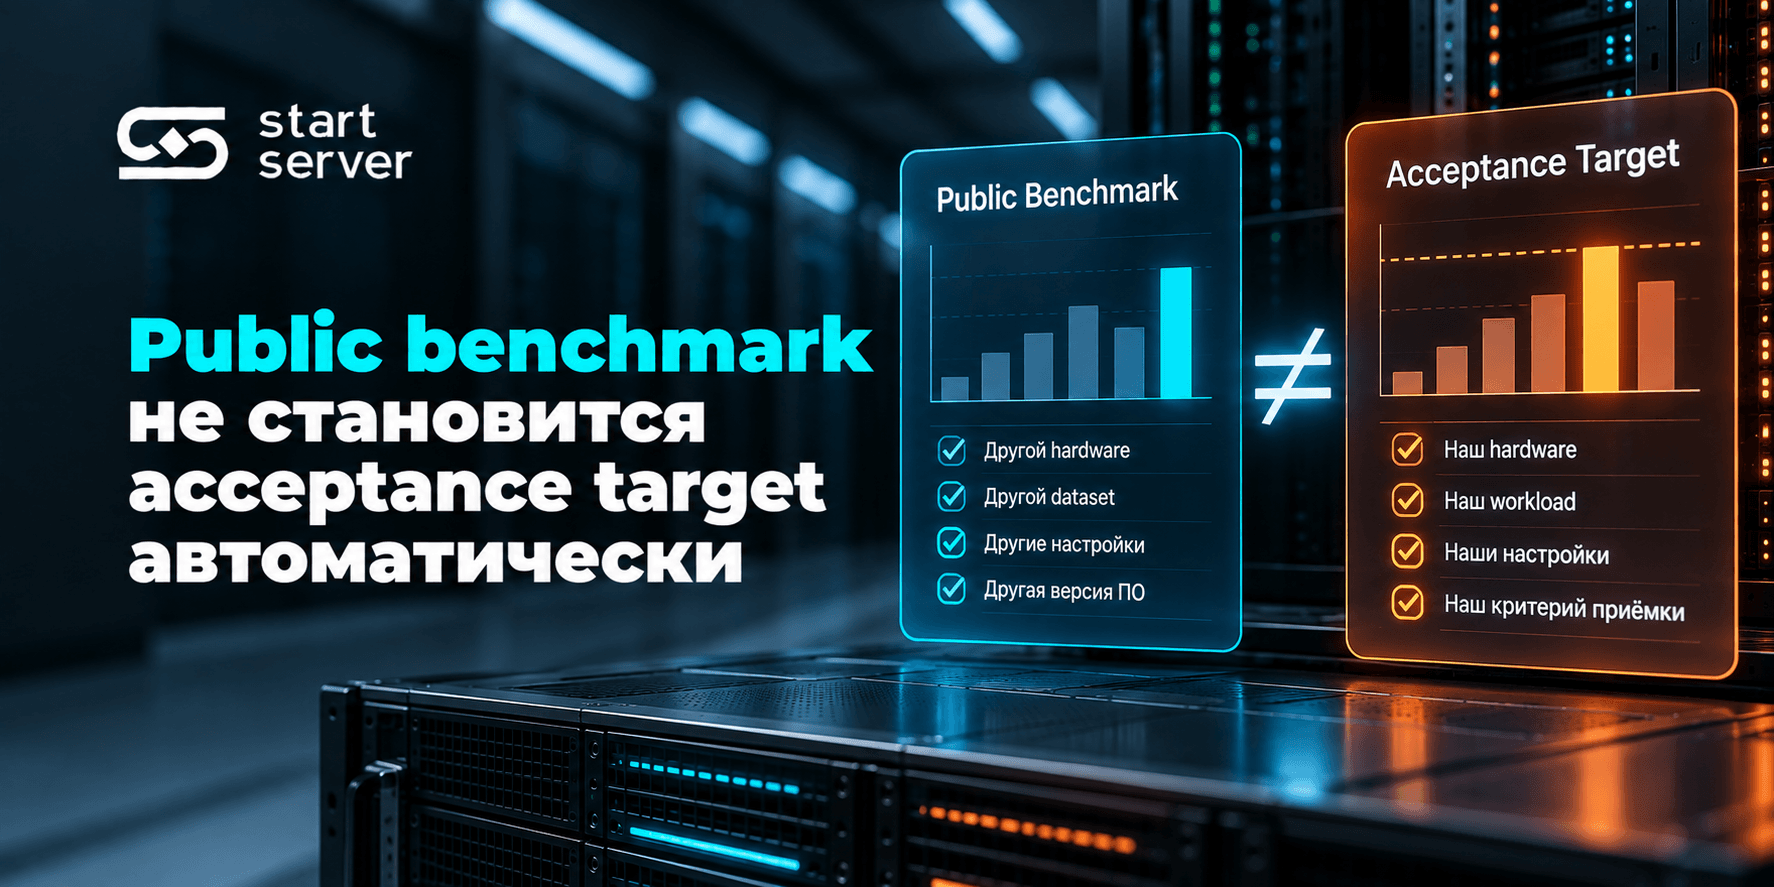
Если criterion взят из публичной таблицы, нужно проверить:
model;
precision;
input/output;
concurrency;
GPU count;
software stack;
metric definition.
Для этого публичные benchmark results нужно сначала проверить на сопоставимость условий.
Поэтому:
Public Benchmark Number ≠ Acceptance Target Automatically.
Stability test не обязан идти 24 часа
Нет универсального правила:
настоящий burn-in = 24 часа.
Продолжительность определяется:
workload;
риском;
проектом;
agreed test plan.
Поэтому:
Longer Test ≠ Automatically Better Acceptance Test.
Важнее:
точная workload;
точная duration;
заранее определённые failure criteria.
Что сохранять во время stability run
Полезный evidence:
GPU utilization;
VRAM;
clocks;
temperature;
power;
ECC/RAS;
XID/vendor events;
throttling/constraint evidence;
PCIe/fabric state;
application performance.
Здесь telemetry сохраняется именно как evidence конкретного acceptance run, а не как общая инструкция по production monitoring.
Не задавайте универсальный thermal threshold
Thermal criterion должен происходить из:
vendor limits;
platform requirements;
agreed operating envelope.
Не использовать:
температура выше X °C = FAIL для любой GPU.
Подробную проверку охлаждения под контролируемой нагрузкой лучше оформлять как отдельную процедуру с собственными условиями, telemetry и критериями.
Network и storage включайте только если они входят в scope проекта
Если проект требует:
RDMA;
multi-node training;
remote storage;
defined network throughput;
checkpoint performance;
эти paths должны получить отдельные acceptance criteria.
Не:
«iperf работает».
А:
согласованное requirement выполнено.
То же самое относится к storage.
Component PASS не равен end-to-end PASS
Memory PASS
не означает:
Compute PASS.
Compute PASS
не означает:
Fabric PASS.
Fabric PASS
не означает:
Application PASS.
Поэтому:
Component → System → Target Workload.
Разделяйте Tool Result и Project Disposition
Это ключевая структура итогового протокола.
Tool Result
Что фактически сообщил test/tool:
PASS;
FAIL;
SKIP;
NOT RUN;
N/A.
Project Disposition
Что проект делает с этим результатом:
ACCEPT;
INVESTIGATE;
REMEDIATE;
RETEST;
ACCEPTED DEVIATION / WAIVER;
OPEN / REJECT.
Главная формула:
Tool Result ≠ Project Decision.
Почему это важно
Например:
Tool Result
FAIL
Error
CUDA initialization failure.
Это ещё не означает:
GPU hardware неисправна.
Project Disposition:
INVESTIGATE / RETEST.
Другой пример:
Tool Result
FAIL
Measurement
Performance ниже согласованного criterion.
Project Disposition
ACCEPTED DEVIATION, если стороны отдельно согласовали waiver.
При этом исходный tool result всё равно остаётся FAIL.
SKIP и NOT RUN тоже разные состояния
SKIP
Tool/test был затребован, но не дал verdict.
NOT RUN
Проектная проверка вообще не была запущена.
Ни одно из них нельзя автоматически считать PASS.
SKIP ≠ PASS.
NOT RUN ≠ PASS.
Acceptance Record Template
ID | Requirement | Test | Tool/version | Criterion | Tool Result | Error / Measurement | Project Disposition | Evidence |
|---|---|---|---|---|---|---|---|---|
HW-01 | exact GPU count | inventory | exact match | |||||
HW-02 | installed RAM | inventory | exact match | |||||
GPU-01 | memory integrity | DCGM/RVS | agreed | |||||
GPU-02 | compute stability | DCGM/RVS | agreed | |||||
BUS-01 | host↔GPU path | PCIe test | agreed | |||||
FAB-01 | peer fabric | vendor test | agreed | |||||
APP-01 | target workload | benchmark | project SLO | |||||
STB-01 | stability | controlled run | agreed |
Эта таблица технически сильнее одной колонки:
PASS / FAIL / DEVIATION.
Что делать после FAIL
Используйте reproducible workflow:
Tool Result
↓
Read Error Code / Message
↓
Diagnostic Finding or Execution Problem?
↓
Capture Raw Evidence
↓
Identify Environment / Software / Hardware Cause
↓
Remediation
↓
Record Configuration Change
↓
Repeat Same Test
↓
Compare Against Same Criterion
↓
Project Disposition
↓
Preserve Original + Retest Evidence.
Не стирайте первый FAIL после успешного retest
Представим:
Первый run:
PCIe FAIL.
После firmware fix:
PASS.
Правильный evidence pack содержит оба результата:
original failure;
remediation;
changed baseline;
successful retest.
Это полезная история для будущей эксплуатации и поддержки.
Configuration change создаёт новый test context
Если после FAIL изменили:
BIOS;
driver;
firmware;
power cap;
test config;
runtime;
новый result относится уже к другой configuration.
Поэтому:
Configuration Change → New Test Context.
Не меняйте target workload незаметно
Если первый run FAIL, а затем:
уменьшается batch;
снижается concurrency;
сокращается context;
меняется precision;
и второй run PASS — это уже другая acceptance workload.
Изменение может быть допустимо, но его нужно явно оформить.
Иначе test перестаёт проверять исходный requirement.
Сохраняйте raw evidence
Не ограничивайтесь итоговым screenshot.
Хороший evidence pack включает:
raw diagnostic output;
JSON, если доступен;
logs;
configs;
command line;
timestamps;
telemetry;
benchmark result files.
Поэтому:
Screenshot ≠ Full Raw Evidence.
Acceptance Evidence Pack
Итогом должна быть не устная фраза:
«всё работает».
А reproducible package.
Document Control
project;
requirement revision;
quote/order/BOM revision;
acceptance-plan revision;
date.
System Identity
server model/serial;
GPU SKU/count/UUID;
CPU;
RAM;
storage;
NIC;
topology.
Software Baseline
BIOS/BMC;
firmware;
OS/kernel;
driver;
CUDA/ROCm;
runtime;
diagnostic versions.
Test Definition
tool/version;
suite/plugin/module;
config;
command;
duration;
metric;
criterion.
Tool Results
status;
error code;
message;
measurement.
Project Disposition
accept;
investigate;
remediate;
retest;
accepted deviation.
Raw Evidence
logs;
JSON;
telemetry;
benchmark output.
Acceptance Decision Tree
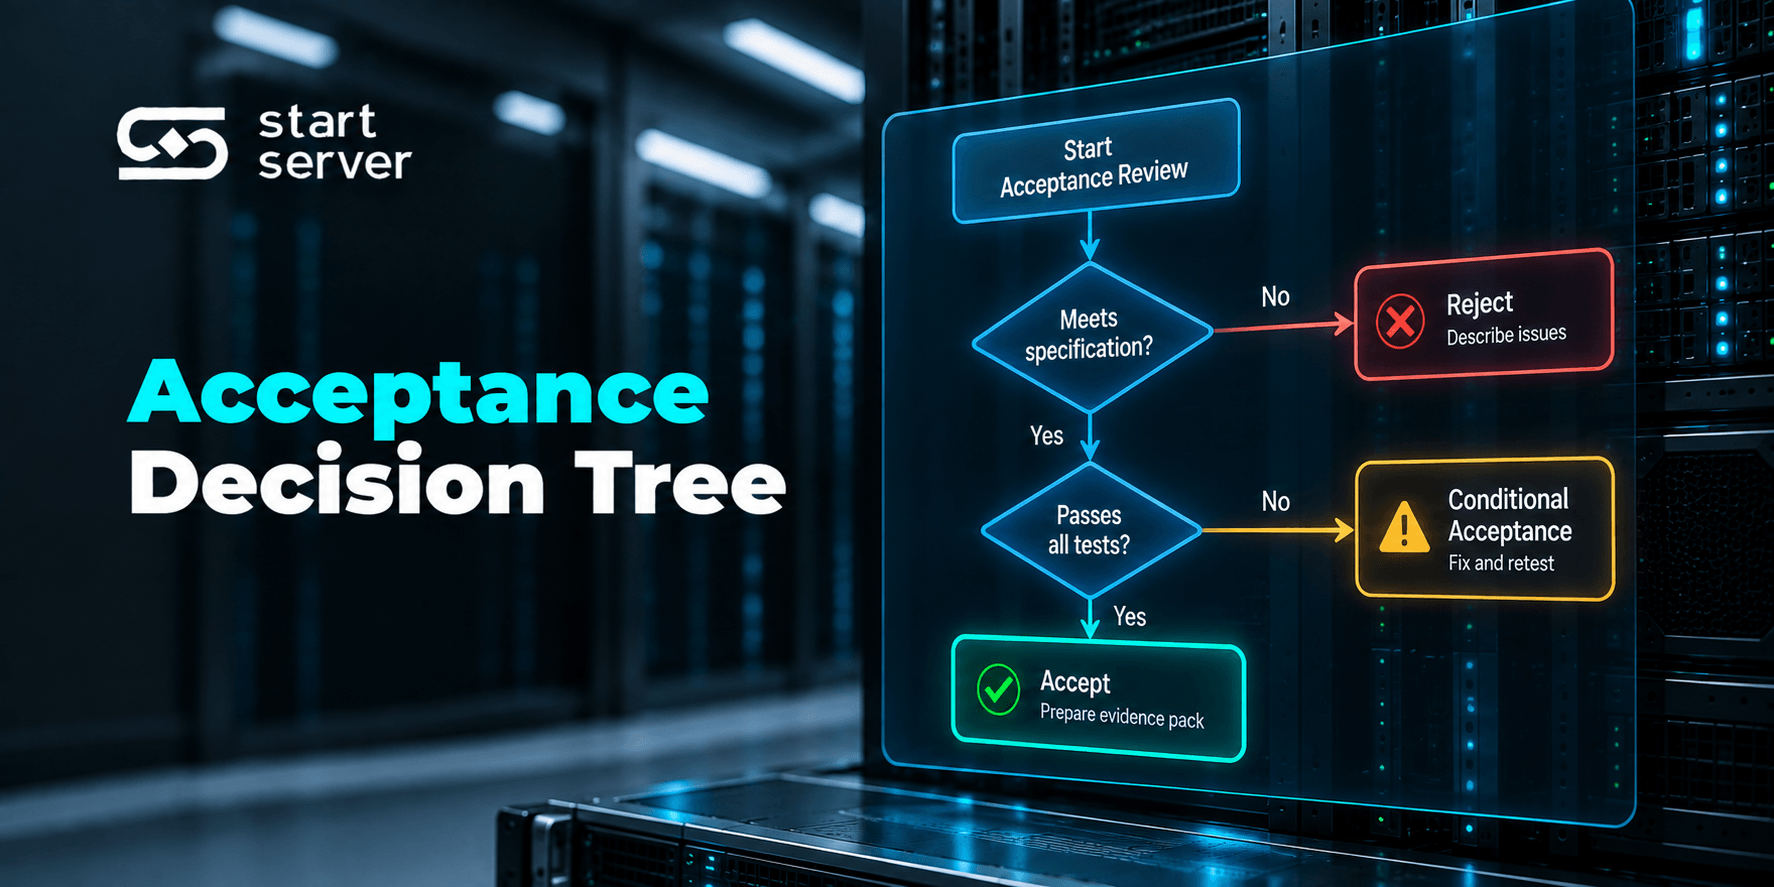
As-Built BOM совпадает с agreed configuration?
Нет
→ deviation / remediation.
Да ↓
Version baseline соответствует agreed stack?
Нет
→ remediate / deviation.
Да ↓
Passive health содержит blocking evidence?
Да
→ investigate.
Нет ↓
Все обязательные active tests реально выполнены?
Нет
→ SKIP / NOT RUN → resolve.
Да ↓
Tool results соответствуют criteria?
Нет
→ inspect code/message → remediate/investigate → retest.
Да ↓
PCIe / peer fabric requirements выполнены?
Нет
→ investigate data path.
Да ↓
Target workload достигает agreed criterion?
Нет
→ performance investigation / project disposition.
Да ↓
Stability criterion выполнен?
Нет
→ investigate.
Да ↓
Evidence Pack полный?
Нет
→ acceptance incomplete.
Да ↓
Ready for Acceptance Decision.
Что нельзя считать полноценной приёмкой
Недостаточно только:
увидеть сервер в BIOS;
увидеть все GPU в
nvidia-smi;получить зелёный passive-health status;
пройти один synthetic stress;
один раз запустить LLM;
увидеть «нормальную» температуру глазами.
Каждая проверка имеет собственный scope.
Самый тяжёлый synthetic stress не заменяет application test
Логика:
если выдержал максимальный synthetic stress, значит production точно работает,
слишком сильна.
Synthetic stress полезен для component/system validation.
Production workload может иметь другой:
memory profile;
communication pattern;
scheduling;
latency sensitivity.
Поэтому:
Maximum Synthetic Stress ≠ Production Acceptance by Itself.
Нужны оба слоя:
Vendor Diagnostics
и:
Target Workload.
Как связаны этап закупки и этап приёмки
На этапе закупки определяется:
что именно обещано поставить.
Выход:
Agreed BOM / Scope.
На этапе приёмки проверяется:
что именно поставлено и какие requirements подтверждены evidence.
Выход:
Acceptance Evidence Pack.
Связка:
Quote Alignment Matrix
→ Agreed BOM
→ Acceptance Matrix
→ As-Built BOM
→ Tool Results
→ Project Disposition
→ Acceptance Decision.
Короткий чек-лист перед ПСИ
Есть exact requirement revision?
Если нет — зафиксировать baseline.
Есть final agreed BOM?
Без него inventory нечем сравнивать.
Каждый requirement имеет test/check?
Если нет — определить evidence.
У каждого test есть criterion?
Не задавать threshold после измерения.
Tool/version/config зафиксированы?
Обязательно.
Diagnostic реально выполнился?
Requested test ещё не означает executed test.
Status интерпретируется вместе с error code?
Особенно для FAIL/SKIP.
Target workload описана полностью?
Не случайная demo configuration.
Raw evidence сохраняется?
Не только screenshots.
Tool Result и Project Disposition разделены?
Обязательно.
Главное
Приёмка GPU-сервера — это не один stress-test и не проверка:
«все GPU видны».
Правильная последовательность:
Agreed Requirement
→ Acceptance Matrix
→ As-Built Inventory
→ Firmware / Software Baseline
→ Passive Health
→ Active Diagnostics
→ Interpret Status + Error Code
→ PCIe / GPU Fabric
→ Target Workload
→ Stability
→ Tool Result
→ Project Disposition
→ Remediation / Retest
→ Acceptance Evidence Pack
→ Acceptance Decision.
Ключевые правила:
Supported Configuration ≠ Delivered Configuration.
Test Result without Version Baseline = Weak Evidence.
Passive Health PASS ≠ Active Diagnostic PASS.
Diagnostic PASS ≠ Project Acceptance PASS.
Extra Long ≠ Production Meta-Suite.
Requested Test ≠ Test Actually Executed.
FAIL Status ≠ Hardware Failure by Definition.
SKIP ≠ PASS.
NOT RUN ≠ PASS.
Memory Integrity ≠ Memory Bandwidth.
Diagnostic GFLOPS PASS ≠ Application Performance PASS.
GPU Visible ≠ PCIe Path Validated.
All GPUs Visible ≠ GPU Fabric Validated.
NCCL Test Unavailable ≠ Collective Path PASS.
RVS Level 5 ≠ Mandatory for Every AMD Acceptance.
Experimental Diagnostic ≠ Default Mandatory Gate.
Vendor Diagnostic PASS ≠ Target Workload PASS.
Public Benchmark Number ≠ Acceptance Target Automatically.
Longer Test ≠ Automatically Better Acceptance Test.
Component PASS ≠ End-to-End PASS.
Tool Result ≠ Project Decision.
Configuration Change → New Test Context.
Screenshot ≠ Full Raw Evidence.
Maximum Synthetic Stress ≠ Production Acceptance by Itself.
Для NVIDIA DCGM принципиально важно интерпретировать результат per-plugin: PASS относится только к выполненному scope, FAIL может означать как найденный defect/threshold violation, так и execution/setup error, а SKIP вообще не даёт health verdict.
Для AMD ROCm Validation Suite аналогично важно фиксировать выбранный validation level, exact modules и configuration: RVS имеет уровни 1–5, но конкретные tests и thresholds зависят от GPU platform, а отдельные experimental modules — например Pulse Stress — не предназначены для production acceptance по умолчанию.
Поэтому финальный вопрос при ПСИ звучит не:
«диагностическая утилита показала PASS?»
а:
поставлена ли согласованная as-built configuration, выполнены ли именно обязательные проверки, достигнуты ли заранее согласованные criteria на целевой workload, а tool results, deviations и raw evidence сохранены и интерпретированы отдельно от проектного решения?
Если программа испытаний согласована до поставки, субъективное:
«вроде всё работает»
можно заменить воспроизводимой процедурой.
CTA: Согласовать программу испытаний до поставки.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


