В одной таблице указано:
GPU A — 5 000 tokens/s
GPU B — 3 800 tokens/s
На первый взгляд победитель очевиден.
Но без методики эти две цифры могут вообще не быть сопоставимыми.
Один результат мог быть получен на 8B-модели в FP8, другой — на 70B в BF16. В одном тесте могла работать одна GPU, в другом — восемь. Один benchmark мог измерять максимальный offline throughput, второй — online serving с ограничением по latency. Даже одинаковая подпись tokens/s может обозначать output throughput, total token throughput или другую величину.
Поэтому до вывода:
«GPU A быстрее GPU B»
нужно ответить на другой вопрос:
Измерены ли результаты в достаточно одинаковых условиях и измеряют ли они одно и то же?
Рабочая последовательность:
Original Source → Model → Precision & Quality → Workload → Load Pattern → Cache State → Metric Definition → Hardware → Software → Power Scope → Comparability → Relevance.
Главный принцип:
Сначала найдите первоисточник benchmark
Не начинайте сравнение со строки tokens/s.
Сначала найдите original report, test configuration или документацию benchmark.
Скриншот, рекламный слайд или пересказ чужой таблицы без methodology не позволяют понять:
что именно тестировали;
в каком software stack;
с какой model;
при какой нагрузке;
как определялась метрика.
Если первоисточник найти невозможно, корректный статус результата:
Methodology UNKNOWN.
Это не означает, что цифра обязательно неправильная.
Это означает, что использовать её как проверяемое техническое основание закупки нельзя.
Benchmark Comparison Sheet
Перед тем как ставить две цифры рядом, приведите их к одному формату.
Поле | Benchmark A | Benchmark B | Совпадает? |
Original source | |||
Date | |||
Tool / version | |||
Model / revision | |||
Tokenizer | |||
Precision | |||
Quantization | |||
Quality criterion | |||
Input length | |||
Output length | |||
Dataset / distribution | |||
Dataset seed | |||
Prefix caching | |||
Cache state | |||
Batch | |||
Request rate | |||
Arrival pattern / burstiness | |||
Max concurrency | |||
Client queue included? | |||
Scenario | |||
Benchmark duration | |||
Total requests | |||
Successful / failed | |||
Metric | |||
Metric definition | |||
Percentile | |||
Goodput / SLO | |||
GPU exact SKU | |||
GPU count | |||
GPU execution | |||
Topology | |||
Server / CPU / RAM | |||
Engine / version | |||
Driver / runtime | |||
Tuning | |||
Power limit | |||
Power measurement scope | |||
Result |
Итоговый статус удобно обозначать так:
Exact model важнее названия семейства
Записи:
Llama
или:
Llama 3
для технического сравнения недостаточны.
Нужна exact model и по возможности exact revision.
8B и 70B создают совершенно разную workload. Dense и MoE различаются по вычислительному профилю. Base и instruct versions также нельзя автоматически считать одним и тем же test object.
Если в двух результатах меняются одновременно model и GPU, разницу нельзя целиком приписать accelerator.
Поэтому точнее формулировать так:
Different Model ≠ Apples-to-Apples GPU Isolation.
Сравнение разных models может быть полезным как end-to-end system comparison, но это уже другой вопрос.
Revision и tokenizer тоже относятся к benchmark condition
Даже при одинаковом названии repository может измениться:
checkpoint;
configuration;
tokenizer;
generation behaviour;
runtime integration.
Для воспроизводимого теста полезно фиксировать:
Tokenizer особенно важен для показателей в tokens/s.
Token — не фиксированное количество символов или слов. Разные tokenizers могут разбить один и тот же текст на разное число tokens.
Поэтому сравнение разных моделей только по tokens/s не изолирует производительность GPU.
Precision нельзя оставлять за кадром
BF16, FP16, FP8, INT8 и INT4 — разные execution conditions.
Precision влияет на:
compute path;
VRAM;
memory traffic;
kernel selection;
achievable throughput.
Поэтому:
BF16 Result ≠ FP8 Result.
Это не означает, что их нельзя сравнивать вообще.
Их можно сравнивать как две готовые system configurations, если именно это является целью исследования.
Но нельзя показать BF16 одного accelerator и FP8 другого и затем утверждать, что измерена только разница GPU.
Quantization требует quality context
Если один result получен в BF16, а второй — в INT4, меняется не только hardware workload.
Quantization способна изменить:
memory footprint;
kernel path;
throughput;
latency;
качество output.
Поэтому performance comparison должен отвечать ещё на один вопрос:
Обе configurations удовлетворяют одному acceptance criterion по качеству?
Главная формула:
Стандартизированные suites вроде MLPerf именно поэтому разделяют performance и accuracy validation. Для Server scenario также действует latency constraint: слишком высокий target QPS делает run невалидным, если latency requirement не выполняется.
Это не означает, что любой локальный test обязан повторять MLPerf. Но если precision или quantization могут изменить результат модели, quality criterion должен быть явным.
Maximum context не равен tested context
Надпись:
model supports 128K context
ничего не говорит о фактической длине prompt в benchmark.
Нужны два отдельных значения:
ISL — Input Sequence Length
и
OSL — Output Sequence Length.
Benchmark с input 128 tokens и benchmark с input 16K tokens нагружают систему по-разному.
То же самое относится к output length.
Тест:
1K input → 20 output
не эквивалентен:
1K input → 1K output.
Поэтому:
Среднее значение длины тоже может скрывать разный workload
Даже одинаковое:
average input length = 2 048
не доказывает одинаковую workload.
Один benchmark может использовать fixed prompts по 2 048 tokens.
Другой — смесь запросов от 100 до 8 000 tokens с тем же средним.
Эти distributions могут давать разный scheduler и cache behaviour.
Поэтому Comparison Sheet должна сохранять не только среднюю длину, но и:
Dataset / Distribution.
Главный принцип:
Same Mean Length ≠ Same Request Distribution.
Batch, concurrency и request rate — три разные вещи
Эти параметры нельзя использовать как синонимы.
Batch описывает объединение work внутри execution model.
Concurrency — число одновременно outstanding requests.
Request rate — скорость появления новых requests.
В актуальном vllm bench serve --request-rate и --max-concurrency управляются отдельно. При finite request rate arrival pattern дополнительно меняется через --burstiness.
Поэтому:
Batch ≠ Concurrency.
Request Rate ≠ Concurrency.
Default vllm bench serve не означает production-like traffic
Это важная ловушка при чтении публичных тестов.
В текущем vLLM параметр --request-rate по умолчанию равен inf.
То есть requests отправляются сразу максимально быстро — это режим maximum-throughput/stress workload, а не автоматически модель обычного пользовательского трафика. Для контролируемого arrival pattern задаётся finite request rate.
Следовательно:
Default Benchmark Load ≠ Production-Like Load.
Если в benchmark написано только:
vllm bench serve
но параметры генератора нагрузки не опубликованы, workload описана недостаточно.
Arrival pattern тоже меняет результат
При finite request rate vLLM использует burstiness для моделирования распределения межзапросных интервалов.
В текущей документации значение 1.0 соответствует Poisson arrival process, меньшие значения делают traffic более bursty, а большие — более равномерным.
Это означает, что две нагрузки с одинаковым:
20 requests/s
могут по-разному воздействовать на queue и latency.
Поэтому вместе с request rate желательно знать:
Arrival Pattern / Burstiness.
Client-side queue и server queue нельзя смешивать
Если benchmark ограничивает --max-concurrency, часть requests может ожидать разрешения на стороне самого benchmark client ещё до отправки на server.
Текущий vLLM поэтому умеет отдельно измерять client_queue_time; при finite request rate также существует end-to-end вариант с учётом client-side ожидания.
Получаются два разных слоя:
Client Queue — request ещё не попал на inference server.
Server Queue — request уже принят serving stack и ждёт обработки.
Поэтому:
При сравнении E2E latency нужно проверить, включён ли client-side wait в измеряемую величину.
Prefix cache способен сделать два одинаковых запуска неравными
Это ещё одна важная ловушка.
Актуальная документация vLLM прямо предупреждает: повторный vllm bench serve против того же server может повторно использовать prompts, оставшиеся в prefix cache, и тем самым повысить throughput. Это возможно даже на synthetic dataset, если используется тот же воспроизводимый seed.
Поэтому benchmark record должен отвечать на вопросы:
Параметр | Что фиксировать |
Prefix caching | enabled / disabled |
Cache state | cold / warm / unknown |
Dataset | название / источник |
Seed | exact value, если применимо |
Server reset | был ли reset/restart перед run |
Главная формула:
Same Workload + Different Cache State ≠ Same Benchmark.
Нельзя сравнивать cold-cache result одного сервера с warm-cache result другого и выдавать разницу за performance GPU.
Offline и Server отвечают на разные вопросы
Offline
Главный вопрос:
какой throughput система может дать на заранее доступной workload?
Это throughput-oriented scenario.
Server / Online
Главный вопрос:
как система обслуживает поток requests при заданной модели arrival и latency constraints?
MLPerf разделяет Offline и Server и требует, чтобы Server run выполнял latency constraint при заданном target QPS.
vLLM тоже имеет отдельные команды для serving benchmark и offline throughput; в offline output отдельно показываются requests/s, total tokens/s и output tokens/s.
Поэтому:
Для online serving одной точки throughput обычно мало
При низкой нагрузке система может показывать:
хороший TTFT;
низкую queue;
небольшой aggregate throughput.
При росте нагрузки:
aggregate throughput увеличивается;
затем queue начинает расти;
TTFT ухудшается;
около capacity limit дополнительные requests уже дают в основном latency penalty.
vLLM parameter sweeps специально предназначены для изучения разных workload levels по request rate или concurrency, от low-load до high-load режима.
Поэтому при выборе serving platform полезнее:
Latency–Throughput Curve
чем одна строка:
максимальный throughput = X.
tokens/s без определения — недостаточная метрика
В актуальном vllm bench serve считаются разные показатели.
Request throughput:
completed requests / benchmark duration.
Output token throughput:
output tokens / benchmark duration.
Total token throughput:
(input tokens + output tokens) / benchmark duration.
То есть две цифры:
5 000 tok/s
могут иметь разные числители.
Поэтому:
Output Tokens/s ≠ Total Tokens/s.
И:
Peak throughput и sustained throughput — тоже разные вещи
Некоторые benchmark outputs дополнительно фиксируют максимальный output-token rate в отдельных временных buckets.
Это не то же самое, что средний throughput за полный test interval. В актуальном vLLM benchmark code average output throughput рассчитывается по всем успешно сгенерированным output tokens и полной duration, а peak metric считается отдельно.
Следовательно:
Peak Throughput ≠ Sustained Throughput.
Если в презентации вынесен только кратковременный peak, это должно быть явно подписано.
Aggregate throughput не равен скорости одного пользователя
Сервер может обслуживать много requests одновременно и выдавать высокий aggregate tokens/s.
При этом individual requests могут иметь:
высокий TTFT;
худший TPOT;
длинный tail latency.
Другой server может иметь меньше aggregate throughput, но значительно лучшую interactive latency.
Поэтому до benchmark comparison нужно определить цель.
Цель | На что смотреть |
Batch processing | aggregate/offline throughput |
Interactive assistant | TTFT, TPOT/ITL, tail latency |
Maximum users under SLO | goodput / throughput при latency constraint |
Cost efficiency | workload performance + одинаковая power/cost boundary |
Без цели слово:
«быстрее»
не определено.
Throughput и goodput — разные показатели
Для production serving особенно полезно отличать количество завершённых requests от количества requests, которые выполнили SLO.
В текущем vLLM benchmark коде request_throughput считается по числу завершённых requests, а request_goodput — по числу успешно завершённых requests, удовлетворивших заданным ограничениям по TTFT, TPOT и/или E2E latency.
Поэтому:
Throughput = сколько система завершила.
Goodput = сколько она завершила в пределах заданного performance requirement.
Главная формула:
Для procurement interactive LLM-serving goodput иногда полезнее максимального tokens/s.
TTFT, TPOT, ITL и E2E нельзя складывать в одну колонку «latency»
Benchmark должен указывать точную метрику.
TTFT — Time To First Token.
TPOT — Time Per Output Token.
ITL — Inter-Token Latency.
E2E — полное время request.
Кроме того, важно понимать measurement surface конкретного tool.
Для vllm bench serve нужно использовать определения именно соответствующей версии benchmark client, а не автоматически переносить semantics из server-side Prometheus metrics.
Правило:
Metric + Tool + Version + Measurement Points.
ITL и TPOT — не одно и то же
В актуальном vLLM benchmark TPOT для request рассчитывается по формуле:
(E2E latency - TTFT) / (output tokens - 1).
ITL собирается как интервалы между streamed outputs.
При стандартной генерации они могут быть близки.
Но, например, при speculative decoding один streamed event способен содержать несколько tokens.
Следовательно:
ITL ≠ TPOT by Definition.
Нельзя брать p99 ITL одного теста и сравнивать его с p99 TPOT другого как одну и ту же latency metric.
Average недостаточно для online benchmark
Среднее может скрывать длинный tail.
Современный vLLM benchmark считает mean, median и выбранные percentiles для TTFT, TPOT, ITL и E2E latency.
Какой percentile важен — зависит от SLO.
Главное:
Поэтому нельзя сравнивать:
mean TTFT одного сервера
с:
p99 TTFT другого.
Successful и failed requests тоже входят в benchmark
Current vLLM отдельно фиксирует completed и failed requests, а throughput считает по успешно завершённым.
Это означает, что высокий throughput при значительном числе failed requests нельзя читать так же, как performance при полном успешном completion.
В Comparison Sheet должны быть:
Total / Completed / Failed.
Benchmark duration и число requests нужно сохранять
Короткий run может сильнее зависеть от:
transient behaviour;
warm-up;
случайного arrival pattern;
cache state.
Нельзя задать один универсальный minimum duration для всех tests.
Но duration и request count должны быть опубликованы, чтобы читатель понимал масштаб измерения.
Формула:
Result without Test Window = Incomplete Evidence.
Число GPU должно быть явным
Сравнение:
System A — 8 000 tok/s
System B — 2 000 tok/s
не говорит о performance одной GPU, если первая system использовала восемь accelerators, а вторая — одну.
Результат может быть корректным как system-level comparison.
Но нельзя затем заключить:
GPU A в четыре раза быстрее GPU B.
Multi-GPU result нельзя просто делить на N
Если восемь GPU дали 8 000 tok/s, это не означает автоматически:
одна GPU = 1 000 tok/s.
На scaling влияют:
tensor/model parallelism;
communication;
interconnect;
scheduler;
topology;
synchronization.
Поэтому:
Exact GPU execution обязателен
Название:
H100
или:
MI300
может быть недостаточно.
Для технической таблицы важно зафиксировать:
exact SKU;
memory capacity;
PCIe/SXM/OAM/NVL или другое исполнение;
configured power;
server platform.
Разные исполнения нельзя смешивать в одну строку как идентичное hardware.
Topology — часть multi-GPU benchmark
Одинаковое количество GPU не означает одинаковую system architecture.
Могут различаться:
PCIe topology;
NVLink/NVSwitch;
XGMI/Infinity Fabric;
NUMA placement;
CPU attachment.
При tensor parallelism communication path может существенно повлиять на результат.
Поэтому:
CPU, RAM и server platform тоже входят в test system
GPU benchmark способен зависеть от host side.
CPU участвует в:
tokenization;
request handling;
preprocessing;
scheduling;
networking;
CPU offload.
Поэтому reproducible result желательно связывать хотя бы с:
Server + CPU + RAM + GPU Topology.
Software stack может изменить результат без замены GPU
Performance относится не только к silicon.
В результат входят:
driver;
CUDA/ROCm;
framework;
inference engine;
engine version;
attention backend;
kernels;
compiler;
tuning.
Поэтому строку:
H200 = X tok/s
корректнее читать как:
Разделяйте Hardware Isolation и Best-System Comparison
Это два разных корректных вида benchmark.
Hardware Isolation
Вопрос:
что изменилось именно из-за accelerator?
Тогда model, precision, workload, software и methodology максимально фиксируются.
Best-System Comparison
Вопрос:
какая готовая production platform лучше выполняет workload?
Тогда допустимы platform-specific:
engines;
kernels;
compiler;
quantization;
tuning.
Но вывод относится ко всей system configuration.
Поэтому:
Different Software Stack → System Comparison, not Pure Silicon Comparison.
Vendor-specific optimization сама по себе не делает benchmark неправильным.
Нужно только честно назвать объект сравнения.
Peak TFLOPS нельзя использовать как замену LLM benchmark
VRAM, memory bandwidth, TFLOPS, TOPS и TDP — specifications.
tokens/s, TTFT и request throughput — measurements.
Application result дополнительно зависит от:
model;
kernels;
precision;
communication;
scheduler;
software.
Поэтому:
Peak Compute ≠ Measured LLM Throughput.
И:
Спецификации помогают сформировать гипотезу, но не заменяют workload test.
Performance per watt требует одинаковой границы измерения
tokens/s/W тоже может быть несопоставимой метрикой.
Watts могут означать:
TDP;
configured power cap;
measured GPU board power;
whole-server power;
PDU/wall power.
Нельзя сравнивать:
output tok/s / GPU TDP
с:
output tok/s / measured whole-server power
как одинаковую efficiency metric.
Поэтому:
Estimated or Configured Power ≠ Measured Power.
И в Comparison Sheet обязательно:
Power Measurement Scope.
Evidence Levels: внутренняя классификация Start Server
Чтобы быстро оценивать полноту публичного benchmark, удобно использовать внутреннюю шкалу evidence. Это не официальный стандарт MLPerf или vLLM.
Уровень | Что известно |
A — Standardized / Auditable | формальные rules, scenario, quality criteria, detailed configuration |
B — Reproducible Technical Benchmark | command/config, exact system, model, workload и results доступны |
C — Technical / Vendor Report | methodology понятна, но system специально optimized автором |
D — Number Without Methodology | есть цифра, но условий недостаточно для проверки |
Важно оценивать не компанию, а конкретный benchmark result.
Один и тот же vendor может опубликовать и подробный reproducible test, и рекламный слайд без methodology.
Benchmark Comparability Gate
Перед использованием двух performance figures в одной сравнительной таблице пройдите gate.
Gate | Проверочный вопрос |
MODEL | Exact model/revision сопоставимы? |
QUALITY | Precision, quantization и acceptance quality сопоставимы? |
WORKLOAD | ISL/OSL и distribution сопоставимы? |
LOAD | Request rate, concurrency и arrival pattern сопоставимы? |
CACHE | Prefix-cache state сопоставим? |
SCENARIO | Offline и online/server не смешаны? |
METRIC | Определение throughput/latency одинаково? |
SYSTEM | GPU count, exact execution и topology учтены? |
SOFTWARE | Engine/version/tuning известны? |
POWER | Для efficiency совпадает measurement boundary? |
Если критический ответ:
нет
или:
неизвестно,
результаты нельзя выдавать за прямое apples-to-apples comparison.
Normalized LLM Benchmark Table
Итоговая таблица для сравнительной статьи или технической части КП может выглядеть так:
Поле | System A | System B |
Model / revision | ||
Precision / quantization | ||
Quality criterion | ||
ISL / OSL | ||
Dataset / distribution | ||
Prefix-cache state | ||
Request rate | ||
Arrival pattern | ||
Max concurrency | ||
Client queue semantics | ||
Scenario | ||
Duration / requests | ||
Successful / failed | ||
GPU exact SKU / count | ||
Execution / topology | ||
CPU / RAM | ||
Engine / version | ||
Driver / runtime | ||
Metric definition | ||
Output throughput | ||
Total token throughput | ||
TTFT percentile | ||
TPOT / ITL percentile | ||
Goodput / SLO | ||
Power scope | ||
Source | ||
Evidence level | ||
Comparability |
Если большинство этих полей невозможно заполнить, headline:
«GPU A быстрее GPU B»
почти наверняка слишком сильный.
Красные флаги публичного benchmark
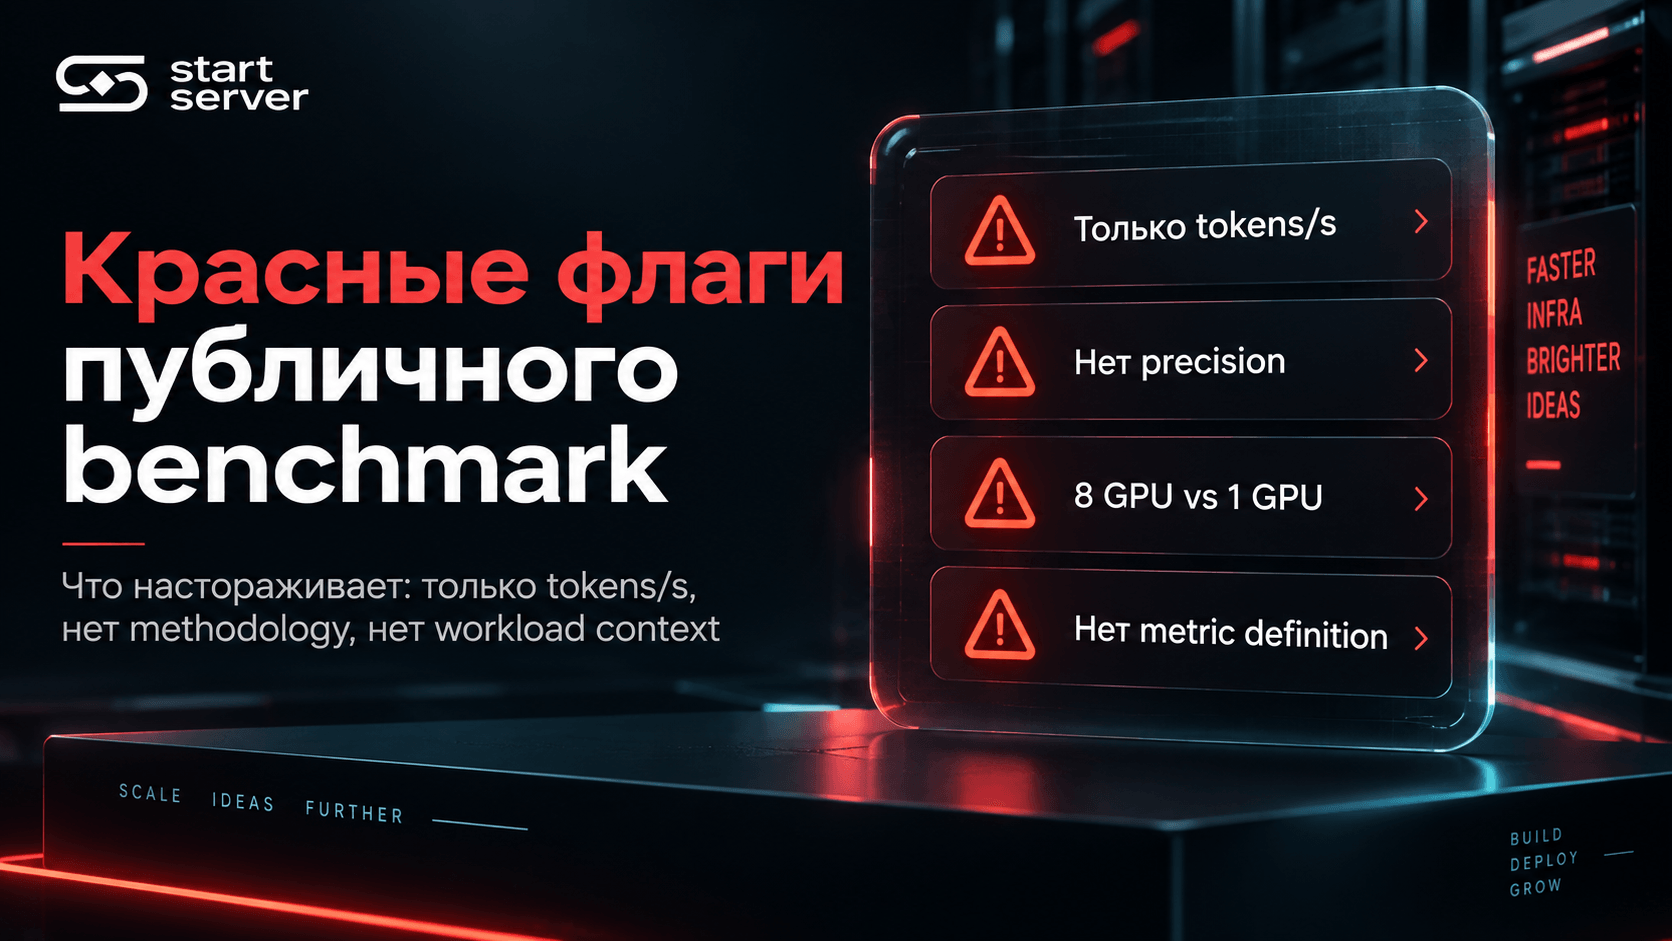
Что опубликовано | Чего не хватает |
Только tokens/s | workload и definition |
Только название GPU | exact execution, count, system |
Нет precision | compute path |
BF16 сравнивают с INT4 | quality context |
Нет ISL/OSL | prefill/decode profile |
Нет request rate/concurrency | load level |
Нет cache state | возможное влияние prefix caching |
Нет metric definition | output/total/peak неизвестны |
Нет engine/version | reproducibility |
8 GPU против 1 GPU | system scope |
performance/W | одинаковая power boundary |
«в 2 раза быстрее» | что именно менялось |
Несопоставимый benchmark нельзя исправить арифметикой
Не нужно пытаться восстановить missing methodology через:
8-GPU throughput / 8
или:
FP8 × условный коэффициент → BF16
или:
short-context result → long-context estimate
или:
Offline throughput → Online capacity
или:
mean latency → p99.
Главный принцип:
Если conditions фундаментально различаются, нужен новый test.
Benchmark может быть валидным, но нерелевантным
Это один из самых важных выводов.
Представим полностью воспроизводимый benchmark:
input = 128
output = 128
concurrency = 256
максимальный throughput
А production workload:
input = 16K
output = 500
concurrency = 8
строгий TTFT SLO
Первый benchmark не становится плохим.
Он просто отвечает на другой вопрос.
Поэтому:
Valid Benchmark ≠ Relevant Benchmark.
Релевантность важнее самой большой цифры
Для выбора сервера иногда полезнее результат:
3 000 tok/s на workload, близкой к production
чем:
10 000 tok/s на workload, которая никогда не встретится в вашем приложении.
После Comparability Gate всегда нужен второй вопрос:
Проверяются model, context, output length, concurrency, arrival pattern, latency requirement, precision и topology.
Когда публичных benchmark недостаточно
Собственный workload test особенно нужен, если решение существенно зависит от:
long context;
custom model;
нестандартной quantization;
adapters;
multimodal input;
строгого TTFT/TPOT;
необычной concurrency;
multi-GPU topology;
custom inference stack;
performance-per-watt requirement.
Публичные numbers тогда помогают сформировать shortlist.
Но финальное решение подтверждается собственной нагрузкой.
Как читать benchmark в коммерческом предложении
Если в КП написано:
«Система обеспечивает 12 000 tokens/s»,
не нужно сразу принимать или опровергать эту цифру.
Нужно нормализовать evidence:
Вопрос | Что запросить |
Model | exact ID/revision |
Precision | BF16/FP8/INT8/INT4 |
Quality | acceptance criterion |
ISL/OSL | фактические lengths |
Dataset | workload distribution |
Load | request rate / concurrency |
Cache | cold/warm, prefix cache |
Scenario | offline / serving |
Metric | output / total / peak |
Latency | TTFT/TPOT/ITL + percentile |
Goodput | какой SLO выполнен |
Hardware | GPU count / execution / topology |
Software | engine / version / runtime |
Power | measurement scope |
Главное
LLM benchmark нельзя читать как паспортную характеристику GPU.
Результат относится к конкретному сочетанию:
Model
→ Precision / Quantization / Quality
→ Input / Output Distribution
→ Request Rate / Concurrency / Arrival Pattern
→ Cache State
→ Scenario
→ Metric Definition
→ GPU Count / Topology
→ Software Stack
→ Power Scope.
Ключевые правила:
Same Unit ≠ Comparable Result.
Different Model ≠ Apples-to-Apples GPU Isolation.
BF16 Result ≠ FP8 Result.
Faster at Different Quality ≠ Same Benchmark.
Maximum Context ≠ Tested Context.
Same Mean Length ≠ Same Request Distribution.
Batch ≠ Concurrency.
Request Rate ≠ Concurrency.
Default Benchmark Load ≠ Production-Like Load.
Client Queue ≠ Server Queue.
Different Cache State ≠ Same Benchmark.
Offline Throughput ≠ Serving Capacity under Latency Constraint.
Output Tokens/s ≠ Total Tokens/s.
Peak Throughput ≠ Sustained Throughput.
Throughput ≠ SLO-Compliant Goodput.
Aggregate Throughput ≠ Per-Request Experience.
Same Average ≠ Same Tail Latency.
Per-System Result ≠ Single-GPU Result × N.
Different Software Stack → System Comparison, not Pure Silicon Comparison.
Peak Compute ≠ Measured LLM Throughput.
Valid Benchmark ≠ Relevant Benchmark.
Современный vLLM сам показывает, почему одной цифры недостаточно: benchmark workload задаётся через request rate, concurrency и arrival pattern; output и total token throughput считаются отдельно; SLO-based goodput выделяется отдельно; повторный run может получить преимущество от prefix cache.
Поэтому если критические условия двух benchmark различаются или неизвестны, правильный вывод звучит не:
«GPU A быстрее GPU B»,
а:
«По опубликованным данным прямое сравнение не подтверждено».
Если закупочное решение зависит от конкретной model, long context, concurrency или latency SLO, публичные benchmarks стоит использовать для shortlist, а финальную GPU-конфигурацию проверять на workload, близкой к production.
Если в коммерческих предложениях Start Server сравниваются несколько GPU-платформ, их performance-цифры можно сначала привести к единой Benchmark Comparison Sheet и определить, какие результаты действительно сопоставимы.
CTA: Проверить сравнение GPU в вашем предложении.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


