MLOps, Machine Learning Operations, объединяет практики разработки, выпуска и эксплуатации систем машинного обучения. Его задача: сделать путь модели от эксперимента до рабочего сервиса воспроизводимым, контролируемым и наблюдаемым.
Речь идет не только о запуске обучения на GPU. Команде нужно понимать, на каких данных получена модель, почему она допущена в эксплуатацию, какая версия сейчас отвечает пользователям и что делать при ухудшении качества. Для этого связывают код, данные, эксперименты, артефакты, инфраструктуру и правила принятия решений.
MLOps не требует обязательно начинать с Kubernetes, большого кластера и десятка специализированных продуктов. Для небольшой команды достаточно ограниченного набора инструментов, если он закрывает версии, проверки, выпуск, мониторинг и восстановление. Масштаб платформы должен следовать реальным рискам и нагрузке.
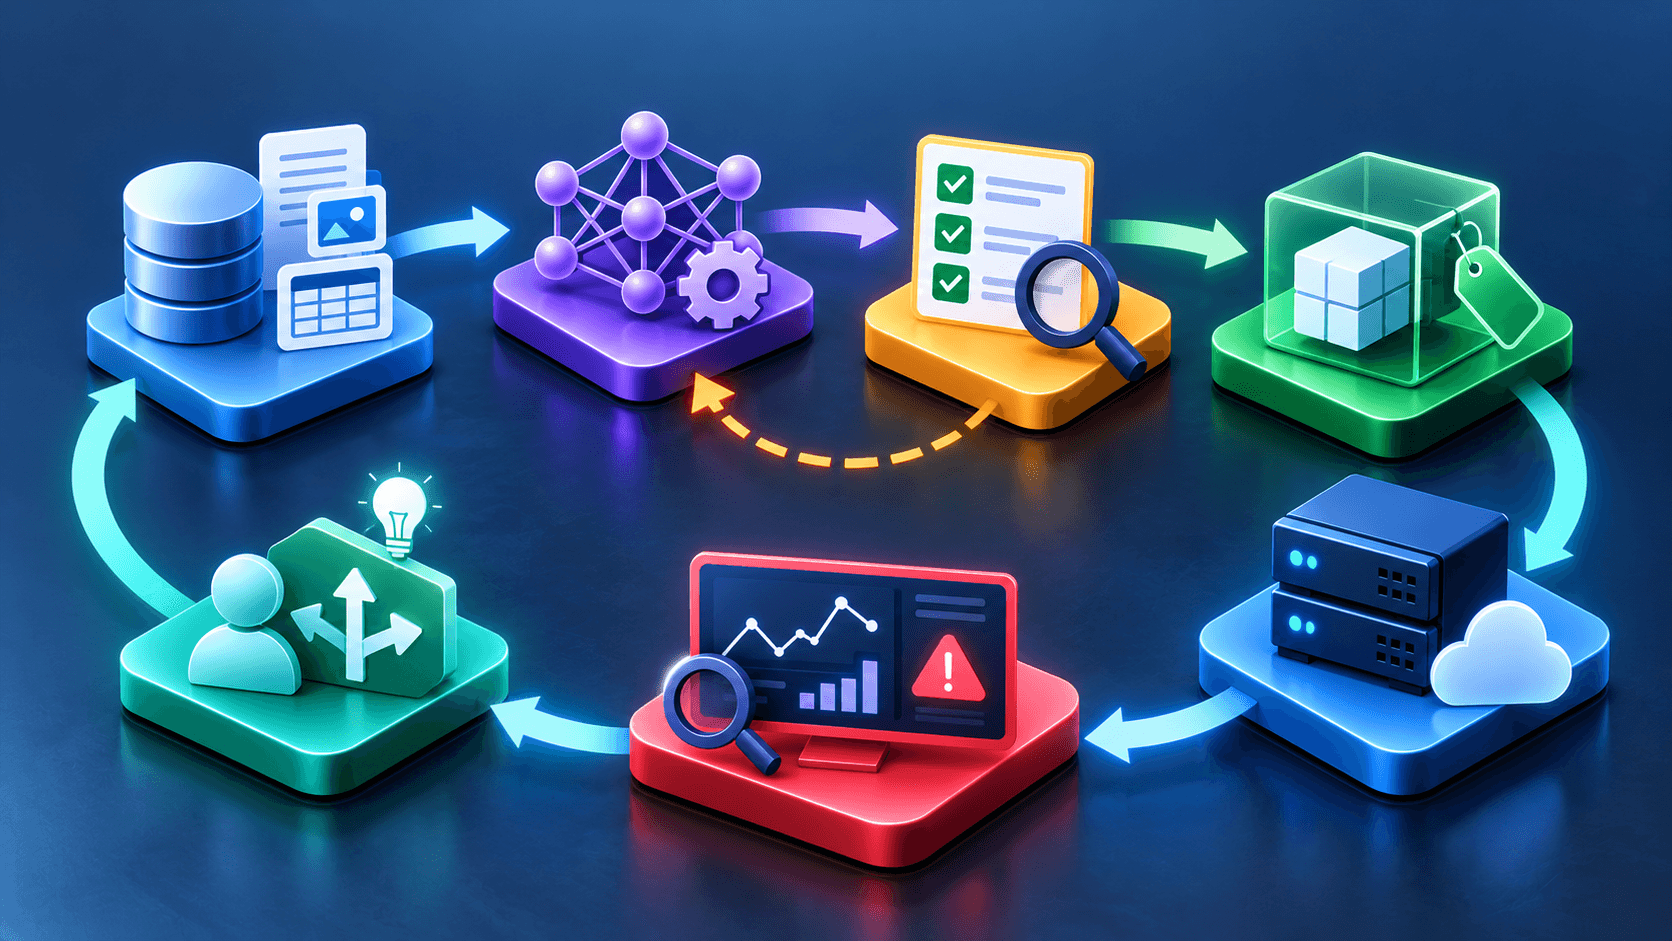
Что такое MLOps простыми словами
Успешный эксперимент отвечает на вопрос, может ли модель решить задачу на выбранных данных. Рабочий сервис должен решать ее регулярно: после обновления датасета, смены библиотеки, перезапуска сервера и появления новых типов запросов.
Без управляемого процесса легко получить файл model_final_v7, который работает только в окружении одного сотрудника. Неясно, какой код его создал, были ли в тесте будущие данные и можно ли повторить результат. MLOps вводит проверяемую связь между исходными материалами, обучением и выпущенной системой.
Чем MLOps отличается от DevOps
DevOps и MLOps разделяют практики автоматизации, тестирования, управления конфигурацией и наблюдения. Но в ML результат зависит не только от кода: на него влияют данные, способы построения признаков и параметры обучения.
Область | Что необходимо контролировать в ML-системе |
|---|---|
Исходный код | Подготовку данных, обучение, обработку запросов и инфраструктурные конфигурации |
Данные | Версию, происхождение, схему, доступность и допустимость использования |
Модель | Артефакт, параметры, метрики, зависимости и требования к выполнению |
Выпуск | Допуск, конфигурацию сервиса, совместимость признаков и возможность отката |
Эксплуатация | Ошибки и задержки сервиса, качество предсказаний и изменения входных данных |
Чем занимается MLOps-инженер
Он помогает организовать воспроизводимое выполнение, автоматизацию проверок, управление артефактами, развертывание и эксплуатацию моделей. Конкретные обязанности зависят от команды: часть работы может выполнять ML-инженер, платформенный инженер, DevOps или специалист по данным.
Ответственность за качество модели не стоит целиком передавать администратору инфраструктуры. Команда должна заранее определить, кто утверждает метрики, кто разрешает выпуск, кто реагирует на деградацию и кто обеспечивает доступность сервиса.
Из каких компонентов состоит MLOps-платформа
Компоненты удобно рассматривать как логические роли. Не каждой роли сразу нужен отдельный продукт или сервер.
Компонент | Задача | Что должно сохраняться |
|---|---|---|
Репозиторий кода | Версии программ и конфигураций | Проверенный commit и история изменений |
Хранилище данных | Датасеты и производные наборы | Идентификатор версии, схема, происхождение и права |
Трекинг экспериментов | Сравнение запусков | Параметры, метрики, окружение и артефакты |
Оркестрация | Выполнение этапов процесса | Зависимости, статусы, повторные запуски и ошибки |
Реестр моделей | Учет подготовленных версий | Связь с экспериментом, метаданные, допуски |
Serving | Выполнение предсказаний | Точная версия модели и конфигурация сервиса |
Мониторинг | Контроль работоспособности и качества | Метрики, события, сигналы деградации и действия |
Версии данных, экспериментов и моделей
Что нужно для воспроизводимого запуска
Для каждого значимого эксперимента стоит фиксировать версию кода, идентификатор данных, схему признаков, параметры, программные зависимости и вычислительное окружение. Если используются контейнеры, полезен неизменяемый digest образа, а не только перемещаемый тег latest.
Должна существовать связь от выпущенной модели к конкретному запуску и его входным данным. Иначе расследование ошибки превращается в поиск файлов по именам и переписке.
Одинаковый random seed не гарантирует побитно одинаковый результат на разных GPU и версиях библиотек. Сначала определяют требуемый уровень воспроизводимости: идентичность артефакта, совпадение метрик в согласованном допуске или возможность повторить полный процесс.
Трекинг экспериментов и реестр моделей
Например, MLflow Tracking сохраняет параметры, метрики и выходные файлы запусков. Реестр моделей добавляет версионирование, метаданные и связь с происхождением модели. Эти механизмы помогают сравнить кандидатов и определить, какая версия допущена к следующему этапу.
Но наличие модели в registry еще не означает, что она развернута. Даже изменение псевдонима вроде champion не заменяет процедуру выпуска: сервис должен получить артефакт, пройти проверки и подтвердить используемую версию. Возможности реестра описаны в документации MLflow Model Registry.
Данные, метаданные и артефакты должны восстанавливаться согласованно. Восстановить только файл весов недостаточно, если утрачены обработчик признаков или сведения о нужной среде выполнения.
Как организовать данные и избежать утечки в оценку качества
Перед обучением проверяют схему, типы, обязательные поля, пропуски, дубликаты и допустимые диапазоны. Правила зависят от предметной задачи: отсутствие значения иногда допустимо, но появление новой семантики поля может разрушить результат без технической ошибки.
Разделение обучающей и тестовой выборок выполняют до операций, которые учатся на статистике данных. Иначе сведения из теста могут попасть в преобразования и завысить качество. Для временных данных необходимо соблюдать хронологию, а для связанных объектов учитывать риск попадания одного объекта в разные части выборки.
Эти риски отличаются от выбора алгоритма. Подробный обзор самих моделей приведен в статье о видах моделей машинного обучения и метриках качества.
Когда нужен feature store
Feature store помогает переиспользовать признаки и согласовать их получение для обучения и онлайн-предсказаний. Он особенно полезен, когда несколько команд используют одинаковые признаки, а сервису нужны их актуальные значения с небольшой задержкой.
Для исторического обучения важно получать значения, доступные на момент прогнозируемого события, а не сегодняшнее исправленное состояние. В системах вроде Feast для этого используется point-in-time retrieval. Но правильная временная привязка требует корректных временных меток и источников; сам инструмент не исправляет все ошибки данных.
Пайплайн, CI/CD и непрерывное обучение
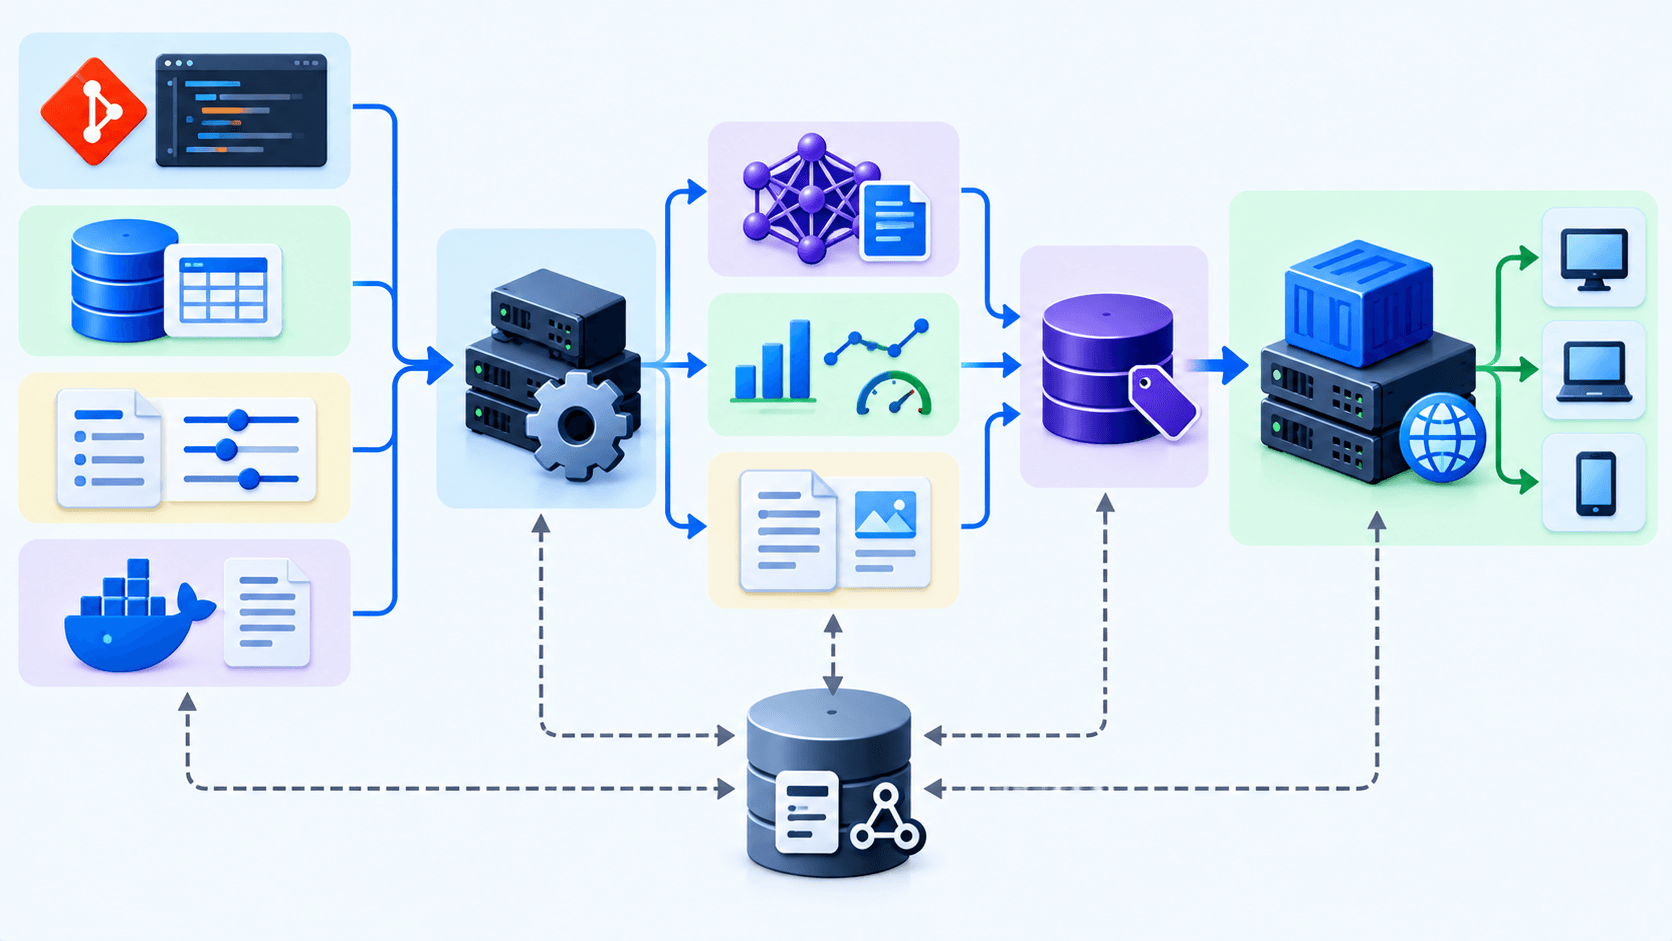
Пайплайн описывает последовательность и зависимости операций. Например: проверить данные, подготовить признаки, обучить кандидата, оценить его, зарегистрировать артефакт и передать на решение о выпуске.
Этапы должны иметь понятные входы и выходы. Повторный запуск после ошибки не должен молча перезаписывать уже принятые результаты или повторно публиковать один и тот же артефакт. Нужны правила повторов, уникальные идентификаторы запусков и сохранение диагностической информации.
CI, continuous integration, означает непрерывную интеграцию: изменения кода и компонентов регулярно объединяют и проверяют. Для ML полезны тесты подготовки данных, контрактов, загрузки модели и короткий проверочный запуск. Не обязательно выполнять дорогое полное обучение на каждый commit.
CD обычно расшифровывают как continuous delivery, непрерывную доставку, либо continuous deployment, непрерывное развертывание. В первом случае финальный допуск может оставаться ручным, во втором выпуск прошедших проверки изменений автоматизирован. Для ML в обоих случаях нужны проверки данных, модели и целевой среды.
CT, continuous training, означает автоматизированное повторное обучение по согласованному событию или расписанию. CT не требует автоматически переводить каждого нового кандидата в production.
Как выбрать серверы для MLOps
У MLOps нет единой обязательной аппаратной конфигурации. Разные части жизненного цикла предъявляют разные требования.
Нагрузка | Основные ресурсы | Что измерять перед закупкой |
|---|---|---|
Подготовка данных | CPU, RAM, I/O | Скорость преобразования и максимальная память |
Обучение | CPU или GPU, RAM, хранение | Время эксперимента, качество, память, длительность checkpoint |
Пакетный инференс | Вычисления и поток данных | Срок обработки всего набора |
Онлайн-инференс | Вычисления, память и сеть | Задержки, параллельность, ошибки и скорость под нагрузкой |
Registry и метаданные | Устойчивое хранение и доступность | Восстановление, целостность и время доступа |
Когда GPU не требуется
Часть табличных моделей и небольших сервисов нормально работает на CPU. Если целевое качество и сроки выполняются, GPU может не дать полезного эффекта. Более дорогая инфраструктура не улучшает модель сама по себе.
Как предварительно оценить вычислительную емкость
Для планирования обучения можно посчитать требуемые GPU-часы. Условный пример: десять независимых запусков в сутки, каждому нужны два одинаковых GPU на три часа. Объем работы составляет 60 GPU-часов в сутки.
Четыре GPU дают теоретически 96 GPU-часов за сутки. Но при плановой полезной загрузке 60% получится только 57,6 GPU-часа. В таком предположении четырех GPU недостаточно. Это учебная оценка, не рекомендация покупать определенное число карт: дальше проверяют расписание, возможность выделять пары GPU, сроки завершения, повторные запуски и обслуживание.
Сумма GPU-часов не учитывает все ограничения размещения. Задание, которому одновременно нужны четыре GPU, не выполнится на двух, даже если за длительный период у них накапливается нужное количество часов.
Нужно ли разделять обучение и production-инференс
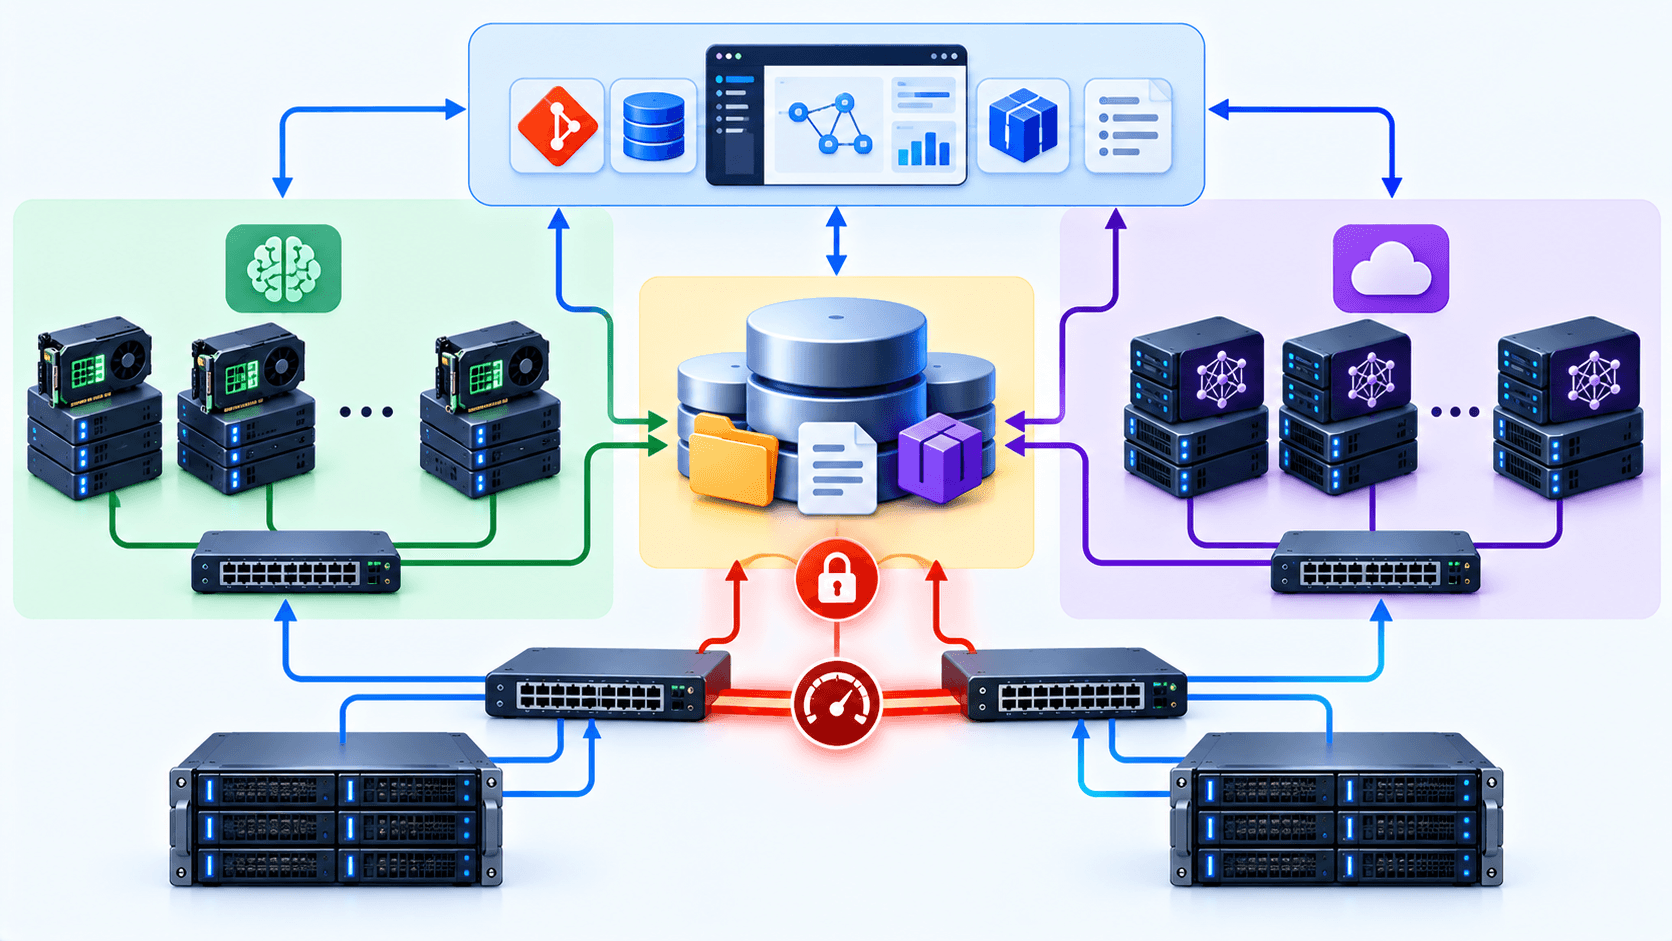
Обучение может занимать GPU часами и создавать пики нагрузки на память и хранилище. Онлайн-сервису обычно нужна предсказуемая доступность. Если обе нагрузки используют одни ресурсы без правил, эксперимент способен ухудшить ответ пользователям.
В небольшой некритичной среде возможно совместное размещение с ограничениями и расписанием. Для сервисов с жесткими SLO, то есть целевыми уровнями обслуживания, часто удобнее отдельные вычислительные группы или гарантированное резервирование.
Разделение должно затрагивать не только GPU. Обучение и инференс могут конкурировать за RAM, CPU, сетевой канал и СХД. Подробный разбор есть в статье об одном GPU-сервере для обучения и инференса.
Обязателен ли Kubernetes
Нет. Для небольшой платформы достаточно других средств запуска и управления, если они обеспечивают нужные ограничения, наблюдение и восстановление. Kubernetes полезен, когда его возможности соответствуют масштабу сервисов и компетенциям команды.
Даже в Kubernetes GPU не становится автоматически доступным контейнеру. Нужны совместимые драйверы, компоненты предоставления устройств и корректные запросы ресурсов. Поддержка NVIDIA Container Toolkit также не отменяет требования к драйверу на хосте.
Контейнер фиксирует значимую часть окружения, но не всю аппаратную и системную среду. Поэтому образ, проверенный на одной конфигурации, нужно испытать на целевой платформе.
Как организовать хранение датасетов и артефактов
Датасеты, checkpoint, готовые модели, образы окружений и метаданные имеют разные размеры и режимы доступа. Трекинг экспериментов может потреблять немного вычислений, но потеря его базы усложнит восстановление происхождения моделей.
Объектное хранилище удобно для многих крупных артефактов, если его поддерживают инструменты. Файловое хранилище может требоваться приложениям, ожидающим файловый интерфейс. Локальные NVMe используют как рабочий слой и кэш, но важные результаты не должны существовать только на одном вычислительном узле.
Политику хранения задают заранее: сколько версий сохранять, какие эксперименты удалять, какие данные неизменяемы и кто имеет право изменять доступ. Иначе платформа быстро накапливает результаты, ценность и происхождение которых никто не понимает.
Как выпускать модель и откатывать изменения
Перед выпуском проверяют качество на согласованной выборке, совместимость API и признаков, потребление памяти, нагрузочные показатели и сценарий восстановления. Порог качества зависит от задачи и риска, а не назначается одинаковым для всех моделей.
Новая версия может сначала работать в тестовой среде, затем получать ограниченную часть реального трафика. При shadow-проверке она обрабатывает копии запросов, но ее ответы не используются как основные. Такой режим тоже требует контроля затрат и доступа к данным.
Canary-выпуск позволяет постепенно увеличивать долю новой версии. Для его оценки заранее определяют метрики и условия остановки. Отсутствие ошибок HTTP не доказывает сохранение качества предсказаний.
Откат должен возвращать совместимую систему: модель, преобразования признаков, конфигурацию и необходимые зависимости. Если данные или API изменились несовместимо, возврат одного файла весов может не восстановить прежнее поведение.
Что мониторить после запуска
Состояние сервиса и оборудования
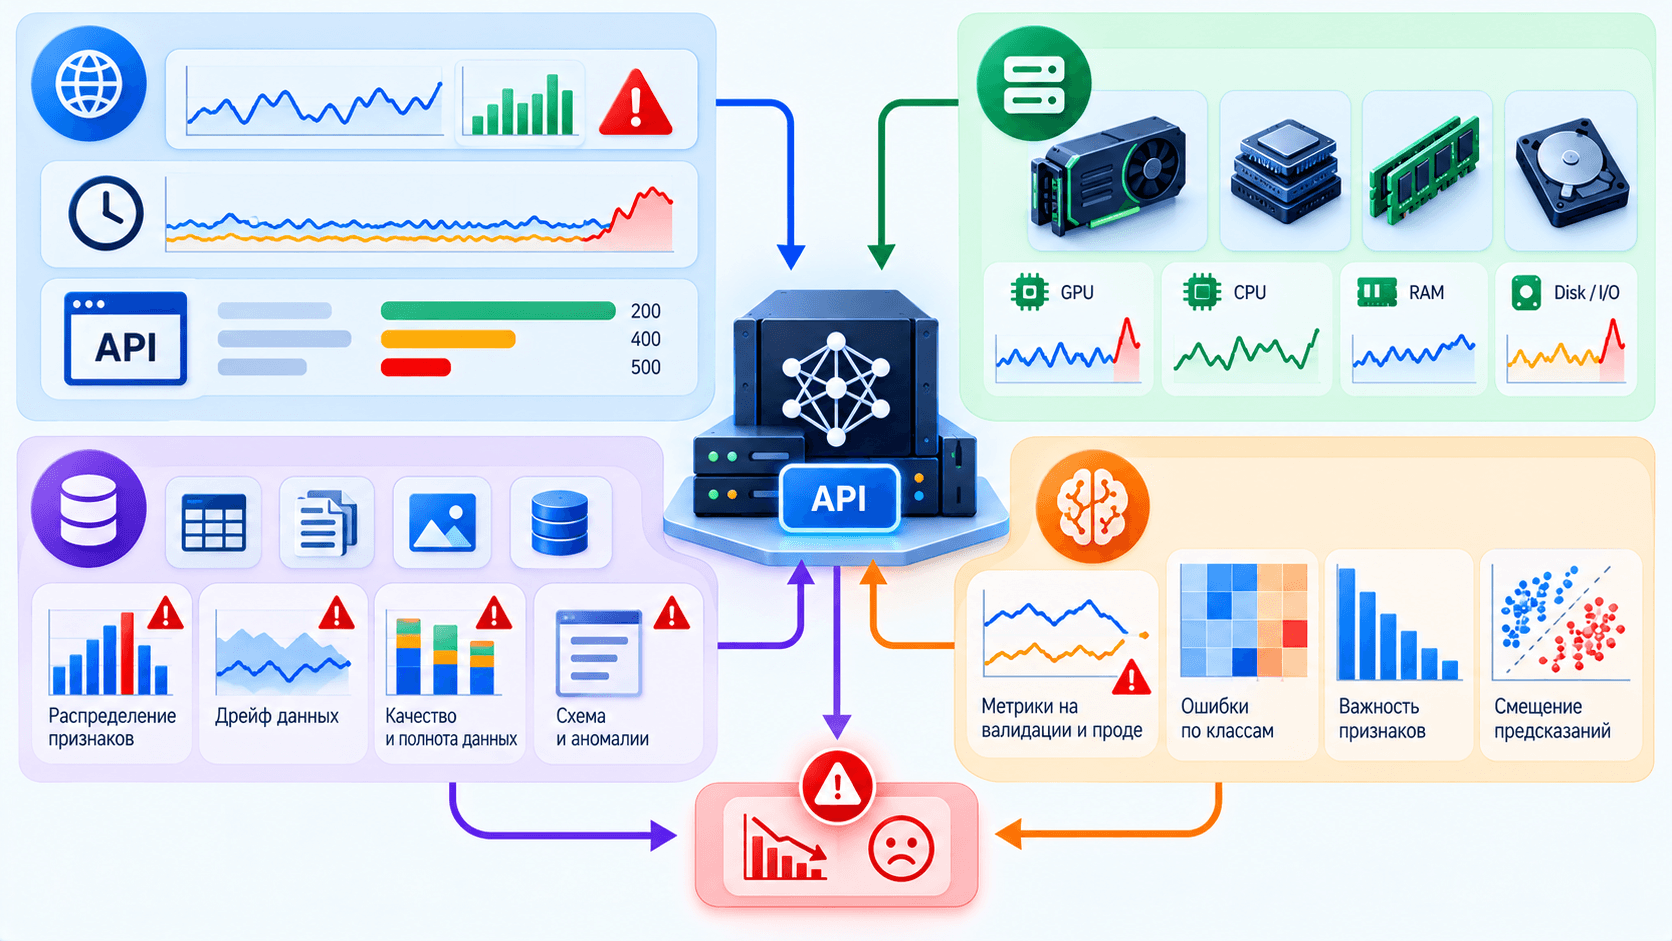
Собирают ошибки, задержки, очередь, число запросов, загрузку CPU/GPU, память и I/O. Для LLM дополнительно полезны время до первого токена, скорость генерации и характеристики входных запросов.
Постоянно высокая загрузка GPU не всегда является успехом. Она может сопровождаться неприемлемой очередью или повторной обработкой неудачных запросов. Интерпретировать ресурсные показатели нужно вместе с результатом сервиса. Аппаратные показатели разобраны в статье о мониторинге GPU-сервера.
Качество данных и предсказаний
Data drift обозначает изменение распределения входных данных. Concept drift связан с изменением зависимости между входными признаками и целевым результатом. Это разные явления.
Изменившееся распределение не доказывает ухудшения качества. А качество может ухудшиться без очевидного изменения отдельных входных признаков. По возможности предсказания сопоставляют с фактическими результатами, учитывая задержку появления разметки.
Сигнал drift должен запускать анализ по согласованному регламенту. Он не является достаточным основанием автоматически обучить и без проверки выпустить новую модель. Нужно исключить сбой источника данных, ошибки измерений и изменение самого бизнес-процесса.
Метрики процесса
Кроме качества модели полезно отслеживать время от изменения до выпуска, долю неуспешных запусков, задержку подготовки данных, стоимость завершенного эксперимента и время восстановления сервиса. Это показывает, где платформа мешает работе команды, даже если отдельный GPU загружен правильно.
Безопасность ML-платформы
Доступ к данным, публикации моделей и управлению инфраструктурой разделяют по ролям. Не каждой экспериментальной задаче нужны production-секреты, а не каждому пользователю registry нужно право менять рабочую версию.
Модельный артефакт нельзя считать безвредным только потому, что он называется моделью. Некоторые форматы сериализации способны исполнять код при загрузке. Используют доверенные источники, подходящие форматы, контроль целостности и проверку зависимостей.
Как начать внедрение MLOps без избыточной платформы
Небольшая команда и одна модель
Начните с версий кода и данных, учета экспериментов, воспроизводимого запуска, проверяемого артефакта и документированного выпуска. Добавьте мониторинг сервиса, проверку качества и испытанный откат. GPU и Kubernetes нужны только при соответствующей нагрузке.
Логические роли можно разместить на небольшом числе систем, но тогда нужно явно принять общие точки отказа. Один сервер с моделью, registry и единственной копией данных остается одной точкой отказа, независимо от количества контейнеров.
Несколько моделей и регулярные изменения
Следующий шаг: повторяемые пайплайны, отдельная тестовая среда, стандартизированные проверки, реестр и разграничение ресурсов. Цель состоит в том, чтобы новый проект использовал уже проверенные правила и инфраструктуру, а не собирал собственную систему с нуля.
Несколько команд и критичные сервисы
Появляются потребности в квотах, учете затрат, изоляции, отказоустойчивости и формальных правилах допуска. Важно назначить владельцев платформы и каждого production-сервиса. Автоматизация без ответственного за инцидент не обеспечивает эксплуатационную надежность.
Все три сценария являются примерами организации, а не описанием выполненных проектов. Переход к следующему уровню оправдан, когда предыдущая схема перестает закрывать измеренные требования.
MLOps для LLM и RAG
Для LLM к обычным артефактам добавляются токенизатор, шаблон диалога, параметры генерации, квантизация и адаптеры дообучения. В RAG необходимо учитывать версию корпуса, разбиение документов, модель эмбеддингов, индекс и настройки поиска.
Изменение одного из этих компонентов может изменить ответы без обновления основных весов. Поэтому версия «модели» в эксплуатационном смысле часто должна описывать весь комплект, а не один файл.
Частые вопросы о MLOps
Как расшифровывается MLOps?
Machine Learning Operations. Это практики организации жизненного цикла ML-систем, включая разработку, проверки, выпуск и эксплуатацию.
MLOps и DevOps являются одним и тем же?
У них общие инженерные принципы, но в ML дополнительно контролируют данные, эксперименты, модельные артефакты и качество предсказаний. Исправный программный сервис не гарантирует полезный результат модели.
MLOps-платформа обязательно должна быть готовым продуктом?
Нет. Ее можно построить из совместимых компонентов или использовать готовое решение. Важно определить обязательные функции, ответственность и требования к восстановлению, а затем сравнивать варианты.
Чем занимается MLOps-инженер?
Он организует инфраструктуру и процесс воспроизводимого запуска, проверки, доставки и наблюдения моделей. Границы роли согласуют с ML-разработчиками, инженерами данных и командой эксплуатации.
Нужен ли MLOps, если модель обучают редко?
Даже при редких обновлениях полезны версии, проверка качества, контролируемый выпуск и восстановление. Но автоматическое переобучение и сложный оркестратор могут не требоваться.
Нужно ли автоматически переобучать модель при drift?
Не обязательно. Сначала выясняют причину сигнала и оценивают качество. Повторное обучение может быть одним из действий, но новый кандидат должен пройти проверки перед выпуском.
С какого оборудования начать?
С измерения времени обучения, памяти, объема данных и требований к инференсу. Затем определяют CPU/GPU, хранение и необходимую доступность. Универсального «MLOps-сервера» для всех моделей нет.
Что нужно для проектирования MLOps-инфраструктуры
Подготовьте список моделей и сервисов, периодичность изменений, требования к качеству, задержкам и доступности. Добавьте данные о времени обучения, памяти, размере датасетов, числе параллельных экспериментов и сроках хранения артефактов.
По этим требованиям выбирают вычисления и систему хранения данных, определяют границы сред и порядок восстановления. Если нагрузке нужны ускорители, конфигурацию подбирают среди AI-серверов после проверки приложения. Приобретение GPU должно закрывать измеренную вычислительную потребность, а не подменять организацию MLOps.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


