Сервер NVIDIA B300 выбирают не по одной строке 8 x B300 в коммерческом предложении. До заказа нужно зафиксировать задачу, точную модель системы, объем HBM3e каждого GPU, CPU, RAM, NVMe, сетевые адаптеры, версию программного стека, питание, охлаждение и программу приемки. Два предложения с одинаковым названием B300 могут отличаться корпусом, хостовой частью, накопителями, сетью, сервисом и готовностью к установке в конкретном ЦОД.
Для тесно связанного обучения, fine-tuning большой модели и крупного multi-GPU инференса базовым вариантом является сервер на NVIDIA HGX B300 с восемью B300 SXM. Если нужен законченный и стандартизованный стек NVIDIA, рассматривают DGX B300. Если важны выбор Intel или AMD, емкость RAM, дисковая конфигурация, BMC и формат сервиса, сравнивают OEM-системы на HGX B300.
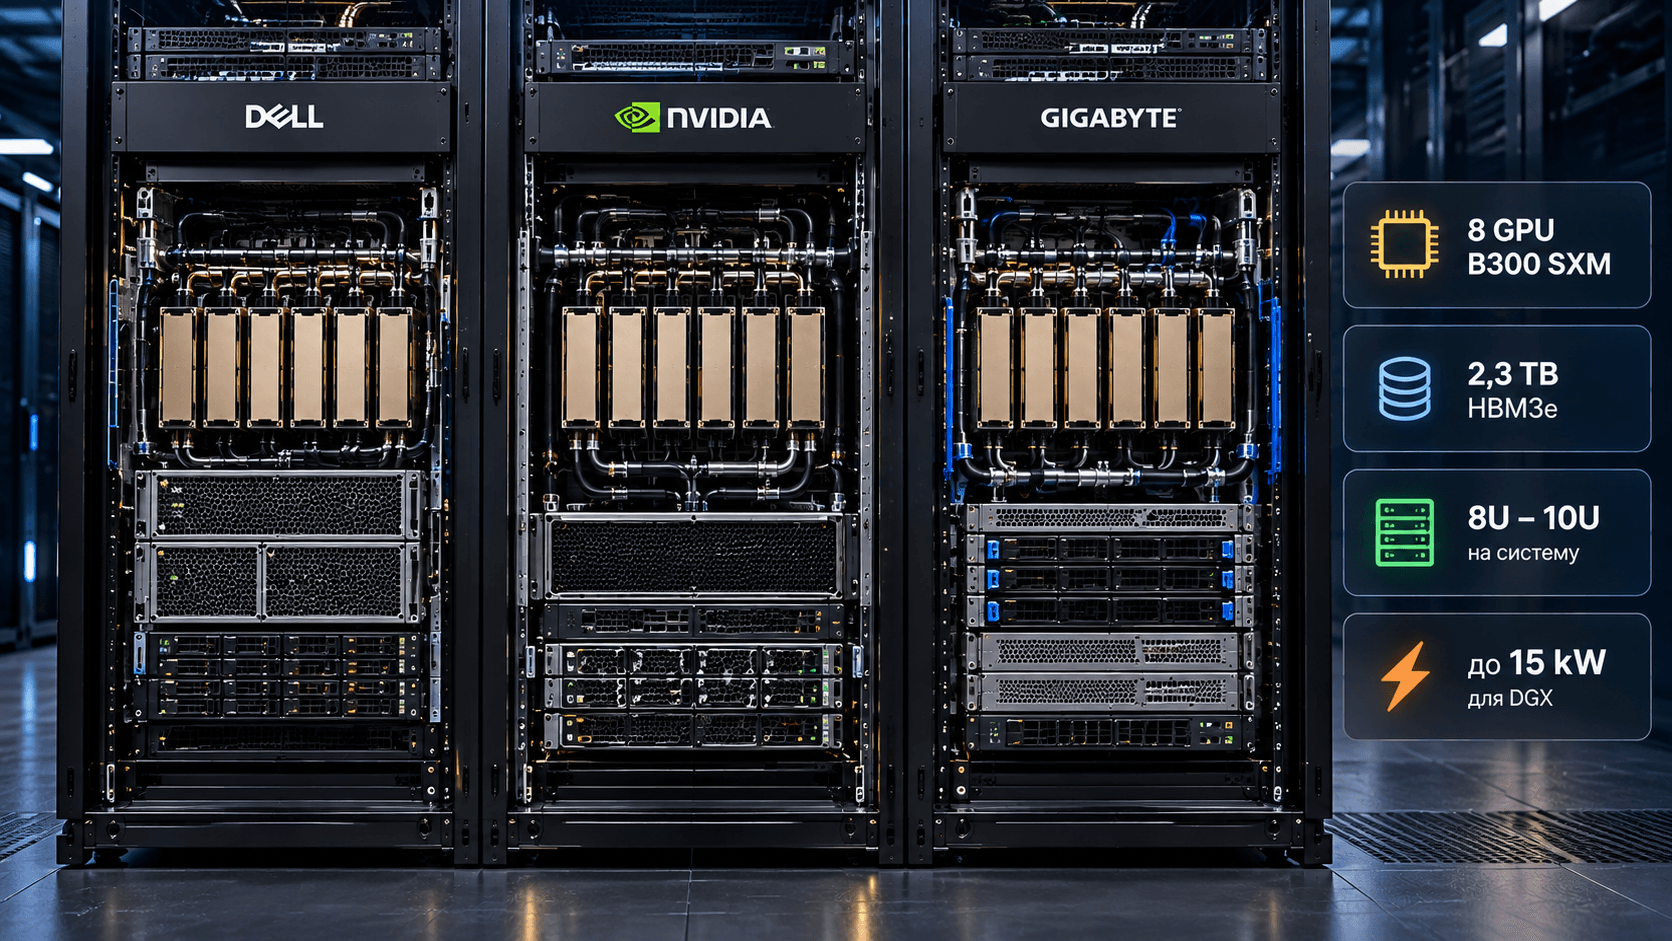
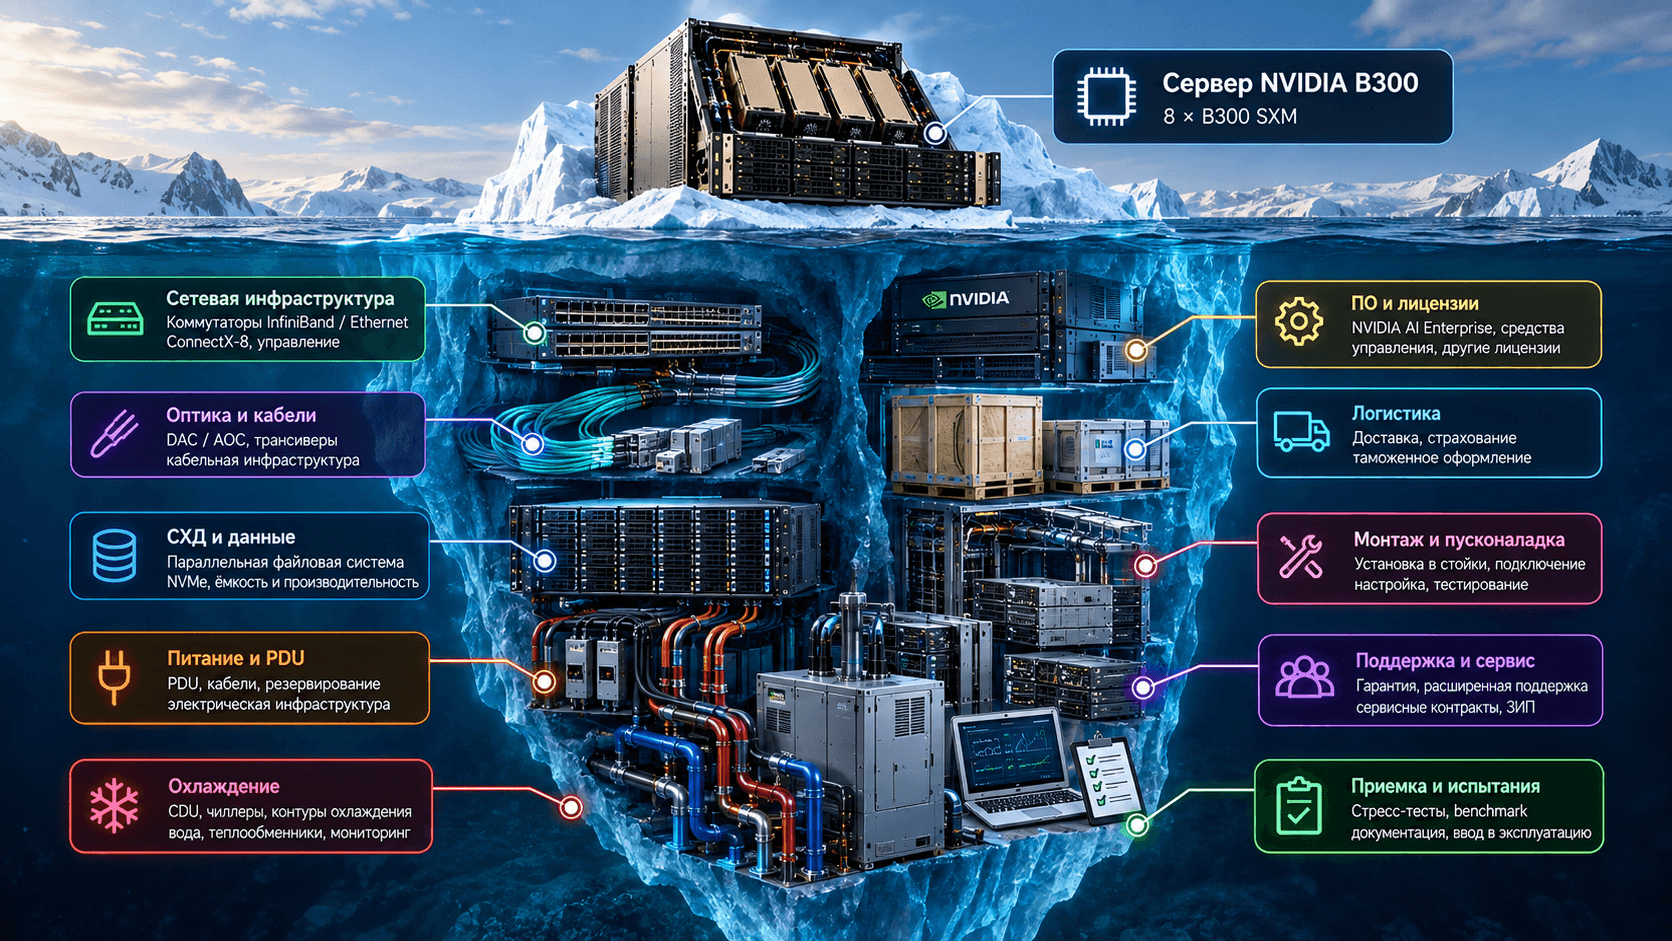
Самая дорогая ошибка возникает после покупки подходящих GPU: сервер не помещается в стойку, площадка не отводит тепловую нагрузку системы мощностью до 15 kW, PDU не поддерживает нужную схему, сеть не соответствует ConnectX-8, а общая СХД не успевает подавать данные. Поэтому выбирать нужно весь вычислительный контур, а не только ускоритель.
Что именно называют сервером NVIDIA B300
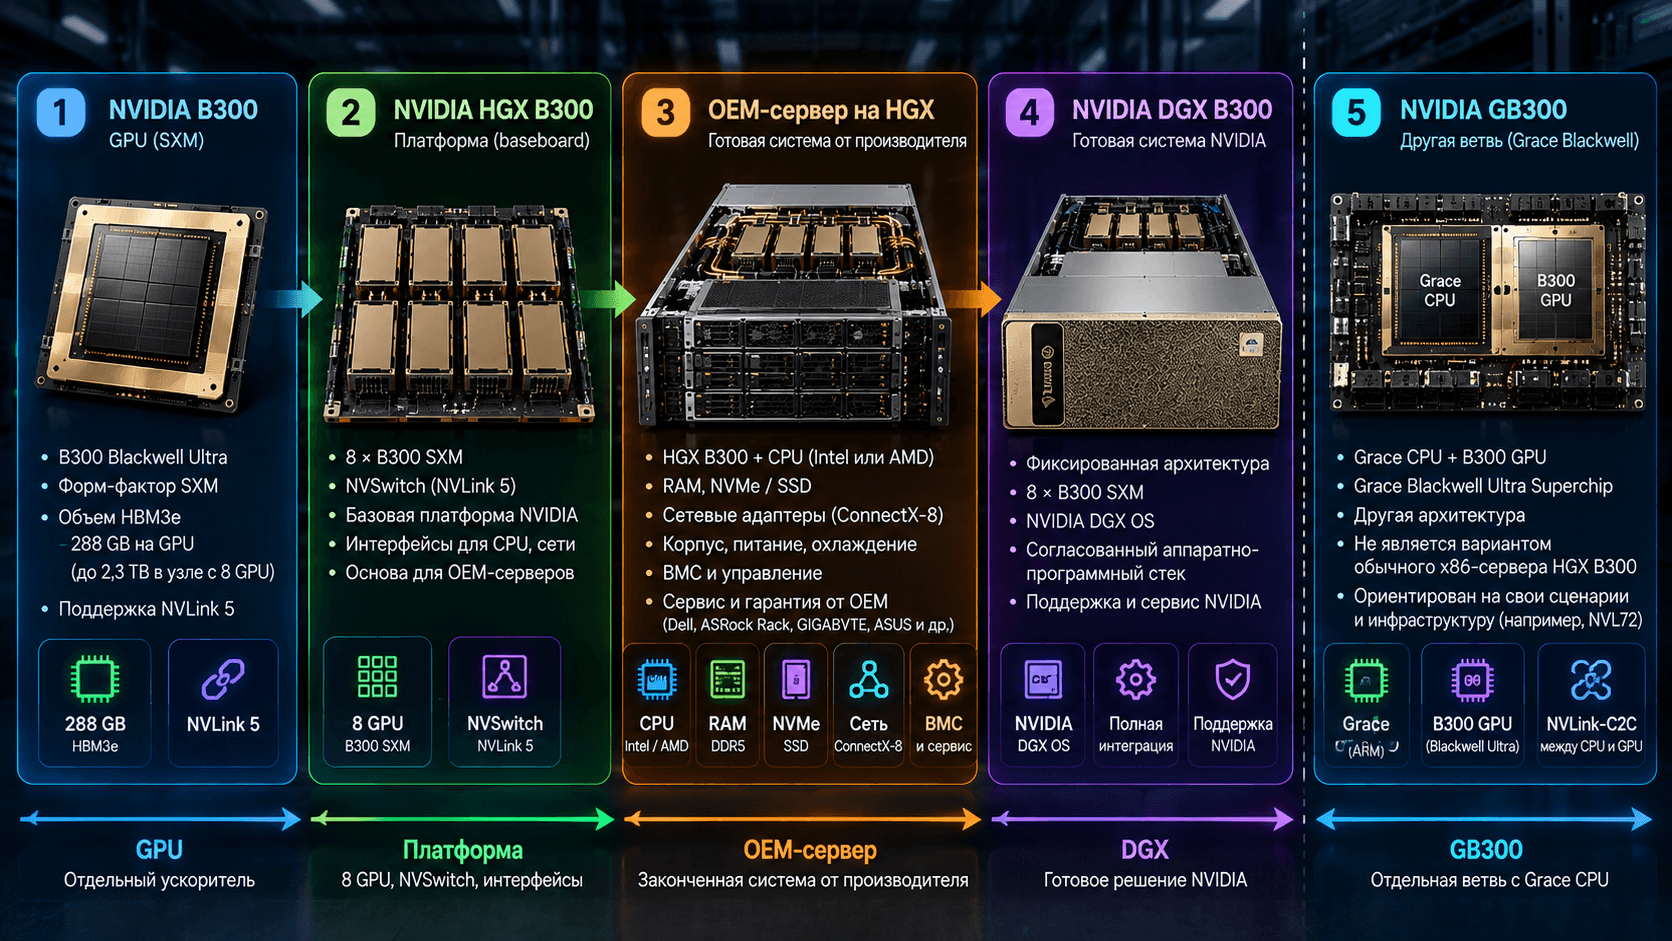
Термин используют для нескольких разных уровней продукта. Их смешение приводит к неверному техническому заданию.
NVIDIA B300является GPU Blackwell Ultra. В серверных системах он применяется в форм-факторе SXM.NVIDIA HGX B300является базовой платформой с восемью B300, NVLink пятого поколения, NVSwitch и интерфейсами для интеграции с хостом и сетью.OEM-сервер HGX B300является законченным сервером Dell, ASRock Rack, GIGABYTE, ASUS или другого производителя. OEM добавляет CPU, RAM, NVMe, корпус, питание, охлаждение, BMC и собственную сервисную модель.NVIDIA DGX B300является готовой системой NVIDIA с фиксированной архитектурой, DGX OS и согласованным аппаратно-программным стеком.NVIDIA GB300использует Grace CPU и B300 в составе Grace Blackwell Ultra Superchip. Это другая ветвь, которую нельзя считать вариантом обычного x86-сервера HGX B300.
Сначала определите workload, затем конфигурацию
Фраза сервер для нейросети не позволяет выбрать оборудование. Поставщику нужны параметры реальной нагрузки:
Модель, число параметров и архитектура, включая MoE при ее использовании.
Режим работы: pretraining, fine-tuning, inference, RAG, аналитика или HPC.
Точность весов и вычислений: FP4, FP8, BF16, FP16 либо другой формат.
Длина контекста, размер batch, число одновременных запросов и требуемые SLA.
Объем датасета, формат файлов, скорость preprocessing и схема checkpoint.
Один узел или кластер, а также план роста на 12-36 месяцев.
Целевые метрики: tokens/s, time-to-first-token, inter-token latency, samples/s, время эпохи или time-to-train.
Ограничения площадки по стойке, мощности, температуре входящего воздуха, шуму, сети и массе.
Без этих данных производительность оценивают по рекламным PFLOPS, хотя приложение может упираться в GPU memory, межGPU-обмен, CPU preprocessing, storage либо внешнюю сеть. Методика корректного сравнения приведена в материале как читать benchmark GPU для LLM.
Быстрая карта выбора
Сценарий | На что смотреть в первую очередь | Типичная ошибка |
|---|---|---|
Обучение или fine-tuning крупной модели на одном узле | объем HBM3e, NVLink и NVSwitch, CPU feed, RAM, локальный cache | считать 2,3 TB единой общей памятью без настройки parallelism |
Multi-node training | восемь GPU на узел, ConnectX-8, topology fabric, NCCL, общая СХД | заказать серверы, а сеть и кабели выбирать после поставки |
Высоконагруженный LLM-инференс | memory budget с KV-cache, batch, latency, число replicas, MIG | делить модель на восемь GPU, хотя независимые replicas дают выше throughput |
RAG и корпоративный AI | inference profile, RAM для индексов и cache, storage latency, north-south сеть | покупать максимум GPU и оставлять узким местом retrieval pipeline |
HPC и научные расчеты | требуемая точность, поддержка kernels, CPU-GPU обмен, MPI и сеть | переносить оценки FP4/FP8 на задачу, которой нужен FP64 |
Общая AI-платформа для команд | изоляция, scheduler, контейнеры, MIG, мониторинг, quota | не заложить эксплуатационный стек и владельца платформы |
Как рассчитать нужную GPU-память
Память B300 расходуют веса модели, KV-cache, activations, gradients, optimizer states, рабочие буферы и резерв runtime. Для инференса грубую оценку начинают с весов:
память весов = число параметров x байт на параметр
Модель на 70 млрд параметров в BF16 требует около 140 GB только для весов. Это не итоговый memory budget: нужен KV-cache, временные буферы, служебная память framework и запас. При длинном контексте и большом числе одновременных сессий KV-cache способен стать главным потребителем HBM3e.
Для обучения расчет намного тяжелее. К весам добавляются gradients, optimizer states и activations. Точный результат зависит от optimizer, precision, checkpointing, sharding и схемы параллелизма. Подробная методика приведена в руководстве сколько VRAM нужно для AI, LLM и обучения.
Почему встречаются 270 и 288 GB
В официальных источниках нет одной универсальной цифры. Blackwell Ultra datasheet указывает для HGX B300 270 GB HBM3e на GPU и 2,1 TB на восемь GPU. Актуальная NVIDIA Enterprise Reference Architecture и руководство DGX B300 указывают 288 GB на GPU и 2,30 TB на узел. Карточки текущих систем в каталоге Start Server также заявляют 288 GB, тогда как официальная страница Dell XE9780 на момент проверки показывает вариант 270 GB.
Причину расхождения нельзя додумывать. В договоре и программе приемки зафиксируйте:
точное название производителя и manufacturer part number;
количество GPU и форм-фактор SXM;
установленную HBM3e на каждом GPU и суммарный объем;
допустимый объем памяти, видимый в
nvidia-smi;версии VBIOS, firmware, driver и CUDA;
действие сторон, если фактическая конфигурация отличается от спецификации.
Надпись B300 288GB в заголовке счета не заменяет полный BOM и приемочный критерий.
Сервер на 4 или 8 NVIDIA B300
В Wordstat существует запрос сервер 4х nvidia b300 288 gb, но наличие спроса не подтверждает существование любой желаемой конфигурации. Актуальная reference architecture NVIDIA и видимые системы в категории B300 используют восемь B300 SXM на HGX B300 baseboard. Поэтому нельзя сокращать восьми-GPU платформу до четырех ускорителей без документации производителя и подтвержденного SKU.
Если workload требует только четыре GPU, задайте поставщику три вопроса:
Есть ли серийный и поддерживаемый четырех-GPU B300 сервер с точным part number?
Сохраняются ли штатные NVLink, cooling, power и firmware support?
Не выгоднее ли выбрать другую платформу или GPU, чем оплачивать восемь B300 с низкой загрузкой?
Восемь B300 оправданы, когда модель или training job действительно использует единый NVLink-домен, либо сервер обслуживает несколько плотно упакованных inference replicas. Для одной небольшой модели и умеренного трафика такой узел может оказаться избыточным.
DGX B300 или OEM-сервер на HGX B300
Обе ветви используют восемь B300, но решают задачу поставки по-разному.
Критерий | NVIDIA DGX B300 | OEM-сервер на HGX B300 |
|---|---|---|
Архитектура | фиксированная система NVIDIA | HGX baseboard в системе конкретного OEM |
CPU | 2 x Intel Xeon Platinum 6776P | варианты Intel Xeon или AMD EPYC зависят от модели |
RAM | 2 TB по умолчанию, расширение до 4 TB | встречаются платформы с пределом 4, 6 или 8 TB |
Локальный storage | заданная схема E1.S cache и M.2 boot | число и формат NVMe выбирают в пределах возможностей OEM |
Сеть | ConnectX-8 и BlueField-3 в определенной topology | состав NIC и DPU нужно сверять по точной конфигурации |
ПО | DGX OS и согласованный NVIDIA stack | ОС, драйверы, firmware и management stack формируют OEM и интегратор |
Кастомизация | ограничена стандартом DGX | выше по CPU, RAM, storage, BMC и сервису |
Поддержка | модель поддержки NVIDIA DGX | поддержка OEM, поставщика и отдельных компонентов |
Подходит, когда | нужен единый стандарт для парка DGX и минимизация вариантов | нужна адаптация хоста, дисков, управления и бюджета под проект |
DGX имеет смысл, если организация стандартизирует инфраструктуру на готовых системах NVIDIA, требует предсказуемый baseline и готова принять фиксированную конфигурацию. OEM HGX рациональнее, когда критичны выбор CPU, большая системная память, конкретные NVMe, корпоративный BMC или унификация с существующим парком.
Статус NVIDIA-Certified нужно проверять для точной модели и конфигурации, а не переносить автоматически на любой сервер с HGX. Общий список доступных систем находится в разделе серверов с GPU NVIDIA B300.
Как выбрать CPU и оперативную память
CPU не выполняет основную матричную работу LLM, но от него зависят tokenization, decompression, dataloader, host runtime, storage I/O, networking и часть orchestration. Недостаток CPU-ядер или неправильная NUMA topology способен снизить загрузку GPU.
NVIDIA Enterprise Reference Architecture для HGX B300 описывает двухсокетный узел, минимум 48 физических ядер на сокет и рекомендацию 56 ядер. Для системной памяти указан минимум 2 TB и совокупная полоса не менее 500 GB/s. DIMM должны быть симметрично распределены между сокетами и каналами.
Выбор между Intel и AMD делают не по бренду, а по конкретной платформе:
числу ядер и частоте для CPU-side части workload;
количеству и topology PCIe lanes;
пропускной способности памяти;
поддерживаемым DIMM и доступному объему RAM;
привязке GPU, NIC и NVMe к NUMA nodes;
сертификации software stack;
сервисной политике и доступности комплектующих.
Объем 2 TB подходит как отправная точка reference configuration, но не является универсальным ответом. 4-8 TB нужны, если приложение держит крупный dataset cache, vector index, CPU-side preprocessing, несколько пайплайнов или использует offload. Для чистого GPU-инференса без тяжелой CPU-части максимальная RAM может не дать измеримого выигрыша.
NVMe и СХД: данные должны успевать за GPU
Локальные накопители разделяют как минимум на boot и data cache. Загрузочная пара хранит ОС и системные разделы. Быстрые E1.S, E3.S или U.2 NVMe используют для cache датасета, временных checkpoints, staging и промежуточных файлов.
Reference architecture NVIDIA рекомендует минимум 1 TB NVMe на каждый CPU socket для inference и HPC, минимум 2 TB на socket для training, а также отдельный загрузочный NVMe на 1 TB. Это нижняя граница reference design, а не оптимальная емкость для любого проекта.
Вопросы для расчета storage:
сколько данных нужно прочитать за эпоху;
каков aggregate throughput при одновременной работе всех GPU;
сколько training workers обращается к метаданным;
как часто и какого размера сохраняются checkpoints;
за какое время узел должен прогреться после рестарта;
какие данные уникальны, а какие можно восстановить;
нужен ли GPUDirect Storage;
где размещаются dataset, model registry и резервные копии.
Локальный RAID 0 может быть уместен для воспроизводимого cache, но не для единственной копии checkpoint. Архитектуру общего слоя подробнее раскрывает материал о видах и устройстве систем хранения данных.
Сеть: NVLink не заменяет InfiniBand или Ethernet
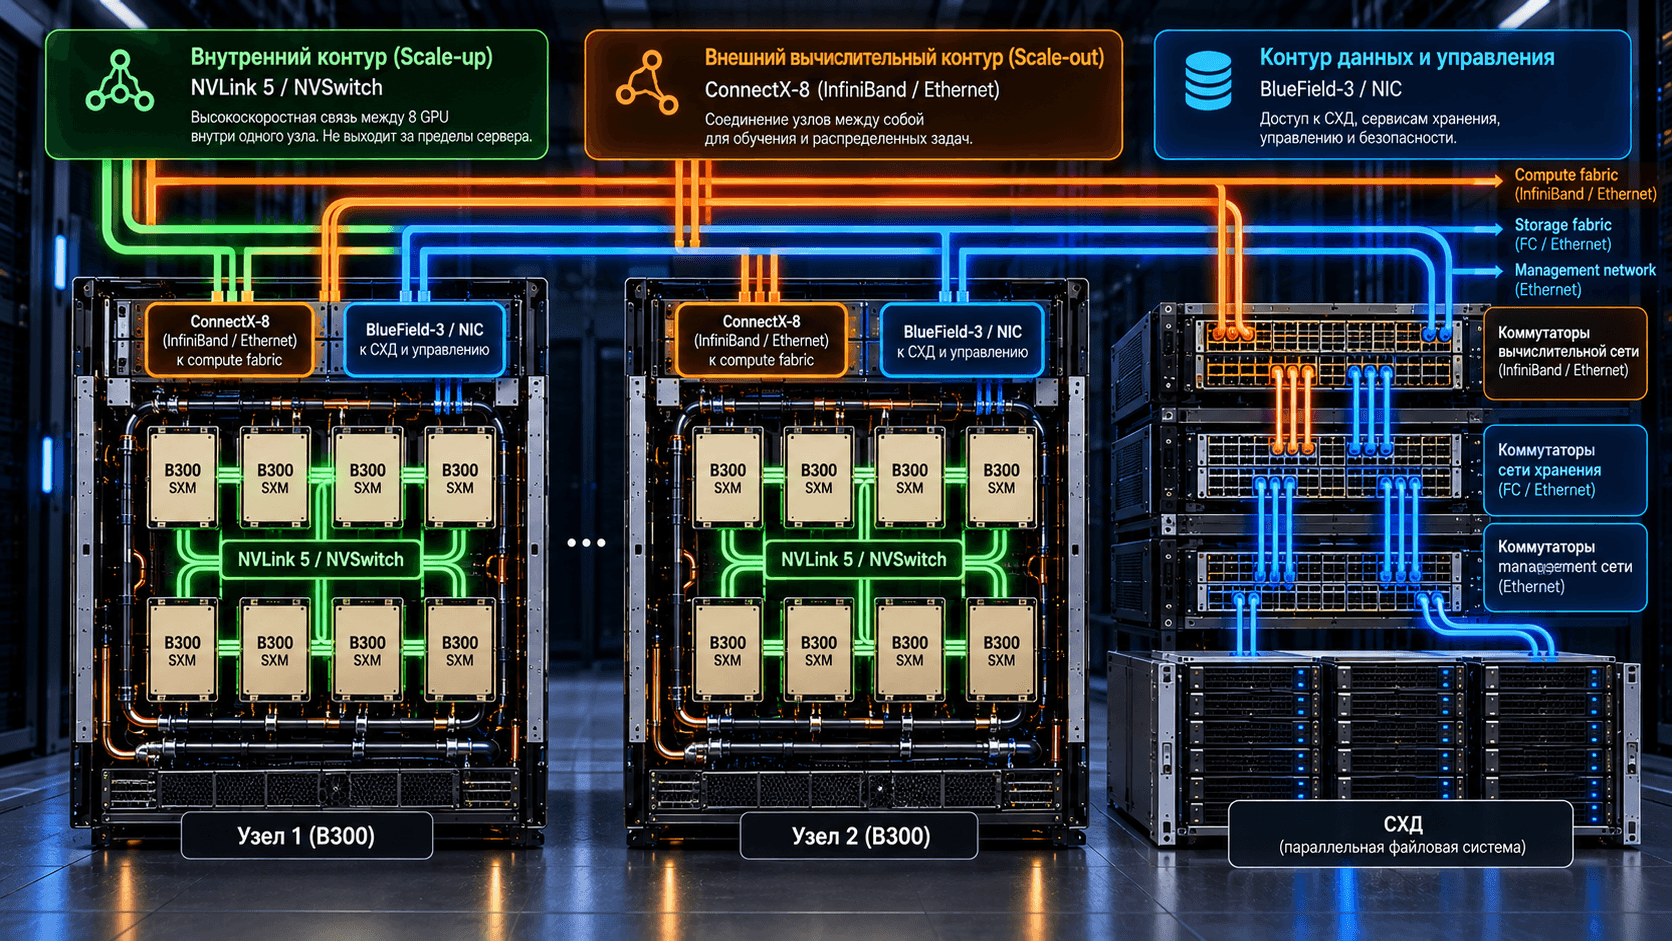
NVLink и NVSwitch связывают восемь GPU внутри сервера. ConnectX-8 переносит трафик между узлами, а BlueField-3 или отдельные NIC обслуживают storage, management и north-south traffic. Это разные контуры.
В HGX B300 reference architecture каждому GPU сопоставлен ConnectX-8 с пропускной способностью до 800 Gb/s, реализуемой как два порта по 400 Gb/s. Такая сеть нужна не автоматически. Для чистого независимого inference внутри одного узла дорогой full-scale compute fabric может не дать выгоды. Для multi-node training, expert parallelism и распределенного fine-tuning межузловая сеть становится частью вычислительной системы.
До заказа зафиксируйте:
Ethernet или InfiniBand;
single-plane или dual-plane topology;
число активных 400G или 800G портов на узел;
модель и firmware адаптеров;
switches, optics, transceivers, DAC или AOC;
rail-optimized подключение для кластера;
отдельные management и storage networks;
поддержку RDMA, GPUDirect RDMA и GPUDirect Storage;
полный cable map и длины линий.
Питание, охлаждение и стойка
Для HGX B300 datasheet указывает настраиваемый TDP до 1 100 W на один GPU. Восемь GPU дают до 8,8 kW только на ускорители. К ним добавляются CPU, RAM, NIC, NVMe, вентиляторы и потери преобразования питания.
У DGX B300 официальное руководство указывает 14,5 kW потребления в эксплуатационной таблице и 15 kW system max в разделе питания. Система занимает 10U, весит 168 kg в AC-исполнении и использует двенадцать вводов 200-240 V AC. Эти цифры нельзя переносить на каждый OEM-сервер, но они показывают класс инженерной нагрузки.
До подписания договора площадка должна подтвердить:
доступные rack units, глубину и грузоподъемность стойки;
допустимую нагрузку на пол и маршрут заноса;
тип rails и сервисное пространство;
напряжение, число линий, разъемы, PDU и схему резервирования;
пиковую мощность, а не только среднее потребление;
максимальное тепловыделение и airflow;
температуру воздуха именно на входе сервера;
отсутствие рециркуляции горячего воздуха;
возможность воздушного или жидкостного отвода тепла для выбранного SKU;
доступность портов, кабельные радиусы и размещение OSFP.
Проверять охлаждение лучше до поставки по паспортной мощности, а после монтажа подтвердить его нагрузочным тестом. Для этого пригодится протокол проверки охлаждения GPU-сервера в стойке.
Программный стек и совместимость
B300 имеет compute capability 10.3. Старый container image, driver или kernel, собранный только под прежние архитектуры, может не использовать GPU либо работать неоптимально. В техническом задании нужно зафиксировать не абстрактное поддерживает CUDA, а воспроизводимый software baseline:
ОС и kernel;
NVIDIA driver;
CUDA toolkit и runtime;
firmware GPU, NVSwitch, NIC, DPU и BMC;
NCCL и network plugin;
container runtime;
framework и его версия;
libraries для inference или training;
DCGM и система мониторинга;
scheduler, Kubernetes либо Slurm при их использовании.
Какие B300-серверы сравнивать
В каталоге Start Server представлены готовая NVIDIA DGX и OEM-системы на HGX. Таблица показывает различия, важные для выбора. Параметры относятся к опубликованным карточкам на дату проверки; заказ оформляют только по подтвержденному BOM.
Система | Хостовая платформа | RAM и storage | Когда рассматривать |
|---|---|---|---|
10U, 2 x Xeon 6776P, 8 x B300 | 2 TB RAM с расширением до 4 TB, 8 x E1.S cache, 2 x M.2 boot | нужен стандартный стек NVIDIA и единая архитектура DGX | |
10U, 2 x Intel Xeon 6, 8 x B300 | до 4 TB RAM, до 16 E3.S или 10 U.2, BOSS-N1 | нужна OEM-система Intel с гибким локальным storage и управлением Dell | |
8U, 2 x Intel Xeon 6, 8 x B300 | до 8 TB RAM, 12 x hot-swap NVMe и M.2 | важны плотность 8U, Intel и большой предел системной памяти | |
8U, 2 x AMD EPYC 9004 или 9005, 8 x B300 | до 6 TB RAM, 12 x hot-swap NVMe и 2 x M.2 | нужен вариант AMD EPYC и гибкая OEM-конфигурация | |
ASUS XA NB3I-E12 | 9U, 2 x Intel Xeon 6, 8 x B300 | до 8 TB RAM, 10 x NVMe Gen5 | сравнивается по высоте 9U, памяти, storage и сетевой комплектации |
В одной и той же модели могут существовать разные CPU, DIMM, NVMe, NIC, cooling и power options. Название корпуса не является спецификацией заказа.
Контрольный список по каждому SKU
Полный part number сервера и HGX baseboard.
Восемь B300 SXM с согласованным объемом HBM3e.
Точные CPU, число ядер и частота.
Объем, тип, скорость и схема заполнения DIMM.
Boot, cache и data drives с part number, endurance и RAID.
ConnectX, BlueField, OCP и дополнительные NIC.
Лицензии, ОС, support subscription и право на обновления.
AC или DC, количество PSU, шнуры, вилки и требования к PDU.
Air cooling или liquid cooling, допустимая температура и airflow.
Rails, bezel, cable management и комплект поставки.
Срок и территория гарантии, SLA, способ замены узлов.
Установка, firmware baseline, burn-in и приемочные испытания.
Как сравнить цену NVIDIA B300 без скрытых различий
Цена NVIDIA B300 не равна стоимости готового проекта. В смету входят сервер, сетевые карты и DPU, switches, optics и кабели, СХД, стойки, PDU, охлаждение, лицензии, поддержка, логистика, страхование, монтаж, настройка и приемка.
Сравнивайте предложения в одной таблице, строка к строке:
Статья сравнения | Что должно быть одинаково или явно раскрыто |
|---|---|
GPU | количество, SKU, HBM3e, состояние, происхождение и гарантия |
Хост | модель сервера, CPU, RAM и memory population |
Storage | число, емкость, интерфейс, endurance, RAID и запасные диски |
Сеть | NIC и DPU, скорость, firmware, optics, кабели и switches |
Питание | AC или DC, PDU, cords, redundancy и лимит мощности |
ПО | ОС, driver, CUDA, лицензии, firmware и обновления |
Услуги | установка, настройка, обучение, burn-in, FAT и SAT |
Логистика | срок, Incoterms при необходимости, страхование, занос и такелаж |
Поддержка | кто принимает заявку, SLA, запасные части и территория обслуживания |
Если одно предложение дешевле, сначала найдите отсутствующую строку. Иногда различие связано с RAM и дисками, иногда с сетевым комплектом, сервисом или вариантом памяти GPU. Подробный шаблон нормализации приведен в статье как сравнить коммерческие предложения на GPU-сервер.
Как проверить поставщика до оплаты
Поставщик B300-сервера должен отвечать не только на вопрос о сроке. До сделки запросите:
официальное коммерческое предложение с полным BOM;
manufacturer part number и серийность конфигурации;
подтверждение нового состояния оборудования;
условия гарантии производителя и поставщика;
проверяемую цепочку поставки и комплект документов;
план логистики для тяжелой 8U-10U системы;
перечень работ на площадке и границы ответственности;
validated compatibility для NIC, optics, cables и switches;
программу factory acceptance test и site acceptance test;
порядок фиксации несоответствий и сроки их устранения;
перечень передаваемых паролей, лицензий, конфигураций и отчетов.
Фраза аналог не хуже неприемлема для GPU, сетевой topology, памяти и охлаждения без заранее описанных критериев эквивалентности. Любая замена после согласования должна проходить повторную техническую проверку.
Приемка сервера NVIDIA B300
Приемка должна доказать, что поставлена именно согласованная система и она выдерживает рабочий режим. Проверяйте:
Модель, serial number и BOM всех узлов.
Восемь GPU, объем HBM3e, VBIOS и firmware.
NVLink и NVSwitch topology, отсутствие деградировавших links.
CPU, NUMA, RAM и симметрию memory channels.
NVMe, SMART, firmware, RAID и фактическую производительность.
ConnectX и BlueField, link speed, RDMA и работу выбранного transport.
BMC, Redfish, журнал событий, remote console и разграничение доступа.
CUDA, NCCL, containers и framework в согласованных версиях.
DCGM diagnostics и длительный burn-in под одновременной GPU-нагрузкой.
NCCL all-reduce внутри узла, а для кластера также между узлами.
Прикладной benchmark на модели заказчика.
Потребление, температуру, fan speed, throttling и устойчивость при отказе допустимого компонента.
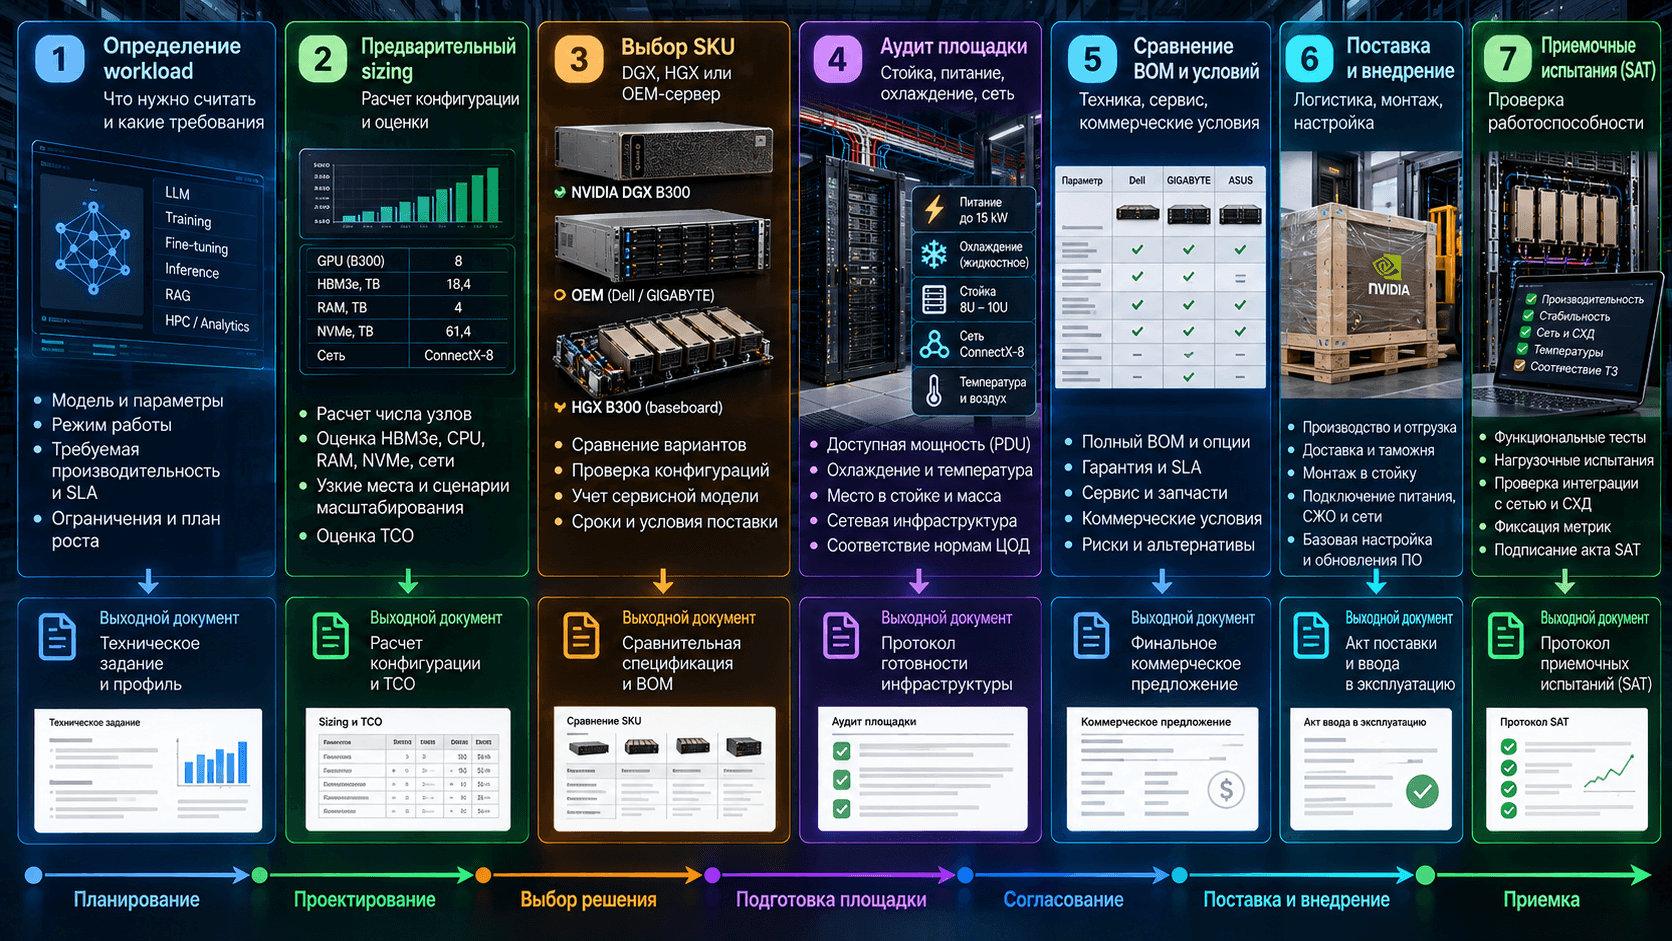
Типичные ошибки при покупке
Выбирать по суммарной памяти
2,3 TB HBM3e выглядят как единый большой объем, но приложение должно корректно распределять модель между GPU. Memory capacity не гарантирует нужную скорость.
Считать B300 отдельной PCIe-видеокартой
Текущие официальные серверные варианты B300 относятся к SXM и HGX. Упоминание PCIe Gen6 в характеристиках описывает интерфейсные возможности платформы, но не подтверждает существование дискретной B300 PCIe add-in card для произвольного сервера.
Заказать только compute node
Без switches, optics, storage, PDU, cooling и software сервер может остаться дорогим необслуживаемым узлом.
Сравнивать разные комплектации по цене
Одинаковое число GPU скрывает различия в RAM, NVMe, сети, лицензиях и гарантии. Нужна нормализованная таблица BOM.
Не проверять площадку
Системы этого класса имеют высокую массу, глубину, airflow и мощность. Обычная свободная розетка в стойке не означает готовность к B300.
Принимать сервер синтетическим тестом
Синтетика подтверждает часть аппаратной функции. Прикладной тест показывает, достигнут ли результат для модели, batch, context и dataset заказчика.
Как сформировать запрос на подбор
Для первого расчета подготовьте короткий паспорт проекта:
модель и режим training, fine-tuning или inference;
precision, context, batch и concurrency;
объем данных и схема хранения;
текущая производительность и целевой SLA;
один узел или планируемое число узлов;
предпочтение DGX либо OEM, если оно уже есть;
ограничения по CPU, RAM и локальному NVMe;
существующая сеть и СХД;
параметры стойки, питания и охлаждения;
требования к сроку, поддержке, монтажу и приемке.
Эти данные позволяют сравнить несколько конфигураций по результату и TCO, а не по максимальному числу характеристик.
FAQ
Что такое сервер NVIDIA B300?
Это законченная AI-система с GPU NVIDIA B300 Blackwell Ultra. В типичной текущей реализации сервер использует платформу HGX B300 с восемью GPU SXM, NVLink и NVSwitch. CPU, RAM, NVMe, сеть, корпус и охлаждение зависят от DGX или конкретного OEM.
Сколько стоит сервер NVIDIA B300?
Стоимость зависит от точного GPU SKU, производителя сервера, CPU, RAM, NVMe, сети, лицензий, гарантии, логистики и работ. Сравнивать нужно одинаковый BOM и отдельно считать инфраструктуру ЦОД. Актуальную цену запрашивают под зафиксированную конфигурацию.
Где купить NVIDIA B300?
Выбирайте поставщика, который фиксирует полный part number, подтверждает гарантию, проектирует сеть и площадку, выполняет burn-in и принимает систему по согласованной программе. Текущие варианты нужно сравнивать в специализированной категории B300-серверов.
Можно ли купить сервер с четырьмя NVIDIA B300?
Наличие такого поискового запроса не доказывает наличие серийной системы. Текущая HGX B300 reference architecture использует восемь B300. Для четырех GPU нужен подтвержденный производителем SKU и проверка NVLink, питания, охлаждения и support. Если такого SKU нет, сравнивают другую платформу.
В NVIDIA B300 270 или 288 GB памяти?
В официальных документах встречаются обе спецификации. Общий Blackwell Ultra datasheet указывает 270 GB для HGX B300, а актуальные Enterprise Reference Architecture и DGX B300 User Guide указывают 288 GB. В закупке фиксируют точный part number и фактическую память, видимую программными средствами.
Существует ли NVIDIA B300 PCIe?
Текущие официальные серверные B300-системы строятся на B300 SXM и HGX. Поддержка PCIe Gen6 в спецификации GPU и платформы не означает, что доступна отдельная B300 PCIe-карта для установки в любой сервер. Требуйте официальный product SKU, а не описание интерфейса.
Чем DGX B300 отличается от HGX B300?
HGX B300 является восьми-GPU базовой платформой для интеграции. DGX B300 является законченным сервером NVIDIA с определенными CPU, RAM, NVMe, сетью, питанием и DGX OS. OEM также выпускают законченные серверы на HGX B300, но с другими хостовыми конфигурациями.
Что означает 2 или 4 TB у B300?
Нужно уточнять тип памяти. В DGX B300 2 TB по умолчанию и до 4 TB относятся к системной DDR5 RAM. Суммарная GPU memory восьми ускорителей у актуальной конфигурации составляет до 2,3 TB HBM3e.
Сколько RAM нужно серверу B300?
NVIDIA reference architecture задает минимум 2 TB для HGX B300. Больший объем обосновывают через dataset cache, preprocessing, vector indexes, CPU workload и offload. Покупать 6-8 TB только ради максимальной комплектации не нужно.
Подбор и покупка сервера NVIDIA B300
Start Server может подобрать DGX или OEM-сервер на HGX B300, рассчитать CPU, RAM, NVMe, СХД, InfiniBand или Ethernet, проверить питание и охлаждение, организовать поставку, монтаж и приемочные тесты.
Для расчета передайте модель, режим работы, memory budget, требования к latency или времени обучения, число узлов и параметры площадки. Посмотрите доступные серверы с GPU NVIDIA B300 или отправьте паспорт проекта через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


