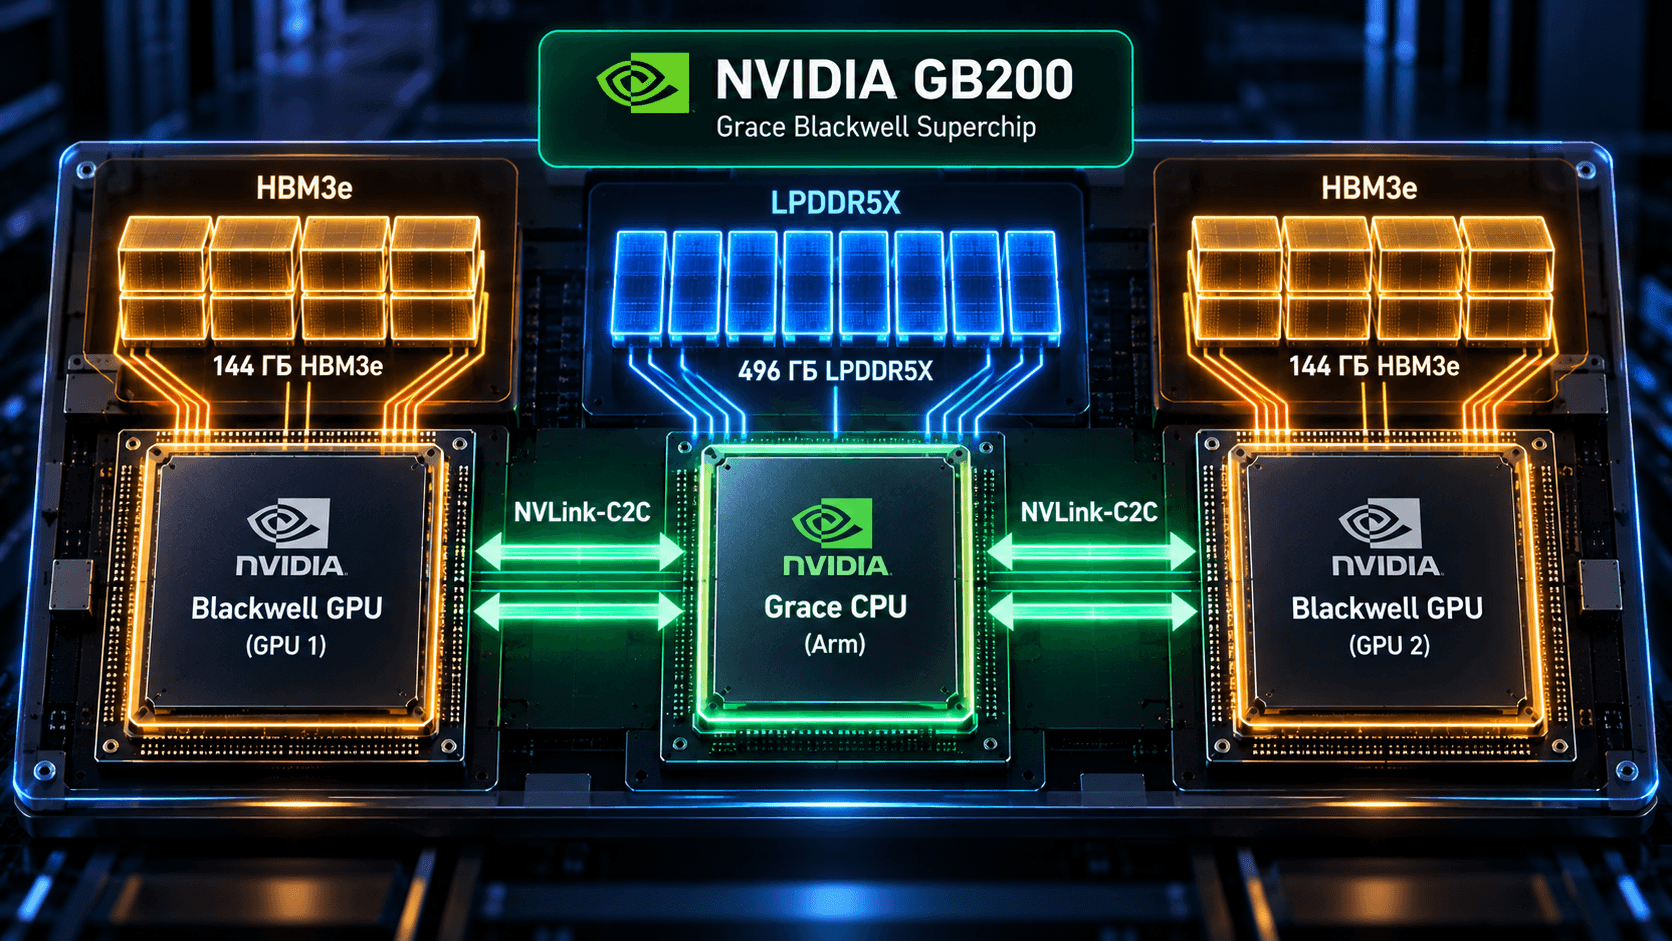
NVIDIA GB200 Grace Blackwell Superchip объединяет один процессор NVIDIA Grace и два графических ускорителя Blackwell. CPU и GPU связаны интерфейсом NVLink-C2C, который обеспечивает быстрый обмен и когерентный доступ к памяти. Такая архитектура предназначена для обучения нейросетей, инференса больших моделей и других задач, где важны одновременно вычислительная мощность, память и передача данных.
GB200 нельзя рассматривать как обычную видеокарту для установки в свободный слот PCIe. Это компонент специализированной вычислительной системы. На его основе строят разные решения: GB200 NVL4 с четырьмя GPU, стоечные GB200 NVL72 и готовые системы NVIDIA DGX GB200.
Что такое NVIDIA GB200 и чем он отличается от B200
В основе GB200 лежит тесная интеграция процессора и ускорителей. Grace выполняет работу центрального процессора: обслуживает операционную систему, управляет задачами и участвует в обработке данных. Blackwell GPU выполняют параллельные вычисления, включая операции нейросетей.
B200 и GB200 относятся к одному поколению Blackwell, но обозначают разные компоненты. B200 используется как обозначение GPU, в частности в платформе HGX B200. GB200 обозначает связку Grace CPU с двумя Blackwell GPU. Из этого не следует, что ускорители из разных платформ можно переставлять между ними.
Название | Что оно обозначает | Что важно не перепутать |
|---|---|---|
Blackwell | Архитектура GPU | Это не название одной комплектации сервера |
B200 | GPU поколения Blackwell | Сам по себе не включает Grace CPU |
GB200 | Суперчип: один Grace CPU и два Blackwell GPU | Это не стандартная PCIe-видеокарта |
HGX B200 | Платформа с восемью GPU для серверов | Не равна GB200 и не содержит Grace CPU в составе GPU-платформы |
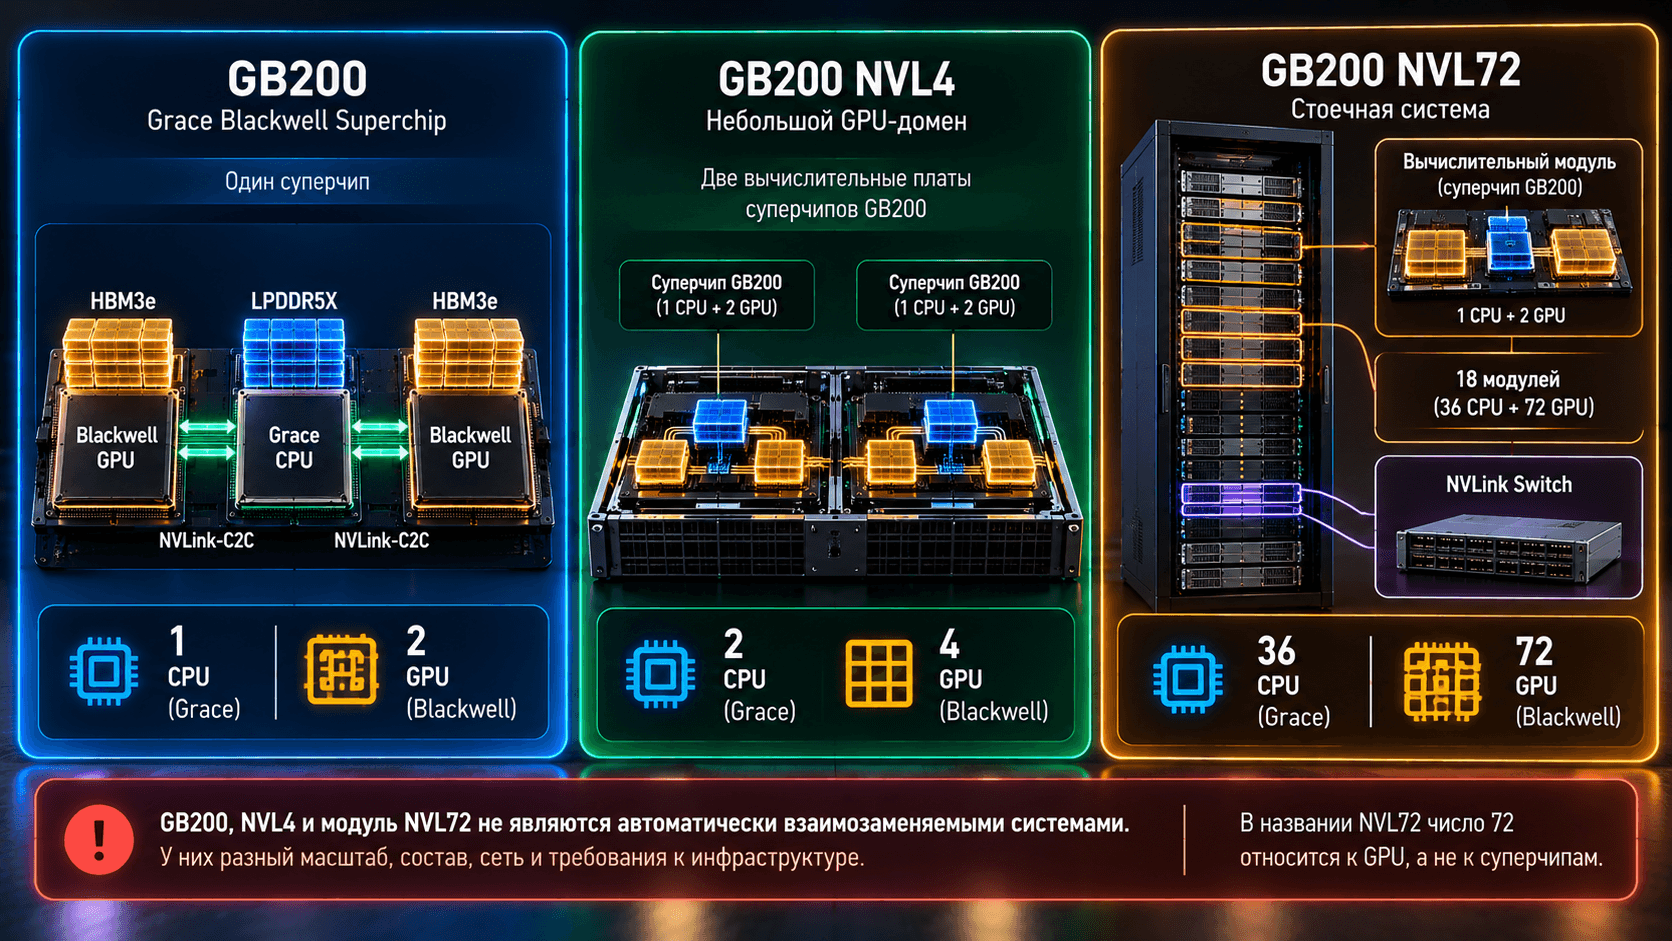
GB200 NVL4 | Система с двумя Grace CPU и четырьмя Blackwell GPU | Меньший GPU-домен, чем у NVL72 |
GB200 NVL72 | Стоечная архитектура с 36 Grace CPU и 72 Blackwell GPU | Число 72 относится к GPU, а не к суперчипам |
DGX GB200 | Готовая стоечная система NVIDIA на основе GB200 NVL72 | Отличается от восьмиускорительного DGX B200 |
Как устроен Grace Blackwell Superchip
Grace CPU: процессор на Arm
Grace в составе GB200 содержит 72 ядра Arm Neoverse V2. Рядом с процессором находится память LPDDR5X. Ее нельзя выбирать и устанавливать по тем же правилам, что съемные RDIMM в обычном двухсокетном сервере: параметры памяти задаются исполнением платформы.
Для пользователя важнее всего архитектура команд. Система требует программного окружения для Arm64. Наличие CUDA-кода не означает, что все остальные части приложения уже готовы к переносу с x86: нужно проверить CPU-библиотеки, расширения, агенты мониторинга и контейнеры.
Два GPU Blackwell: это два устройства, а не четыре
Каждый из рассматриваемых датацентровых Blackwell GPU имеет двухкристальную конструкцию. Два вычислительных кристалла соединены внутри одного GPU и представлены программной среде как единое устройство. У GB200 таких GPU два.
Поэтому физические кристаллы и GPU нельзя считать как одно и то же. Наличие двух кристаллов в каждом ускорителе не превращает GB200 в четырехускорительную систему. Для распределения модели, выделения памяти и настройки параллелизма важны логические устройства и их соединения.
Blackwell поддерживает низкоточные вычисления, в том числе FP4, и Transformer Engine второго поколения. Это дает дополнительные возможности ускорения нейросетей, но требует поддержки со стороны программных библиотек и проверки качества модели. Переключить произвольную задачу в FP4 без проверки точности нельзя.
NVLink-C2C: связь CPU и GPU
NVLink-C2C соединяет Grace с GPU и поддерживает когерентный доступ к памяти. Когерентность означает согласованность данных при работе CPU и GPU, но не одинаковую скорость доступа ко всем физическим областям памяти.
Для этой связи NVIDIA указывает 900 ГБ/с двунаправленной пропускной способности. Это характеристика интерфейса CPU–GPU, а не скорость диска, сети ЦОД или генерации текста. Состав суперчипа и роль соединения описаны в руководстве NVIDIA по архитектуре Grace Blackwell.
NVLink и NVSwitch: связь между ускорителями
Для обмена между GPU используются NVLink и, в соответствующих системах, коммутаторы NVLink Switch. Они решают другую задачу: позволяют ускорителям передавать данные друг другу при распределенных вычислениях.
У одной модели обмен может быть интенсивным, у другой GPU большую часть времени работают независимо. Поэтому наличие быстрого межGPU-соединения еще не доказывает преимущество на любой нагрузке. Основные различия разобраны в статье «NVLink и NVSwitch: как работают и зачем нужны в GPU-серверах».
Характеристики NVIDIA GB200: что относится к суперчипу, а что к стойке
В таблице приведены значения из опубликованной спецификации NVIDIA, проверенной 27 октября 2026 года. Для закупки их нужно сопоставлять с паспортом выбранной системы: разные документы и исполнения могут по-разному указывать объемы памяти и суммарные показатели.
Параметр | GB200 Grace Blackwell Superchip | GB200 NVL72 |
|---|---|---|
Grace CPU | 1 | 36 |
Blackwell GPU | 2 | 72 |
Ядра CPU | 72 Arm Neoverse V2 | 2 592 Arm Neoverse V2 |
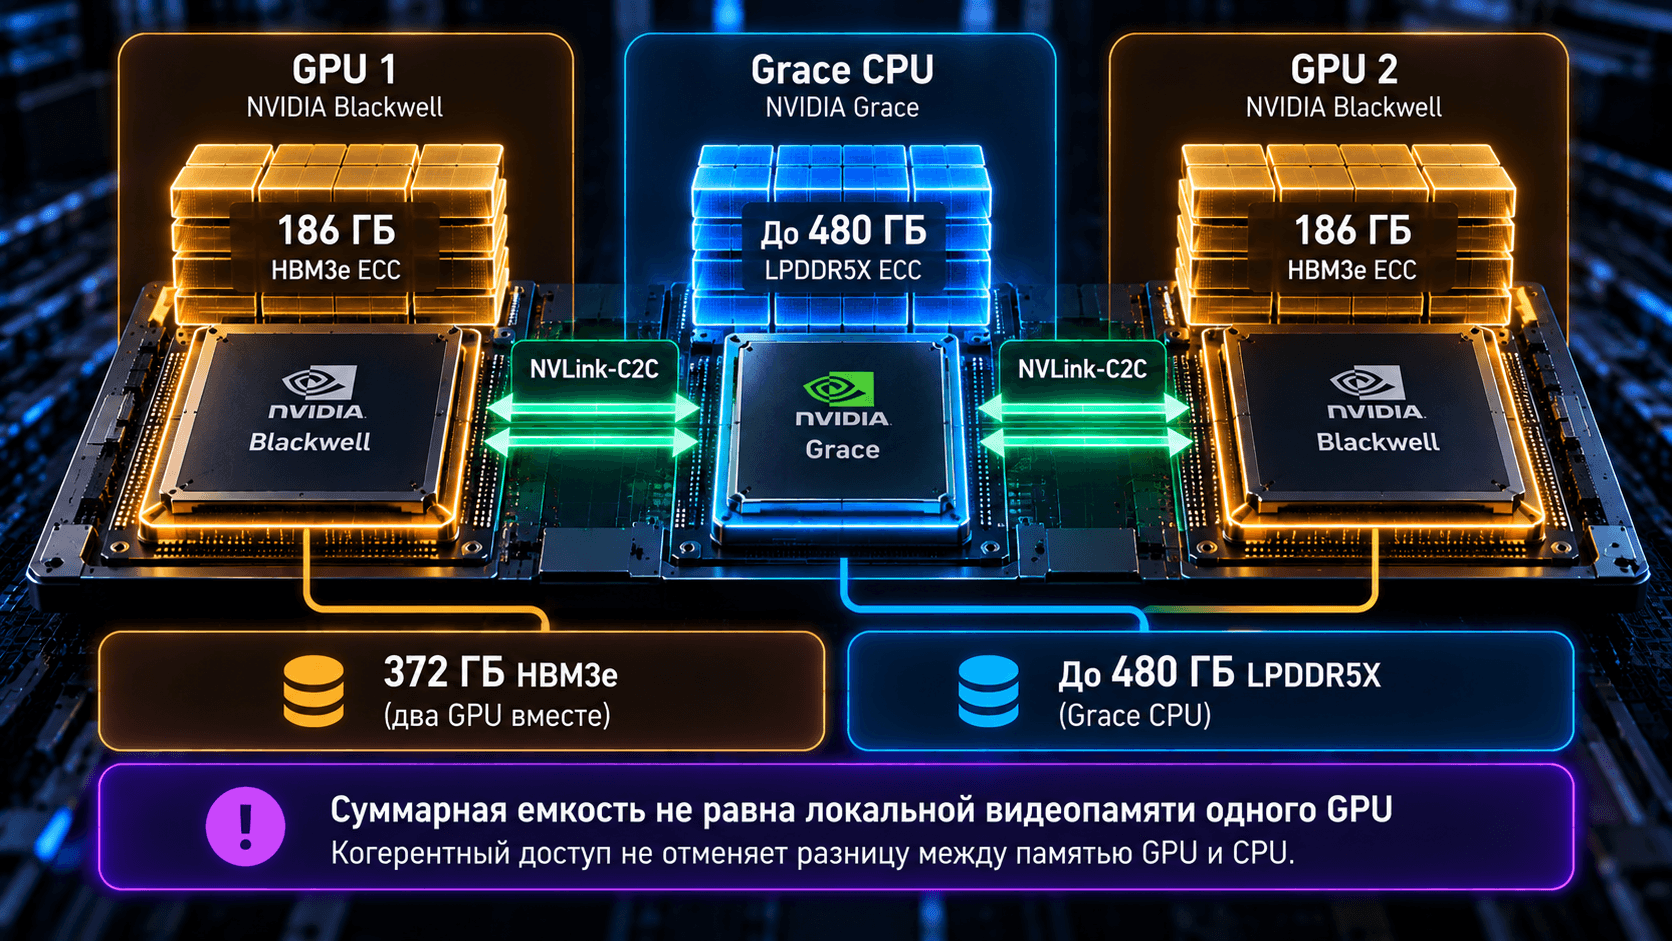
GPU-память | 372 ГБ HBM3e суммарно для двух GPU | 13,4 ТБ HBM3e суммарно |
Пропускная способность HBM3e | 16 ТБ/с суммарно для двух GPU | 576 ТБ/с суммарно |
Память CPU | До 480 ГБ LPDDR5X | Около 17 ТБ LPDDR5X суммарно |
Масштаб | Вычислительный компонент | Полная стоечная система |
Источник значений: спецификация GB200 и GB200 NVL72 на сайте NVIDIA. Суммарная пропускная способность памяти не означает, что один GPU или один процесс сможет читать любую часть памяти стойки с такой скоростью.
Почему HBM3e и LPDDR5X нельзя считать одной большой видеопамятью
В GB200 есть физически разные ресурсы: высокоскоростная HBM3e у GPU и системная LPDDR5X у Grace. Когерентный доступ облегчает совместную работу с данными, но не делает эти ресурсы взаимозаменяемыми по задержкам и пропускной способности.
Простой расчет: 372 ГБ HBM3e плюс до 480 ГБ LPDDR5X дают до 852 ГБ суммарной емкости. Но это не видеокарта с 852 ГБ локальной HBM. Если значительная часть рабочих данных находится в памяти CPU, результат зависит от размещения данных, обмена и того, как приложение использует эту память.
Рассмотрим условную плотную модель на 400 млрд параметров. Для весов BF16 нужно около 800 ГБ: 400 млрд параметров × 2 байта. Это расчет в десятичных гигабайтах, без служебных буферов, активаций и кеша внимания.
Из сравнения 800 и 852 ГБ нельзя заключить, что модель гарантированно запустится на одном GB200 с нужной скоростью. Весам недостаточно локальной HBM двух GPU, а доступ к LPDDR5X требует подходящего режима исполнения. Для инференса также нужен KV-cache, объем которого зависит от архитектуры модели, контекста и числа одновременных запросов.
Какие системы строят на NVIDIA GB200
GB200 NVL4: четыре GPU и два Grace CPU
GB200 NVL4 объединяет два суперчипа: четыре Blackwell GPU и два Grace CPU. GPU соединяются через NVLink-мост, а архитектура рассчитана на совместимые жидкостно-охлаждаемые серверные системы MGX.
NVL4 можно рассматривать для научных вычислений и AI-нагрузок, которым нужна связка Grace и Blackwell, но не требуется единый домен из 72 GPU. Меньшее число ускорителей не делает такую систему обычным офисным сервером: исполнение корпуса, питание и охлаждение все равно нужно проверить.
Еще одна ловушка: вычислительный модуль NVL72 тоже может содержать четыре GPU, но это не означает, что его можно использовать как готовую автономную NVL4. Отличаются соединения, окружение и состав необходимой инфраструктуры. Сравнивать следует законченные поддерживаемые решения.
GB200 NVL72: 36 суперчипов в одной стоечной архитектуре
GB200 NVL72 объединяет 36 Grace CPU и 72 Blackwell GPU в одном NVLink-домене. Это соответствует 36 суперчипам GB200, а не 72. Число в названии описывает масштаб GPU-соединения.
В конфигурации DGX GB200 используются 18 вычислительных модулей с двумя CPU и четырьмя GPU в каждом, а также девять модулей NVLink Switch. В стойке есть системы питания, управления и жидкостного охлаждения. Отдельный вычислительный модуль не заменяет всю эту инфраструктуру.
Такой масштаб полезен, когда одна задача должна эффективно работать на большом числе GPU. Но выражение «работает как один большой GPU» описывает идею объединения ресурсов, а не превращение 72 устройств в одну обычную видеокарту. Программная среда по-прежнему должна управлять распределением данных и вычислений.
DGX GB200 и партнерские системы
DGX GB200 представляет готовое решение NVIDIA. Партнерские системы используют архитектуру GB200, но отличаются конкретным исполнением, подсистемой хранения, охлаждением, сервисом и составом поставки. Общее название ускорителя не делает все предложения идентичными.
В каталоге Start Server представлена стоечная система Supermicro NVIDIA GB200 NVL72. При ее подборе нужно согласовать полный артикул, комплектность стойки, охлаждение, внешнюю сеть и работы по запуску.
DGX B200 стоит рассматривать отдельно. Это восьмиускорительная x86-система, а не уменьшенная комплектация DGX GB200 с тем же CPU. Например, конфигурация NVIDIA DGX B200 с восемью GPU относится к другому классу внедрения.
Для каких задач нужен GB200
Инференс крупных языковых моделей
При инференсе важны вместимость модели, скорость обработки входного контекста, задержка первого токена и скорость последующей генерации. Платформа GB200 интересна там, где требуется высокая пропускная способность сервиса и значительные ресурсы памяти.
Особенно внимательно рассчитывают параллельную работу. Одна сессия с коротким запросом и множество пользователей с длинными документами создают разные требования к KV-cache и планированию. Приемочный тест должен воспроизводить нужный режим, а не демонстрировать максимальную скорость на удобном коротком примере.
Обучение, дообучение и MoE
При распределенном обучении GPU обмениваются данными и синхронизируют вычисления. В MoE-моделях входные данные направляются к выбранным экспертным блокам сети. Если эксперты распределены между GPU, организация обмена может заметно влиять на скорость, а размер NVLink-домена становится одним из критериев выбора.
Но не каждому дообучению нужна NVL72. Если задача помещается на меньшем числе GPU, сначала нужно сравнить скорость, загрузку оборудования и стоимость завершенного эксперимента. Покупка большой стойки ради редких небольших запусков может оказаться экономически неоправданной.
Научные расчеты и обработка данных
GB200 подходит для рассмотрения в проектах, где приложения умеют использовать GPU и поддерживают выбранную Arm-платформу. Для HPC важны требуемая точность вычислений, обмен между процессами и характеристики конкретного пакета. Пиковая производительность FP4 ничего не говорит о скорости задачи FP64.
Для аналитики также нужно проверить весь путь данных: чтение, распаковку, преобразования, вычисления и сохранение результата. Если большую часть времени занимает неподдерживаемая CPU-операция или медленное чтение из хранилища, мощные GPU могут оставаться недогруженными.
Почему PFLOPS не превращаются напрямую в токены в секунду
PFLOPS показывает число операций с плавающей точкой в секунду при определенных условиях. Для сравнения нужно знать формат данных, использование Tensor Cores, режим плотных или разреженных вычислений и число GPU, к которому относится показатель.
Плотный и разреженный режимы не взаимозаменяемы. Высокое значение для поддерживаемой структурированной разреженности нельзя автоматически переносить на обычную плотную модель. Так же нельзя сравнивать показатель всей NVL72 с числом для одного GPU и делать вывод о превосходстве архитектуры.
Для сервиса полезнее измерять пропускную способность при установленной задержке и нужном качестве ответов. В протоколе фиксируют модель, формат весов, длину входа и выхода, число запросов и версии ПО. Для обучения сравнивают время выполнения одного и того же задания, а не только паспортный максимум ускорителей.
Программная совместимость: что проверить до закупки
Первый вопрос для GB200: готов ли ваш стек к Arm64? Проверка должна охватывать не только фреймворк машинного обучения. В проекте могут быть собственные расширения, закрытые библиотеки, плагины, средства защиты и вспомогательные сервисы, собранные только для x86-64.
Для выбранной системы проверьте:
поддержку ОС и архитектуры Arm64;
согласованные версии драйвера, CUDA и вычислительных библиотек;
поддержку Blackwell в движке инференса или обучения;
доступность нужного формата весов и режима параллелизма;
совместимость контейнеров и нативных расширений;
средства управления NVLink-доменом, мониторинга и обновления прошивок.
Контейнер не устраняет различие архитектур CPU. Образ, собранный только для x86-64, не становится нативным Arm64-окружением после переноса на Grace. При этом наличие подходящего образа еще не подтверждает, что выбранная модель и ее оптимизированные операции работают в нужном режиме.
Чем GB200 отличается от GB300
GB200 относится к Grace Blackwell, а GB300 — к Grace Blackwell Ultra. У датацентрового GB300 меняется поколение GPU и характеристики платформы. Эти изменения нужно оценивать по конкретной системе и рабочей нагрузке, а не по сходству названий.
Нельзя переносить характеристики GB300 NVL72 на GB200 или считать переход обычной заменой видеокарт. Для сравнения нужны полные конфигурации, версия ПО, поддерживаемые форматы вычислений и стоимость внедрения. Отдельно оценивают, дает ли новое поколение полезный выигрыш именно в вашем режиме.
Архитектура следующего поколения и различия его исполнений разобраны в статье «NVIDIA GB300: что такое Grace Blackwell Ultra и как устроен суперчип». Для выбора между поколениями стоит сравнивать стоимость заданного объема работы при одинаковых требованиях к качеству и задержкам.
Что требуется от площадки
Для GB200 NVL72 подготовка площадки является частью выбора системы. Проверяют доступную электрическую мощность, резервирование, отвод тепла, габариты, массу, маршрут доставки и доступ для обслуживания. Нельзя исходить из того, что свободного места под стойку достаточно.
Требования зависят от исполнения. Например, в документации Supermicro для SRS-GB200-NVL72-M1 указана рабочая мощность 125–135 кВт. Это показатель конкретной системы, а не универсальное значение для любого решения с GB200. Источник: паспорт Supermicro GB200 NVL72.
Жидкостное охлаждение CPU и GPU не означает полного отсутствия воздушного охлаждения. Часть компонентов продолжает отдавать тепло воздуху. Нужно согласовать контуры охлаждения, блок распределения охлаждающей жидкости CDU, контроль протечек и действия при отказе оборудования.
Даже если поставщик предлагает жидкость–воздух вместо подключения к водяному контуру здания, тепло не исчезает. Его должна принять и отвести инфраструктура помещения. Принципы и варианты подключения описаны в статье о жидкостном охлаждении серверов и ЦОД.
NVIDIA GB200: от чего зависит цена
Цена NVIDIA GB200 без указания системы не дает основы для бюджета. Предложение может относиться к вычислительному модулю, системе NVL4, полной NVL72 или проекту с охлаждением, сетью и пусконаладкой. Эти позиции нельзя сравнивать как одинаковый товар.
Запрос цены NVIDIA GB200 NVL72 стоит сопровождать перечнем того, что должно войти в поставку. Помимо вычислительной части уточняют NVLink-коммутацию, стойку, питание, CDU, внешние коммутаторы и кабели, накопители, лицензии, монтаж и поддержку. Часть инфраструктуры может уже быть на площадке, но ее совместимость нужно подтвердить.
Что сравнивать | Какой вопрос задать поставщику |
|---|---|
Вычислительная часть | Каковы точный артикул, число CPU/GPU и доступная память? |
Комплектность системы | Включены ли необходимые модули коммутации, управления и питания? |
Охлаждение | Какое исполнение CDU и какие работы требуются на площадке? |
Сеть и хранение | Входят ли внешняя фабрика, подключения к СХД и кабели? |
ПО | Какие версии, лицензии и работы по настройке предусмотрены? |
Сервис | Кто проводит диагностику, замену модулей и восстановление системы? |
Приемка | На какой нагрузке и по каким критериям подтверждается результат? |
Стоимость владения включает не только закупку, но и размещение, энергию, обслуживание, лицензии и работу команды. Для нерегулярной нагрузки полезно сравнить покупку с арендой подходящего ресурса. Методика есть в материале «Локальный GPU-сервер или облако: как посчитать TCO».
Как выбрать вариант системы и не переплатить за масштаб
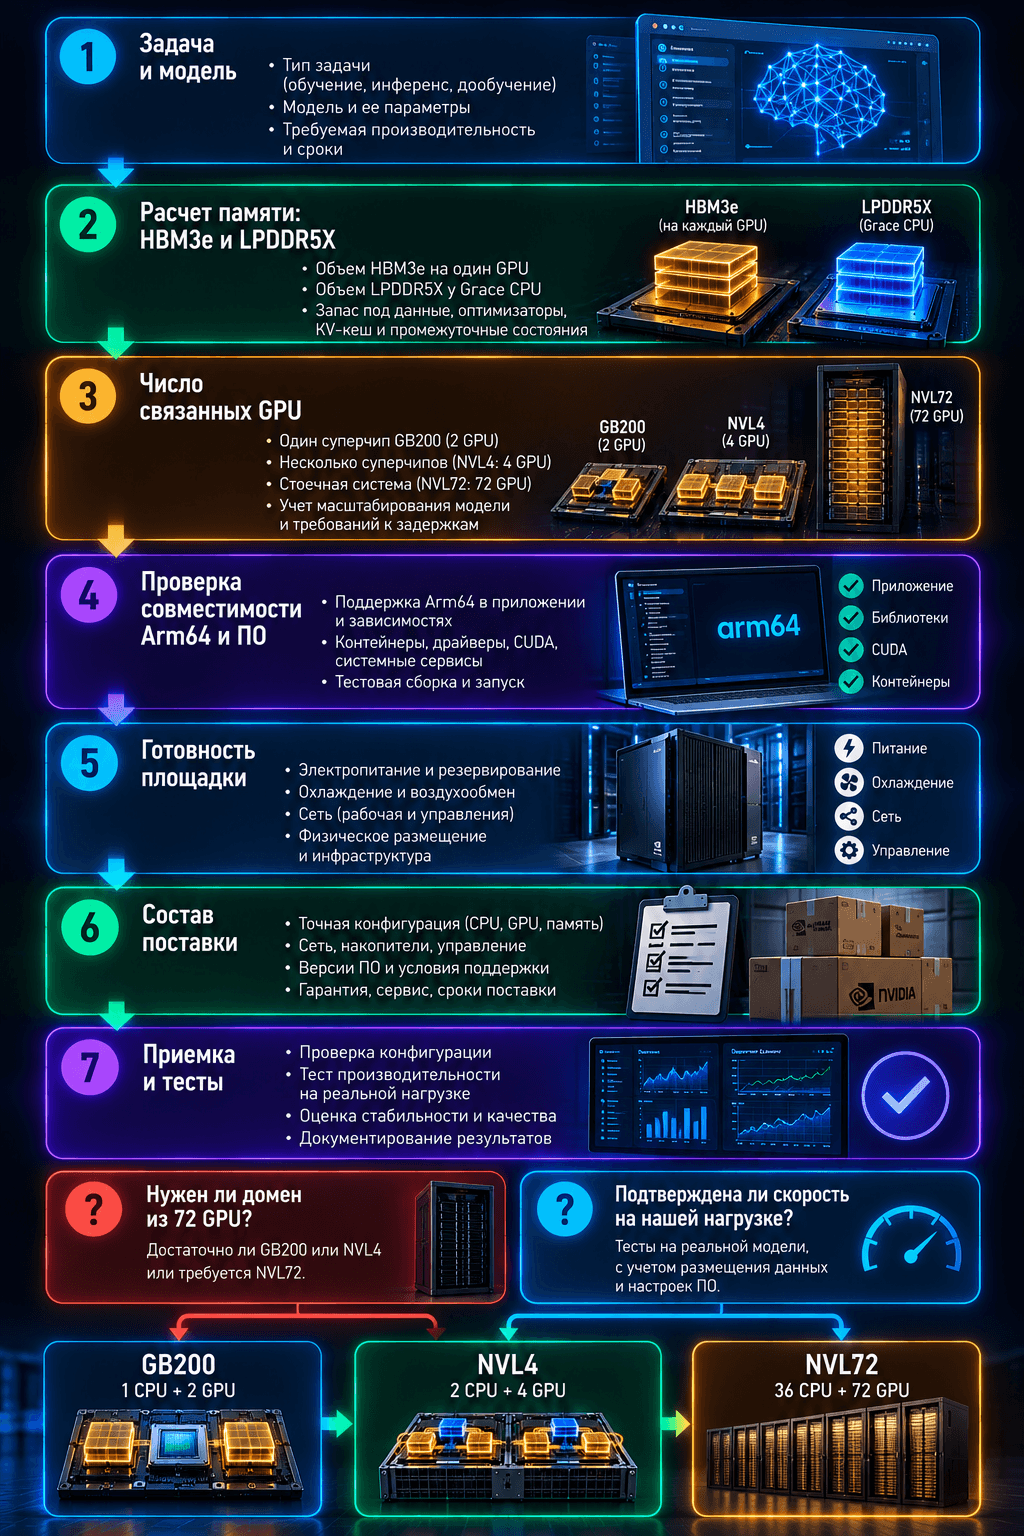
Начните с рабочей нагрузки, а не с самой крупной конфигурации. Требования должны позволять проверить, что оборудование решает задачу.
Зафиксируйте модели или приложения, формат вычислений и объем данных. Для LLM добавьте длину контекста, параллельность и ограничения по задержкам.
Рассчитайте память отдельно для GPU и CPU. Не считайте LPDDR5X эквивалентом локальной HBM.
Определите, сколько GPU должны работать над одной задачей и насколько интенсивен обмен между ними.
Проверьте Arm64 и программный стек. Критическая зависимость только для x86 может изменить выбор платформы.
Сравните поддерживаемые варианты: меньшую GPU-систему, GB200 NVL4, NVL72 или альтернативную архитектуру.
Подтвердите возможности площадки и полный состав поставки.
Проведите тест на согласованной нагрузке и сравните стоимость достижения нужного результата.
Если небольшая модель уверенно работает на одном или нескольких GPU, NVL72 не становится обязательной только из-за слова AI в проекте. Если задача требует большого связанного GPU-домена и высокая загрузка сохранится после внедрения, стоечная система заслуживает предметного расчета.
Частые вопросы о NVIDIA GB200
GB200 — это процессор или видеокарта?
Это суперчип, объединяющий Grace CPU и два Blackwell GPU. Он является частью специализированной платформы и не устанавливается в произвольный сервер как обычная PCIe-видеокарта.
Сколько GPU в одном GB200?
Два. Двухкристальная конструкция каждого Blackwell GPU не меняет этого количества. В полной GB200 NVL72 работают 72 GPU, то есть 36 суперчипов.
Чем GB200 отличается от B200?
B200 обозначает GPU, а GB200 — связку CPU и двух GPU. Серверы HGX/DGX B200 и системы GB200 отличаются архитектурой хоста, компоновкой и условиями внедрения. Сравнивать нужно законченные системы.
Сколько памяти у GB200?
В проверенной спецификации NVIDIA указаны 372 ГБ HBM3e суммарно для двух GPU и до 480 ГБ LPDDR5X у Grace. Это разные пулы памяти. Их сумму нельзя считать локальной видеопамятью одного ускорителя.
Чем GB200 NVL4 отличается от NVL72?
NVL4 объединяет четыре Blackwell GPU и два Grace CPU. NVL72 объединяет 72 GPU и 36 CPU в стоечной архитектуре. Различаются масштаб GPU-домена, устройство системы и инфраструктура, необходимая для работы.
Сколько стоит NVIDIA GB200 NVL72?
Стоимость рассчитывают по точной конфигурации и объему работ. Нужно знать, включены ли охлаждение, сеть, питание, хранение, ПО, монтаж и сопровождение. Цена отдельного модуля не отражает бюджет готовой NVL72.
Можно ли запустить на GB200 привычные приложения с x86-сервера?
Нужно проверить наличие Arm64-версий и совместимость зависимостей. CUDA-приложение может включать CPU-код и библиотеки, которые потребуют другой сборки. Перенос контейнера без проверки архитектуры не подтверждает совместимость.
Нужен ли GB200 NVL72 для корпоративного RAG или чат-бота?
Не обязательно. Требования определяются моделями, контекстом, количеством пользователей и задержками. Если задачу решает меньшая система, сравните ее стоимость и сложность эксплуатации с NVL72. Большая стойка оправдывается нагрузкой, а не названием сервиса.
Подбор системы на Grace Blackwell
Для расчета передайте список моделей или приложений, требования к скорости, предполагаемую загрузку и сведения о площадке. Если рассматриваете конкретную NVL72, приложите спецификацию: важно проверить границы поставки и готовность инфраструктуры до оформления заказа.
В каталоге AI-серверов Start Server можно выбрать исходное решение для обсуждения. Подбор GB200 должен завершаться согласованной конфигурацией, требованиями к площадке и программой проверки на вашей нагрузке.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


