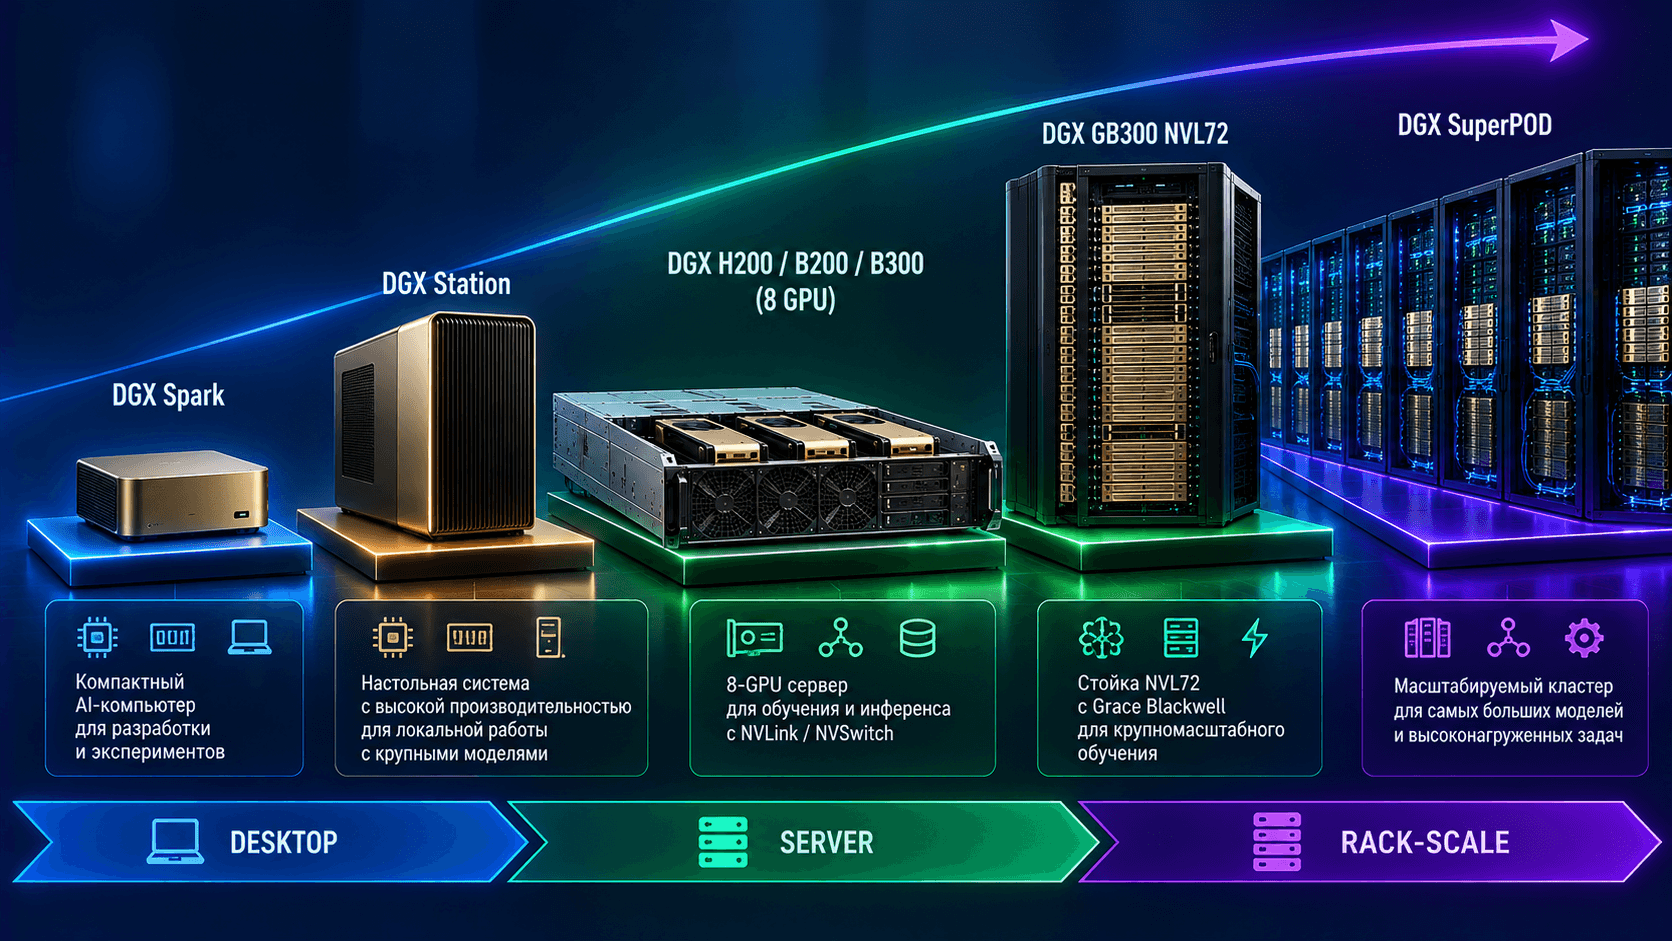
NVIDIA DGX представляет семейство готовых систем и программной платформы для разработки, обучения и инференса моделей искусственного интеллекта. Под одним названием находятся компактный DGX Spark, настольный DGX Station, 8-GPU серверы H200, B200 и B300, а также rack-scale решения Grace Blackwell.
DGX нельзя выбирать только по номеру GPU. Сначала определяют, помещается ли модель в память, нужен ли интенсивный обмен между ускорителями, какой software stack используется и готова ли площадка к питанию, охлаждению и сети. Компактная система и 8-GPU сервер решают задачи разного масштаба, хотя обе относятся к DGX.
Что входит в платформу NVIDIA DGX
DGX является не отдельной видеокартой и не одной конфигурацией сервера. NVIDIA поставляет согласованный аппаратный и программный стек:
GPU или Grace Blackwell Superchip;
CPU, system memory и local NVMe;
NVLink и NVSwitch в многопроцессорных системах;
высокоскоростные сетевые адаптеры;
BMC и средства telemetry для серверов;
DGX OS или подготовленную AI-среду;
driver, CUDA, containers и инструменты диагностики;
документацию жизненного цикла и поддержку для соответствующего продукта.
Чем DGX отличается от HGX и обычного GPU-сервера
DGX является готовой системой NVIDIA с фиксированной референсной архитектурой и программным контуром. HGX представляет compute platform или baseboard с GPU, NVLink и NVSwitch, на основе которой партнеры строят серверы со своими CPU, storage, network и шасси.
Обычный PCIe GPU-сервер дает больше свободы в выборе ускорителей и компонентов. Он может быть выгоднее для компактного inference, видеоаналитики или приложения, которому не нужен плотный NVSwitch fabric.
Вариант | Что получает заказчик | Сильная сторона | Что проверить |
|---|---|---|---|
NVIDIA DGX | готовая система NVIDIA | согласованный стек и topology | соответствие workload и площадке |
Сервер на NVIDIA HGX | система партнера на HGX baseboard | выбор производителя и конфигурации | точный BOM, support и integration |
PCIe GPU-сервер | гибкая платформа с картами | широкий выбор и модернизация | PCIe lanes, airflow, P2P и certification |
Детальное устройство партнерской 8-GPU платформы разобрано в статье NVIDIA HGX B300: характеристики платформы.
Линейка NVIDIA DGX
NVIDIA DGX Spark
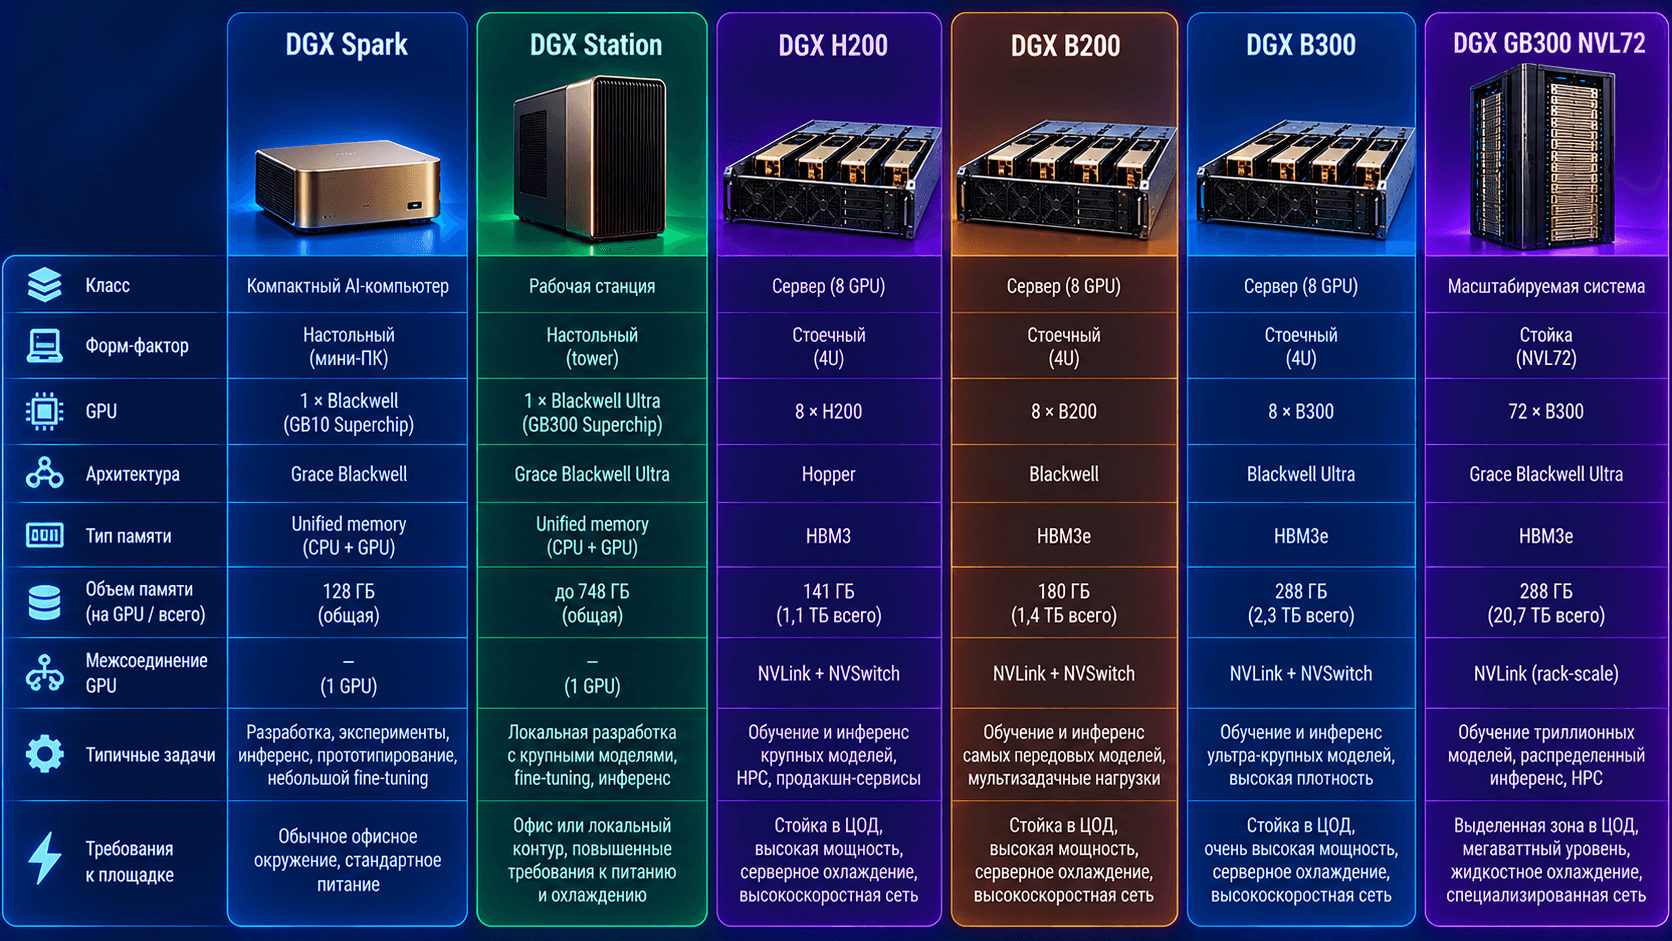
DGX Spark является компактным AI-компьютером на GB10 Grace Blackwell Superchip. Официальная конфигурация включает 20-ядерный Arm CPU, Blackwell GPU, 128 ГБ coherent unified LPDDR5x memory, 4 ТБ NVMe в основной коммерческой конфигурации, 10GbE и ConnectX-7.
Преимущество unified memory состоит в том, что CPU и GPU работают с общим адресным пространством без традиционного разделения на system RAM и VRAM. Это помогает разместить модель крупнее, чем на обычной desktop-карте с 24 или 32 ГБ. Пропускная способность и вычислительный профиль Spark при этом не равны серверному H200 или B300.
NVIDIA указывает до 1 PFLOP FP4 как теоретический показатель с использованием sparsity и возможность работать с моделями до 200 млрд параметров при подходящем формате. Размер параметров не является гарантией скорости или качества. Реальный предел зависит от precision, KV cache, context, runtime и активной памяти.
Spark подходит для локальной разработки, прототипирования, inference, экспериментов и части fine-tuning. До покупки проверяют ARM64-совместимость Python packages, containers и custom extensions. Товарная конфигурация представлена на странице NVIDIA DGX Spark GB10.
NVIDIA DGX Station
DGX Station относится к deskside-системам и строится на GB300 Grace Blackwell Ultra Desktop Superchip. NVIDIA указывает до 748 ГБ coherent memory и возможность локальной работы с моделями до 1 трлн параметров при поддерживаемом формате и software stack. Система занимает промежуточное положение между Spark и стоечным сервером.
Station подходит командам, которым нужна крупная coherent memory рядом с рабочим местом или в локальном shared-контуре. Нужно заранее проверить noise, питание, тепловой режим, ARM64 software и условия обслуживания. Возможность установить дополнительную RTX PRO Blackwell GPU не означает автоматического объединения всей памяти для любого приложения.
NVIDIA DGX H100 и DGX H200
DGX H100 и H200 являются 8-GPU стоечными системами поколения Hopper. DGX H200 содержит восемь H200 SXM по 141 ГБ, суммарно 1 128 ГБ HBM3e. Система использует NVSwitch fabric, два Intel Xeon 8480C, 2 ТБ system memory и высокоскоростные ConnectX-7 adapters.
H200 сохраняет архитектуру Hopper, но увеличивает memory capacity и bandwidth относительно основной версии H100 80 ГБ. Это важно для LLM, long context и memory-bound HPC. Если модель и batch помещаются в H100 и workload ограничен compute, выигрыш H200 нельзя выводить только из объема памяти.
Карточка NVIDIA DGX H200 с восемью GPU показывает состав доступной системы.
NVIDIA DGX B200
DGX B200 содержит восемь Blackwell B200 по 180 ГБ HBM3e, суммарно 1 440 ГБ. Официальный user guide указывает два Xeon 8570, 2 ТБ system memory с возможностью расширения, NVSwitch и локальный массив NVMe.
B200 подходит для AI training и inference, которым нужны Blackwell Tensor Cores, большой memory pool и быстрый обмен внутри 8-GPU узла. Перед переносом Hopper workload проверяют версии driver, CUDA, framework, libraries и container images.
NVIDIA DGX B300
DGX B300 использует восемь Blackwell Ultra B300 по 288 ГБ HBM3e, суммарно 2,3 ТБ. Система имеет два Xeon Platinum 6776P, 2 ТБ RAM по умолчанию, NVSwitch, восемь E1.S NVMe по 3,84 ТБ для cache и восемь ConnectX-8 по 800 Гбит/с для cluster network согласно руководству NVIDIA.
Это платформа для крупных training и inference workloads с длинным context, reasoning и высокой плотностью. Требования к электропитанию, стойке, сети и охлаждению должны проверяться по точной AC или DC конфигурации.
Полные характеристики раскрыты в статье NVIDIA DGX B300: устройство и выбор системы. Товарная карточка DGX B300 на восьми ускорителях нужна для проверки состава предложения.
DGX GB200 и GB300 NVL72
Grace Blackwell rack-scale системы строятся как единая NVLink fabric на уровне стойки. NVL72 объединяет 72 GPU в большом NVLink domain и включает compute trays, NVLink switch trays, power shelves и network components. Это не «сервер на 72 видеокарты» в обычном понимании.
Такая система требует проекта ЦОД: power, liquid cooling, rack integration, network fabric, storage, management и сервисные зоны. Архитектура подробно рассмотрена в материале NVIDIA GB300 NVL72: требования к ЦОД.
Сравнение классов DGX
Система | Класс | Память для AI workload | Типичный выбор |
|---|---|---|---|
DGX Spark | compact desktop | 128 ГБ unified memory | локальная разработка и прототипы |
DGX Station GB300 | deskside | до 748 ГБ coherent memory | крупные локальные модели и shared development |
DGX H200 | 8-GPU server | 1 128 ГБ HBM3e | Hopper LLM, training, inference и HPC |
DGX B200 | 8-GPU server | 1 440 ГБ HBM3e | Blackwell training и inference |
DGX B300 | 8-GPU server | 2,3 ТБ HBM3e | Blackwell Ultra, long context и плотные AI-workloads |
DGX GB300 NVL72 | rack-scale | память 72 GPU в NVLink domain | модели и parallelism уровня стойки |
DGX OS и программная платформа
DGX OS основана на Ubuntu и включает системные оптимизации, driver, диагностику и management tools для поддерживаемых DGX. Конкретная версия зависит от модели и жизненного цикла. Перед внедрением проверяют support matrix для системы, CUDA, framework и приложения.
Типовой программный контур включает:
NVIDIA driver и CUDA;
container runtime;
NGC containers и registries;
PyTorch или другой framework;
NCCL для collective communications;
DCGM и telemetry;
scheduler или Kubernetes для shared cluster;
backup, image management и security controls.
Предыдущие поколения и поддержка
DGX A100 остается в поддерживаемом списке DGX OS 7 и может быть полезен для существующего CUDA-workload. DGX-1 на V100 и DGX-2 относятся к legacy, а официальная документация указывает завершение их поддержки в августе 2025 года.
При покупке бывшей в употреблении системы проверяют serial numbers, support entitlement, firmware, состояние NVLink fabric, NVMe wear, ошибки памяти, историю перегрева и доступность запасных частей. Низкая цена без поддержки и приемочного теста может увеличить риск простоя.
Как выбрать конфигурацию NVIDIA DGX
1. Проверить размещение модели
Посчитайте веса в целевом precision, optimizer states для training, activations, KV cache, buffers и запас. Не складывайте память GPU как общий пул без поддержки model parallelism.
2. Определить режим работы
Training, fine-tuning, batch inference и online serving используют систему по-разному. Для serving важны TTFT, throughput и concurrency. Для training нужны time-to-train, checkpoint и масштабирование.
3. Проверить software compatibility
Spark и Station используют Arm CPU, а классические DGX H200, B200 и B300 построены как x86 systems. Проверьте архитектуру containers, custom operators, Python wheels, compilers и внешние agents.
4. Выбрать scale-up или scale-out
Если workload помещается в один GPU или один узел, большая fabric может быть не нужна. Multi-node cluster оправдан, когда модель и deadline используют распределенный parallelism с приемлемой efficiency.
5. Рассчитать сеть и storage
Collective operations, dataset reading и checkpoints имеют разные traffic patterns. Network fabric, parallel filesystem и local cache проектируют вместе с compute.
6. Проверить площадку
Для server и rack-scale классов нужны точные данные о rack dimensions, массе, power feeds, PDU, cooling, water loops, network ports и service clearances.
7. Провести benchmark
Тестируйте точную модель, context, batch, framework и dataset. Фиксируйте software versions, power mode, utilization и end-to-end metrics.
Как купить NVIDIA DGX без ошибки
Цена NVIDIA DGX зависит от модели, storage, network, support, software, логистики, монтажа и инфраструктуры. Публичная цифра без спецификации быстро вводит в заблуждение, поэтому в статье не приводится.
В запросе поставщику зафиксируйте:
Точную модель и part number.
GPU memory и system memory.
Local storage и RAID layout.
Network adapters, optics и cables.
AC или DC power option.
Rails, PDU и монтажный комплект.
DGX OS, software licenses и support term.
Срок и условия поставки.
Пусконаладку и обучение администраторов.
Программу приемочного теста.
DGX BasePOD и SuperPOD
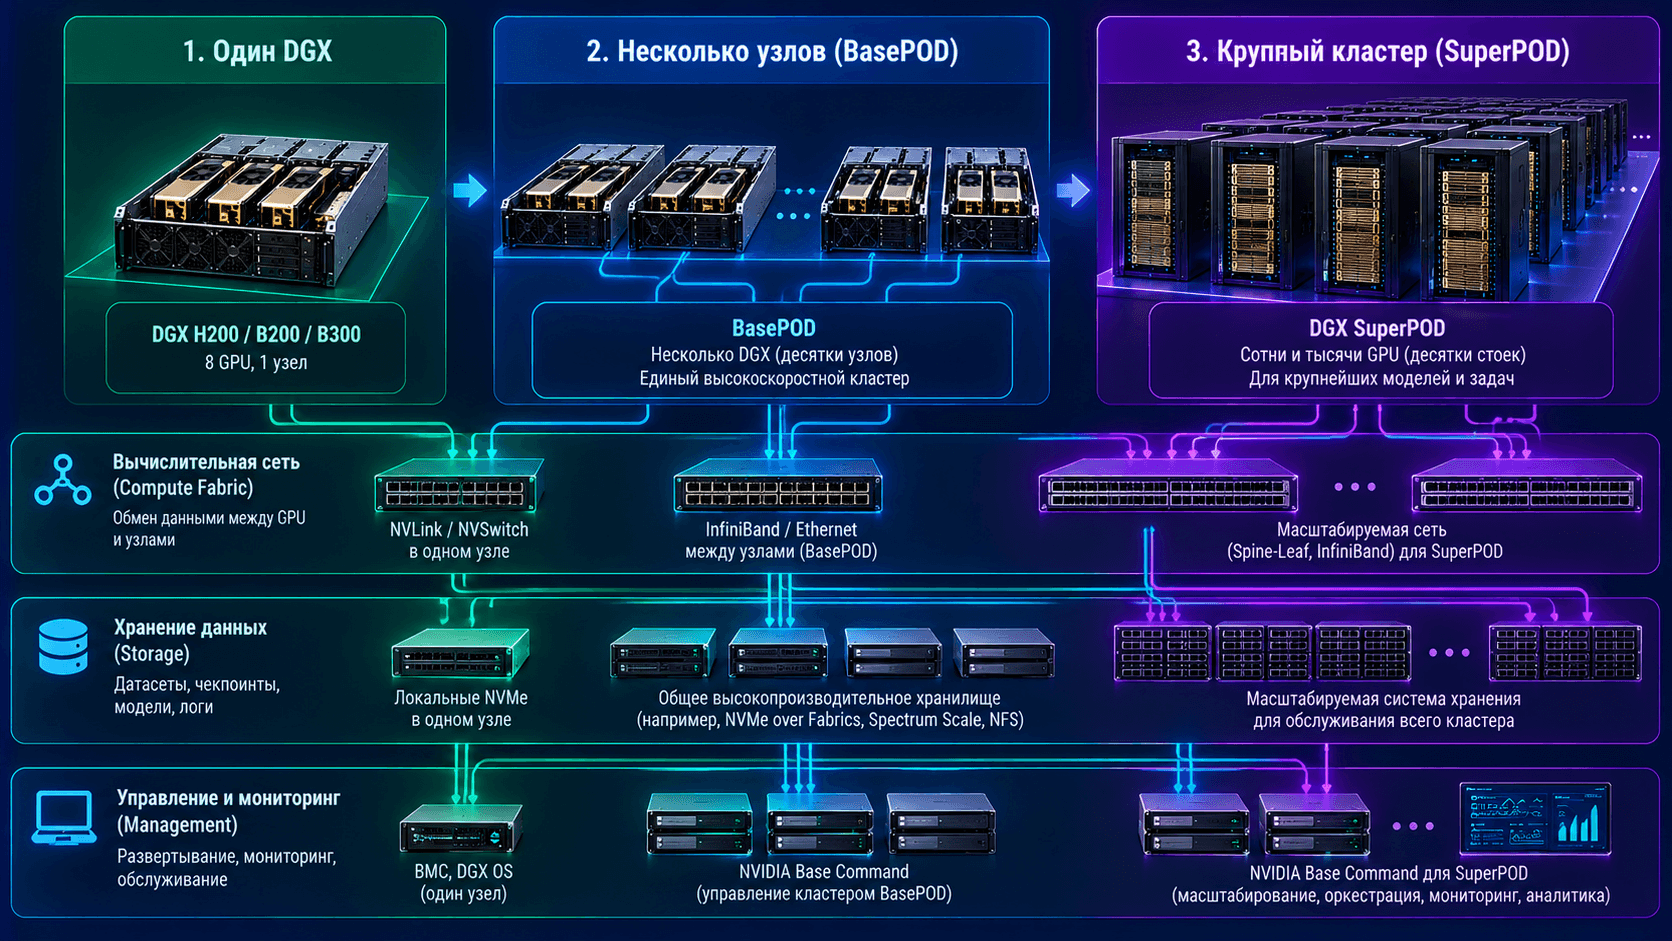
Один DGX является узлом. Для нескольких узлов NVIDIA публикует reference architectures BasePOD и SuperPOD с compute fabric, storage fabric, management network, scheduler и operational practices.
SuperPOD имеет смысл для постоянного масштаба, который использует distributed training или inference. Если загрузка нерегулярна, сначала сравнивают один узел, cluster и cloud по measured workload и TCO.
Типичные ошибки выбора
Сравнивать Spark и B300 только по памяти.
Считать DGX названием одной видеокарты.
Покупать максимальную систему без workload-test.
Игнорировать ARM64 в desktop-class DGX.
Рассматривать суммарную HBM как автоматически общую память.
Не учитывать NVLink и NVSwitch topology.
Планировать multi-node без измерения network efficiency.
Не проверить DGX OS и application support matrix.
Считать local NVMe полноценной общей СХД.
Не согласовать питание и охлаждение до поставки.
Сравнивать цену без support, optics и внедрения.
Покупать legacy DGX без health check и статуса поддержки.
FAQ
Что такое NVIDIA DGX?
Это семейство готовых AI-систем NVIDIA, которое включает аппаратную платформу, высокоскоростные межсоединения, сетевые компоненты и подготовленный программный стек.
NVIDIA DGX это сервер или суперкомпьютер?
Зависит от модели. Spark и Station являются desktop или deskside системами, H200, B200 и B300 являются стоечными 8-GPU серверами, а NVL72 и SuperPOD относятся к rack-scale и cluster-class решениям.
Что такое NVIDIA DGX Spark?
Это компактный AI-компьютер на GB10 Grace Blackwell с 128 ГБ unified memory и NVMe. Он предназначен для локальной разработки, inference и части fine-tuning workloads.
Можно ли считать DGX Spark сервером?
Он может предоставлять удаленные AI-сервисы, но по форм-фактору, питанию, охлаждению и обслуживанию отличается от rack server. Для production нужно отдельно оценить доступность и резервирование.
Чем DGX отличается от HGX?
DGX является готовой системой NVIDIA. HGX представляет compute platform для серверов партнеров и позволяет выбирать производителя и состав узла.
Сколько памяти у DGX H200?
Восемь H200 по 141 ГБ дают 1 128 ГБ суммарной HBM3e. Использование этой памяти зависит от parallelism приложения.
Сколько памяти у DGX B300?
Восемь B300 по 288 ГБ дают 2,3 ТБ суммарной HBM3e.
Что выбрать, DGX B200 или B300?
B300 дает больше памяти на GPU и относится к Blackwell Ultra. Выбор зависит от размера модели, software readiness, доступности, power и стоимости результата. Нужен тест целевого workload.
Можно ли купить NVIDIA DGX без отдельной СХД?
Для одного пилота local NVMe может быть достаточно. Для команды, нескольких узлов, большого корпуса и резервирования обычно требуется общая storage architecture.
От чего зависит цена NVIDIA DGX?
От модели, конфигурации, support, software, network, optics, логистики, монтажа и подготовки площадки. Сравнивать нужно полный BOM и внедрение.
Что передать для подбора DGX
Укажите модели и precision, training или inference, context, batch, concurrency, объем данных, deadline, software stack, число пользователей, требования к support и параметры площадки. Start Server поможет сравнить DGX с HGX или PCIe-системой, проверить спецификацию и подготовить внедрение. Передать вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


