NVIDIA DGX Station GB300 — настольная AI-система, в которой процессор Grace и ускоритель Blackwell Ultra связаны высокоскоростным интерфейсом NVLink-C2C. Она предназначена для локальной разработки, инференса и дообучения моделей, которым уже тесно в памяти обычной рабочей станции.
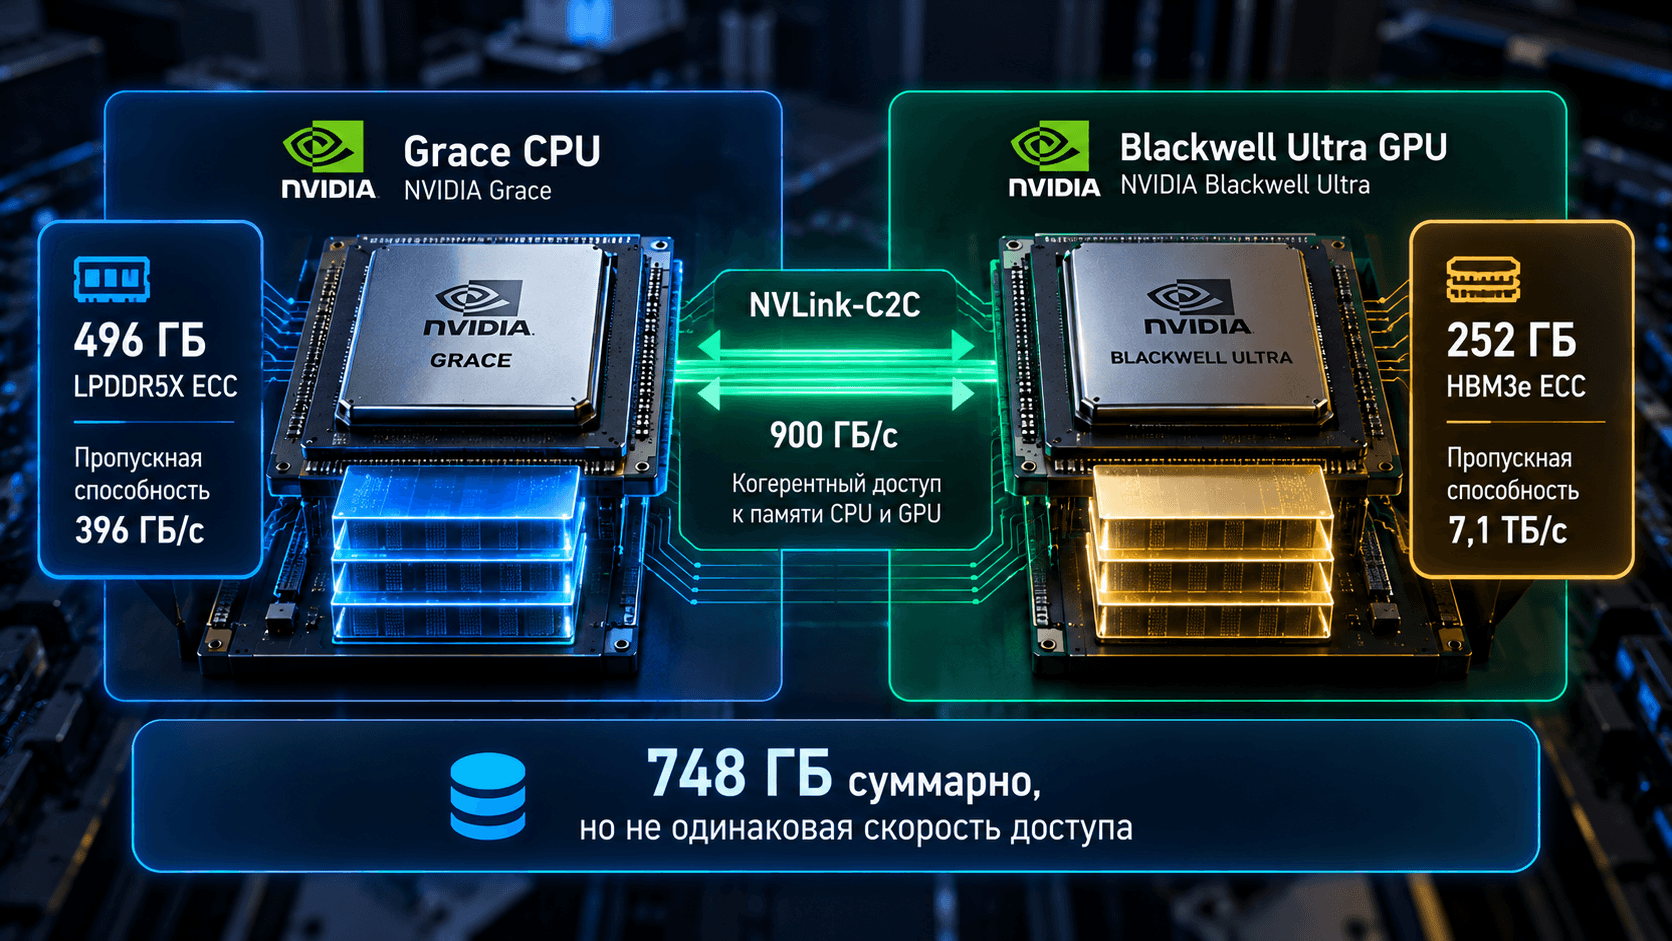
Главная особенность платформы — большой объем когерентной памяти CPU и GPU. В актуальной спецификации указаны 748 ГБ: 252 ГБ HBM3e у ускорителя и 496 ГБ LPDDR5X у процессора. Но это не 748 ГБ одинаково быстрой видеопамяти. Где размещены данные и как к ним обращается программа, напрямую влияет на скорость.
Что такое NVIDIA DGX Station GB300
В основе системы находится NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip. Слово Desktop здесь важно: речь идет о платформе для настольной AI-системы, а не о целой стойке GB300 NVL72 и не о сервере DGX B300.
Процессор Grace выполняет обычный программный код, подготовку данных и управление задачами. Blackwell Ultra ускоряет нейросетевые вычисления. Связь между ними позволяет работать с памятью обоих компонентов в когерентной архитектуре: аппаратная платформа поддерживает согласованность данных при предусмотренных способах доступа.
Это отличается от привычной схемы «x86-процессор плюс видеокарта PCIe». Совместимость CPU-приложений, размещение данных и обмен между компонентами здесь требуют отдельного внимания.
Название DGX Station использовалось и раньше. Например, DGX Station A100 была системой с процессором AMD и четырьмя ускорителями A100. У поколения GB300 другая архитектура, поэтому характеристики и инструкции старой станции к нему не подходят.
Характеристики DGX Station: на какие цифры ориентироваться
Ниже приведены параметры, опубликованные NVIDIA для платформы на момент подготовки статьи, 27 октября 2026 года. Конкретная система партнера может отличаться накопителями, дополнительной графикой, портами и условиями поддержки.
Параметр | Актуальная спецификация платформы |
|---|---|
Основной AI-ускоритель | Один NVIDIA Blackwell Ultra |
CPU | NVIDIA Grace, 72 ядра Arm Neoverse V2 |
Память GPU | 252 ГБ HBM3e ECC |
Пропускная способность памяти GPU | До 7,1 ТБ/с |
Память CPU | 496 ГБ LPDDR5X ECC |
Пропускная способность памяти CPU | До 396 ГБ/с |
Суммарная когерентная память | 748 ГБ |
Связь CPU и GPU | NVLink-C2C, заявленная пропускная способность 900 ГБ/с |
Высокоскоростная сеть | ConnectX-8, Ethernet до 800 Гбит/с, два порта по 400 Гбит/с |
Разделение GPU | До семи экземпляров MIG |
FP4 Tensor Core | До 20 PFLOPS с разреженностью, до 15 PFLOPS без нее |
Базовая программная среда | Ubuntu с NVIDIA AI Developer Tools |
Заявленная мощность системы | 1600 Вт; требования конкретного исполнения уточняются у производителя |
Почему в описаниях встречаются 784 ГБ вместо 748 ГБ
В первоначальном анонсе NVIDIA в марте 2025 года для DGX Station указывались 784 ГБ когерентной памяти. На актуальной странице и в документации платформы фигурируют 748 ГБ.
Это не пересчет гигабайтов в гибибайты. Меняется сама опубликованная конфигурация: актуальные 252 ГБ HBM3e плюс 496 ГБ LPDDR5X дают 748 ГБ.
Если коммерческое предложение обещает 784 ГБ, попросите подтвердить объемы каждого типа памяти и приложить спецификацию именно поставляемой модели. Старое число в карточке не доказывает, что покупатель получит такую комплектацию. Причину изменения объема нельзя устанавливать по одному совпадению цифр, например автоматически приписывать разницу ECC.
Как устроена память: HBM3e, LPDDR5X и NVLink-C2C
У DGX Station есть два физических типа оперативной памяти. HBM3e находится на стороне ускорителя и обеспечивает высокую пропускную способность для GPU. LPDDR5X связана с процессором Grace и дает дополнительную емкость.
NVLink-C2C соединяет CPU и GPU, но не превращает их память в однородный массив с одной скоростью. При обращении GPU к данным на стороне CPU результат зависит и от памяти CPU, и от пути доступа, и от характера обращений.
Что дает когерентность
Когерентная архитектура упрощает обмен данными: в поддерживаемых сценариях GPU может обращаться к системной памяти без привычного явного копирования каждого блока в отдельный буфер видеопамяти.
Но приложение должно использовать подходящий способ выделения памяти. Например, обычный вызов CUDA cudaMalloc выделяет память GPU. Сам по себе он не предоставляет процессу все 748 ГБ.
В руководстве NVIDIA по оптимизации DGX Station отдельно рассматриваются UMA и когерентный доступ. Практический вывод для покупателя прост: нужно проверить не только объемы памяти, но и то, как выбранный движок инференса размещает веса, кэш и служебные данные.
Почему модель может помещаться, но работать медленно
Предположим, веса не укладываются в HBM, но входят в суммарную память системы. Это открывает возможность локального запуска, но не гарантирует подходящую скорость.
Если существенная часть вычислений требует постоянного чтения данных из LPDDR5X, режим работы отличается от размещения всего активного набора в HBM. Точный эффект зависит от модели, движка и организации обращений. Универсального коэффициента замедления здесь нет.
Какие модели можно запускать: расчет вместо обещаний
Количество параметров — только отправная точка. Для первичной оценки памяти весов используют формулу:
Память весов в байтах ≈ число параметров × число бит на параметр ÷ 8.
Это нижняя оценка хранения весов. Она не учитывает метаданные квантования, дополнительные тензоры, KV-cache и память среды выполнения.
Условный размер модели | Веса при 16 битах | При 8 битах | При 4 битах |
|---|---|---|---|
70 млрд параметров | 140 ГБ | 70 ГБ | 35 ГБ |
235 млрд параметров | 470 ГБ | 235 ГБ | 117,5 ГБ |
1 трлн параметров | 2000 ГБ | 1000 ГБ | 500 ГБ |
Это арифметические примеры в десятичных гигабайтах, не результаты испытаний конкретных моделей на DGX Station. Реальные форматы занимают больше места, а отдельные тензоры могут храниться с другой точностью.
Для модели с 235 млрд параметров оценка 235 ГБ при восьмибитном хранении оставляет слишком мало номинального пространства HBM для уверенного вывода «все помещается». Нужно добавить остальные расходы и проверить доступную память в работающей системе.
Что означает поддержка моделей до триллиона параметров
NVIDIA заявляет возможность работы с моделями до 1 трлн параметров. Это не обещание запустить любую такую модель в любой точности с высокой скоростью.
Даже грубая оценка четырехбитных весов дает 500 ГБ, что больше объема HBM одного ускорителя. Значит, для подобного сценария существенны использование общей памяти, формат модели и поддержка со стороны программного стека.
Для MoE-моделей нужно различать полное число параметров и число активных параметров на токен. Меньшее количество активных параметров не означает, что все остальные веса можно безусловно исключить из расчета хранения.
KV-cache, контекст и параллельные запросы
KV-cache хранит промежуточные ключи и значения attention, чтобы модель не пересчитывала их заново при генерации каждого токена. Его объем зависит от архитектуры, длины контекста, числа одновременно обрабатываемых последовательностей и формата хранения.
Проверка одной короткой беседы не показывает, как система поведет себя при нескольких длинных диалогах. Для подбора нужны реальные ограничения: длина входа, длина ответа, число одновременных запросов и целевое время ожидания.
Подробная методика вынесена в материал о расчете VRAM для весов, KV-cache и контекста. Для DGX Station к этому расчету добавляется еще один вопрос: какие данные будут находиться в HBM, а какие в памяти Grace.
Производительность: почему 20 PFLOPS не равны токенам в секунду
Показатель до 20 PFLOPS относится к Tensor Core, формату FP4 и использованию разреженности. В спецификации NVIDIA для плотных вычислений FP4 отдельно приведено до 15 PFLOPS.
Эти числа нельзя напрямую сравнивать с производительностью другого GPU в FP32 или переносить на модель, которая использует иной формат. Четырехбитные веса тоже не означают автоматически, что приложение выполняет все вычисления в NVFP4 на заявленном пике.
Для LLM полезнее измерять следующие показатели:
время до первого токена, или TTFT;
скорость генерации для одной сессии;
суммарную пропускную способность при согласованной параллельности;
задержки при длинном контексте;
потребление HBM и системной памяти;
качество ответов после квантования.
Одновременно фиксируют версию модели, движок, драйвер, контейнер, длину запросов и настройки обработки. Без них число «токенов в секунду» невозможно корректно повторить или сравнить.
Инференс, дообучение и обучение с нуля
DGX Station подходит для локального запуска моделей, разработки AI-приложений, экспериментов с данными и определенных сценариев дообучения. Но эти задачи предъявляют разные требования к памяти.
При инференсе основными статьями расхода становятся веса, кэш и рабочие буферы. Во время обучения добавляются активации, градиенты и состояния оптимизатора. Поэтому возможность загрузить модель для генерации не доказывает возможность полностью обучать ее на той же системе.
Когда рассматривать LoRA и QLoRA
Если нужно адаптировать модель под терминологию или формат задачи, часто разумно начать с параметрически эффективного дообучения. LoRA обучает дополнительные низкоранговые параметры, а QLoRA сочетает такой подход с квантованной базовой моделью.
Это снижает часть требований, но не отменяет память для активаций и вычислительных буферов. Размер обучающей последовательности, пакет и реализация влияют на результат не меньше названия метода.
Перед закупкой полезно сопоставить конфигурацию с расчетом памяти для LoRA и QLoRA. В техническом задании следует указать именно метод дообучения, а не расплывчатое «обучение LLM».
Когда лучше сразу планировать серверный кластер
Для длительного распределенного обучения крупной модели или большого общего сервиса может потребоваться несколько GPU с другой топологией обмена и серверная инфраструктура.
Настольная Station не заменяет кластер только потому, что в ее названии есть GB300. Важны время выполнения задачи, допустимый простой, количество пользователей и план масштабирования.
Программная совместимость: Grace использует Arm
CPU Grace относится к Arm, а не к x86-64. Поэтому готовый бинарный файл или контейнер для обычного Intel- или AMD-сервера нельзя считать совместимым без проверки.
Особенно внимательно нужно относиться к Python-пакетам с нативными расширениями, собственным CUDA-операторам, закрытым библиотекам, средствам защиты и агентам мониторинга. Исходный Python-код может переноситься сравнительно просто, но его зависимости нередко содержат архитектурно-зависимые компоненты.
До заказа системы составьте короткую проверочную матрицу:
Компонент | Что подтвердить |
|---|---|
ОС и образ системы | Поддерживаемую поставщиком редакцию и порядок обновления |
Контейнеры | Наличие образа для Arm64 и совместимого GPU-стека |
Фреймворк и движок LLM | Поддержку используемой модели и формата квантования |
Нативные расширения | Готовую Arm64-сборку либо воспроизводимую сборку из исходников |
Корпоративное ПО | Поддержку архитектуры со стороны производителя |
Перенос в ЦОД | Совместимость модели, библиотек и форматов, а не только успешный запуск на Station |
Linux и DGX Station for Windows
Базовая среда, указанная для текущей DGX Station, — Ubuntu с NVIDIA AI Developer Tools. Не следует автоматически переносить на нее инструкции по DGX OS для другой системы или старого поколения.
DGX Station for Windows является отдельным объявленным направлением. На 27 октября 2026 года официальная страница NVIDIA по-прежнему указывает выпуск в четвертом квартале и предлагает подписаться на уведомление о доступности. В анонсированном сценарии предусмотрен доступ к Linux-инструментам через WSL.
Поэтому требование Windows нужно закреплять в спецификации поставки вместе с поддерживаемыми приложениями и драйверами. Нельзя покупать Linux-конфигурацию, исходя лишь из предположения, что любая редакция Windows установится и будет полностью поддерживаться.
Локальный запуск и работа без интернета
Локальное выполнение модели не равнозначно полностью автономной поставке. Сначала нужно получить веса, контейнеры, пакеты, обновления и необходимые лицензии.
Для закрытого контура заранее готовят проверенный комплект артефактов, фиксируют версии и отключают непредусмотренные внешние обращения. Отдельно проверяют, не обращается ли само приложение к облачному API, даже если основная LLM запущена локально.
Такой порядок подготовки описан в статье о локальной нейросети без интернета.
Нужна ли дополнительная RTX PRO
Основной Blackwell Ultra в GB300 предназначен для AI-вычислений. В поддерживаемую конфигурацию DGX Station можно добавить отдельную RTX PRO для графики, визуализации и симуляции.
Это не обязательный способ ускорить любую LLM. Если система работает как удаленный вычислительный узел без графических задач, дополнительную карту нужно обосновать конкретным приложением.
Память RTX PRO не становится автоматически частью когерентной памяти Grace–Blackwell. Дискретная карта подключается иначе, и программам приходится учитывать отдельный путь доступа и передачу данных.
Также нужно проверить, на каком GPU действительно запущено приложение. Порядок устройств в системе и внутри контейнера может отличаться. Ошибка выбора способна направить вычисления на дополнительную графическую карту вместо GB300.
Наличие разъема Mini DisplayPort на BMC не означает поддержку полноценной рабочей графики через него: в спецификации NVIDIA этот выход предназначен для управления системой.
Можно ли разделить DGX Station между сотрудниками
Да, платформа поддерживает многопользовательские сценарии. MIG позволяет разделить основной GPU на несколько изолированных экземпляров, максимум семь при поддерживаемой конфигурации.
Каждый экземпляр получает часть ресурсов, а не отдельный полный ускоритель. Семь MIG-экземпляров не означают семь пользователей, которым одновременно доступна вся память и производительность Station.
Не следует считать и 496 ГБ памяти CPU автоматически разделенными средствами MIG. Изоляцию процессов, права на данные, квоты и доступ к системным ресурсам проектируют отдельно.
Для команды нужно определить:
кто получает целый GPU, а кто отдельный MIG-профиль;
сколько памяти требуется каждому заданию;
как запускаются и останавливаются задачи;
кто может менять конфигурацию;
где хранятся данные и кто имеет к ним доступ;
как отслеживаются занятость ресурсов и сбои.
Сеть, накопители и объединение двух Station
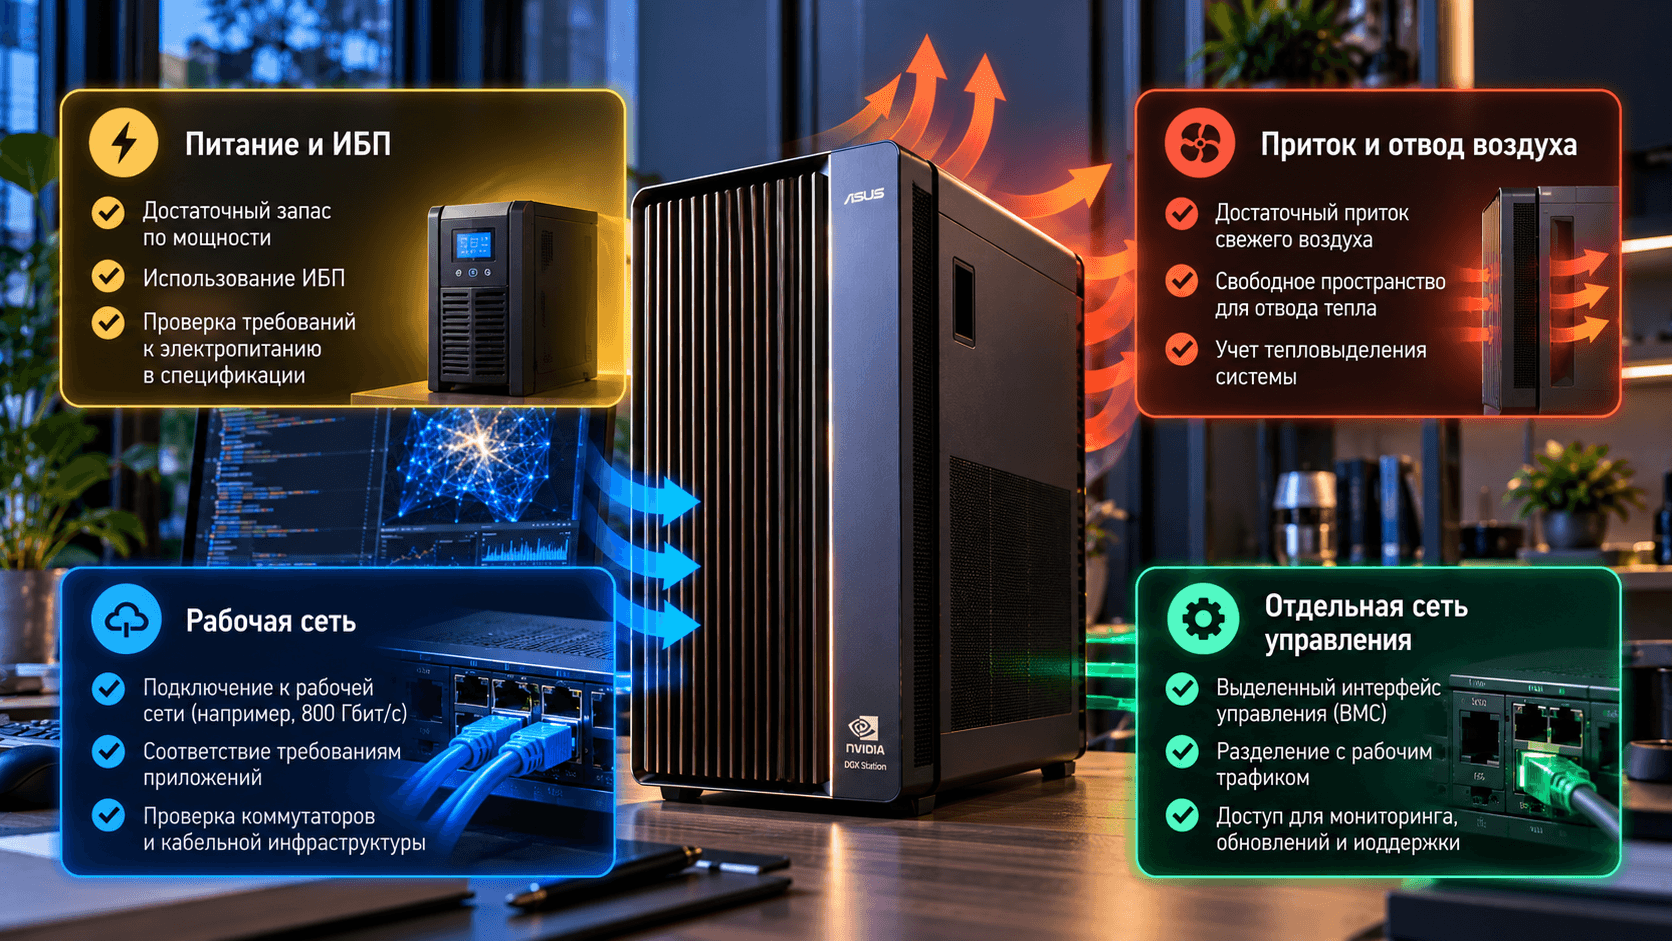
В референсной спецификации NVIDIA предусмотрен ConnectX-8 с двумя портами Ethernet по 400 Гбит/с. Число 800 Гбит/с описывает заявленный суммарный сетевой потенциал, а не скорость обычного подключения к офисному коммутатору.
Производитель предусматривает соединение двух DGX Station для масштабирования. Но подключение кабеля не объединяет память двух компьютеров в одну локальную HBM и не заставляет обычное приложение автоматически работать на двух узлах.
Нужны поддерживаемая схема соединения, подходящие кабели и сетевой стек, а также программа, способная распределять работу. Для одной модели цена межузлового обмена может быть существенной, для независимых задач двух узлов распределение окажется проще.
Внешнюю сеть нельзя путать с NVLink-C2C внутри суперчипа. Назначение разных межсоединений подробнее объясняется в статье о NVLink и NVSwitch.
Почему накопители проверяют по конкретному исполнению
Вместимость и скорость SSD влияют на загрузку моделей, подготовку данных и сохранение результатов. Нужен запас не только под одну копию весов, но и под контейнеры, разные версии моделей, датасеты и контрольные точки.
Документация партнеров может отличаться от общей таблицы платформы. Например, MSI для WS300T60L указывает два M.2 PCIe 5.0, связанных с CPU, и два M.2 PCIe 6.0, связанных с ConnectX-8. Нельзя превращать эту схему в универсальную спецификацию любой DGX Station.
В предложении должны быть артикулы и емкость установленных SSD, схема загрузочного хранения, свободные слоты и правила обслуживания. Резервное копирование результатов требуется отдельно: быстрый локальный NVMe не защищает от удаления или потери всей машины.
Питание, охлаждение и размещение
Заявленные для платформы 1600 Вт — серьезное требование для рабочего помещения. Это не обязательно постоянное потребление, но ориентироваться на типичный офисный компьютер при подготовке площадки нельзя.
В текущей таблице NVIDIA также указано требование к цепи питания 20 А. Применимость к конкретной поставке, напряжение, кабель, разъем и защиту линии нужно подтвердить по руководству OEM. Проект электропитания и выбор ИБП следует согласовать со специалистом, а не выводить из одного числа в обзоре.
Почти вся потребленная электроэнергия в итоге становится теплом. Поэтому заранее проверяют возможности кондиционирования, температуру воздуха на входе, свободное пространство и отсутствие рециркуляции горячего воздуха.
Жидкостное охлаждение не делает систему бесшумной
В партнерских исполнениях встречается замкнутое жидкостное охлаждение. Например, ASUS описывает такую схему для ExpertCenter Pro ET900N G3.
Это не означает, что требуется внешняя водяная магистраль, но и не гарантирует тишину. В корпусе остаются вентиляторы, насосы и другие источники шума. Запрашивать нужно условия измерения акустики и параметры именно выбранной комплектации, особенно при установке дополнительной RTX PRO.
DGX Station, DGX Spark или GPU-сервер: что выбрать
Одинаковый бренд не делает эти устройства взаимозаменяемыми. Сначала определяют ограничение задачи: память, скорость, совместимость, доступность или масштабирование.
Вариант | Когда включать в сравнение | Что проверить в первую очередь |
|---|---|---|
DGX Spark на GB10 | Компактная локальная разработка и задачи, которым достаточно его ресурсов | Доступную конфигурацию памяти, скорость своего приложения и Arm-совместимость |
DGX Station на GB300 | Крупные локальные модели, эксперименты с большим объемом памяти, общий ресурс небольшой команды | Размещение данных в HBM и LPDDR5X, программный стек, питание и охлаждение |
Рабочая станция с RTX PRO | AI сочетается с профессиональной графикой или нужен привычный набор приложений | VRAM каждой карты, архитектуру CPU и сертификацию ПО |
Стоечный GPU-сервер | Централизованная эксплуатация, несколько ускорителей, требования к инфраструктурному управлению | Топологию GPU, сеть, обслуживание и готовность площадки |
Облачные GPU | Эпизодические задачи, быстрый доступ к разным конфигурациям | Стоимость фактической загрузки, доступность ресурсов и правила работы с данными |
DGX Spark использует GB10, а не GB300. NVIDIA указывает для него конфигурации до 128 ГБ памяти; это другой класс системы. Выбирать Station только по принципу «старшая модель должна быть лучше» не нужно.
Когда DGX Station имеет смысл
Платформа заслуживает предметного теста, если команда регулярно работает с моделями, которым недостаточно памяти обычной рабочей станции, хочет удерживать данные локально и готова использовать поддерживаемый Arm-стек.
Дополнительный аргумент — необходимость экспериментировать на архитектуре Grace Blackwell до переноса задачи в более крупную инфраструктуру. При этом перенос все равно проверяют: похожая архитектура не гарантирует идентичную конфигурацию библиотек и окружения.
Когда лучше выбрать другой вариант
Station может оказаться лишней для редких небольших задач. Она также не лучший выбор по умолчанию, если критичное приложение доступно только для x86, требуется масштабное распределенное обучение или сервис должен переживать отказ одного узла без перерыва.
Покупка двух устройств сама по себе тоже не создает отказоустойчивый сервис. Переключение клиентов, копии данных и восстановление модели требуют отдельного проекта.
Как купить DGX Station GB300 и сравнить предложения
Сравнивать нужно полные партнерские системы, а не только надпись NVIDIA GB300. Общая архитектура не делает одинаковыми корпус, накопители, графическую конфигурацию, обслуживание и условия поставки.
В каталоге Start Server представлена MSI XpertStation WS300 на GB300. Для такого предложения нужно уточнить точное исполнение, состав SSD, программный образ и комплект подключения.
Другой вариант — ASUS ExpertCenter Pro ET900N G3. Производитель подтверждает использование архитектуры DGX Station. Сравнение с MSI должно опираться на фактическую комплектацию и испытание задачи, а не на разные рекламные формулировки.
Наличие карточки не подтверждает складской остаток, цену или срок отгрузки. Актуальное предложение должно содержать:
полное название и артикул системы;
отдельно объем HBM и памяти CPU;
установленные SSD и доступные возможности расширения;
наличие или отсутствие дополнительной RTX PRO;
ОС, драйверы и поддерживаемые приложения;
состав программных лицензий и срок поддержки;
требования к площадке;
условия приемки, гарантии и обслуживания.
Универсальную цену «за DGX Station» указывать некорректно. Стоимость меняется с комплектацией, поддержкой и работами. При сравнении с облаком нужно учитывать загрузку системы, администрирование, электричество, охлаждение и срок использования, а не только цену покупки.
Что проверить до оплаты: короткий план испытания
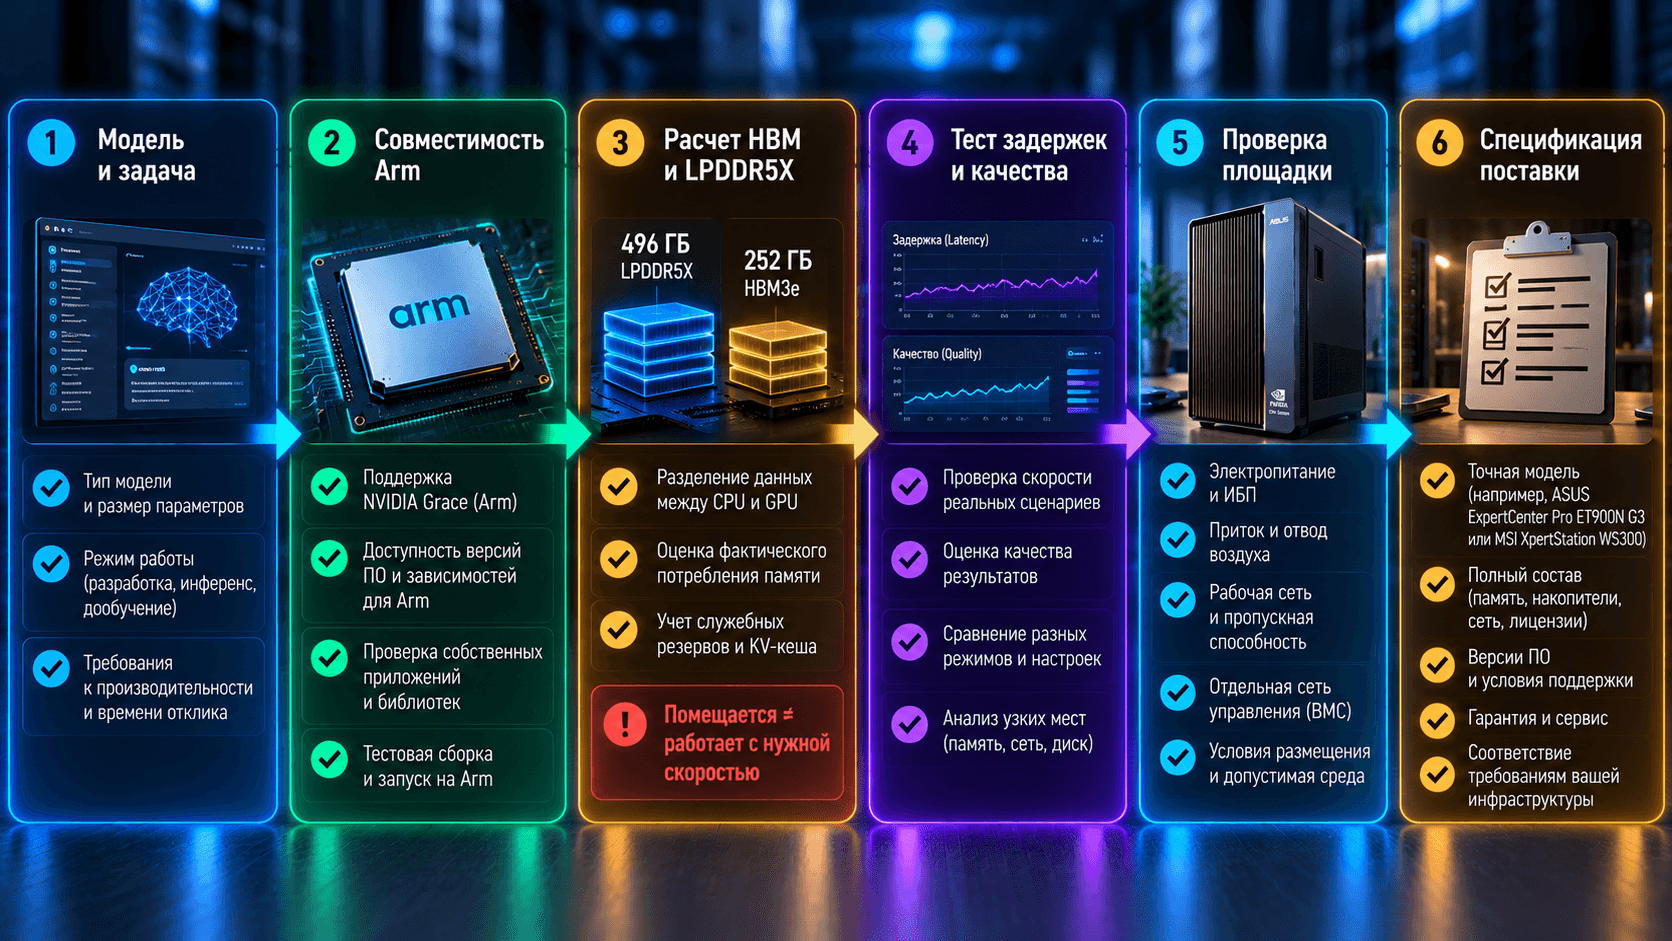
Испытание полезнее проводить на своей модели и типичных запросах. Тогда результат отвечает на вопрос о пригодности системы, а не просто подтверждает запуск демонстрации.
Зафиксировать окружение. Записать модель и ее версию, квантование, контейнер, драйвер и движок.
Проверить совместимость. Выполнить полный путь приложения, включая загрузку данных, нативные зависимости и сохранение результата.
Измерить память. Отдельно наблюдать HBM и память CPU, проверить реальное размещение данных и запас.
Воспроизвести нагрузку. Прогнать короткие и длинные запросы при целевой параллельности.
Оценить качество и задержки. Сравнить ответы после квантования, время до первого токена и скорость генерации.
Проверить длительную работу. Наблюдать температуры, частоты, потребление и ошибки в течение согласованного периода.
Проверить эксплуатацию. Подтвердить управление, обновление, резервное копирование и восстановление после перезапуска.
Частые вопросы о DGX Station GB300
DGX Station GB300 — это видеокарта или готовый компьютер?
Это AI-система на платформе с процессором Grace и ускорителем Blackwell Ultra. GB300 Desktop Superchip является ее вычислительной основой, а партнер поставляет конкретное исполнение компьютера.
Сколько памяти у актуальной DGX Station: 748 или 784 ГБ?
В текущей документации NVIDIA указаны 748 ГБ суммарно. Число 784 ГБ встречается в первоначальном анонсе. Для заказа следует подтвердить раздельные объемы HBM и LPDDR5X по актуальной спецификации поставки.
Можно ли считать всю память станции VRAM?
Нет. HBM ускорителя и LPDDR5X процессора различаются физически и по пропускной способности. Доступ приложения к суммарной памяти зависит от программной реализации, а не только от ее наличия.
Можно ли купить NVIDIA DGX Station для работы без интернета?
Локальная работа возможна, если подготовлены модели, зависимости и необходимые лицензии. До поставки нужно проверить весь сценарий в закрытом контуре и исключить обращения приложения к внешним сервисам.
Чем DGX Station GB300 отличается от DGX Station A100?
Это разные поколения с разными CPU, ускорителями и организацией памяти. У Station A100 была платформа AMD с четырьмя A100, у новой Station используется Grace Blackwell Ultra Desktop Superchip. Инструкции и характеристики не взаимозаменяемы.
Поддерживает ли DGX Station Windows?
NVIDIA объявила DGX Station for Windows. На дату подготовки статьи официальная страница еще указывает план выпуска в четвертом квартале 2026 года. Поддержку Windows и нужного приложения следует подтвердить для конкретной поставки.
Можно ли обучать на ней модель с триллионом параметров?
Заявленная возможность работы с такой моделью не означает ее полное обучение с нуля. Нужно отдельно рассчитывать веса, активации, градиенты, состояния оптимизатора и время вычислений. Возможность инференса не переносится на обучение автоматически.
Можно ли использовать Station для нескольких сотрудников?
Да, но ресурсы требуется распределить. MIG помогает разделять GPU, а учетные записи, доступ к данным, ограничения системной памяти и запуск задач настраиваются отдельно.
Как подготовить запрос на подбор
Для подбора DGX Station передайте специалистам Start Server название модели, формат весов, задачу, длину контекста и число одновременных пользователей. Укажите требования к скорости, возможность использования Arm, необходимость Windows или графической RTX PRO и условия размещения.
Эти данные помогут сравнить Station с другими AI-серверами, согласовать испытание и подготовить полную спецификацию.
Главный критерий выбора — не максимальная цифра памяти, а способность всей системы выполнять вашу задачу с нужной скоростью, качеством и предсказуемыми условиями эксплуатации.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


