Техническое задание на GPU-сервер часто начинают со списка комплектующих:
4× GPU, два CPU, 512 ГБ RAM, NVMe и два сетевых адаптера.
Проблема такого подхода в том, что из документа непонятно, почему нужны именно эти компоненты, что поставщик имеет право заменить и как после поставки проверить соответствие исходной задаче.
Обратная крайность выглядит так:
нужен мощный сервер для искусственного интеллекта.
Такое ТЗ тоже бесполезно: несколько поставщиков могут предложить совершенно разные системы, формально подходящие под описание.
Рабочая последовательность другая:
Хорошее ТЗ — не максимальный список SKU. Это документ, который сохраняет связь между AI-задачей и тем, что заказчик в итоге получит.
Почему ТЗ нельзя начинать с готового BOM
BOM — перечень конкретных компонентов поставляемой системы.
Он нужен для коммерческого предложения и приёмки, но в начале проекта важнее другое:
что сервер должен делать?
Если сначала скопировать чужой BOM, можно случайно зафиксировать:
неподходящий GPU;
лишний interconnect;
недостаточную RAM;
ненужную сеть;
chassis, которое не подходит площадке.
При этом поставщик сможет формально выполнить спецификацию, а исходная задача останется нерешённой.
Поэтому сначала фиксируется workload.
Что поставщик должен понять из ТЗ
После чтения документа должно быть понятно:
для какой задачи приобретается система;
какие требования обязательны;
где допускаются альтернативы;
что является только reference configuration;
какие ограничения есть у площадки;
что должно войти в комплект поставки;
чем поставщик подтверждает соответствие;
как оборудование будет приниматься.
Если эти вопросы не закрыты, предложения поставщиков становятся трудно сопоставимыми.
Первый блок — назначение системы
Начните с роли сервера.
Поле | Значение |
Проект | |
Назначение системы | |
Основной workload | |
Дополнительные workloads | |
Срок запуска | |
Горизонт эксплуатации | |
Ожидаемый рост нагрузки |
Например, вместо:
сервер для AI
лучше указать:
сервер для production-инференса корпоративной LLM с заданным профилем concurrency и latency.
Второй блок — workload
Для AI-проекта фиксируют параметры, которые действительно влияют на sizing.
Для LLM-инференса
Поле | Значение |
Model/version | |
Precision/quantization | |
Context | |
Input-token profile | |
Output-token profile | |
Concurrency | |
Streaming | |
Performance objective |
Для training/fine-tuning
Поле | Значение |
Model/version | |
Precision | |
Optimizer | |
Sequence length | |
Global batch | |
Microbatch | |
Parallelism | |
Time-to-train objective |
Не обязательно заполнять все поля из обеих таблиц. ТЗ должно описывать реальную задачу, а не универсальный AI-чек-лист.
Третий блок — software stack
Для GPU-сервера hardware и software связаны.
Полезно зафиксировать:
операционную систему;
framework;
CUDA или ROCm;
driver requirements;
container runtime;
serving или training stack;
critical libraries.
Но exact version стоит фиксировать только там, где она действительно является dependency.
Requirement и reference configuration — разные вещи
Это одна из главных границ хорошего ТЗ.
Requirement
Что системе действительно необходимо.
Например:
GPU configuration должна иметь не менее требуемого объёма памяти и поддерживать software stack проекта.
Reference configuration
Один из вариантов реализации.
Например:
Предварительный sizing выполнялся на GPU X.
Это не обязательно означает:
допускается только GPU X.
Если конкретный SKU действительно обязателен, это нужно написать прямо.
Когда имеет смысл требовать exact GPU SKU
Жёсткий SKU оправдан, если есть техническая причина:
application уже квалифицирован именно на нём;
есть software dependency;
нужна конкретная сертификация;
требуется определённый interconnect или form factor;
парк стандартизирован на конкретную платформу;
performance requirement подтверждён только для этого варианта.
Во всех остальных случаях полезно сначала проверить, можно ли сформулировать functional requirement.
Почему одинаковая VRAM не делает две GPU эквивалентными
GPU одинакового объёма памяти могут различаться по:
архитектуре;
поддерживаемым datatype;
quantization;
software support;
interconnect;
form factor;
энергопотреблению;
производительности нужного workload.
Поэтому:
Как правильно писать «или эквивалент»
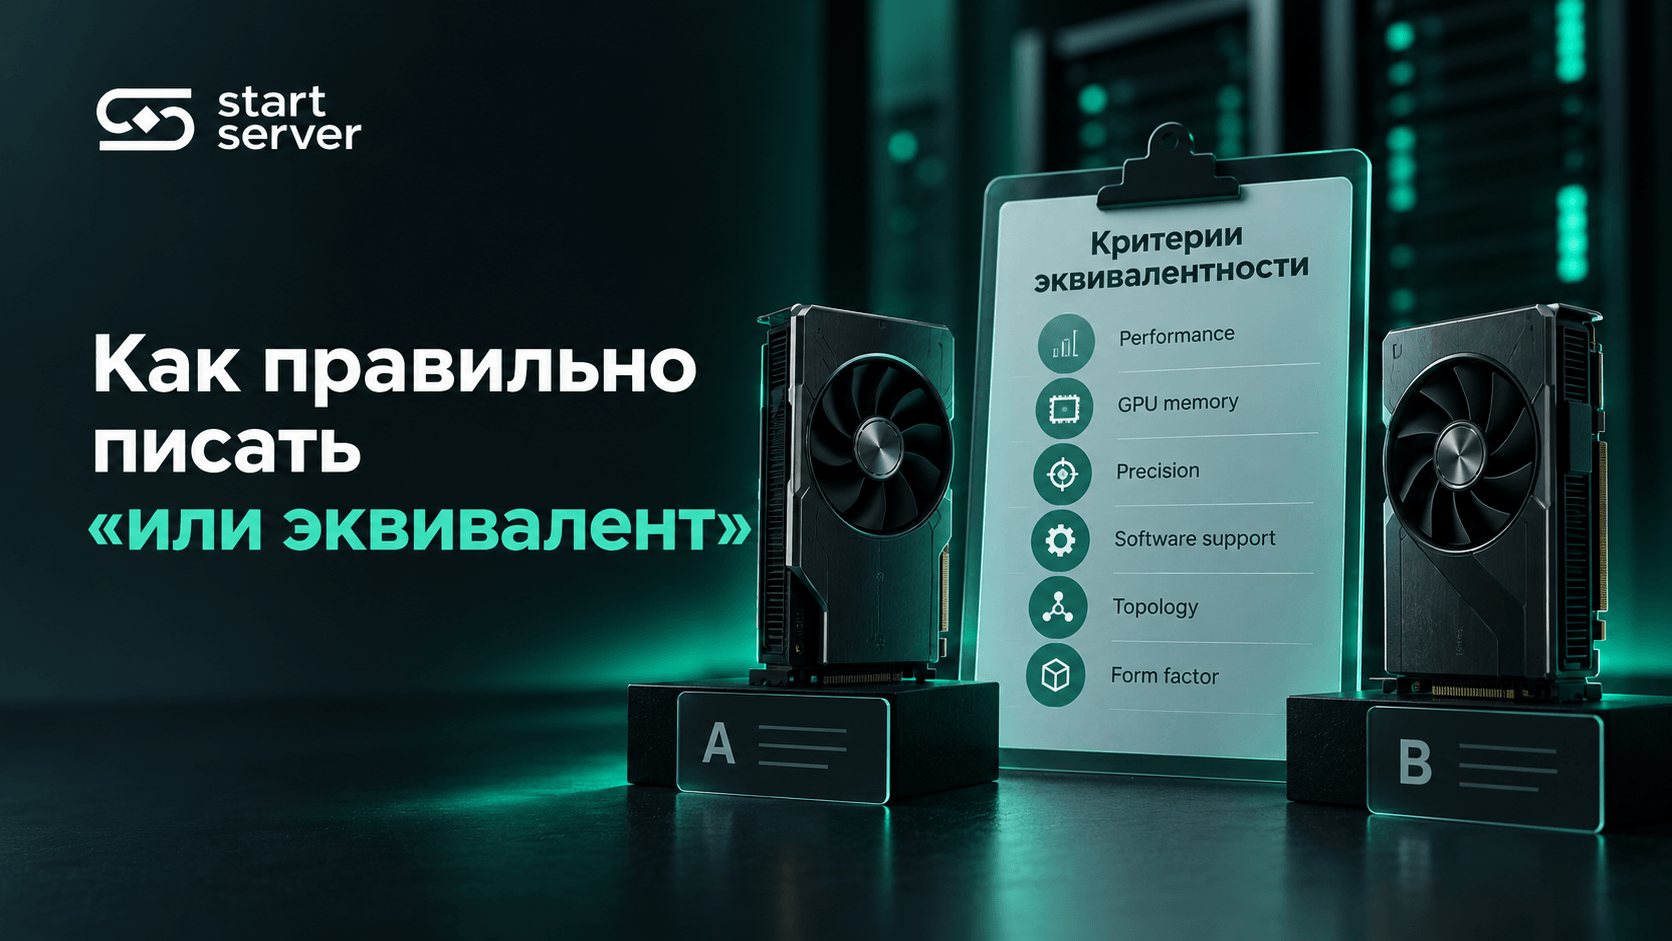
Если эквиваленты разрешены, заранее определите критерии.
Например:
Критерий | Требование |
GPU memory | Не ниже согласованного значения |
Software support | Совместимость с required stack |
Precision/quantization | Поддержка нужных режимов |
Topology/interconnect | Согласно workload |
Form factor | Совместимость с chassis |
Power/cooling | В пределах площадки |
Performance | Согласно agreed benchmark, если требуется |
Для предложенного эквивалента полезно также потребовать evidence, подтверждающее соответствие каждому критичному критерию.
GPU topology — отдельное требование
Фраза:
4 GPU
ещё не описывает multi-GPU platform.
В зависимости от workload могут быть важны:
PCIe generation;
link width;
GPU placement;
GPU-GPU paths;
CPU/root-complex affinity;
GPU-NIC locality;
NVLink/NVSwitch.
Но topology requirement должен появляться только тогда, когда он действительно влияет на задачу.
Не нужно требовать NVLink просто потому, что сервер относится к AI.
CPU: не используйте универсальное число cores на GPU
CPU может участвовать в:
preprocessing;
tokenization;
dataloader;
storage path;
networking;
virtualization;
ancillary services.
Поэтому универсального соотношения:
N CPU cores на GPU
нет.
RAM нельзя считать простым коэффициентом от VRAM
Так же не существует универсального:
RAM = 2× total VRAM.
Host memory может потребляться:
application;
staging;
preprocessing;
cache;
checkpointing;
virtualization.
Требование должно следовать из workload.
Installed, supported maximum и available expansion — три разные вещи
Это особенно важно при сравнении предложений.
Installed
Что физически поставляется сейчас.
Supported maximum
Что платформа теоретически поддерживает.
Available expansion
Какой реальный ресурс для upgrade остаётся в конкретной поставляемой конфигурации.
Например:
Ресурс | Installed | Supported maximum | Available expansion |
GPU | |||
RAM | |||
Drives | |||
NIC | |||
PCIe slots |
Платформа может поддерживать восемь GPU, но конкретный BOM не обязательно позволяет просто добавить ещё четыре без других изменений.
Supported и included — тоже разные вещи
Сервер может поддерживать определённый:
NIC;
transceiver;
cable;
storage adapter;
software license.
Но это не означает, что он входит в поставку.
Поэтому:
Supported ≠ Included.
Отдельно фиксируйте фактический delivery scope.
Как оформить storage requirements
Полезно разделить три роли.
System storage
Для ОС и software.
Local working storage
Для models, datasets, cache и temporary artifacts.
Shared-storage connectivity
Если workload использует внешнюю СХД.
Не нужно автоматически требовать NVMe для любого AI-сервера.
Если storage performance является requirement, она должна быть измеримой и происходить из workload sizing.
Как оформить сеть
Разделите network requirements по назначению:
management;
application traffic;
storage;
inter-node communication.
Только затем имеет смысл фиксировать:
port count;
link speed;
adapter class;
RDMA;
protocol;
optics;
cables.
Формулировка:
AI требует 400G
без архитектурной причины слишком общая.
Комплект поставки нужно описать отдельно
Полезная таблица:
Компонент | Требуется в поставке |
Server | |
Rails | |
Power cords | |
NIC | |
Transceivers | |
Network cables | |
Storage adapters | |
Licenses | |
Documentation |
Power — отдельный блок ТЗ
GPU-сервер может подходить по compute и не подходить существующей площадке.
Нужно зафиксировать:
допустимую мощность;
входные параметры питания;
connectors;
число вводов;
требования к PSU redundancy.
При этом:
redundant PSU ≠ отказоустойчивость всей системы.
Резервирование блока питания защищает только соответствующий subsystem и не заменяет HA архитектуры.
Cooling и ограничения площадки
До выбора chassis полезно знать:
Поле | Значение |
Rack U | |
Максимальная глубина | |
Максимальная масса | |
Доступная мощность | |
Cooling constraints | |
Airflow constraints | |
Температурные ограничения |
Для размещения вне специализированного ЦОД могут быть важны также шум и особенности помещения.
Remote management лучше описывать через функции
Вместо конкретной марки BMC можно потребовать:
out-of-band management;
remote power control;
remote console;
hardware inventory;
telemetry;
event logs;
firmware operations;
access control.
Redfish: требуйте нужные функции, а не только название протокола
Redfish может использоваться как удобный стандартный интерфейс management/inventory.
Но формулировка:
требуется Redfish
слишком общая, если проекту нужны конкретные функции.
Лучше указать, например:
component inventory;
firmware inventory;
event access;
remote power operations.
Потому что реализации management API разных платформ могут различаться.
Разделите требования по приоритету
Практичный вариант:
MUST
Обязательное соответствие.
SHOULD
Предпочтительно; отклонение должно быть явно описано и обосновано.
OPTIONAL
Дополнительная возможность.
Смысл этих терминов следует определить прямо в самом ТЗ.
Почему priority важнее длинного списка характеристик
Без priority поставщик не понимает:
что нельзя менять;
где допускается engineering alternative;
какие deviations приемлемы.
Для каждого critical requirement нужен supplier evidence
Недостаточно написать:
соответствует.
Нужно заранее определить приемлемое доказательство.
Например:
Requirement | Возможное evidence |
Installed components | Detailed BOM |
Mechanical/power | OEM documentation |
Expansion | Platform documentation |
Software compatibility | Official compatibility/support matrix |
Topology | OEM diagram |
Management | Product documentation |
Performance | Agreed benchmark report |
Supplier evidence и acceptance — не одно и то же
Supplier evidence
Что поставщик показывает до покупки.
Acceptance
Что проверяется на фактически поставленной системе.
Например:
До покупки: topology diagram.
После поставки: фактический topology report.
Эти два этапа не следует смешивать.
Detailed BOM должен раскрывать критичные компоненты
Для каждого важного компонента полезно получить:
manufacturer;
model/SKU;
quantity;
installed capacity.
Требуйте Compliance Matrix
Вместо общей фразы:
полностью соответствует ТЗ
лучше получить структурированный ответ.
ID | Requirement | Priority | Supplier response | Evidence | Deviation |
GPU-01 | MUST | ||||
TOP-01 | MUST | ||||
MEM-01 | MUST | ||||
NET-01 | SHOULD | ||||
FAC-01 | MUST |
Если предлагается alternative, deviation и его техническое обоснование должны быть видны до заказа.
Acceptance нужно определить до покупки
Критичные MUST requirements желательно сразу связать со способом проверки.
Например:
Requirement
Установлены четыре GPU согласованного SKU.
Evidence before purchase
Detailed BOM.
Acceptance
Фактический hardware inventory.
Так формируется traceability от ТЗ до поставки.
Уровень 1 — Delivery PASS
Проверяется комплектность:
chassis;
rails;
power cords;
cables;
adapters;
licenses;
documentation.
Уровень 2 — Inventory PASS
Проверяется, что действительно установлены согласованные:
GPU;
CPU;
RAM;
drives;
NIC.
Но:
Inventory PASS ≠ Configuration PASS.
Уровень 3 — Configuration PASS
Если workload чувствителен к topology, проверяется:
PCIe placement;
GPU-GPU connectivity;
GPU-NIC relationship;
configuration/firmware requirements.
Наличие правильных GPU ещё не доказывает правильную topology.
Уровень 4 — Diagnostic PASS
Активные hardware diagnostics проверяют работоспособность:
GPU compute;
memory;
PCIe;
interconnect;
power/thermal path —
в зависимости от выбранного diagnostic suite.
Но:
Diagnostic PASS ≠ workload performance PASS.
Уровень 5 — Software PASS
Выполняется согласованный smoke test.
Его задача:
доказать, что required software stack и workload запускаются.
Не обязательно измерять максимальную производительность.
Уровень 6 — Performance PASS
Нужен только тогда, когда performance является частью контрактного требования.
До заказа должны быть согласованы:
workload;
model/version;
precision;
software configuration;
input profile;
metric;
PASS threshold.
Нельзя сначала купить сервер и только потом решать, какой benchmark считать правильным.
Smoke test и performance benchmark — разные проверки
Smoke test
Приложение работает.
Performance test
Приложение достигает требуемого результата.
Не используйте одно вместо другого.
Не пишите «максимальная производительность»
Фраза:
сервер должен обеспечивать максимальную производительность AI
не имеет однозначного acceptance criterion.
Измеримое требование должно содержать:
workload;
metric;
target.
Сам target должен происходить из sizing, пилота или предварительного benchmark.
Коммерческие и сервисные требования держите отдельно
Отдельный раздел может включать:
срок поставки;
место поставки;
монтаж;
warranty;
support;
документацию;
licensing.
Не следует смешивать эти поля с hardware requirements.
Что поставщик должен вернуть
Минимальный полезный пакет ответа:
Detailed BOM.
Compliance Matrix.
Список deviations.
Installed / supported maximum / available expansion.
Included delivery scope.
Evidence для critical requirements.
Commercial/service conditions.
GPU Server Procurement Pack
Ниже — копируемый шаблон.
A. Назначение и workload
Поле | Значение |
Название проекта | |
Назначение сервера | |
Workload | |
Model/application | |
Training / inference | |
Precision / quantization | |
Context / sequence | |
Batch / concurrency | |
Performance objective | |
Expected growth |
B. Software
ID | Requirement | Priority |
SW-01 | Operating system | |
SW-02 | Framework | |
SW-03 | CUDA/ROCm | |
SW-04 | Driver compatibility | |
SW-05 | Container runtime | |
SW-06 | Other critical software |
C. Hardware
ID | Component | Installed requirement | Supported maximum / expansion | Priority | Equivalent allowed | Included |
GPU-01 | GPU | MUST | ||||
TOP-01 | GPU topology | MUST | ||||
CPU-01 | CPU | |||||
MEM-01 | RAM | |||||
STO-01 | System storage | |||||
STO-02 | Working storage | |||||
NET-01 | Application network | |||||
NET-02 | Storage/cluster network |
D. Facility
ID | Requirement |
FAC-01 | Rack U |
FAC-02 | Maximum depth |
FAC-03 | Maximum weight |
FAC-04 | Available power |
FAC-05 | Input/connectors |
FAC-06 | Cooling/environment |
E. Management
ID | Requirement |
OPS-01 | Out-of-band management |
OPS-02 | Remote console |
OPS-03 | Hardware inventory |
OPS-04 | Events/logs |
OPS-05 | Firmware management |
F. Requirement Matrix
ID | Requirement | Technical reason | Priority | Equivalent criteria | Required evidence | Acceptance |
GPU-01 | MUST | |||||
TOP-01 | MUST | |||||
MEM-01 | MUST | |||||
NET-01 | SHOULD | |||||
FAC-01 | MUST |
G. Supplier Compliance Matrix
ID | Supplier response | Proposed value/SKU | Evidence | Deviation |
H. Acceptance Matrix
ID | Requirement | Supplier evidence | Delivered value | Verification | Result |
PASS / FAIL |
Пример: ТЗ для production LLM inference
Главное — не конкретный BOM, а структура требований.
Workload
Зафиксировать:
model/version;
quantization;
context profile;
concurrency;
streaming;
latency objective.
GPU requirement
Возможный functional вариант:
GPU configuration должна обеспечивать требуемую memory capacity, совместимость с утверждённым serving stack и согласованный workload result.
Если production deployment уже квалифицирован только на определённой GPU, exact SKU становится MUST.
CPU/RAM
Определяются по:
serving stack;
preprocessing;
cache;
host services.
Network
Требования зависят от architecture:
client traffic;
storage;
management;
multi-node inference, если используется.
Acceptance
Можно использовать:
Пример: ТЗ для training или fine-tuning
Workload
Фиксируются:
model;
precision;
optimizer;
sequence;
batch;
parallelism.
GPU
Могут быть критичны:
memory fit;
GPU count;
topology;
interconnect.
CPU/RAM
Зависят в том числе от:
dataloader;
preprocessing;
checkpoint staging.
Storage
В ТЗ переносятся уже рассчитанные требования:
dataset read profile;
local cache;
checkpoint.
Network
Для multi-node training требования выводятся из parallelism и qualification, а не из универсального правила «AI требует N Гбит/с».
Acceptance
Можно разделить:
inventory;
diagnostics;
software smoke test;
representative training workload, если performance является contractual requirement.
Что делать, если точная конфигурация пока неизвестна
Не нужно выдумывать hardware specification.
Передайте поставщику:
workload;
model/software stack;
batch/concurrency;
performance objective;
facility constraints;
growth requirements;
acceptance expectations.
И запросите:
Так становится понятно, какие engineering assumptions сделал сам поставщик.
Частые ошибки в ТЗ
Копировать чужой BOM
Он мог проектироваться под другую задачу.
Фиксировать SKU без технической причины
Это искусственно сокращает варианты.
Писать «или эквивалент» без критериев
Тогда эквивалентность становится субъективной.
Путать installed и maximum
Максимальная capability платформы не является фактической поставкой.
Путать maximum и available expansion
Теоретический максимум не означает наличие свободных ресурсов в конкретном BOM.
Путать supported и included
Поддерживаемый компонент может отсутствовать в коммерческом предложении.
Игнорировать площадку
Подходящий по compute сервер может не подойти по power, depth или cooling.
Оставлять acceptance на потом
После поставки стороны начинают по-разному понимать исходные требования.
Какие данные передать поставщику
Если полного ТЗ пока нет, полезный минимум:
Блок | Данные |
Задача | Что сервер должен делать |
Workload | Model/application |
Mode | Training / inference |
Precision | Если определена |
Load | Batch / concurrency / context |
Software | Required stack |
Performance | Target metric |
Storage | Local/shared requirements |
Network | Architecture requirements |
Facility | Rack/power/cooling |
Growth | План расширения |
Acceptance | Что требуется подтвердить |
После этого можно переходить к подбору GPU- и AI-серверов.
Главное
Хорошее ТЗ на GPU-сервер начинается не с конкретной видеокарты.
Сначала фиксируют:
задачу → workload → software dependencies.
Затем:
workload → technical requirements.
Для каждого критичного требования определяют:
priority → exact/equivalent policy → supplier evidence → acceptance.
При этом важно помнить:
Requirement ≠ reference configuration.
Same VRAM ≠ equivalent GPU.
Vendor reference ratio ≠ universal requirement.
Installed ≠ supported maximum.
Supported maximum ≠ available expansion.
Supported ≠ included.
Inventory PASS ≠ Configuration PASS.
Configuration PASS ≠ Diagnostic PASS.
Diagnostic PASS ≠ Performance PASS.
Smoke test ≠ Performance benchmark.
Supplier evidence ≠ post-delivery acceptance.
Так ТЗ превращается из списка комплектующих в сквозной procurement document:
workload → requirement → evidence → delivered configuration → acceptance.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


