Ошибка CUDA out of memory при инференсе LLM обычно воспринимается однозначно: видеокарте не хватает VRAM. Но для диагностики этого вывода недостаточно.
Memory failure может возникнуть ещё при загрузке весов модели, во время инициализации inference engine, из-за недостаточной ёмкости KV cache, на конкретном runtime-запросе или только под параллельной нагрузкой. Отдельно существуют ситуации, когда CUDA OOM вообще нет, но из-за давления на KV cache растёт число preemptions и ухудшается latency.
Поэтому начинать нужно не с изменения gpu_memory_utilization, длины контекста или allocator settings, а с классификации ошибки.
Рабочая последовательность:
Reproduce → Classify → Capture Evidence → Identify Constraint → Change One Lever → Retest Same Workload → Recheck Performance.
Главный принцип:
Сначала определите, что именно произошло
Одинаковая жалоба «не хватает памяти» может соответствовать разным failure modes.
Что наблюдаем | Что это может означать |
torch.cuda.OutOfMemoryError при загрузке модели | weights и связанный working set не помещаются в доступную GPU memory |
Модель загрузилась, но engine не стал ready | проблема initialization, profiling, execution buffers, CUDA graphs или cache allocation |
Engine сообщает, что заданный context не помещается | недостаточная KV-cache capacity для выбранной конфигурации |
Server ready, конкретный request вызывает CUDA OOM | runtime working set превышает доступную память |
Один request работает, а под concurrency растут preemptions и latency | давление на KV cache или scheduler capacity без обязательного CUDA OOM |
OOM появляется нестабильно при workload, который должен помещаться | allocator state, fragmentation, external allocations или другой потребитель GPU memory |
Это важное разделение: memory failure не всегда является CUDA allocator OOM.
И наоборот, отсутствие CUDA OOM не доказывает, что memory sizing достаточен для production-нагрузки.
Что сохранить до изменения настроек
До tuning нужно зафиксировать исходное состояние. Иначе после нескольких одновременно изменённых параметров будет невозможно понять, какой из них действительно повлиял на проблему.
OOM Incident Card
Поле | Что записать |
Exact failure | точный текст ошибки или симптом |
Failure type | CUDA OOM / cache capacity / preemption / other |
Phase | model load / initialization / runtime |
Model / revision | точный ID и версия |
Precision / quantization | формат весов |
GPU | SKU × количество |
Device memory | общий и доступный объём |
Other GPU processes | сторонние потребители памяти |
Runtime / version | vLLM, PyTorch и другие значимые версии |
TP / PP | текущая схема parallelism |
gpu_memory_utilization | фактическое значение |
Explicit KV-cache budget | задан ли kv_cache_memory_bytes или аналогичный параметр |
max_model_len | maximum context |
Scheduler limits | включая актуальные ограничения sequences/tokens |
Input tokens | размер failing input |
Requested output | запрошенная длина generation |
Concurrency | профиль параллельной нагрузки |
PyTorch allocated / reserved | если проблема дошла до allocator-диагностики |
Reproducible | воспроизводится ли ошибка одинаково |
Принцип простой:
Шаг 1. CUDA OOM возникает при загрузке модели
Если ошибка появляется непосредственно во время model load, это отдельная ветка диагностики.
Первый вопрос:
Помещается ли resident model footprint в фактически доступную GPU memory?
Нужно сопоставить model/revision, precision или quantization, число GPU, parallelism и свободную память перед запуском. Одновременно стоит проверить, не занимает ли VRAM другой inference process, notebook, training job или стороннее CUDA-приложение.
Если weights действительно не помещаются, возможны несколько направлений.
Tensor parallelism
Tensor parallelism распределяет модель между несколькими GPU и способен снизить объём model weights на одно устройство.
Но это не бесплатное увеличение памяти: меняются communication и synchronization overhead, требования к interconnect и итоговый performance profile.
Поэтому:
Model fits ≠ production target met.
Pipeline parallelism
Pipeline parallelism также позволяет распределить слои модели между устройствами, но может изменить latency и поведение pipeline.
Использовать PP только как «аварийный флаг от OOM» без повторного performance test нельзя.
Quantization
Более компактное представление weights может существенно изменить memory footprint и сделать configuration запускаемой.
При этом меняется сама inference configuration. После изменения нужно снова проверять совместимость выбранной модели и runtime, производительность и — когда это существенно для конкретного метода — качество результата.
CPU offload
Offload части весов в RAM способен помочь configuration поместиться, но не превращает CPU memory в физическую VRAM.
Данные приходится передавать между CPU и GPU во время исполнения, поэтому:
Fits with offload ≠ fits natively in VRAM.
После такого изменения latency и throughput нужно измерять заново.
Шаг 2. Модель загрузилась, но engine не стал ready
Успешная загрузка weights ещё не означает успешный запуск inference server.
Во время initialization engine может профилировать workload, выделять KV cache и execution buffers, а также подготавливать CUDA graphs и другие runtime structures.
Поэтому:
Если failure возникает здесь, нужно отделить model footprint от дополнительного initialization overhead.
CUDA graphs тоже входят в memory budget
CUDA graphs способны увеличивать потребление GPU memory. Уменьшение graph-capture footprint или переход к eager execution в отдельных случаях помогает уменьшить memory pressure.
Но это trade-off.
Eager execution отключает часть оптимизированного execution path и может изменить steady-state performance. Значит, использовать его как универсальный production fix нельзя.
Правильный вопрос:
исправляет ли изменение конкретно наш memory failure и сохраняет ли необходимую производительность?
Почему gpu_memory_utilization нельзя менять вслепую
Это один из ключевых моментов диагностики vLLM.
gpu_memory_utilization задаёт per-instance memory budget model executor. Этот budget связан не только с KV cache: в общей картине присутствуют model weights, execution memory и автоматически определяемая память cache.
Поэтому универсального направления изменения нет.
При одном failure mode может потребоваться больше headroom. При другом недостаточный общий budget ограничивает доступный KV cache, и увеличение utilization способно дать cache больше пространства.
Следовательно, советы вида:
«При OOM всегда уменьшайте gpu_memory_utilization»
или
«При OOM всегда увеличивайте gpu_memory_utilization»
одинаково опасны.
Направление изменения зависит от того, что именно не помещается.
Explicit KV-cache budget меняет логику
Если размер KV cache задан явно через kv_cache_memory_bytes, cache sizing уже не определяется обычным способом из gpu_memory_utilization.
Поэтому этот параметр обязательно нужно записывать в Incident Card.
Иначе инженер может несколько раз менять utilization и не получать ожидаемого изменения cache capacity.
Есть и ещё одна практическая граница: вручную выбранный cache budget существует внутри конкретного состояния системы. Конфигурация, которая помещалась при одном объёме свободной VRAM, может перестать помещаться, если память перед следующим запуском занял другой процесс.
То есть:
Шаг 3. KV cache не хватает для заданного context
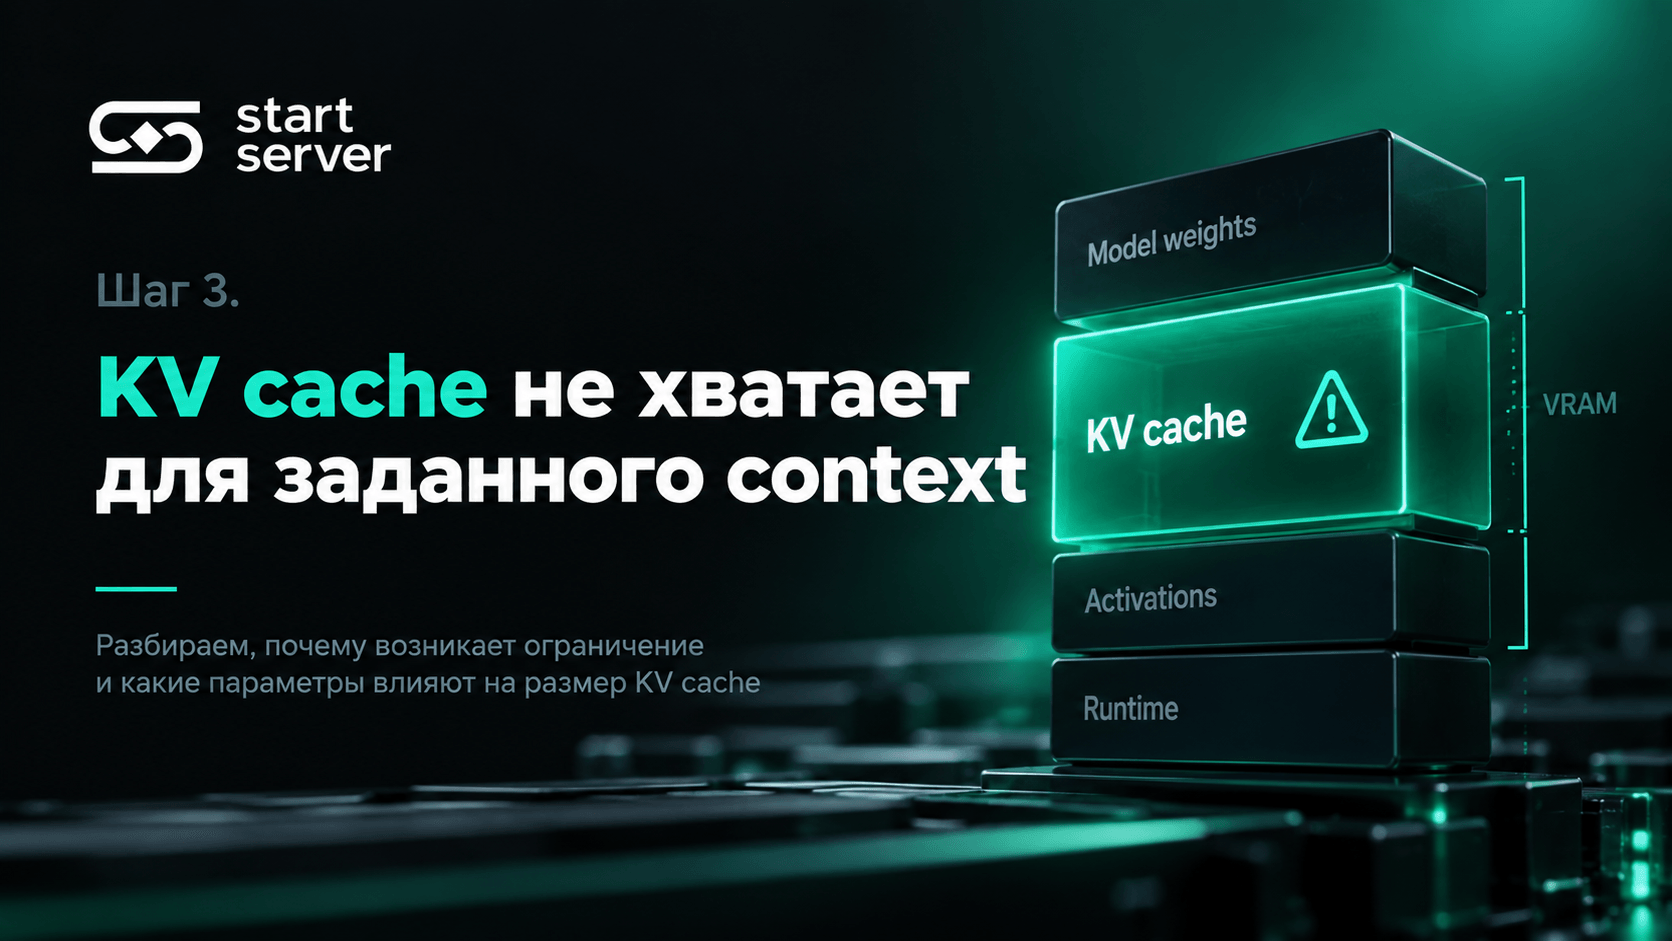
Отдельный сценарий: weights загрузились, но engine определяет, что имеющейся cache capacity недостаточно для configured maximum context.
Это memory-capacity failure, но его не следует автоматически называть torch.cuda.OutOfMemoryError.
Что означает max_model_len
max_model_len задаёт maximum model context — prompt и output в пределах одной последовательности.
Если приложение действительно требует эту длину, уменьшить параметр только ради запуска означает изменить требования системы.
Если же максимальный context был выставлен с большим запасом и реальному workload он не нужен, снижение может оказаться допустимым.
Важно правильно описывать результат:
снижение max_model_len уменьшает требуемую maximum context capability.
Не следует обещать:
«уменьшили context вдвое — потребление VRAM автоматически уменьшилось вдвое».
Cache geometry и общий execution memory зависят от конкретной модели и реализации inference engine. Простая линейная формула здесь ненадёжна.
Как длина sequence связана с KV cache
При autoregressive inference engine сохраняет key/value states для уже обработанных tokens.
Поэтому на memory demand влияют длина sequence и число одновременно активных последовательностей.
Но vLLM управляет KV cache блоками, а не работает по модели «каждый новый token делает отдельный malloc, пока память не закончится».
Эта разница важна для диагностики: общий принцип роста KV-state полезен для понимания нагрузки, но не заменяет реальную cache implementation конкретной версии serving stack.
Шаг 4. Engine работает, но конкретный request вызывает CUDA OOM
Если server успешно initialized и failure появляется только при запросе, нужно сохранить параметры именно этого запроса.
Критичны input length, requested output, concurrency, текущая memory configuration и состояние GPU перед выполнением.
Фраза:
«модель не помещается»
в этом случае может оказаться неправильной.
Модель может помещаться. Не помещается конкретный execution profile.
Длинный context — сильный сигнал, но не диагноз
Предположим, короткие prompts стабильно работают, а длинный request вызывает OOM.
Это полезный diagnostic signal, но он не доказывает, что единственная причина — KV cache.
Длинный request одновременно способен изменить required cache capacity, prefill scheduling, token budget и transient execution memory.
Поэтому:
Short request PASS + long request FAIL ≠ доказанный KV-cache root cause.
Нужно сохранять исходный failing request и проверять компоненты по очереди.
Шаг 5. Один request работает, а concurrency ломает workload
Такой сценарий особенно важен для production inference.
Smoke test может успешно загрузить модель, запустить server и выполнить один request. Под параллельной нагрузкой при этом появляются memory failures, preemptions или резкий рост latency.
Следовательно, размер inference configuration нельзя оценивать только по размеру весов.
max_num_seqs
max_num_seqs — это не «число пользователей сервера».
Параметр задаёт максимальное число sequences, обрабатываемых в одной iteration, и связан также с sizing внутренних runner structures и CUDA graph capacity.
Его снижение в соответствующей configuration способно уменьшить pressure, но одновременно меняет способность системы обслуживать параллельную нагрузку.
max_num_batched_tokens
Этот параметр ограничивает token budget одной iteration.
Изменение может влиять одновременно на scheduling, batch pressure, TTFT, inter-token latency и throughput.
Поэтому scheduler limits относятся к memory levers только с обязательным последующим benchmark.
Memory pressure может быть без CUDA OOM
При нехватке KV-cache capacity во время serving vLLM может preempt-ить часть работы и позже recompute-ить её.
Процесс при этом не обязан падать.
Симптомом могут стать preemptions и ухудшение end-to-end latency.
Поэтому:
No CUDA OOM ≠ No Memory Pressure.
Server способен пройти first-run test и при этом иметь недостаточный memory budget для требуемого сочетания context, concurrency и latency.
Шаг 6. Working set должен помещаться, но OOM нестабилен
Только после проверки основных sizing-причин имеет смысл переходить к allocator internals.
К этому моменту уже должны быть исключены очевидные проблемы с model footprint, context requirement, concurrency, cache configuration и сторонними потребителями GPU memory.
Если workload номинально должен помещаться, но OOM зависит от последовательности запросов или плохо объясняется ожидаемым working set, тогда появляется основание изучать allocator state.
allocated и reserved — разные величины
PyTorch использует caching allocator.
allocated показывает память, занятую активными tensors.
reserved показывает более широкий объём memory, которым управляет caching allocator, включая blocks, доступные для повторного использования.
Поэтому:
Allocated ≠ Reserved.
И:
nvidia-smi при этом может показывать больше памяти, чем текущий объём tensor allocations: unused blocks caching allocator всё ещё существуют на уровне GPU, а часть памяти вообще может быть выделена за пределами PyTorch allocator.
Почему empty_cache() не создаёт дополнительную VRAM
empty_cache() освобождает неиспользуемые cached blocks, которыми PyTorch в данный момент не занят.
Он не освобождает память живых tensors и не уменьшает сам требуемый working set.
Если workload физически требует больше памяти, чем доступно GPU, вызов empty_cache() не меняет фундаментальную проблему.
При отдельных allocator scenarios операция может помочь с fragmentation, но:
empty_cache() ≠ sizing fix.
И тем более:
empty_cache() ≠ больше физической VRAM.
Когда действительно проверять fragmentation
Fragmentation существует, но считать её причиной любого CUDA OOM — плохая стратегия.
Переходить к этой ветке стоит, когда target workload должен помещаться, другие GPU consumers исключены, ошибка воспроизводится, а allocator statistics дают основания подозревать неэффективное распределение blocks.
Только после этого имеет смысл рассматривать allocator-specific controls.
Параметры вроде max_split_size_mb не должны превращаться в магические значения из чужого GitHub issue. Их применимость зависит от allocator backend и конкретного allocation pattern; возможен и performance cost.
Логика должна быть:
stats → evidence → allocator tuning.
А не:
OOM → случайный allocator flag.
Как использовать PyTorch Memory Snapshot
Для сложного воспроизводимого случая можно перейти к snapshot allocator history.
Минимальный workflow:
Record history → Reproduce OOM → Dump snapshot → Inspect OOM event.
Snapshot позволяет увидеть allocations, frees, allocator blocks и состояние allocator около момента отказа.
Это полезнее, чем пытаться доказать fragmentation только по одной строке CUDA out of memory.
Snapshot не показывает всю память GPU
Это важное ограничение.
PyTorch Memory Snapshot видит память, которой управляет PyTorch allocator. GPU memory могут выделять напрямую CUDA-компоненты, NCCL и сторонние библиотеки.
Поэтому ситуация:
PyTorch объясняет 40 ГБ, а device-wide usage показывает 45 ГБ
не означает автоматически утечку 5 ГБ внутри PyTorch.
Нужно сопоставлять два уровня:
allocator-visible memory
и
device-wide memory.
Меняйте один параметр за раз
Самая полезная методика во всей диагностике выглядит так:
Воспроизвести исходный failure.
Зафиксировать environment и workload.
Определить наиболее вероятный constrained component.
Изменить один параметр.
Повторить тот же failing workload.
Сравнить memory behaviour.
Повторить performance test.
Если одновременно снизить context, concurrency, включить quantization и поменять allocator configuration, ошибка действительно может исчезнуть.
Но root cause останется неизвестным.
После fix нужен именно тот же failing workload
Если исходный OOM возникал при длинном context, concurrency 8 и определённом output profile, именно этот workload должен пройти после изменения.
Проверка одним коротким запросом ничего не доказывает, если короткий запрос работал и до исправления.
Retest должен подтверждать исправление исходной проблемы, а не более простой задачи.
После memory fix снова проверьте performance
Большинство memory levers имеют стоимость.
Изменение | Возможный trade-off |
Больше TP | communication и synchronization overhead |
PP | изменение latency |
Quantization | другой compatibility/performance/quality profile |
CPU offload | CPU↔GPU transfer |
Eager execution | потеря части execution optimizations |
Более жёсткие scheduler limits | снижение capacity |
Меньший token budget | изменение throughput и latency |
Меньший context | снижение capability |
Поэтому исправленный server должен пройти не только memory test.
Он должен по-прежнему соответствовать требованиям workload.
Corrective Action Matrix
Таблица ниже не является списком обязательных fixes. Она показывает, какой lever имеет смысл проверять после конкретного evidence.
Evidence | Возможный lever | Что перепроверить |
Weights не помещаются | TP / PP | communication, latency |
Weights не помещаются | Quantization | compatibility, performance, quality |
Weights не помещаются | CPU offload | latency, throughput |
CUDA graph overhead критичен | уменьшение capture / eager | steady-state performance |
Cache не поддерживает required context | изменить cache budget или VRAM | headroom, stability |
Configured context больше реального requirement | снизить max_model_len | capability приложения |
Pressure растёт с concurrency | scheduler/concurrency controls | capacity, latency, throughput |
Fragmentation подтверждена | allocator tuning | backend и performance |
External allocation занимает VRAM | убрать или изолировать consumer | operational impact |
Короткое дерево диагностики LLM OOM
Memory symptom
→ 1. Какой exact failure?
CUDA OOM / cache-capacity error / preemption / other.
→ 2. На какой фазе?
Model load / engine initialization / runtime.
→ 3. Model weights помещаются?
Если нет — precision, quantization, parallelism, offload, other processes и physical VRAM.
→ 4. Engine initialization проходит?
Если нет — profiling, transient memory, CUDA graphs и cache allocation.
→ 5. Configured context помещается в cache capacity?
Если нет — проверить max_model_len, cache budget и реальные требования приложения.
→ 6. Конкретный runtime workload вызывает OOM?
Зафиксировать request shape, context, concurrency и device state.
→ 7. OOM нет, но под нагрузкой растут preemptions и latency?
Проверить KV-cache pressure и scheduler/concurrency limits.
→ 8. Working set должен помещаться, но OOM нестабилен?
Только теперь переходить к allocated/reserved, fragmentation и external allocations.
→ 9. Изменить один lever.
→ 10. Повторить тот же failing workload.
→ 11. Повторно проверить performance.
→ 12. Только после этого принимать hardware decision.
Когда действительно нужна GPU с большей VRAM
Не каждый OOM является аргументом для замены GPU.
Hardware-capacity mismatch подтверждён, когда определён target workload, failure стабильно воспроизводится, constrained memory component установлен, а допустимые software/configuration alternatives не позволяют сохранить одновременно нужные context, concurrency, quality и performance.
Тогда более крупная VRAM перестаёт быть случайным troubleshooting-советом и становится техническим требованием.
Для подбора конфигурации полезно передать модель и revision, precision или quantization, требуемые context и concurrency, serving stack и его версию, текущий parallelism, точный воспроизводимый failure, используемые GPU и целевые latency/throughput.
После подтверждения memory-capacity mismatch можно перейти к подбору GPU-ускорителей и конфигураций с подходящим объёмом памяти на Start Server.
Главное
CUDA out of memory при LLM-инференсе нельзя исправлять только по названию ошибки.
Сначала нужно установить:
Exact Failure → Failure Type → Failure Phase → Environment + Workload Evidence → Memory Constraint.
И только потом:
One Corrective Lever → Same Workload Retest → Performance Retest.
Ключевые границы диагностики:
Memory Failure ≠ всегда CUDA OOM.
Model Load PASS ≠ Engine Ready PASS.
Cache-Capacity Failure ≠ Runtime OOM.
No OOM ≠ No KV Pressure.
Long-context failure ≠ автоматически KV-cache root cause.
gpu_memory_utilization ≠ параметр с универсальным направлением изменения.
Allocated ≠ Reserved.
Reserved ≠ Leak.
empty_cache() ≠ More Physical VRAM.
Fragmentation ≠ Default Root Cause.
PyTorch Snapshot ≠ Device-Wide Memory.
OOM-Free ≠ Performance PASS.
Хорошая диагностика OOM — это не поиск магической настройки. Это воспроизводимый incident: зафиксировать failure, определить constrained component, изменить один lever, повторить исходный workload и снова проверить производительность.
Только если требуемая workload configuration после этого устойчиво не помещается без неприемлемого компромисса, недостаток VRAM становится основанием для выбора другой GPU-конфигурации.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


