Поддержка ROCm в PyTorch ещё не означает, что конкретное ML-приложение можно без изменений перенести с NVIDIA GPU на AMD.
Сам Python-код может состоять из стандартных PyTorch operations и почти не зависеть от производителя GPU. Но рядом могут находиться:
custom CUDA kernels;
бинарные extensions;
PTX;
CUDA-specific libraries;
NVIDIA-oriented container dependencies;
distributed settings;
monitoring через NVML;
backend-specific inference code.
Поэтому перед закупкой AMD GPU-сервера нужно отвечать не на вопрос:
«Поддерживает ли наш framework ROCm?»
а на другой:
Проходит ли наш конкретный application stack требуемый workload на целевой ROCm-конфигурации?
Рабочая последовательность:
Freeze CUDA Baseline → Inventory Dependencies → Define Exact ROCm Target → Functional Test → Correctness → Distributed & Operations → Performance → Hardware Decision.
Главный принцип:
Сначала зафиксируйте рабочий CUDA baseline
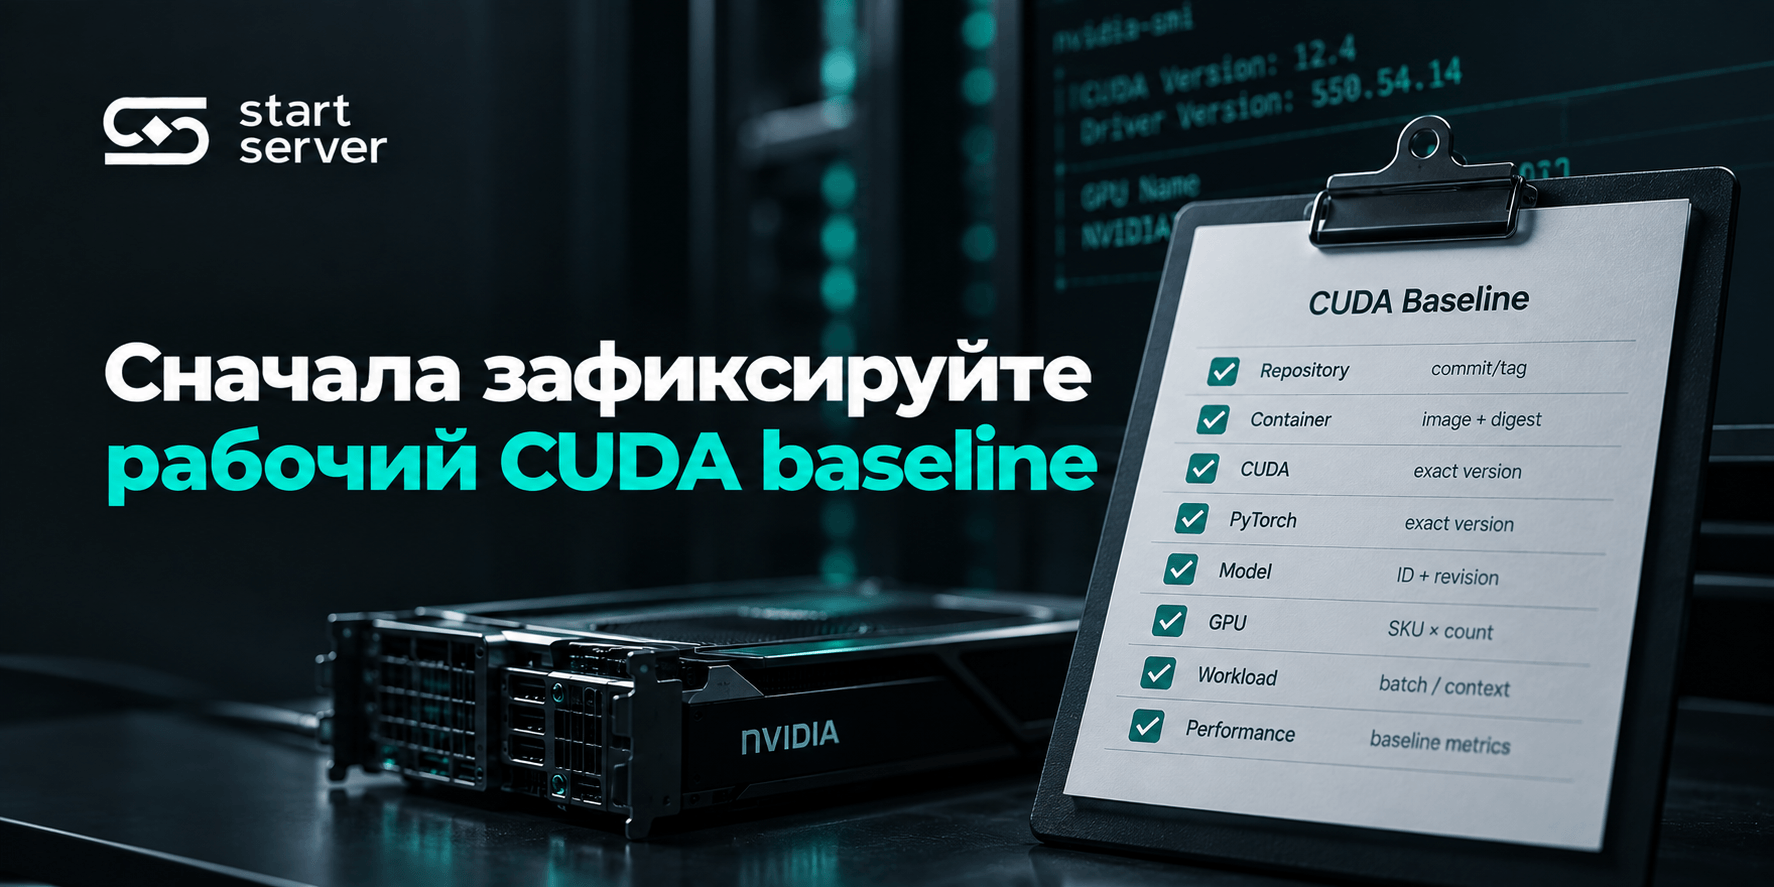
До миграции нужна исходная configuration, которую можно воспроизвести.
Если одновременно меняются model revision, framework, container и GPU platform, после failure будет сложно определить причину.
Зафиксируйте:
Поле | Что сохранить |
Repository | commit/tag |
Container | image + digest |
OS | distribution/version |
Driver | exact version |
CUDA | exact version |
Python | exact version |
Framework | exact version |
Serving/training engine | exact version |
Model | ID + revision |
Dependencies | lockfile/freeze |
Precision | FP32/FP16/BF16/FP8/quantization |
GPU | SKU × count |
Parallelism | TP/PP/DP |
Workload | batch/context/concurrency |
Startup | exact command |
Correctness | reference output/metric |
Performance | baseline latency/throughput |
Главная идея:
Нельзя доказать переносимость workload, если исходный workload сам не зафиксирован.
Не меняйте всё одновременно
При CUDA → ROCm migration нежелательно одновременно:
менять GPU vendor;
обновлять framework на несколько major versions;
менять model revision;
переходить на другой inference engine;
менять quantization;
переписывать batching или application logic.
Предпочтительная логика:
Current: PyTorch X
Target: PyTorch Y
Reason: требование target ROCm stack.
Так upgrade становится частью migration plan, а не скрытым изменением.
Совместимость нужно проверять по слоям
Одной строки:
«ROCm поддерживается»
недостаточно.
Рабочий ML application состоит из нескольких уровней.
Hardware
Поддерживается ли точная AMD GPU architecture?
Firmware
Соответствует ли требуемой версии target platform?
Driver и ROCm
Согласованы ли kernel driver и ROCm user-space stack?
OS и kernel
Поддерживается ли выбранная комбинация?
Framework / engine
Поддерживается ли exact version PyTorch, JAX, vLLM, SGLang или другого runtime?
Application dependencies
Есть ли рабочие builds используемых packages?
Native GPU code
Есть ли custom CUDA, PTX, compiled extensions или vendor libraries?
Distributed
Проходит ли required multi-GPU/multi-node path?
Operations
Работают ли container, deployment, monitoring и health checks?
Correctness
Получаем ли допустимый результат?
Performance
Достигается ли production target?
AMD публикует ROCm compatibility именно как согласованный стек firmware, driver, OS/kernel и user-space компонентов. Framework compatibility также привязана к конкретным validated версиям, а не только к названию framework. На дату проверки, 21 сентября 2026 года, текущая compatibility documentation относится к ROCm 10.0.0; перед реальным тестом нужно использовать актуальную матрицу для выбранной конфигурации.
Поэтому:
torch.cuda не означает NVIDIA-only
Это один из самых важных нюансов при проверке PyTorch codebase.
PyTorch на ROCm намеренно сохраняет существующий torch.cuda API namespace.
Например, для AMD GPU с ROCm нормальным остаётся:
device = torch.device("cuda")
и:
torch.cuda.is_available()
torch.cuda.get_device_name(0)
torch.device("rocm") или torch.device("hip") для обычного PyTorch device selection не используются. PyTorch делает это специально, чтобы облегчить перенос существующего кода между CUDA и HIP backends.
Следовательно, аудит:
grep cuda → нашли torch.cuda → application NVIDIA-only
некорректен.
Главная граница:
Framework-level torch.cuda = API namespace.
Direct CUDA Runtime/Driver API, CUDA libraries, PTX и native extensions = отдельные dependency classes.
Dependency Classifier
Каждую найденную CUDA-related зависимость нужно классифицировать.
Класс | Пример | Что проверять |
Framework portable | torch.cuda.* | ROCm build framework |
Backend-specific framework code | custom backend switch | docs exact version |
CUDA Runtime API | cudaMalloc, cudaMemcpy | HIP path |
CUDA Driver API | cuModule*, cuCtx* | manual/translated port |
CUDA library | cuBLAS/cuDNN/cuSPARSE | ROCm alternative |
Custom CUDA source | .cu, .cuh | HIP port/build |
PTX | inline/embedded PTX | alternative implementation or port |
Binary extension | wheel / .so | ROCm build or rebuild |
Distributed | NCCL assumptions | RCCL/PyTorch path |
Operations | NVML, nvidia-smi | operational replacement |
Container | CUDA base image | ROCm image |
Главный принцип:
Сделайте static dependency scan
До доступа к AMD GPU значительную часть риска можно найти по repository и container.
Полезно искать:
.cu
.cuh
nvcc
CUDA_HOME
CUDAToolkit
cudaMalloc
cudaMemcpy
cuModule
cuCtx
libcuda
cudart
cublas
cudnn
cusparse
nccl
nvidia-smi
NVML
pynvml
PTX
Также проверьте:
Dockerfile;
requirements.txt;
lockfiles;
pyproject.toml;
CMakeLists.txt;
CI/CD;
shell scripts;
Kubernetes manifests;
monitoring configuration.
Но static scan создаёт список кандидатов на проверку, а не verdict.
Например:
torch.cuda.synchronize()
и:
cudaMalloc(...)
содержат слово cuda, но имеют совершенно разный migration risk.
Определите exact ROCm target
До functional testing нужно зафиксировать target tuple.
Не:
AMD + ROCm latest.
А:
GPU
Firmware
Driver / ROCm
OS / Kernel
Python
Framework / Engine
Application Dependencies
Не используйте latest как test specification
Записи:
ROCm latest;
PyTorch latest;
vLLM latest
не позволяют нормально повторить тест спустя несколько месяцев.
В test record нужны:
exact versions;
container tag;
желательно digest;
model revision;
repository commit.
Если compatibility matrix позже изменится, остаётся понятно, что именно было проверено перед procurement.
Соберите отдельный ROCm environment
Рабочий CUDA container лучше сохранить неизменным.
Для ROCm создаётся отдельный candidate environment:
CUDA baseline
Существующая воспроизводимая configuration.
ROCm candidate
Отдельный image с exact:
ROCm;
framework;
Python;
engine;
dependencies;
application revision.
Так проще:
повторять тест;
локализовать failure;
сравнивать результаты;
хранить evidence;
делать rollback.
Basic Runtime Gate
До загрузки большой модели проверьте базовый environment.
Container starts
↓
GPU visible
↓
Framework imports
↓
Framework detects GPU
↓
Simple tensor operation
↓
Application imports
↓
Application starts
Для PyTorch можно сохранить diagnostic output:
import torch
print("PyTorch:", torch.__version__)
print("GPU available:", torch.cuda.is_available())
print("CUDA field:", torch.version.cuda)
print("HIP field:", torch.version.hip)
if torch.cuda.is_available():
print("Device:", torch.cuda.get_device_name(0))
Наличие torch.cuda здесь нормально и на ROCm. Для определения backend важно смотреть фактическую build/version information, а не название namespace.
Version checks тоже могут сломать перенос
Особое внимание нужно уделить low-level branches вроде:
#if CUDA_VERSION >= ...
PyTorch отдельно показывает, что CUDA и HIP version macros/runtime checks нельзя механически считать семантически одинаковыми. В переносимом коде могут потребоваться отдельные ROCm conditions.
То есть приложение может использовать в основном portable PyTorch APIs и всё равно выбрать неправильный native code path из-за одного version check.
Custom CUDA code получает отдельную ветку
Если repository содержит:
.cu;
.cuh;
custom CUDA extension;
custom PyTorch operator;
direct CUDA Runtime API;
CUDA Driver API;
нужно определить, существует ли уже ROCm implementation или код необходимо переносить.
Что делает HIPIFY
HIPIFY автоматизирует перевод множества CUDA APIs в HIP equivalents.
AMD предоставляет два основных варианта.
hipify-clang
Работает через Clang AST и требует, чтобы исходный CUDA code можно было корректно разобрать с нужными headers.
hipify-perl
Использует pattern-based translation и предъявляет меньше требований к build environment.
Но:
HIPIFY Success ≠ Application PASS.
Translation не доказывает:
successful build;
корректность kernels;
numerical correctness;
отсутствие unsupported APIs;
production performance.
После HIPIFY всегда нужен compile и functional test.
CUDA Driver API может потребовать ручной работы
CUDA имеет отдельные Runtime и Driver APIs.
Например:
cuda* — runtime;
cu* — driver;
cuModule* — module management;
cuCtx* — context management.
HIP в большей степени объединяет эти возможности в общей runtime model и предоставляет свои hipModule, hipCtx и hipDrv* interfaces.
Поэтому:
Source Translation ≠ Semantic Equivalence.
Особенно внимательно проверяются:
context lifecycle;
module loading;
architecture-specific code;
intrinsics;
memory assumptions;
compiler flags.
PTX — высокий migration risk, но не автоматический BLOCKER
PTX является NVIDIA-specific representation, поэтому тот же PTX path нельзя просто использовать на AMD.
Но обнаружение PTX ещё не означает:
«вся миграция невозможна».
Нужно выяснить:
является ли PTX path обязательным;
существует ли portable implementation;
есть ли другой backend;
можно ли заменить operation стандартным framework operator;
можно ли переписать kernel.
Правильный начальный статус:
В BLOCKER она превращается только тогда, когда необходимый production requirement невозможно выполнить через приемлемый alternative path.
Главная формула:
PTX Found ≠ Migration Impossible.
Precompiled extensions проверяйте отдельно
Рабочий CUDA wheel не означает наличие ROCm build.
Для native package нужно ответить:
Есть ли официальный ROCm wheel?
Есть ли package в поддерживаемом container?
Доступны ли исходники?
Можно ли собрать его под target AMD architecture?
Проходит ли собственный functional test?
Если готового wheel нет, но есть поддерживаемый source build, это обычно REMEDIATION, а не автоматически BLOCKER.
FAIL тоже не означает автоматически BLOCKER
Это важное правило migration workflow.
PASS
Обязательный компонент подтверждён тестом.
REMEDIATION
Сейчас не проходит, но существует понятный:
port;
rebuild;
replacement;
configuration change.
BLOCKER
Обязательный requirement невозможно выполнить приемлемым способом либо стоимость remediation признана неприемлемой.
UNKNOWN
Компонент не проверен.
Следовательно:
FAIL ≠ Automatically BLOCKER.
И:
UNKNOWN ≠ PASS.
Разделяйте типы failure
Для Blocker Register полезно фиксировать фазу.
INSTALL FAIL
Package не устанавливается.
BUILD FAIL
Native code не собирается.
IMPORT FAIL
Application не импортируется.
INIT FAIL
Backend/GPU не инициализируется.
RUNTIME FAIL
Падает конкретный operator/workload.
CORRECTNESS FAIL
Код работает, но результат неприемлем.
PERFORMANCE FAIL
Результат корректен, но target не достигается.
Это гораздо информативнее фразы:
«ROCm не заработал».
Functional Test Matrix
После basic environment test запускайте реальный application.
Test | CUDA baseline | ROCm candidate | Status |
Application import | PASS | ||
Model load | PASS | ||
Checkpoint load | PASS | ||
Smoke inference | PASS | ||
Representative workload | PASS | ||
Boundary workload | PASS | ||
Required precision | PASS | ||
Custom operators | PASS | ||
Forward | если нужен | ||
Backward | если нужен | ||
Optimizer step | если нужен | ||
Checkpoint save/reload | если нужен | ||
Multi-GPU | если нужен | ||
Multi-node | если нужен |
Статусы:
NOT TESTED не является PASS.
Model Load PASS недостаточен
Загрузка checkpoint подтверждает только часть execution path.
Failure может появиться:
на custom op;
при long context;
на другом batch size;
при backward;
на production precision;
при multi-GPU;
в другом attention backend.
Поэтому:
Model Load PASS ≠ Workload PASS.
Используйте production-like inputs
Для полноценной проверки полезно иметь три класса input.
Smoke
Минимальная быстрая проверка.
Representative
Типичный production request.
Boundary
Нагрузка около требуемой границы:
context;
batch;
sequence length;
resolution;
concurrency.
Именно boundary case часто открывает проблемы, которые незаметны на smoke test.
Проверяйте numerical correctness
Код может закончиться без exception и всё равно дать неправильный результат.
Для inference можно использовать:
golden dataset;
application metric;
logits tolerance;
reference outputs.
Для training:
loss;
gradients;
NaN/Inf;
короткий convergence run;
checkpoint save/reload.
Главный принцип:
Не требуйте universal bitwise identity
Разные GPU backends могут немного отличаться по порядку floating-point operations и implementations kernels.
Поэтому критерий:
«всё должно совпасть bit-for-bit»
не является универсальным.
Но и:
«любое отличие нормально»
тоже неверно.
Acceptance tolerance задаётся исходя из:
workload;
precision;
metric;
model;
business/engineering requirement.
Production precision проверяется отдельно
Если production работает в BF16, нельзя считать FP32 run окончательным compatibility test.
То же относится к:
FP16;
FP8;
INT8;
AWQ;
GPTQ;
другим quantization paths.
Different precision может активировать другой:
kernel;
fused operation;
attention backend;
library implementation.
Поэтому:
Inference engine получает собственный gate
Поддержка PyTorch не доказывает поддержку конкретного serving stack.
vLLM официально поддерживает AMD ROCm как отдельную GPU platform, но имеет отдельные ROCm installation requirements и hardware/backend-specific пути.
Следовательно:
PyTorch PASS ≠ vLLM PASS.
И:
vLLM Supports ROCm ≠ Every Model + Precision + Backend PASS.
Проверяется exact:
Single GPU PASS не означает Distributed PASS
Multi-GPU execution — отдельный compatibility layer.
Application может успешно работать на одной AMD GPU и не проходить:
tensor parallelism;
data parallelism;
collectives;
multi-node communication;
checkpoint synchronization.
Поэтому:
Single GPU PASS ≠ Distributed PASS.
Если production требует четыре или восемь GPU, именно эта configuration должна пройти test.
backend="nccl" не всегда означает NVIDIA-only
Здесь действует похожая ловушка, как с torch.cuda.
На ROCm часть software stack сохраняет знакомые NCCL-style interfaces и configuration names для compatibility. RCCL documentation использует параметры NCCL_* и внутренние nccl* API names даже в AMD communication stack.
Поэтому наличие:
backend="nccl"
или:
NCCL_DEBUG=INFO
не является достаточным доказательством NVIDIA-only зависимости.
Но из этого нельзя сделать обратный вывод:
NCCL и RCCL полностью эквивалентны.
Правильная граница:
NCCL Naming/API Compatibility ≠ NCCL/RCCL Implementation or Performance Equivalence.
Старый NCCL tuning нельзя переносить вслепую
Даже если RCCL понимает знакомые NCCL_* параметры, старый NVIDIA tuning не становится автоматически оптимальным для AMD platform.
Для каждого production variable лучше определить статус:
Parameter | Status |
NCCL_* | Needed / Supported / Replace / Remove / Test |
Отдельно тестируются:
topology;
transport;
collective performance;
scale-out behaviour.
Operations тоже входят в migration
Рабочий notebook ещё не означает готовность production deployment.
Проверьте:
Containers
Есть ли reproducible ROCm image?
Device access
Правильно ли GPU передаётся в container?
Kubernetes
Работают ли:
device integration;
resource scheduling;
node labels;
health status?
Monitoring
Нет ли жёсткой зависимости от:
nvidia-smi;
NVML;
pynvml;
NVIDIA-specific exporter.
Deployment scripts
Ищите:
/usr/local/cuda;
CUDA_HOME;
NVIDIA runtime assumptions;
NVIDIA-specific image tags.
Health checks
Не завязан ли readiness test на NVIDIA-only command?
Полный monitoring AMD GPU — отдельная эксплуатационная тема. В SS-041 достаточно доказать, что существует рабочий operational path.
Blocker Register
Все проблемы фиксируются отдельно.
Dependency / Failure | Phase | Evidence | Remediation | Retest | Status |
Package без ROCm wheel | install | log | source build | ||
.cu extension | build | source/log | HIP port | ||
PTX path | static/runtime | source | alternative kernel | ||
Model op fail | runtime | log | backend change | ||
Precision fail | runtime | log | alternate path | ||
Multi-GPU fail | distributed | trace | config/port | ||
NVML dependency | deployment | manifest | replace tooling |
Так:
«ROCm не работает»
превращается в конкретный список инженерных задач.
CUDA → ROCm Migration Test Matrix
Главный useful asset статьи.
Компонент | CUDA baseline | ROCm target | Evidence | Action | Status |
GPU | vendor matrix | ||||
Firmware | vendor matrix | ||||
OS/kernel | compatibility matrix | ||||
ROCm/driver | exact version | ||||
Framework | official docs | ||||
Engine | official docs | ||||
Python packages | install logs | ||||
Native extensions | build log | ||||
Custom kernels | source/test | ||||
PTX dependencies | scan | ||||
Model load | PASS | test | |||
Representative workload | PASS | test | |||
Boundary workload | PASS | test | |||
Numerical correctness | baseline | metric | |||
Precision | test | ||||
Multi-GPU | log | ||||
Deployment | test | ||||
Monitoring | test | ||||
Performance | baseline | benchmark |
Главная ценность этой таблицы — evidence.
Не:
«должно работать».
А:
Performance проверяется после functionality
Benchmark не должен быть первым этапом migration.
Правильный порядок:
Functional PASS
↓
Correctness PASS
↓
Required Precision PASS
↓
Distributed PASS
↓
Operational PASS
↓
Performance Test
Иначе можно оптимизировать configuration, которая позже окажется функционально непригодной.
Как сравнивать performance
Чтобы CUDA baseline и ROCm candidate можно было сравнить, нужно сохранить одинаковыми:
model/revision;
workload;
input;
batch;
context;
requested output;
concurrency;
precision;
acceptance quality;
methodology.
После этого сравниваются:
throughput;
latency;
TTFT/ITL для LLM serving;
memory use;
training step time;
scaling.
Главный вопрос:
Достигает ли target AMD/ROCm configuration требований проекта?
А не:
«обязана ли она показать ровно столько же tokens/s, сколько NVIDIA?»
Functional PASS не означает Performance PASS
Application может быть полностью переносимым и при этом не удовлетворять production target.
Причины могут находиться в:
kernel backend;
communication;
topology;
scheduler;
model-specific optimization;
maturity конкретного code path.
Поэтому:
Application Runs ≠ Performance Target Met.
Performance PASS ещё не выбирает поставщика оборудования
SS-041 заканчивается software compatibility gate.
Она не должна самостоятельно отвечать на:
стоимость оборудования;
TCO;
энергопотребление всего решения;
сроки поставки;
гарантию;
инфраструктурные расходы.
Результат статьи:
После этого можно переходить к hardware sizing и коммерческому сравнению.
Когда AMD GPU-сервер покупать рано
Procurement лучше не закрывать, пока есть критический UNKNOWN.
Например:
не протестирован required custom operator;
production precision заменена более простой;
проверена только одна GPU при требуемых восьми;
не протестирован serving engine;
неизвестен porting path обязательного PTX component;
ключевая binary dependency не имеет проверенного ROCm build;
monitoring/deployment ещё NVIDIA-only.
Даже подходящие VRAM и compute характеристики GPU не устраняют software uncertainty.
Когда failure не отменяет миграцию
Отдельный failure может быть исправим.
Например:
Нет ROCm wheel
Попробовать supported source build.
CUDA-only custom operator
Проверить HIP port или portable framework implementation.
PTX optimization
Проверить другой backend или переписать kernel.
NVIDIA monitoring
Заменить operational integration.
Поэтому:
FAIL ≠ Automatically BLOCKER.
Нужно оценить remediation.
Короткий Pre-Purchase Compatibility Gate
Перед закупкой ответьте на вопросы.
CUDA baseline воспроизводится?
Если нет — сначала исправить baseline.
Exact AMD GPU подтверждена в compatibility matrix?
Для выбранного ROCm release.
Firmware/driver/OS/framework combination подтверждена?
Не только модель GPU.
Все vendor-specific dependencies найдены?
Включая native code и binaries.
ROCm candidate воспроизводим?
С exact versions.
Production workload выполняется?
Не только smoke test.
Numerical result допустим?
По заданному acceptance criterion.
Production precision протестирована?
Не surrogate precision.
Required multi-GPU configuration протестирована?
Если нужна production.
Deployment path готов?
Container, scheduling, health checks, monitoring.
Performance target достигнут?
После functional PASS.
Если критический ответ:
«не проверяли»,
статус остаётся:
Главная схема CUDA → ROCm Migration Gate
Working CUDA Baseline
↓
Dependency Inventory
↓
Exact Target: GPU + Firmware + Driver/ROCm + OS + Framework
↓
Unsupported Required Dependency?
→ да → REMEDIATION / BLOCKER
→ нет
↓
Build ROCm Candidate
↓
Basic Runtime PASS
↓
Application Functional PASS
↓
Correctness PASS
↓
Production Precision PASS
↓
Distributed PASS
↓
Operational PASS
↓
Performance PASS
↓
MIGRATION READY
↓
Hardware Sizing / Procurement
Главное
Перенос CUDA workload на ROCm нельзя подтвердить одной строкой в compatibility matrix.
Нужно последовательно доказать:
CUDA Baseline
→ Dependencies
→ Exact ROCm Target
→ Functional Compatibility
→ Numerical Correctness
→ Required Precision
→ Distributed & Operations
→ Performance.
Ключевые границы:
Framework Support ≠ Application Support.
torch.cuda ≠ NVIDIA-only.
API Name ≠ Dependency Classification.
HIPIFY Success ≠ Application PASS.
PTX Found ≠ Migration Impossible.
Compile PASS ≠ Functional PASS.
Model Load PASS ≠ Workload PASS.
Execution PASS ≠ Correctness PASS.
Single GPU PASS ≠ Distributed PASS.
Functional PASS ≠ Performance PASS.
FAIL ≠ Automatically BLOCKER.
UNKNOWN ≠ PASS.
PyTorch намеренно сохраняет torch.cuda API на ROCm, поэтому простой поиск слова cuda создаёт ложные blockers. Настоящие риски чаще находятся в native code, PTX, custom kernels, binary dependencies, backend-specific execution и operational tooling.
ROCm target должен задаваться как конкретная комбинация GPU, firmware, driver, OS/kernel и software stack, а затем проверяться фактическим workload.
Только когда production application проходит functional, correctness, precision, distributed и operational gates, имеет смысл сравнивать performance и переходить к выбору конкретного AMD GPU-сервера.
Если рассматривается перенос существующей CUDA-нагрузки на AMD GPU-платформу Start Server, для предварительной проверки можно передать текущий software stack, модель, custom GPU dependencies и параметры production workload.
CTA: Проверить совместимость приложения с AMD GPU-платформой.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


