Инференс нейросети, или inference, представляет применение уже обученной модели к новым данным. Модель получает текст, изображение, звук, таблицу или другой вход и вычисляет результат: класс, вероятность, координаты объекта, вектор, прогноз либо сгенерированную последовательность.
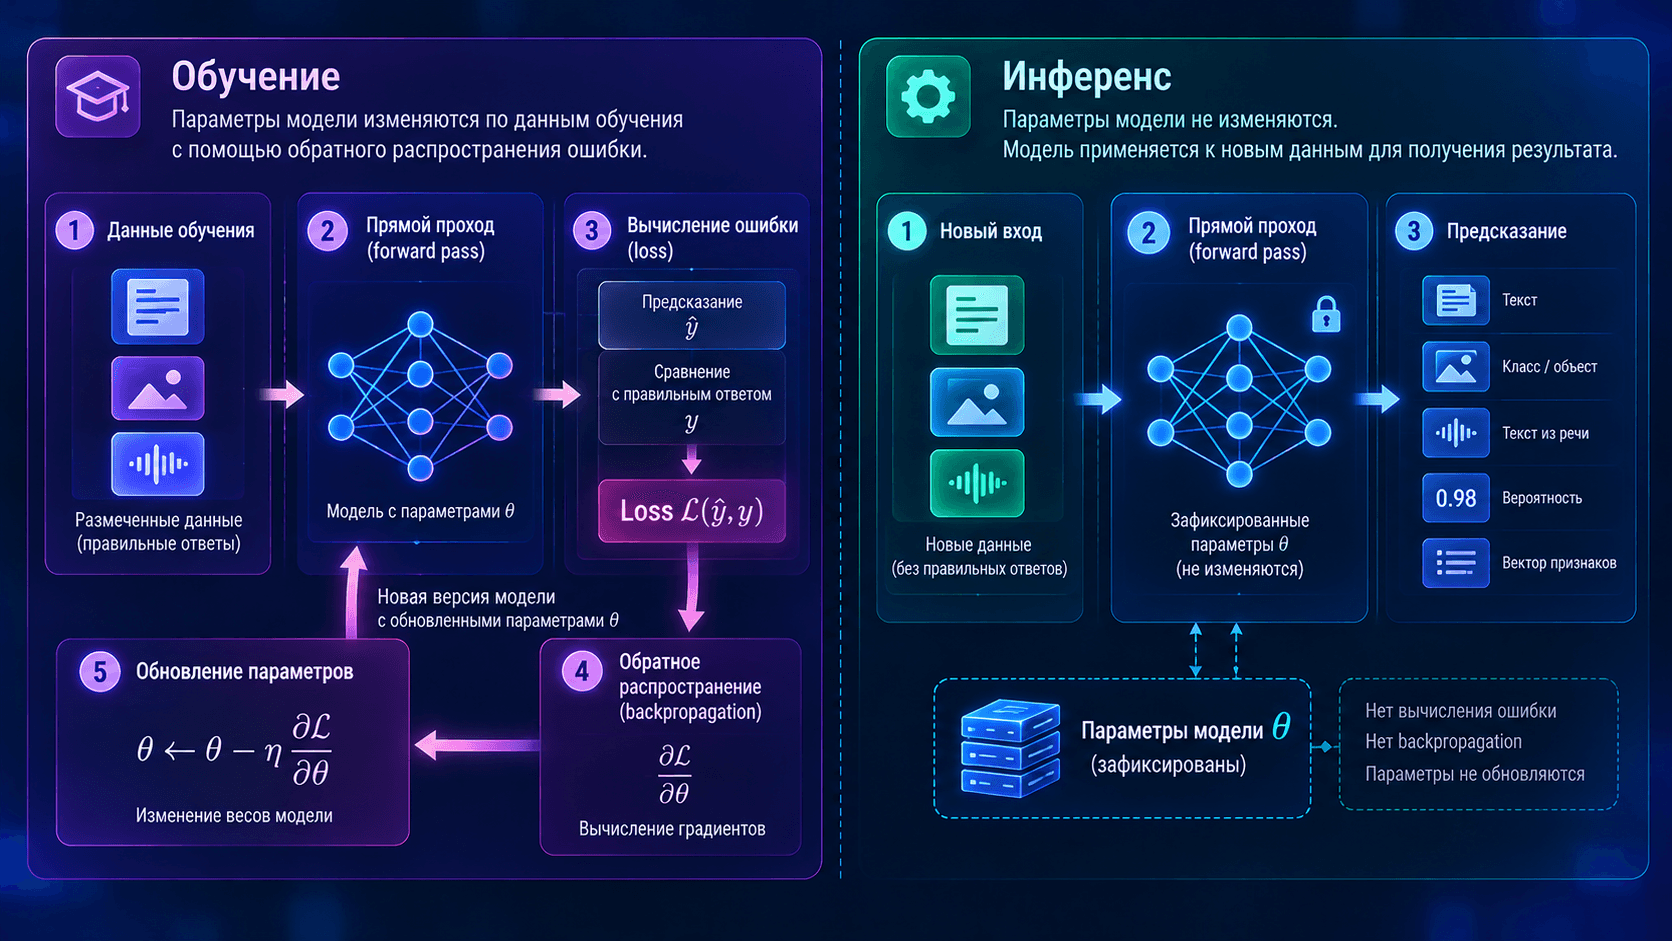
Во время обычного инференса веса модели не обучаются. Система выполняет прямой проход, преобразует выход в прикладной результат и возвращает его пользователю или другой программе. Например, классификатор определяет тип документа, модель компьютерного зрения находит дефект, speech model распознает речь, а LLM генерирует ответ токен за токеном.
Скорость инференса зависит не только от видеокарты. На нее влияют архитектура и размер модели, форма входа, длина контекста, precision, batch size, число одновременных запросов, runtime, доступная память, передача данных, очередь, постобработка и требования к качеству. Быстрый forward pass не гарантирует быстрый сервис, если большую часть времени занимают подготовка данных или ожидание в очереди.
Что такое инференс в машинном обучении
В машинном обучении inference означает использование закономерностей, записанных в параметрах модели после обучения. На вход поступает новый объект, а на выходе появляется предсказание или сгенерированный результат.
Для разных задач выход выглядит по-разному:
Задача | Вход | Результат инференса |
|---|---|---|
Классификация | письмо, изображение, транзакция | класс и оценка уверенности |
Регрессия | набор признаков | числовой прогноз |
Object detection | кадр или фотография | классы, координаты и confidence объектов |
Сегментация | изображение | маска по пикселям |
Распознавание речи | аудиопоток | текст и временные метки |
Embeddings | текст или изображение | числовой вектор |
LLM | prompt и контекст | последовательность выходных токенов |
Diffusion model | текстовое описание и параметры | изображение или видео |
Инференс модели не равен готовому бизнес-решению. В production вокруг нее работают прием запросов, проверка данных, preprocessing, база признаков или RAG, scheduler, postprocessing, правила, мониторинг и обработка ошибок. Если измерять только функцию model(input), можно пропустить основную задержку реального сервиса.
Чем инференс отличается от обучения, валидации и тестирования
Эти этапы используют одну модель, но решают разные задачи.
Этап | Что происходит с весами | Нужны правильные ответы | Главная цель |
|---|---|---|---|
Обучение | обновляются через backpropagation и optimizer | обычно да | уменьшить ошибку на обучающих данных |
Валидация | не обновляются | да | выбирать настройки и контролировать переобучение |
Тестирование модели | не обновляются | да | оценить качество на отложенной выборке |
Инференс | не обновляются | не обязательно | получить результат для нового входа |
В PyTorch вызов model.eval() переключает слои, поведение которых различается между обучением и применением, например dropout и batch normalization. Контекст inference_mode() отключает часть механизмов autograd и связанного overhead, но сам по себе не переводит модель в evaluation mode. Эти действия дополняют друг друга.
Как работает инференс нейросети
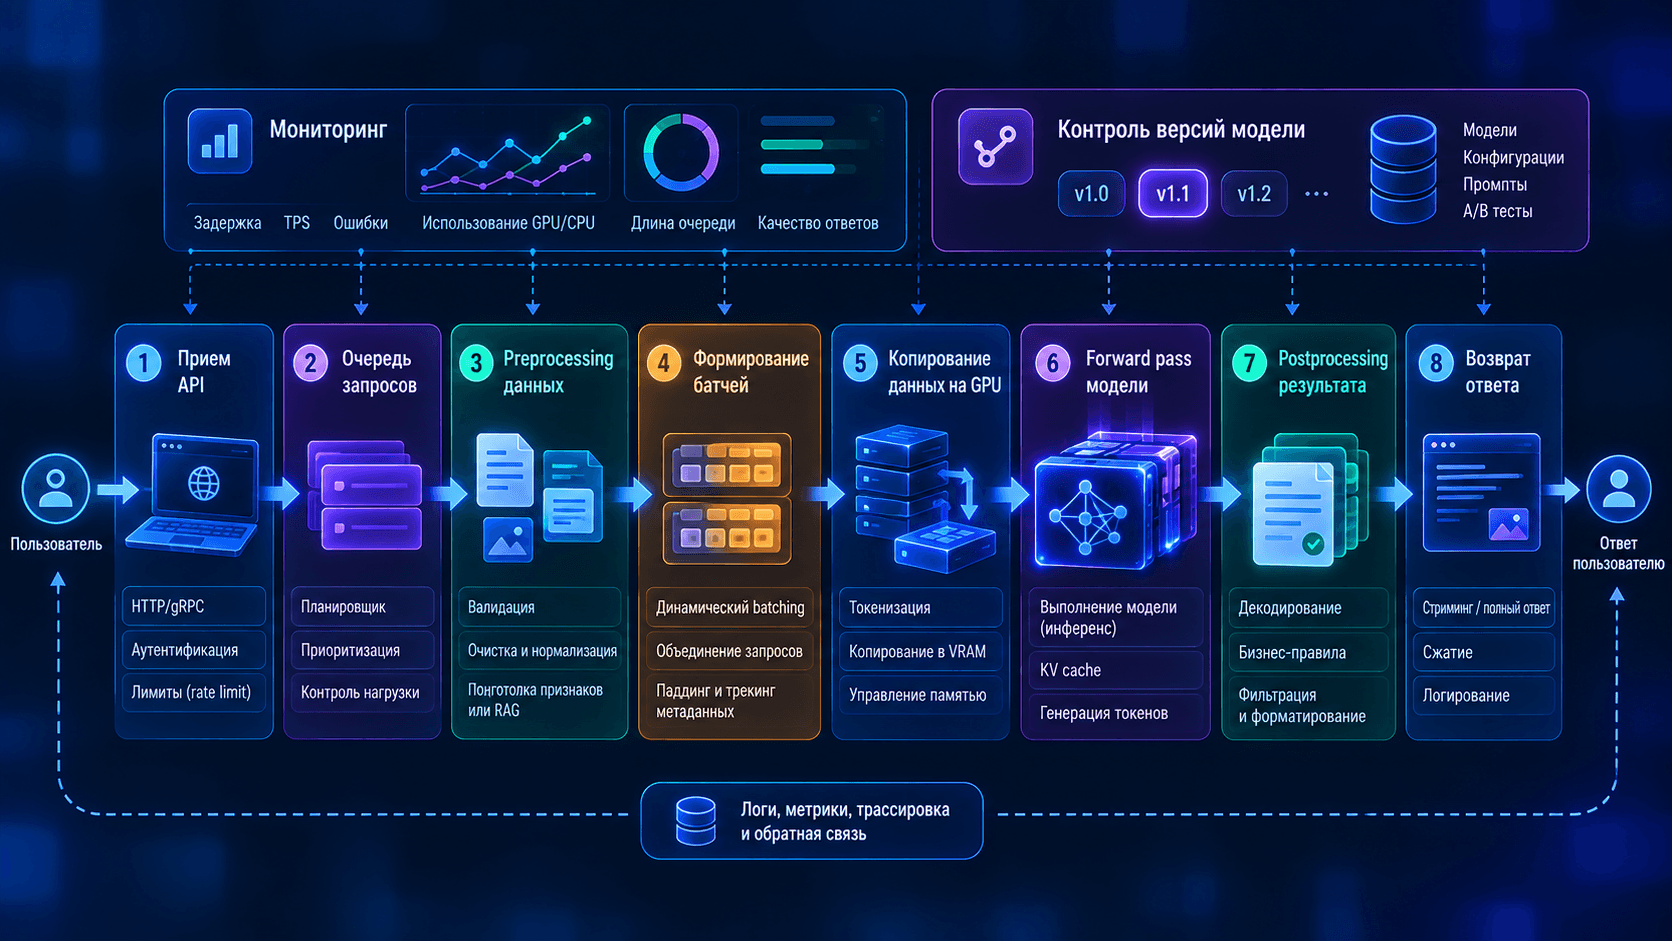
Конкретный pipeline зависит от задачи, но production-контур обычно проходит восемь этапов.
1. Загрузка модели
Сервис читает checkpoint или готовый engine, выделяет RAM и VRAM, загружает веса, инициализирует runtime и создает рабочие буферы. Первый запуск может быть медленнее из-за компиляции kernels, выбора tactics, заполнения cache и прогрева.
2. Прием и проверка входа
API проверяет тип, размер, схему, авторизацию и лимиты. На этом этапе запрос может ждать свободный worker. Queue time входит в пользовательскую задержку, хотя GPU еще не начал вычисление.
3. Предобработка
Текст токенизируется. Изображение декодируется, масштабируется и нормализуется. Аудио преобразуется в нужную частоту дискретизации или спектральное представление. Табличные признаки приводятся к схеме обучения. Несовпадение preprocessing способно ухудшить качество даже при исправной модели.
4. Формирование batch
Scheduler может объединить несколько входов в пакет. На GPU это часто повышает throughput, потому что вычислительные блоки получают больше параллельной работы. Ожидание соседних запросов увеличивает latency, поэтому размер batch и задержку сборки подбирают по SLA.
5. Передача данных
Входные tensors перемещаются в память вычислительного устройства. Для маленькой модели копирование CPU-GPU и запуск kernels иногда занимают заметную долю времени. Лишние преобразования layout, dtype и device создают overhead.
6. Прямой проход
Runtime выполняет граф модели. В зависимости от архитектуры основную нагрузку дают matrix multiplication, convolution, attention, normalization, activation и memory movement. Результат сохраняется в output tensors.
7. Постобработка
Приложение применяет softmax, threshold, non-maximum suppression, beam search, декодирование токенов, правила или объединение результатов. Для video analytics сюда входят tracking и бизнес-логика. Постобработка на CPU может стать узким местом после ускорения самой модели.
8. Ответ и наблюдаемость
Сервис сериализует результат, возвращает его клиенту и записывает технические метрики. Полезно фиксировать версию модели, длину входа, batch, queue time, model time, end-to-end latency, тип ошибки и качество на доступной обратной связи.
Какие виды инференса бывают
Онлайн-инференс
Каждый запрос требует быстрого ответа. Примеры: чат, антифрод, поиск, рекомендации и проверка изображения при загрузке. Основной компромисс проходит между низкой latency и эффективным batching.
Пакетный инференс
Большой набор обрабатывается по расписанию или очереди. Например, ночной скоринг клиентской базы или создание embeddings для архива документов. Здесь допустима большая задержка отдельного объекта, а главной метрикой становится throughput и стоимость всего задания.
Потоковый инференс
Система непрерывно получает аудио, видео или события. Важны стабильность, backpressure, обработка state и задержка каждого фрагмента. Средняя скорость должна быть не ниже скорости поступления данных, иначе очередь растет.
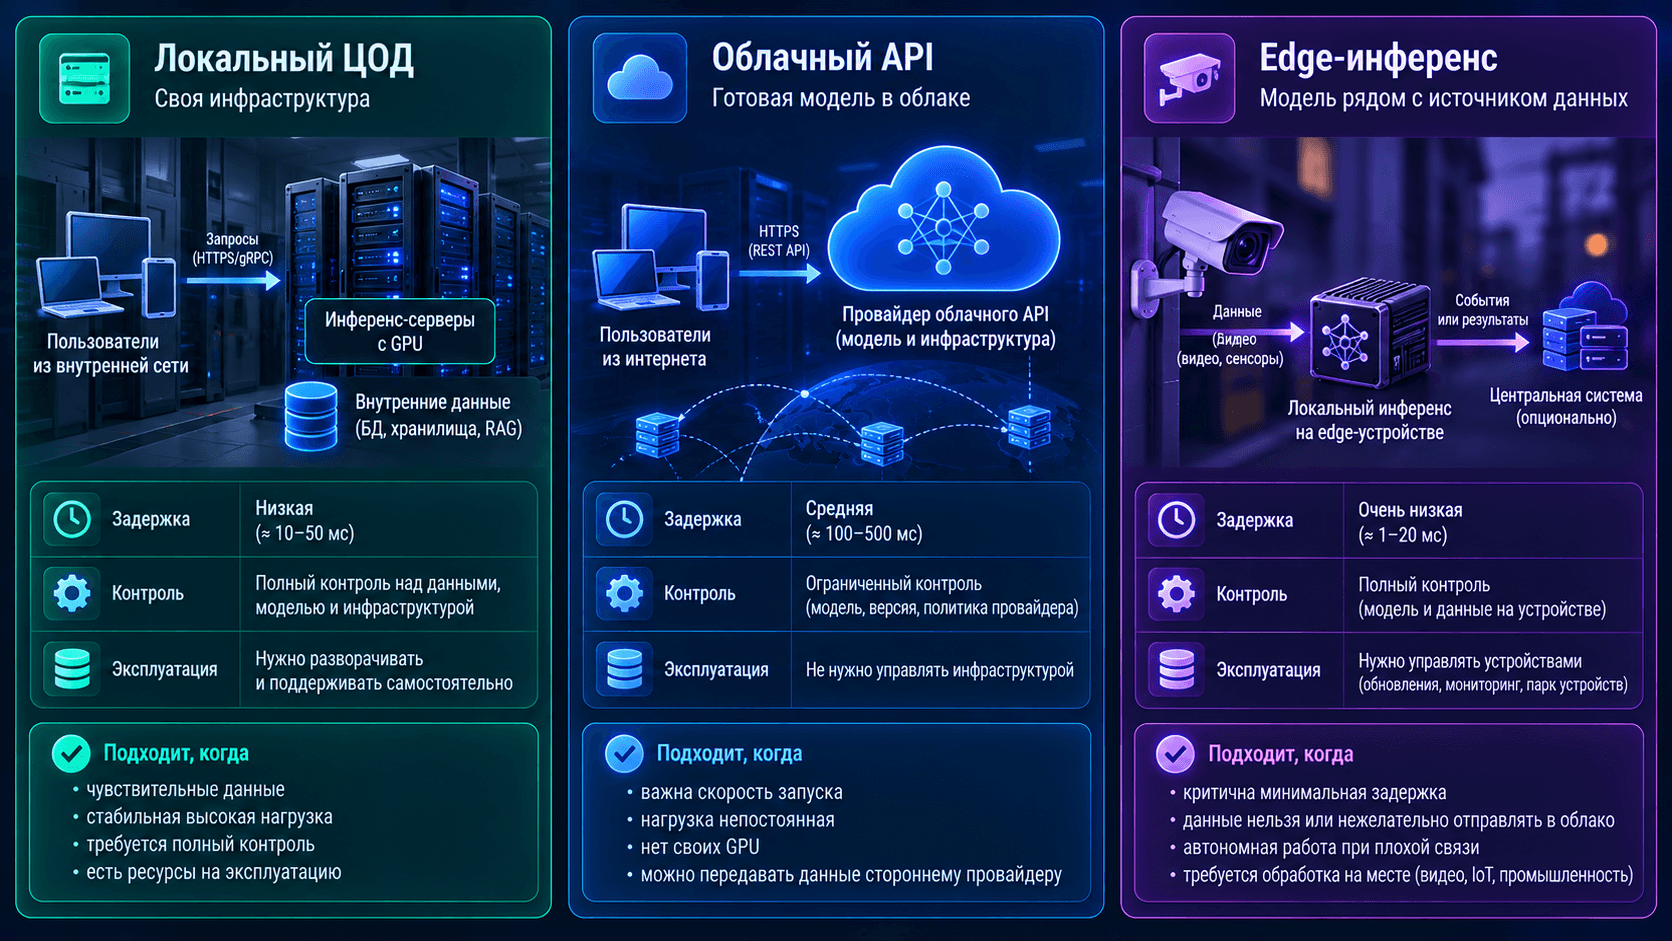
Локальный инференс
Модель работает на сервере, рабочей станции или устройстве организации. Это дает контроль над данными, версией и latency, но требует развертывания, мониторинга, обновлений и резервирования.
Edge-инференс
Вычисление выполняется рядом с камерой, станком, датчиком или пользователем. Снижаются сетевые задержки и зависимость от канала, но ограничены питание, охлаждение и память. Часто edge обрабатывает срочную часть, а центр хранит данные и переобучает модель.
Облачный инференс через API
Провайдер управляет инфраструктурой, а приложение платит за запросы или вычислительное время. Это удобно для быстрого пилота и переменной нагрузки. Нужно проверить правила обработки данных, лимиты, версию модели, доступность региона, стоимость и зависимость от внешнего сервиса.
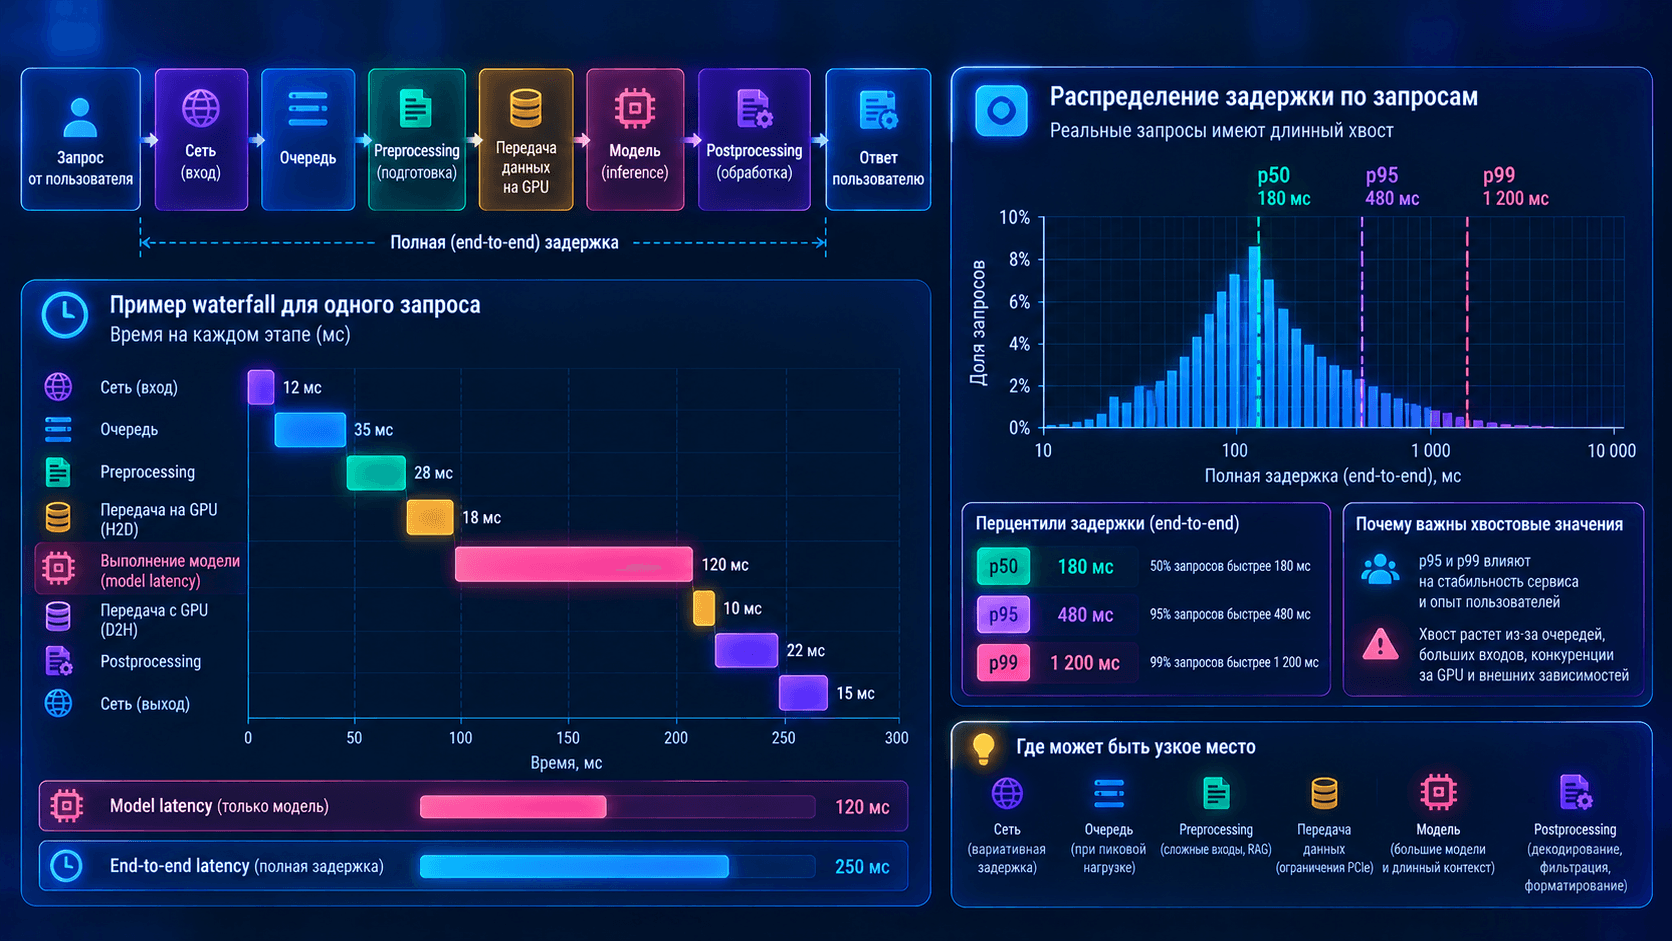
Как измеряют скорость инференса
Одна цифра не описывает производительность. Нужен набор метрик, соответствующий сценарию.
Метрика | Что показывает | Типичная ошибка |
|---|---|---|
Model latency | время прямого прохода | выдавать его за полную задержку сервиса |
End-to-end latency | время от отправки запроса до полного ответа | смотреть только среднее значение |
Queue time | ожидание worker или места в batch | считать очередь работой GPU |
Throughput | число результатов, кадров или токенов за единицу времени | не фиксировать batch и качество |
Concurrency | число одновременно обслуживаемых запросов | путать с requests per second |
p50 | медианная задержка | игнорировать медленный хвост |
p95 и p99 | задержка большинства и редких медленных запросов | измерять на слишком коротком тесте |
Goodput | доля работы, выполненная в пределах SLA и качества | считать любой завершенный ответ полезным |
Utilization | занятость GPU, CPU и памяти | считать высокий процент гарантией throughput |
Полную задержку удобно представить как сумму:
T_e2e = T_network + T_queue + T_preprocess + T_transfer + T_model + T_postprocess + T_serialize
Метрики LLM
Для LLM выделяют time to first token, time per output token, inter-token latency, output tokens per second, total token throughput и end-to-end latency. Первые три описывают пользовательское ожидание и плавность генерации, общая пропускная способность показывает емкость сервера.
Подробная методика приведена в статье как измерить производительность LLM-сервера: TTFT, задержки и throughput.
Метрики компьютерного зрения
Для классификации и detection используют изображения или кадры в секунду, latency одного кадра, поддерживаемый batch и качество модели. В потоковой системе добавляют decode, tracking, число камер и end-to-end задержку до события.
Метрики речи и генерации изображений
Для ASR применяют real-time factor и word error rate. Для генерации изображений измеряют время на изображение или images per minute при зафиксированных разрешении, числе sampling steps, sampler и критерии качества. Сравнение без этих условий недостоверно.
От чего зависит скорость инференса
Архитектура и размер модели
Число параметров влияет на объем весов, но не полностью описывает вычисления. Важны типы слоев, число операций, memory access, активные параметры MoE, длина последовательности и возможность fusion. Две модели одинакового размера могут иметь разную latency.
Размер и форма входа
Для vision нагрузку меняют разрешение, число кадров и число объектов. Для текста важна длина последовательности. Для speech учитываются длительность аудио, chunk size и streaming mode. Dynamic shapes иногда требуют отдельных optimization profiles или вызывают дополнительную компиляцию.
Длина выхода
В классификации выход мал. В autoregressive LLM каждый следующий токен требует нового шага decode. В diffusion generation время зависит от числа итераций denoising. Поэтому одинаковый input не означает одинаковое время запроса.
Precision и квантование
FP16, BF16, FP8, INT8, INT4 и другие режимы уменьшают объем данных и могут ускорить поддерживаемые операции. Выигрыш зависит от GPU, kernels и архитектуры модели. Квантование проверяют по качеству на целевой выборке. Меньшая битность без аппаратной поддержки или с большим числом conversions может не дать ожидаемого ускорения.
CPU, GPU, NPU и другие ускорители
CPU подходит для небольших моделей, нерегулярной логики и низкой нагрузки. GPU эффективен при большом объеме параллельных tensor operations. NPU и специализированные ASIC полезны в поддерживаемых моделях и форматах. Выбор определяют latency, throughput, память, энергопотребление, стоимость и совместимость, а не название класса устройства.
Базовые различия вычислителей раскрыты в материале GPU: как работает и чем отличается от CPU.
Пропускная способность и объем памяти
Модель должна помещаться вместе с activations, рабочими буферами и cache. Если веса постоянно переносятся между RAM и VRAM, latency растет. Для memory-bound workload важна bandwidth, а не только число вычислительных блоков.
Batch size и concurrency
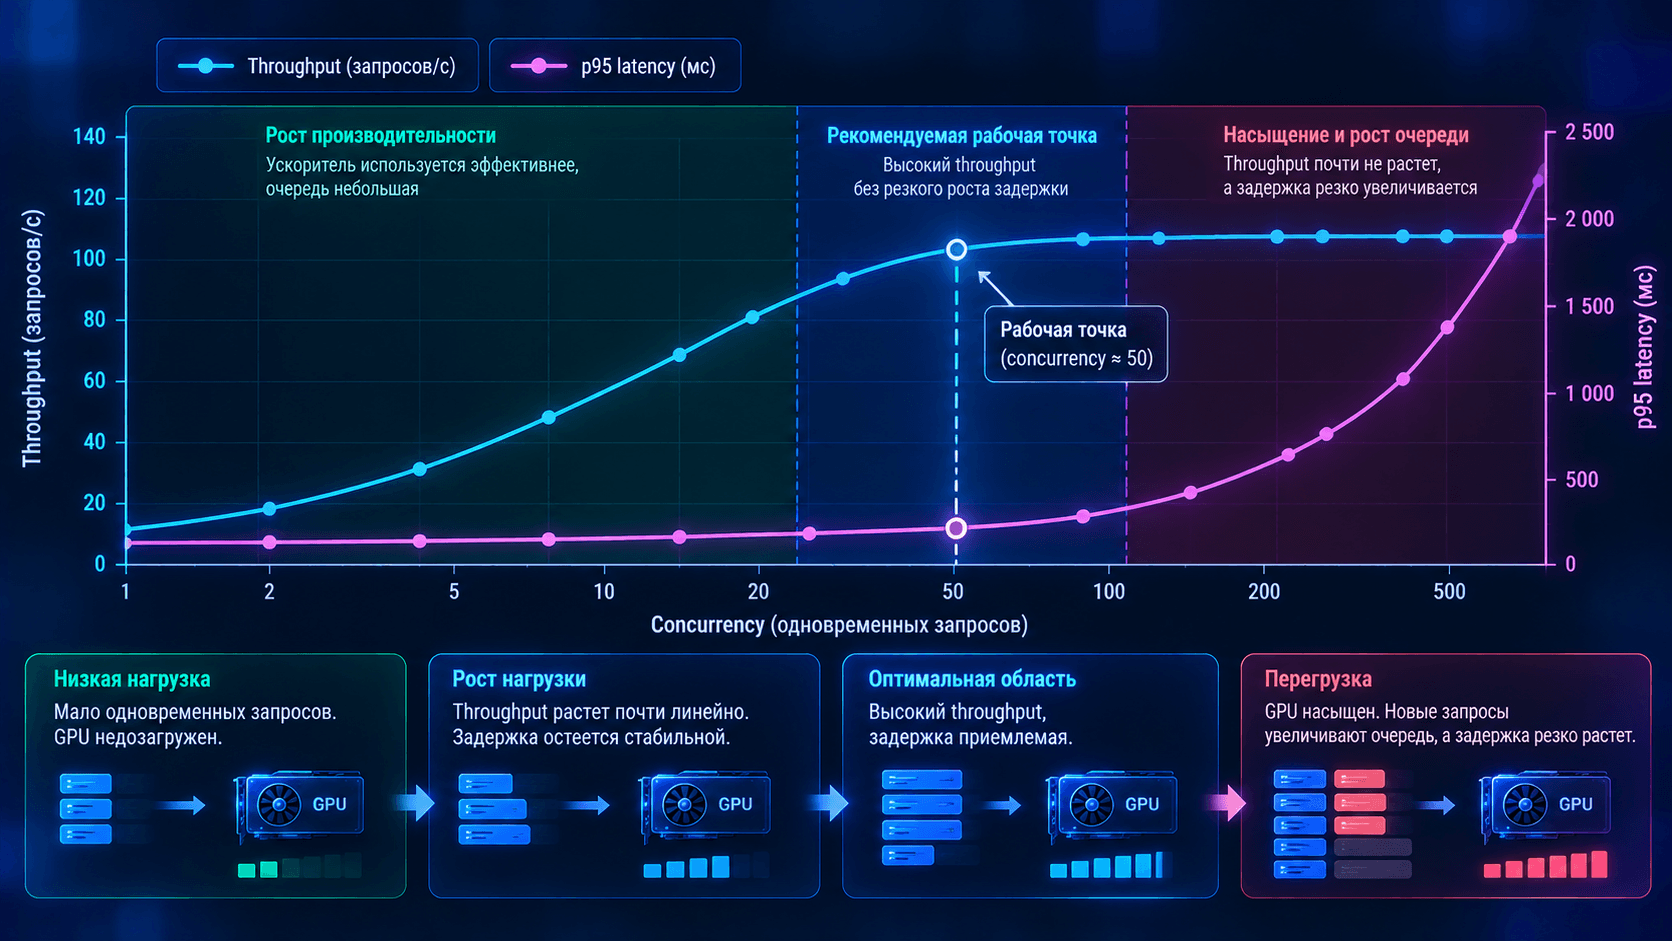
Большой batch обычно повышает общую эффективность GPU, но требует памяти и может задерживать отдельный запрос. Concurrency позволяет scheduler заполнять устройство работой. После точки насыщения новые запросы увеличивают очередь, а throughput перестает расти.
Runtime и kernels
PyTorch eager mode удобен для разработки, но специализированный runtime способен применить operator fusion, graph optimization, layout selection, kernel autotuning, CUDA graphs и memory planning. Результат зависит от модели и версии стека, поэтому нужен benchmark до и после преобразования.
Передача данных и preprocessing
Декодирование изображений, токенизация, resampling audio, JSON parsing, копирование tensors и синхронизация потоков часто выполняются вне основного GPU-графа. Если GPU простаивает в ожидании CPU, покупка более мощного ускорителя проблему не решит.
Multi-GPU и сеть
Если модель распределена между несколькими GPU, часть времени уходит на обмен. Внутри сервера имеют значение PCIe, NVLink, topology и NUMA. Между узлами добавляются network latency, bandwidth и коллективные операции. Малую модель иногда быстрее обслуживают независимые replicas, чем один распределенный экземпляр.
Температура и лимит мощности
Частоты снижаются при перегреве или power cap. Нестабильные результаты benchmark могут быть связаны с охлаждением, частотами и shared workload, а не с изменением модели. Для production фиксируют состояние оборудования и длительность теста.
Latency и throughput: почему нельзя получить максимум одновременно
Интерактивному сервису нужен быстрый ответ отдельному пользователю. Пакетной обработке важнее максимальное число результатов за час. Настройки для этих целей различаются.
Dynamic batching собирает несколько запросов и эффективнее загружает GPU. Если scheduler ждет заполнения batch, latency первых запросов растет. Если он отправляет каждый вход сразу, пользователь получает ответ быстрее при низкой нагрузке, но общая эффективность может снизиться.
Компромисс ищут нагрузочным тестом:
Задают допустимые p95 и p99 latency.
Увеличивают concurrency по профилю реального трафика.
Настраивают max batch, queue delay и число model instances.
Находят точку, после которой очередь растет быстрее throughput.
Проверяют качество, память, энергопотребление и устойчивость длительного прогона.
Особенности инференса LLM
Инференс LLM разделяется на prefill и decode.
Во время prefill модель обрабатывает prompt, системные инструкции, историю и RAG-контекст. Чем длиннее input, тем больше работа до первого токена. Во время decode модель генерирует продолжение последовательно и читает KV cache предыдущих позиций.
На производительность влияют:
размер и архитектура LLM;
input tokens и output tokens;
число KV heads и размер KV cache;
batch и число active sequences;
precision весов и cache;
tensor parallelism и связь между GPU;
continuous batching и scheduler;
prefix caching;
speculative decoding;
требования к TTFT и ITL.
Вес модели отвечает только на часть вопроса о VRAM. Длинный контекст и параллельные запросы способны занять большой объем памяти под KV cache. Расчет приведен в руководстве как рассчитать VRAM для LLM.
Инференс компьютерного зрения и речи
В computer vision скорость одной нейросети не равна скорости полного pipeline. Видеопоток нужно принять, декодировать, преобразовать, собрать в batch, обработать моделью, выполнить NMS или segmentation postprocessing, tracking и правила события.
Если камера передает 30 кадров в секунду, модель не обязательно должна анализировать каждый кадр. Частоту inference выбирают по динамике объекта и требуемой реакции. Пропуск кадров снижает нагрузку, но может пропустить короткое событие.
Архитектура полного контура описана в статье компьютерное зрение: задачи и применение. Для распознавания речи дополнительно учитывают chunking аудио, voice activity detection, streaming, количество каналов и real-time factor.
Как ускорить инференс без неконтролируемой потери качества
1. Зафиксировать baseline
Сохраните модель, dataset или набор запросов, hardware, software versions, precision, shapes, batch, concurrency и метрики качества. Без одинакового baseline нельзя понять эффект оптимизации.
2. Разложить end-to-end latency
Отдельно измерьте queue, preprocessing, transfer, model execution и postprocessing. Профилируйте CPU и GPU timeline. Оптимизируйте самый дорогой этап, а не самый заметный компонент спецификации.
3. Включить корректный inference mode
Переведите модель в evaluation mode и отключите autograd там, где это допустимо. Проверьте, что output совпадает с эталоном и pipeline не использует inference tensors в обучаемом участке.
4. Оптимизировать граф и runtime
Проверьте operator fusion, constant folding, memory planning, I/O binding, CUDA graphs, скомпилированные engines и подходящий execution provider. Не все операции поддерживаются ускорителем. Незаметный fallback на CPU способен замедлить весь граф.
5. Выбрать precision
Сравните FP32 с поддерживаемыми lower-precision режимами. Для квантования нужен calibration или другой предусмотренный методом процесс, затем проверка accuracy, редких классов и устойчивости численных операций.
6. Настроить batching и scheduler
Подберите batch и queue delay под целевой SLA. Для LLM проверьте continuous batching, пределы активных токенов и preemption. Для stateful sequence нельзя автоматически применять правила stateless classifier.
7. Устранить лишние копирования
Сведите к минимуму conversions между layouts, dtype и devices. Используйте pinned memory, asynchronous transfer или device tensors только после измерения и при поддержке runtime.
8. Прогреть сервис
Cold start включает загрузку модели, выделение памяти, JIT compilation и заполнение cache. Разделяйте cold и warm latency. Для autoscaling учитывайте время появления готовой replica.
9. Проверить тепловой режим
Длительный тест выявляет throttling, который не виден в коротком прогоне. Одновременно контролируйте power, temperature, clocks, ECC errors и память.
10. Повторить тест на рабочем трафике
Синтетический одинаковый input удобен, но скрывает dynamic shapes, длинные prompts и тяжелые случаи. Финальный прогон должен воспроизводить распределение размеров, concurrency и arrival pattern production.
Почему GPU иногда медленнее CPU
GPU дает преимущество, когда работа достаточно крупная и параллельная. На малой модели с batch 1 время копирования, запуска kernels и синхронизации способно превысить выигрыш вычисления. Причиной также бывает CPU fallback неподдерживаемой операции, медленный preprocessing или неоптимальный layout.
Локальный, облачный или edge-инференс
Критерий | Локальный сервер | Облачный API | Edge-устройство |
|---|---|---|---|
Контроль данных | высокий при правильной архитектуре | зависит от договора и сервиса | данные можно обработать у источника |
Старт | нужна инфраструктура | обычно быстрый пилот | нужна интеграция с устройством |
Масштабирование | закупка или резерв мощностей | квоты и тариф провайдера | ограничено каждым устройством |
Задержка | контролируется локальной сетью и нагрузкой | зависит от сети и внешнего endpoint | минимальный путь до источника |
Эксплуатация | полностью у владельца | значительная часть у провайдера | распределенное обновление и мониторинг |
Стоимость | зависит от загрузки и TCO | переменная оплата | включает парк устройств и обслуживание |
Локальный инференс оправдан при требованиях к данным, предсказуемой высокой нагрузке, автономности, фиксированной версии или низкой сетевой задержке. Облачный API удобен для эксперимента и нерегулярной нагрузки. Edge выбирают, когда решение нужно рядом с источником и канал нельзя считать надежным.
Как выбрать оборудование для инференса
Выбор начинается с workload, а не с модели видеокарты. Для расчета нужны:
Название и revision модели.
Precision или вариант quantization.
Формы и размеры входа.
Длина выхода для генеративных моделей.
p50, p95 и p99 latency.
Requests per second и пиковая concurrency.
Batch policy и допустимое ожидание в очереди.
Требования к качеству и воспроизводимости.
Размер весов, activations, buffers и cache.
Требования к отказоустойчивости и росту нагрузки.
Для небольшого локального пилота важны простота, память и поддержка программного стека. NVIDIA DGX Spark GB10 представляет компактный класс AI-систем, но пригодность для конкретного инференса определяется моделью, precision, context и измеренным SLA.
Для энергоэффективного serving, video analytics и нескольких компактных моделей можно рассматривать ускорители класса NVIDIA L4 24 ГБ. Пассивная карта требует рассчитанного серверного воздушного потока и совместимого шасси.
Крупная LLM, длинный контекст и высокая параллельность требуют другого объема VRAM и масштаба. Примером плотной системы служит Dell PowerEdge XE9680 с восемью NVIDIA H200. Это пример класса, а не универсальная рекомендация.
Типичные ошибки при развертывании инференса
Сравнивать GPU по peak FLOPS без теста модели.
Выдавать model latency за пользовательскую задержку.
Измерять среднее и не смотреть p95, p99 и очередь.
Менять precision без проверки качества.
Подбирать оборудование только по размеру весов.
Не учитывать preprocessing, postprocessing и transfer.
Тестировать batch 1, хотя production требует высокой concurrency.
Показывать offline throughput вместо интерактивного SLA.
Не прогревать runtime или смешивать cold и warm результаты.
Игнорировать CPU fallback, NUMA, PCIe topology и thermal throttling.
Считать, что добавление второй GPU всегда удвоит скорость.
Запускать на одном сервере обучение и production без изоляции ресурсов.
FAQ
Что значит инференс?
Это применение обученной модели к новым данным для получения предсказания или сгенерированного результата. Во время обычного инференса веса не обновляются.
Что такое инференс в ИИ?
Инференс в искусственном интеллекте представляет этап, на котором готовая модель используется внутри приложения: принимает вход, выполняет вычисление и возвращает результат.
Что такое инференс нейросети?
Это прямой проход нового входа через нейросеть с зафиксированными параметрами. Выходом может быть класс, число, вектор, изображение, текст или другая структура.
Чем инференс отличается от обучения?
Обучение рассчитывает ошибку и изменяет веса. Инференс использует уже полученные веса. Поэтому ему обычно не нужны gradients и optimizer states, но остаются требования к памяти для весов, activations, buffers и cache.
Что такое инференс LLM?
Это обработка prompt и последовательная генерация выходных токенов большой языковой моделью. Производительность разделяют на prefill и decode, а измеряют через TTFT, TPOT, ITL и throughput.
Что такое локальный инференс?
Это запуск модели на инфраструктуре организации или собственном устройстве без обязательного обращения к внешнему AI API. Владелец получает больше контроля, но отвечает за оборудование и эксплуатацию.
От чего зависит скорость инференса?
От модели, входа и выхода, precision, CPU или GPU, памяти, batch, concurrency, runtime, kernels, передачи данных, preprocessing, очереди и температурного режима.
Что такое время инференса?
В узком смысле это время вычисления модели. В пользовательском смысле нужно считать end-to-end latency, включая сеть, очередь, обработку данных, выполнение модели и формирование ответа.
Какая видеокарта нужна для инференса?
Универсальной модели нет. Сначала проверяют объем памяти, поддерживаемый precision, latency и throughput на целевой модели. Затем учитывают форм-фактор, охлаждение, питание, software stack и план роста.
Можно ли выполнять инференс без GPU?
Да. Небольшие модели и редкие запросы можно обслуживать на CPU. GPU оправдан, когда он дает измеримый выигрыш по SLA, пропускной способности, плотности или стоимости результата.
Подходит ли DGX Spark для инференса?
Он относится к компактным AI-системам и может использоваться для локальных задач, если модель и workload соответствуют доступной памяти и производительности. Решение подтверждают на точной версии модели, runtime и реальном профиле запросов.
Что передать для расчета инференс-сервера
Подготовьте модель и revision, precision, примеры входов, распределение их размеров, длину выхода, пиковую concurrency, целевые p95 и p99, ожидаемый рост и требования к отказоустойчивости. Если baseline уже работает, приложите queue time, model latency, throughput, utilization и расход памяти.
Start Server может провести подбор и нагрузочную проверку оборудования под LLM, computer vision, speech, embeddings или другую модель. Передать данные можно через контакты Start Server. Конфигурация считается подтвержденной только после теста целевого pipeline, а не по паспортным характеристикам ускорителя.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


