Сервер с восемью GPU не обязательно требует 1 TB оперативной памяти. И наоборот: системе с двумя или четырьмя GPU может оказаться мало 256 GB RAM, если подготовка данных создаёт большой host-side working set.
Причина в том, что объём системной памяти определяется не количеством GPU как таковым, а тем, что происходит с данными до передачи на ускоритель.
Один pipeline читает заранее подготовленные tensors с NVMe. Другой одновременно декодирует изображения или видео, выполняет CPU augmentation в десятках процессов, держит несколько batches в prefetch queue и использует pinned memory для передачи данных на GPU.
GPU могут быть одинаковыми. Требование к RAM — совершенно разным.
Поэтому правило вроде:
RAM = 2 × суммарная VRAMнельзя использовать как универсальную формулу.
Практический порядок другой:
Dataset
   ↓
Dataset / metadata state
   ↓
DataLoader workers
   ↓
decode / tokenize / transform
   ↓
prefetched batches
   ↓
pinned host buffers
   ↓
H2D transfer
   ↓
GPUСколько RAM нужно GPU-серверу: короткий ответ
Сценарий | Что прежде всего влияет на RAM |
|---|---|
Готовые tensors читаются потоково | batch, prefetch, process footprint |
JPEG/video декодируются на CPU | decoded data и временные buffers |
Много DataLoader workers | worker/Dataset state и prefetch |
Большой | больше batches готовятся ahead of time |
| page-locked host memory |
Несколько DDP ranks | несколько training processes и их data pipelines |
Dataset кэшируется приложением | размер фактического in-memory cache |
Используется CPU offload | parameters/optimizer state в host RAM |
Dataset больше RAM | само по себе допустимо при streaming |
Короткий вывод:
RAM и VRAM — не одно и то же
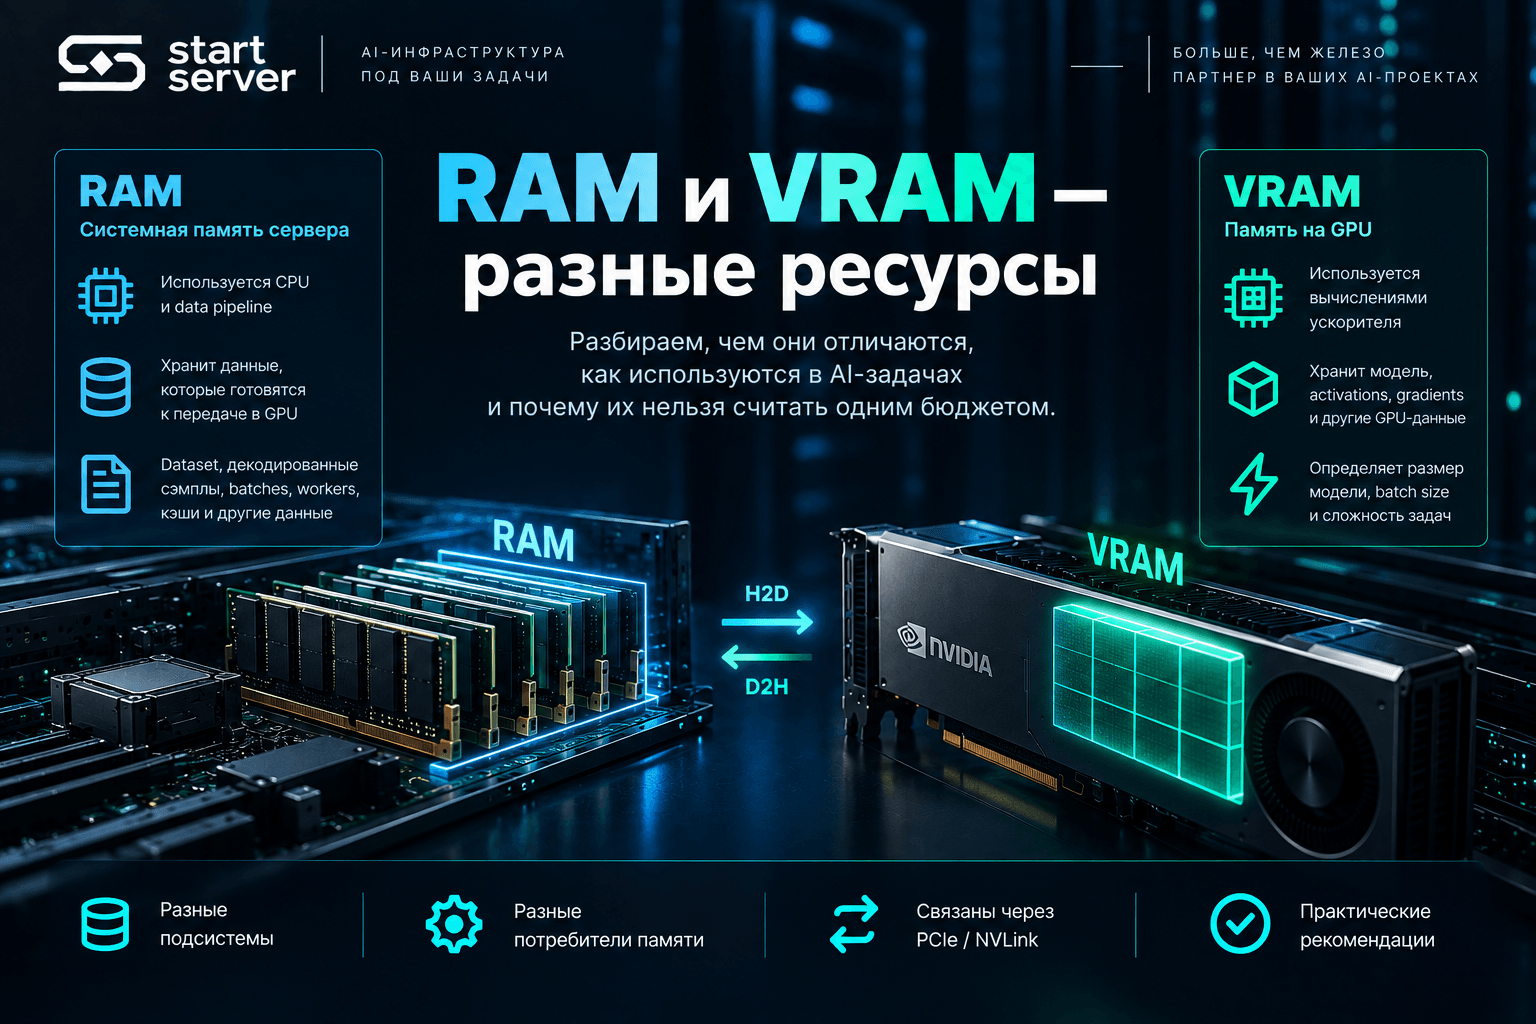
VRAM находится на ускорителе. Там живут GPU tensors, model states и другие данные, необходимые непосредственно GPU workload.
RAM — память хоста. В ней могут находиться Dataset metadata, Python objects, decoded samples, DataLoader worker state, готовые batches, pinned memory, filesystem cache и при определённых схемах — offloaded model/optimizer states.
Поэтому конфигурация:
8 GPU × 80 GB = 640 GB суммарной VRAMничего автоматически не говорит о том, должно ли в сервере стоять 256 GB, 512 GB или 1 TB системной памяти.
RAM и VRAM нужно рассчитывать отдельно.
Полный размер датасета не определяет требуемую RAM
Предположим, dataset занимает 5 TB.
Из этого не следует:
RAM ≥ 5 TBПри streaming pipeline одновременно в оперативной памяти находится только текущий working set.
Полезно разделять четыре понятия:
Величина | Что она означает |
|---|---|
Dataset size | полный объём данных на storage |
Working set | данные, активно используемые сейчас |
Prefetch window | batches, подготовленные заранее |
Explicit cache | данные, которые приложение сознательно сохраняет в RAM |
Отдельно Linux может использовать свободную RAM как filesystem page cache.
Поэтому большой dataset вполне может обрабатываться на машине с гораздо меньшим объёмом RAM, если приложение не пытается целиком загрузить его в память.
Главный вопрос другой:
Размер файла и размер данных после decode — разные величины
Compressed object на накопителе может занимать гораздо меньше памяти, чем его рабочее представление.
Для изображения путь может выглядеть так:
JPEG
 ↓
decoded image
 ↓
augmentation
 ↓
float tensor
 ↓
batch
Размер JPEG-файла не определяет размер final tensor.
То же самое относится к video, audio и некоторым columnar datasets.
Кроме того, во время preprocessing старое и новое представления данных могут частично существовать одновременно. Поэтому коэффициент вида:
RAM = dataset size × 1.5не имеет универсального смысла.
Для sizing гораздо полезнее измерить batch после тех transform, которые реально будут использоваться.
Как посчитать размер tensor batch
Для обычного dense PyTorch tensor:
Tensor bytes =
numel × element_size
Tensor.nbytes в PyTorch определяется именно как numel() × element_size() для соответствующего tensor representation.
Возьмём учебный пример.
Batch:
32 изображения
3 канала
1024 × 1024
float32
Расчёт:
32 × 3 × 1024 × 1024 × 4 bytes
= 402 653 184 bytes
= 384 MiB
То есть raw tensor payload одного готового batch — 384 MiB.
Это ещё не RAM всего DataLoader.
В памяти одновременно могут находиться Dataset state, промежуточные результаты decode/transform и другие batches.
Но теперь у нас появился конкретный измеримый компонент pipeline.
Как num_workers влияет на RAM
При num_workers=0 PyTorch выполняет data loading внутри основного процесса. Положительное значение включает multi-process loading с указанным числом worker subprocesses.
Workers нужны не бесплатно.
PyTorch отдельно предупреждает, что после нескольких итераций loader workers способны потреблять значительный объём CPU memory из-за Python objects родительского процесса, к которым они обращаются. Типичный проблемный случай — большой Python list filenames или metadata, созданный в Dataset.__init__.
Это означает, что:
RAM DataLoader = batch × num_workers— неправильная модель.
Worker может удерживать не только batch, но и Dataset state, Python state и данные, находящиеся на разных стадиях preprocessing.
При этом нельзя впадать и в противоположную крайность и автоматически умножать весь RSS parent process на количество workers. Реальный memory sharing зависит от multiprocessing model и конкретных объектов.
Как prefetch_factor меняет рабочий набор
Здесь есть уже более конкретная арифметика.
В актуальном PyTorch prefetch_factor — это количество batches, которое каждый worker загружает заранее. При num_workers>0 default сейчас равен 2; сама документация поясняет, что prefetch_factor=2 означает до 2 × num_workers prefetched batches across workers.
Пусть:
num_workers = 8
prefetch_factor = 2
Тогда:
8 × 2 = 16 prefetched batchesВернёмся к batch с raw payload 384 MiB.
Оценка payload prefetch window:
16 × 384 MiB
= 6144 MiB
= 6 GiB
Это уже заметный объём.
Но читать результат нужно правильно:
В эту величину не входят worker state, Dataset metadata, промежуточные allocations transforms, pinned memory и прочие расходы.
Сравним с другой конфигурацией:
num_workers = 4
prefetch_factor = 1
Тогда raw prefetch payload:
4 × 384 MiB
= 1.5 GiB
Один этот компонент уменьшился в четыре раза — хотя GPU, dataset и размер одного batch не изменились.
Больше workers — не обязательно быстрее
Увеличивать num_workers до количества CPU cores без измерений не стоит.
PyTorch рекомендует подбирать этот параметр профилированием: workers способны ускорять expensive CPU transforms и I/O, но слишком большое число processes расходует CPU memory и другие системные ресурсы. В свежем руководстве прямо предлагается увеличивать workers до момента, когда throughput перестаёт улучшаться.
Практический цикл выглядит так:
num_workers ↑
       ↓
Data throughput улучшился?
       ↓
GPU waiting уменьшился?
       ↓
RAM peak остаётся приемлемым?
Если переход с 8 на 16 workers почти не уменьшает простой GPU, дополнительное потребление RAM уже не приносит сопоставимой пользы.
Поэтому DataLoader сначала настраивается по throughput, и только после этого его рабочая конфигурация фиксируется как вход для RAM sizing.
Что меняет persistent_workers=True
По умолчанию DataLoader worker processes завершаются после того, как соответствующий iterator перестаёт использоваться. persistent_workers=True сохраняет workers и их Dataset instances живыми для дальнейших проходов.
Это может уменьшить повторные startup costs между эпохами.
Для RAM sizing важен другой эффект:
Но правила:
persistent_workers=True → RAM × 2не существует.
Меняется lifetime allocations, а фактический объём нужно измерять на вашем Dataset и loader configuration.
Pinned memory — это системная RAM
При pin_memory=True DataLoader возвращает tensors в pinned, или page-locked, host memory. Такая память не является VRAM.
Pinned host memory полезна для передачи данных на GPU: page-locked source позволяет эффективнее использовать DMA и в подходящей схеме — asynchronous H2D transfers.
То есть:
Pinned memory → RAM
GPU tensors   → VRAM
это два разных бюджета.
При этом page-locked memory нельзя рассматривать как бесплатную оптимизацию. Она не может обычным образом вытесняться в swap, поэтому чрезмерное pinning увеличивает давление на физическую RAM.
Но и формула:
pin_memory=True → batch memory × 2неверна как универсальное правило.
Фактический peak зависит от того, сколько pageable и pinned buffers одновременно существует в конкретной реализации.
Почему /dev/shm может закончиться при свободной RAM
При num_workers>0 данные передаются между worker processes и основным процессом через multiprocessing mechanisms, включающие shared memory.
PyTorch отдельно описывает ошибки вида unable to open shared memory object и Unexpected bus error encountered in worker при исчерпании доступного /dev/shm; среди способов снизить давление указаны уменьшение num_workers, prefetch_factor и batch size.
Поэтому ситуация:
вполне возможна, особенно в containerized environment с ограниченным /dev/shm.
Однако /dev/shm — не отдельные физические гигабайты поверх RAM. Это тоже memory-backed storage.
При расчёте общего потребления его нельзя прибавлять второй раз к уже учтённому memory usage.
Почему маленький MemFree ещё не означает нехватку RAM
Linux старается использовать свободную память продуктивно, в том числе для filesystem cache.
Поэтому:
MemFree = малосамо по себе не доказывает memory pressure.
Kernel определяет MemAvailable как оценку памяти, доступной для запуска новых приложений без swapping, учитывая reclaimable resources и необходимый системе запас.
Для наблюдения GPU training node полезнее смотреть вместе:
MemAvailable
swap activity
memory pressure / OOM events
workload peak
а не только MemFree.
Высокий Cached также не означает автоматически «потерянную RAM». File cache может быть reclaimable и одновременно ускорять повторное чтение dataset.
Почему нельзя сложить RSS всех Python-процессов
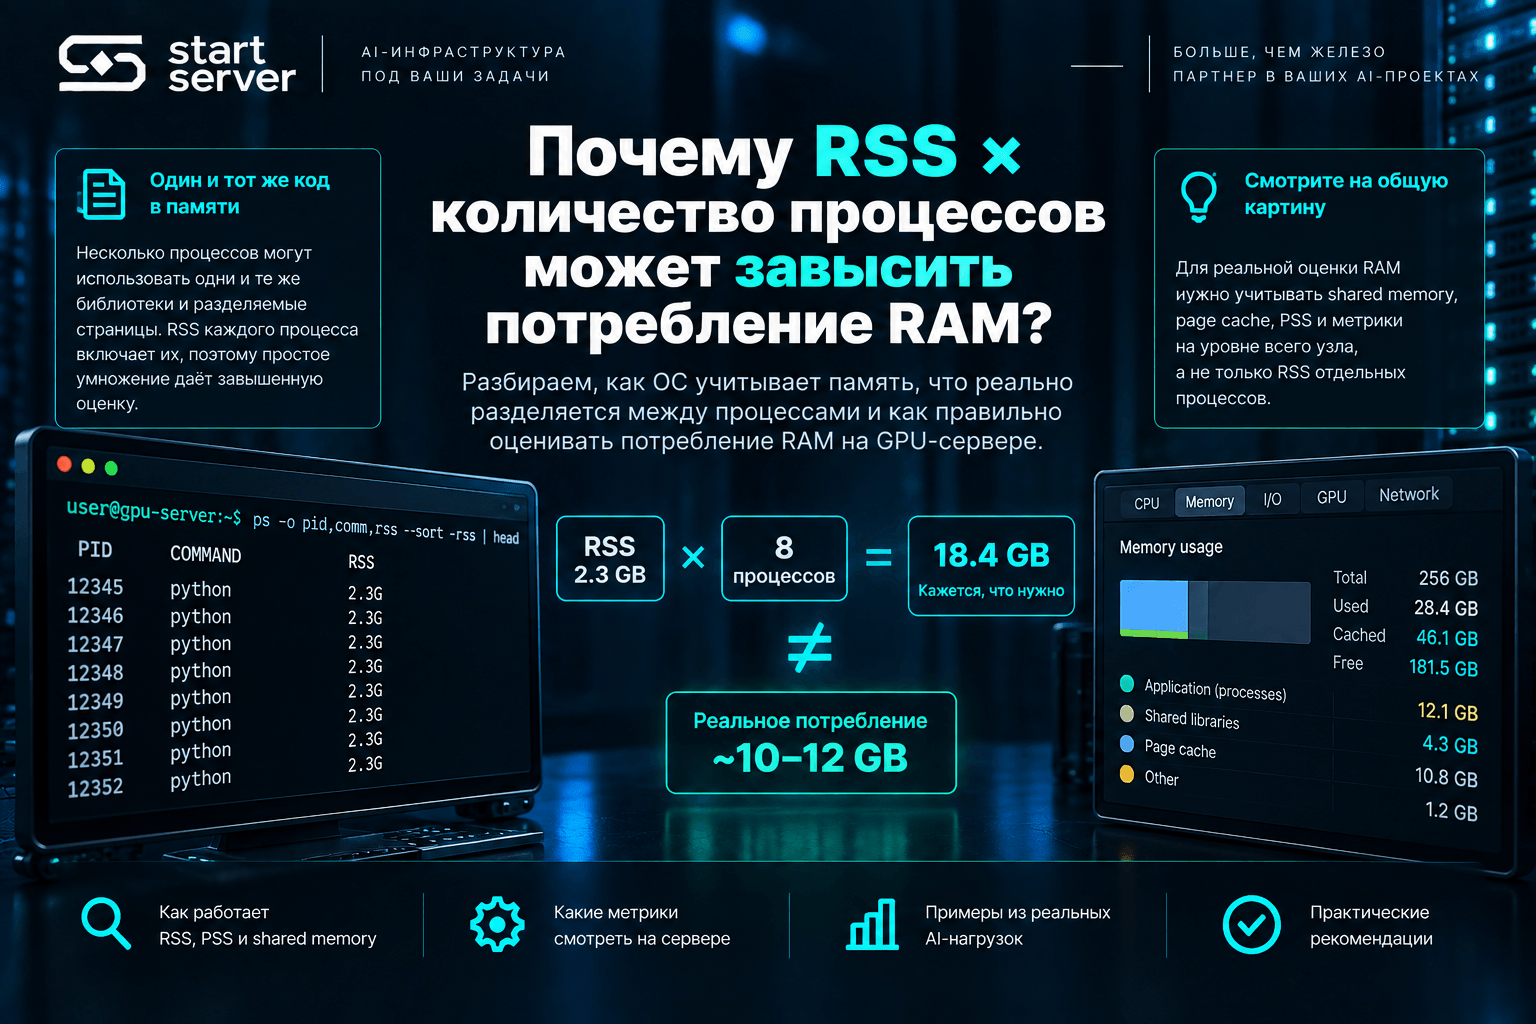
Пусть восемь процессов показывают:
20 GB RSS каждыйПростое:
8 × 20 = 160 GBможет завысить реально уникальную физическую память.
Причина — shared mappings. Одна и та же физическая page может входить в RSS нескольких процессов.
Для диагностики Linux предоставляет PSS — Proportional Set Size. Shared pages в PSS распределяются пропорционально между использующими их процессами. /proc/<PID>/smaps_rollup дополнительно показывает Pss_Anon, Pss_File и Pss_Shmem.
Поэтому:
Для подбора RAM лучше измерять весь process tree как единый workload.
Почему 8 GPU могут неожиданно превратиться в десятки loader workers
В стандартной single-node DDP-конфигурации PyTorch рекомендует отдельный process на каждую GPU.
Предположим:
8 GPU
→
8 DDP ranks
И каждый rank создаёт:
DataLoader(num_workers=8)Если приложение действительно построено таким образом, получаем:
8 ranks × 8 workers
= 64 loader worker processes
Это не означает, что любой 8-GPU training job имеет 64 workers.
Это следствие конкретной конфигурации приложения.
Но именно поэтому запись:
num_workers = 8без контекста недостаточна.
Нужно знать:
Для RAM sizing разница принципиальна.
Как измерять память всего training job
Если возможно, training job полезно поместить в отдельный Linux cgroup v2 или scope контейнера и наблюдать его как один workload.
В cgroup v2 доступны, в частности:
memory.current
memory.peak
memory.stat
memory.events
memory.current показывает текущую память cgroup и descendants, а memory.peak — зафиксированный максимальный usage. Memory controller также учитывает page cache, anonymous memory и ряд kernel resources.
Получается удобное разделение:
Whole-job current/peak
→ capacity sizing

PSS отдельных processes
→ поиск источника расхода
Это существенно надёжнее ручного сложения значений из ps или htop.
Что означают anon, file и shmem
memory.stat помогает разобраться, из чего состоит memory pressure.
Поле | Практический смысл |
|---|---|
| anonymous process memory |
| filesystem cache, включая tmpfs/shared memory |
| более узкая детализация shared/tmpfs memory |
| общий текущий usage cgroup |
| maximum recorded usage |
Важная особенность Linux accounting: file уже включает tmpfs и shared memory. shmem является детализацией этой области.
Поэтому нельзя считать:
total = file + shmemкак сумму независимых видов RAM.
Тем более нельзя брать:
memory.current
+ file
+ shmem
memory.current уже является общей метрикой.
Breakdown объясняет структуру consumption, а не набор чисел для повторного суммирования.
CPU offload требует отдельного RAM budget
До этого момента мы обсуждали RAM, которая обслуживает data pipeline.
CPU offload — другая архитектурная причина потребления памяти.
Например, DeepSpeed ZeRO позволяет offload optimizer state и model parameters в CPU memory или NVMe. Для CPU offload также существует отдельная настройка pinned memory.
Следовательно, два workload:
CPU offload = offи:
parameters / optimizer → CPUмогут иметь совершенно разные требования к host RAM при одинаковом Dataset.
Поэтому расчет лучше концептуально разделять:
Data-pipeline RAM
       +
Offloaded model-state RAM
а затем проверять итог единым whole-job measurement.
Не стоит незаметно включать offload в обычную рекомендацию по памяти DataLoader.
RAM capacity и скорость data pipeline — разные вещи
Допустим, в машине 512 GB RAM, а training job на пике использует 180 GB.
При этом GPU периодически простаивают.
Установка ещё 512 GB сама по себе проблему, скорее всего, не диагностирует.
Bottleneck может находиться в CPU decode, storage throughput, network filesystem, NUMA locality или самих transformations.
Свежий PyTorch Data Loading Optimization tutorial наглядно показывает, что эффект num_workers, pinning и других настроек зависит от конкретного bottleneck; даже в их собственном benchmark pin_memory=True почти не дал дополнительного ускорения, когда доминировали CPU transforms. Авторы отдельно предупреждают, что benchmark results зависят от workload и hardware.
Поэтому:
SS-008 отвечает на memory capacity. CPU/NUMA и storage bandwidth нужно проверять отдельными этапами.
В какой момент измерять RAM peak
Одного измерения в случайный момент training loop недостаточно.
Потребление может изменяться по фазам:
Dataset initialization
       ↓
workers start
       ↓
prefetch queues fill
       ↓
steady training
       ↓
heavy samples / long batches
       ↓
validation
       ↓
checkpointing
Нужно включить именно те фазы, которые существуют в реальном workload.
Для sizing интересует:
steady RAM
peak RAM
minimum available memory
swap / OOM behavior
memory.peak полезен именно потому, что фиксирует максимальный usage всего cgroup с descendants.
Но точный memory.peak короткого smoke test всё равно не заменяет репрезентативную нагрузку.
Точное измерение неправильного сценария остаётся неправильным sizing.
Рабочая методика расчёта RAM GPU-сервера
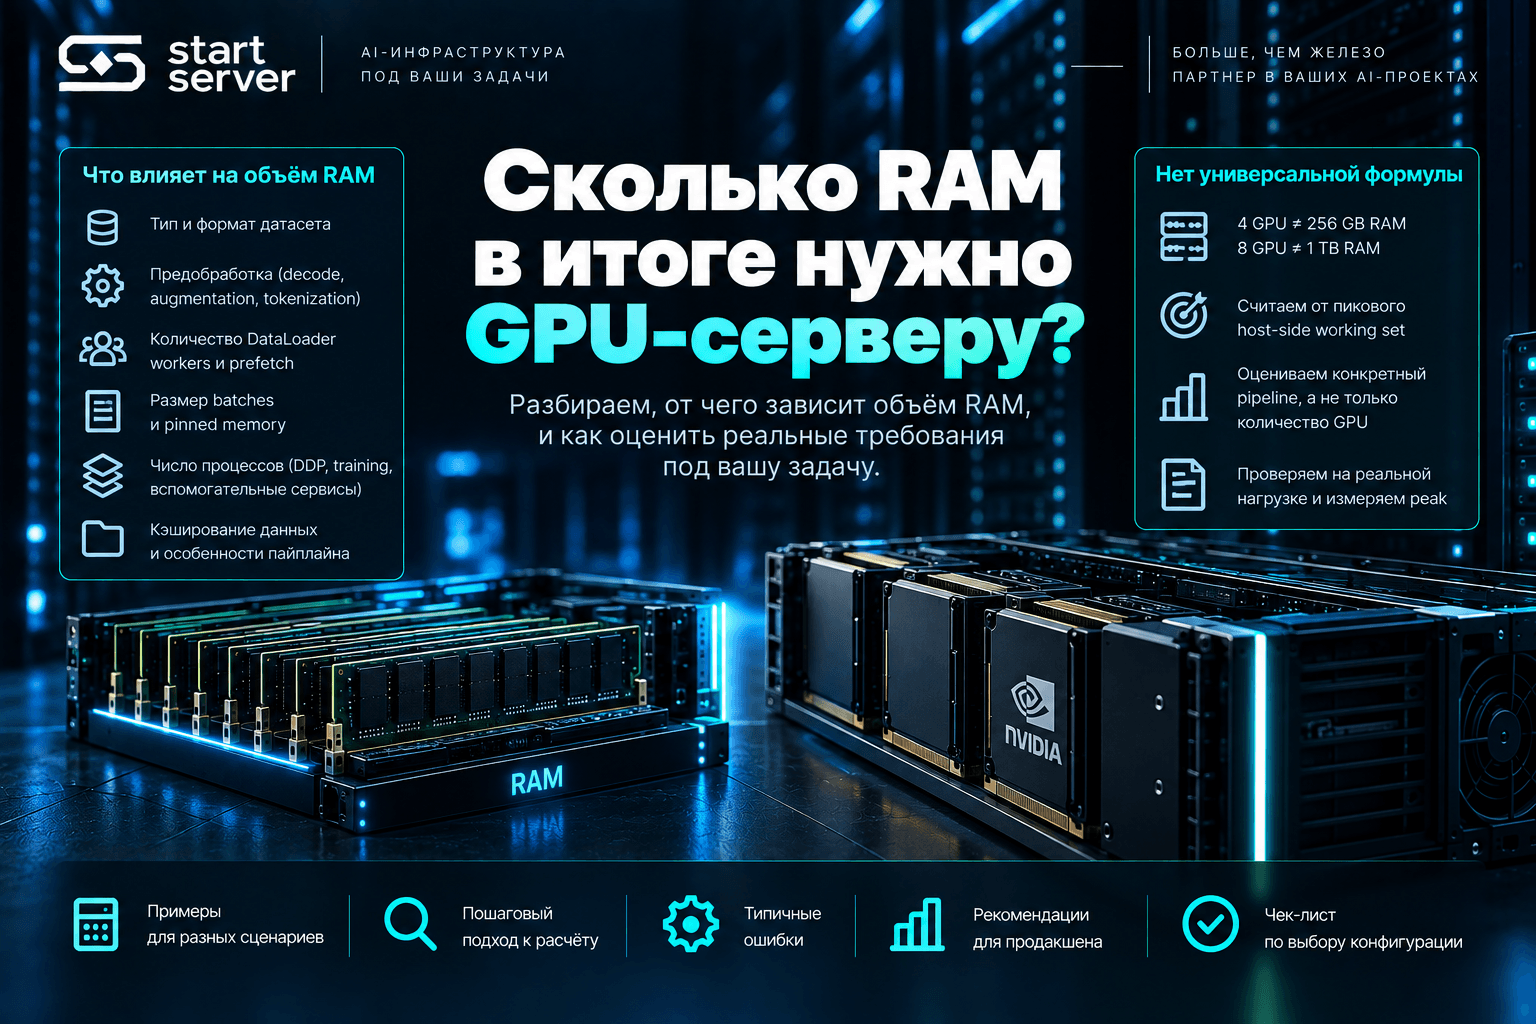
Вместо универсального коэффициента используем следующий процесс:
1. Зафиксировать exact data pipeline
                 ↓
2. Измерить batch после decode/transform
                 ↓
3. Зафиксировать num_workers
                 ↓
4. Зафиксировать prefetch_factor
                 ↓
5. Проверить Dataset/metadata footprint
                 ↓
6. Зафиксировать DDP rank layout
                 ↓
7. Отдельно учесть pinned memory
                 ↓
8. Отдельно учесть CPU offload
                 ↓
9. Запустить Heavy/Limit workload
                 ↓
10. Измерить whole-job memory peak
                 ↓
11. Проверить MemAvailable / swap / OOM
                 ↓
12. Назначить operational reserve
                 ↓
13. Выбрать RAM capacity
                 ↓
14. Проверить DIMM/channel topology сервера
Первые восемь шагов объясняют, откуда возникает memory pressure.
Следующие — показывают, сколько RAM workload потребляет фактически.
Учебный пример: как prefetch меняет расход памяти
Вернёмся к нашему batch:
32 × 3 × 1024 × 1024 × float32
= 384 MiB raw tensor payload
Конфигурация A
num_workers = 8
prefetch_factor = 2

8 × 2 = 16 prefetched batches

16 × 384 MiB
= 6 GiB raw payload
Конфигурация B
num_workers = 4
prefetch_factor = 1

4 × 1 = 4 prefetched batches

4 × 384 MiB
= 1.5 GiB raw payload
Raw prefetch payload отличается в четыре раза.
Это чистая расчётная иллюстрация, а не benchmark Start Server.
И она не означает, что total RAM DataLoader также обязательно будет отличаться ровно в четыре раза. У Dataset, workers, transforms, pinned buffers и остальных компонентов своя memory behavior.
Зато этот пример позволяет заранее понять, почему изменение всего двух настроек может увеличить host-memory pressure на несколько гигабайт.
Какой запас RAM оставлять
Здесь нет хорошего универсального ответа вроде:
Необходимый operational headroom зависит от вариативности samples, качества нагрузочного теста, других сервисов на node, swap policy, будущего увеличения batch/workers и требований к эксплуатации.
Поэтому:
Required installed RAM
=
validated workload requirement
+
explicit operational reserve
Но размер reserve должен быть зафиксированным проектным решением, а не магическим коэффициентом из статьи.
Как перейти к 128, 256, 512 GB или 1 TB
После измерения логика выглядит так:
Heavy workload peak
       ↓
Limit scenario
       ↓
Other resident services
       ↓
Swap policy
       ↓
Operational / growth reserve
       ↓
Required RAM capacity
       ↓
Supported DIMM configuration
И последний пункт нельзя игнорировать.
Серверная память — это не только число гигабайт. Конкретные CPU и motherboard имеют определённое число memory channels, DIMM slots, допустимые типы и схемы установки модулей.
Поэтому итоговый объём нужно набрать так, чтобы он соответствовал документации конкретной платформы и не создавал бессмысленную конфигурацию каналов.
Подробный вопрос CPU, memory channels и NUMA относится уже к следующей статье — SS-009.
Worksheet для sizing системной RAM
DATASET
Format:
Total dataset size:
Metadata/index footprint:
Explicit in-memory cache:

BATCH
Batch size:
Representation after decode:
Tensor dtype:
Measured batch payload:
p50 batch payload:
p95 batch payload:

DATALOADER
num_workers:
prefetch_factor:
persistent_workers:
pin_memory:

PREPROCESSING
Decode:
Tokenization:
CPU transforms / augmentations:
Observed worker memory:

DISTRIBUTED
GPU count:
DDP/training ranks:
DataLoader per rank:
Total loader workers:

OFFLOAD
Parameter CPU offload:
Optimizer CPU offload:
Pinned offload memory:

SYSTEM
/dev/shm limit:
Other permanent services:
Swap policy:

MEASUREMENT
Whole-job steady memory:
Whole-job peak memory:
Minimum MemAvailable:
Swap activity:
OOM / memory events:
PSS of suspiciously large processes:

RESULT
Operational reserve:
Required RAM capacity:
Chosen installed RAM:
DIMM/channel configuration:
Если пока неизвестны num_workers, prefetch_factor, distributed layout и whole-job peak, ответ «нужно 256 или 512 GB» основан преимущественно на предположениях.
Как понять, что добавлять RAM вообще не нужно
Допустим, измерения показывают:
RAM capacity     → далеко от предела
MemAvailable     → остаётся достаточным
Swap             → отсутствует
OOM events       → отсутствуют
но GPU всё равно простаивает.
Это повод прекратить увеличивать RAM и искать реальный bottleneck.
Проверять нужно CPU preprocessing, storage, NUMA locality, network input и сам DataLoader.
Здесь особенно важно не перепутать две задачи:
RAM capacity отвечает: помещается ли host working set.
Дополнительные гигабайты памяти не гарантируют увеличение второго показателя.
Сколько оперативной памяти в итоге нужно GPU-серверу
Универсального соответствия:
2 GPU → 128 GB
4 GPU → 256 GB
8 GPU → 512 GB
не существует.
Для конкретного GPU-сервера сначала нужно определить host-side working set: размер данных после preprocessing, DataLoader workers и prefetch, Dataset state, distributed process layout, pinned buffers, explicit caching и наличие CPU offload.
После этого конфигурацию нужно прогнать на репрезентативном Heavy/Limit workload.
При multiprocessing не стоит определять физическое потребление памяти простой суммой RSS процессов. Для whole-job sizing практичнее использовать групповой memory accounting, например cgroup v2, а PSS отдельных ranks и workers — для диагностики причин расхода.
Затем выбирается эксплуатационный reserve и только после этого — номинал установленной памяти и конкретная DIMM-схема сервера.
Коротко:
Подобрать память под процесс обработки данных
Для подбора нужны формат dataset, размер batch после preprocessing, num_workers, prefetch_factor, число GPU и training ranks, использование pinned memory и CPU offload, а также наблюдаемые steady/peak RAM.
По этим данным можно определить, что именно создаёт host-memory pressure, какой объём RAM требуется workload и как корректно набрать его DIMM на выбранной серверной платформе.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


