Токен в нейросети представляет собой элемент последовательности, с которой работает модель. В текстовой LLM токеном может стать короткое слово, часть слова, знак препинания, пробел, фрагмент байтовой записи или специальная служебная метка. Токен не равен символу и не обязан совпадать с целым словом.
Перед обработкой запроса токенизатор разбивает текст и сопоставляет каждому элементу числовой идентификатор. Модель получает не исходные буквы, а последовательность таких идентификаторов, переводит их в векторные представления и рассчитывает вероятности продолжения. При генерации она выбирает следующий токен, добавляет его к контексту и повторяет вычисление.
Число токенов влияет сразу на несколько параметров системы: доступную длину контекста, стоимость облачного API, время до первого токена, скорость генерации, размер KV cache, расход VRAM и количество параллельных запросов на GPU-сервере. Поэтому считать токены нужно тем токенизатором, который относится к выбранной модели.
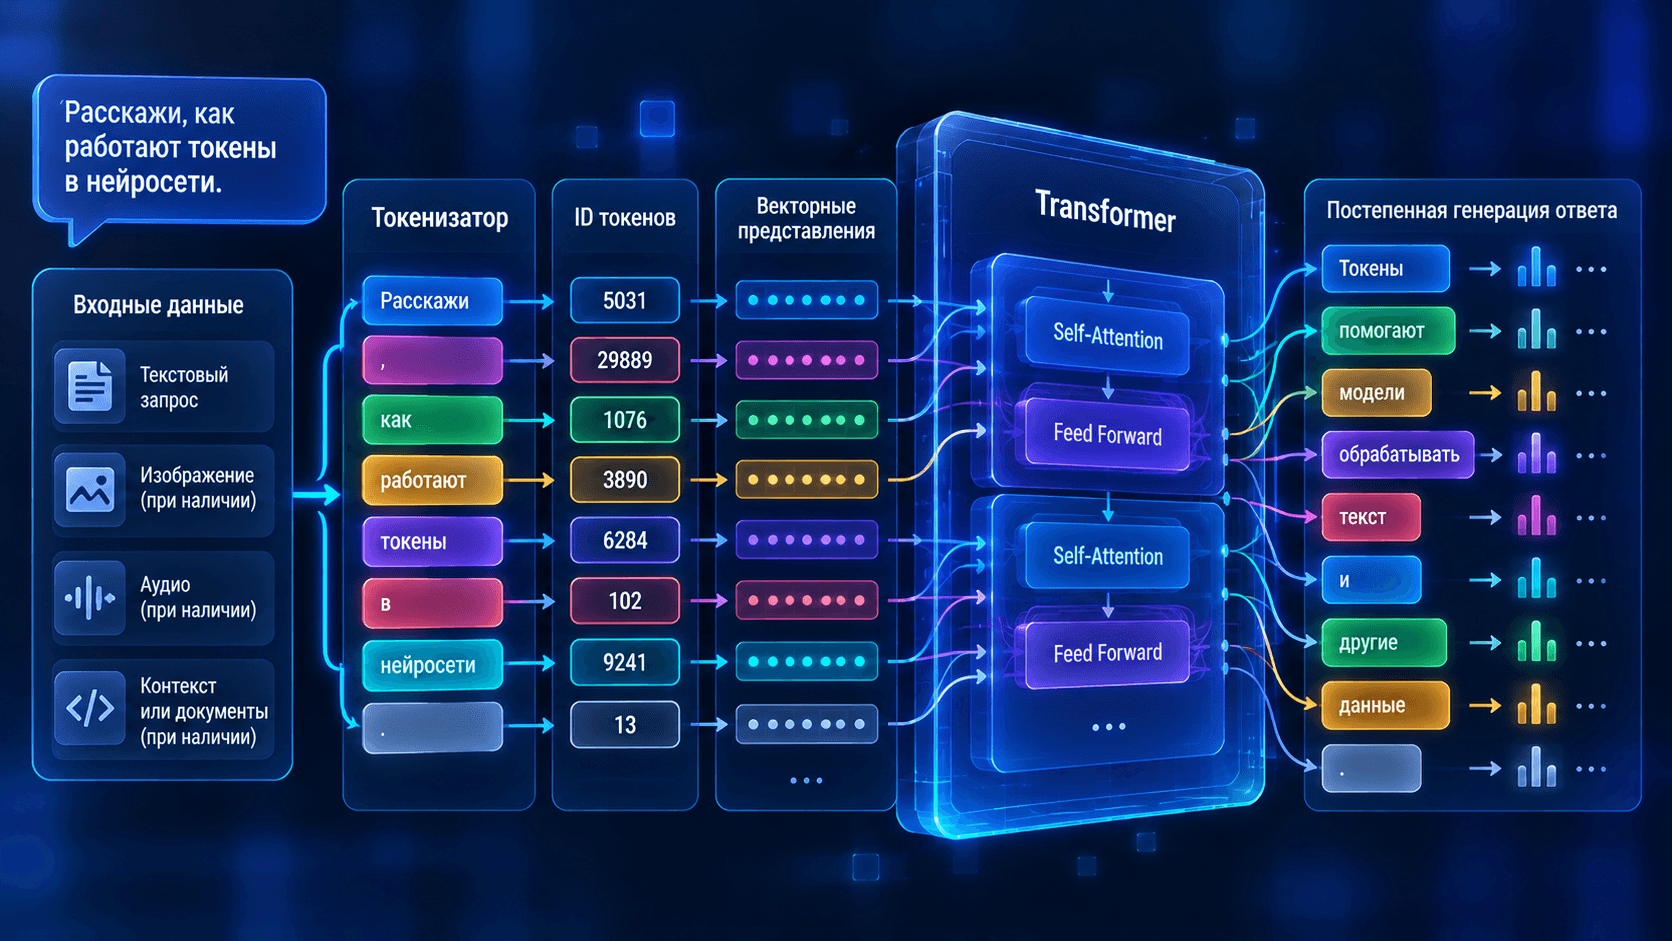
Что такое токены в нейросети простыми словами
У модели есть словарь, то есть набор элементов, которые умеет распознавать ее токенизатор. Каждому элементу назначен ID. Если нужное слово присутствует в словаре целиком, оно может занять один токен. Если такого элемента нет, токенизатор собирает слово из нескольких частей.
Представим условный словарь, в котором есть элементы сервер, GPU, -, ный и отдельные знаки препинания. Тогда фраза может быть разделена на части не так, как ее разделил бы человек. Это иллюстрация, а не результат конкретного токенизатора. Реальное разбиение проверяют программно.
Причина такого устройства практическая. Хранить отдельный элемент для каждого возможного слова, формы, артикула, числа и опечатки невозможно. Разбиение на частые слова и подслова позволяет работать с большим словарем языка, сохраняя ограниченный размер vocabulary.
Что может быть токеном
Конкретный набор зависит от модели и токенизатора. Чаще встречаются следующие варианты:
Вид элемента | Пример роли | Что нужно учитывать |
|---|---|---|
Целое слово | частое короткое слово | один и тот же текст другая модель может разбить иначе |
Подслово | корень, суффикс или фрагмент редкого слова | длинные и редкие термины часто занимают несколько токенов |
Знак препинания | точка, запятая, скобка | форматирование тоже расходует контекст |
Пробел или пробел вместе со словом | граница и начало нового элемента | правила зависят от конкретной схемы кодирования |
Число или его часть | дата, объем памяти, артикул | длинные номера и таблицы способны давать неожиданный счет |
Фрагмент кода | оператор, имя, отступ | код и JSON часто имеют другой профиль, чем обычный текст |
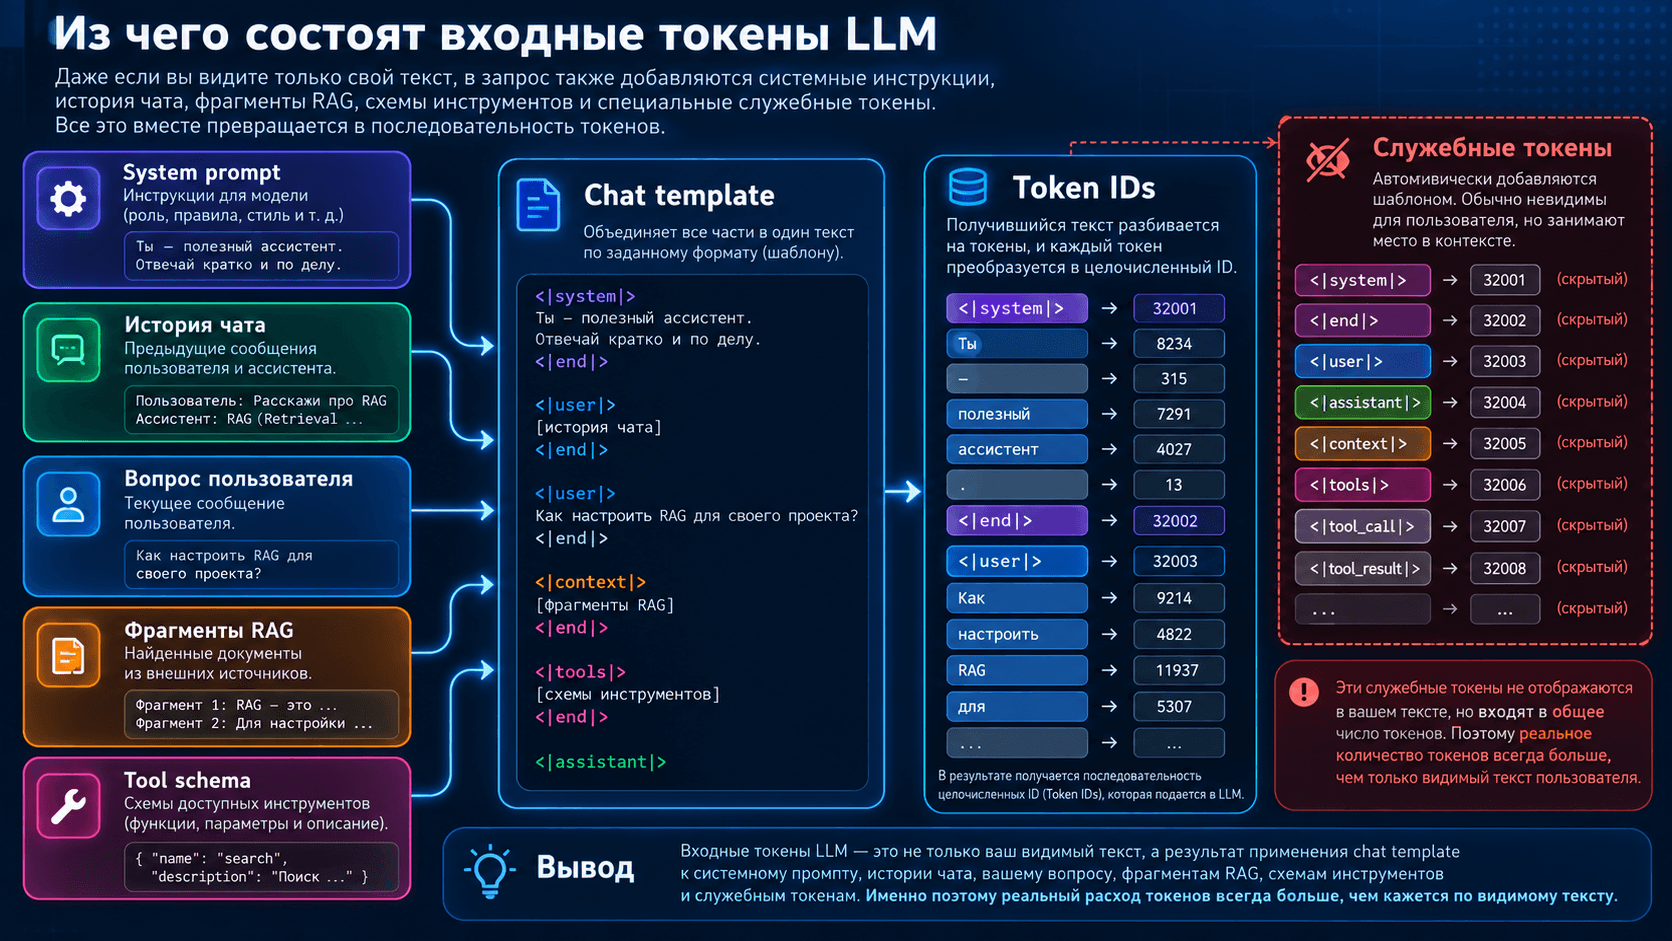
Служебный токен | начало, конец, разделитель, роль сообщения | может добавляться библиотекой или chat template без видимого текста |
Байтовый фрагмент | редкий символ или неизвестная последовательность | помогает кодировать текст без полного словаря всех символов |
Из этого следует важное правило: перевод количества символов или слов в токены дает только грубую оценку. Для русского языка нельзя без проверки применять коэффициент, выведенный на английском тексте. Код, XML, JSON, таблицы, смешение кириллицы с латиницей и длинные технические обозначения также меняют соотношение.
Как работает токенизация текста
Токенизация состоит из нескольких операций, но точная реализация зависит от семейства модели.
Приложение собирает системные инструкции, вопрос, историю, найденные документы и служебные данные.
Chat template добавляет роли, разделители и специальные элементы, если они нужны модели.
Токенизатор кодирует итоговую последовательность в список ID.
ID поступают в embedding layer, где каждому элементу соответствует обучаемое векторное представление.
Слои Transformer обрабатывают последовательность с учетом позиции и контекста.
Выходной слой вычисляет распределение вероятностей следующего токена по словарю.
Выбранный ID декодируется в текст, добавляется к последовательности, затем цикл повторяется.
Распространены subword-подходы, включая варианты Byte Pair Encoding, WordPiece, Unigram и SentencePiece. Название алгоритма само по себе не позволяет предсказать разбиение конкретной фразы. Имеют значение обученный словарь, правила предварительной обработки, версия токенизатора и специальные токены.
Почему разные LLM считают один текст по-разному
Универсального токенизатора для всех нейросетей нет. Даже близкие по назначению модели могут использовать разные словари и правила. Это приводит к нескольким последствиям.
Язык меняет плотность токенов
Если словарь хорошо покрывает русский язык, частые слова и морфемы могут кодироваться компактнее. Если покрытие хуже, текст распадается на большее число частей. Сравнивать модели только по заявленному контекстному окну недостаточно: сначала нужно токенизировать типичные документы на русском языке.
Форматирование тоже учитывается
Пробелы, переносы строк, Markdown, JSON-ключи, XML-теги и отступы в коде могут становиться отдельными элементами или менять границы разбиения. Красиво отформатированный prompt иногда длиннее компактного варианта, хотя передает тот же смысл.
Специальные токены не всегда видны
Чат-модель может ожидать маркеры ролей, начала и конца сообщения. Библиотека добавляет их через шаблон. Если считать только исходную строку без chat template, результат не совпадет с фактическим запросом.
Версия модели имеет значение
Новая модель или новая версия API может использовать другое кодирование. Сохраненный ранее коэффициент «символы на токен» нельзя считать контрактом. В production следует фиксировать модель, tokenizer revision и шаблон сообщений вместе с версией приложения.
Как посчитать токены правильно
Есть три надежных способа. Выбор зависит от того, где запускается модель.
Использовать официальный счетчик поставщика API
Если провайдер публикует tokenizer или endpoint для подсчета, нужно использовать его для выбранной модели. После запроса фактические input tokens и output tokens обычно берут из поля usage ответа. Оно полезнее предварительной оценки, потому что учитывает формат сообщения и правила сервиса.
При этом billing может отдельно учитывать cached input, reasoning tokens, изображения, аудио или tool calls. Названия полей и тарифы меняются, поэтому расчет привязывают к документации и версии API, а не к старой таблице из статьи.
Запустить токенизатор локальной модели
Для модели из экосистемы Transformers базовая проверка может выглядеть так:
from transformers import AutoTokenizer

model_id = "MODEL_ID"
text = "Текст, который нужно посчитать"

tokenizer = AutoTokenizer.from_pretrained(model_id)
token_ids = tokenizer.encode(text, add_special_tokens=True)
print(len(token_ids))
MODEL_ID заменяют точным идентификатором выбранной модели. Для чата надежнее применить ее chat template, иначе служебные элементы могут не попасть в счет. Нельзя брать токенизатор одной LLM для оценки другой только потому, что обе основаны на Transformer.
Считать фактические запросы в телеметрии
Предварительный счет нужен для лимита, но инфраструктуру рассчитывают по распределению реальных запросов. Полезно сохранять без чувствительного текста следующие числовые поля:
input tokens и output tokens;
число токенов system prompt, истории, RAG и tools;
выбранную модель и версию токенизатора;
time to first token, или TTFT;
inter-token latency, или ITL;
общую задержку;
размер batch и число активных последовательностей;
факт усечения или отказа из-за лимита.
Входные, выходные и служебные токены
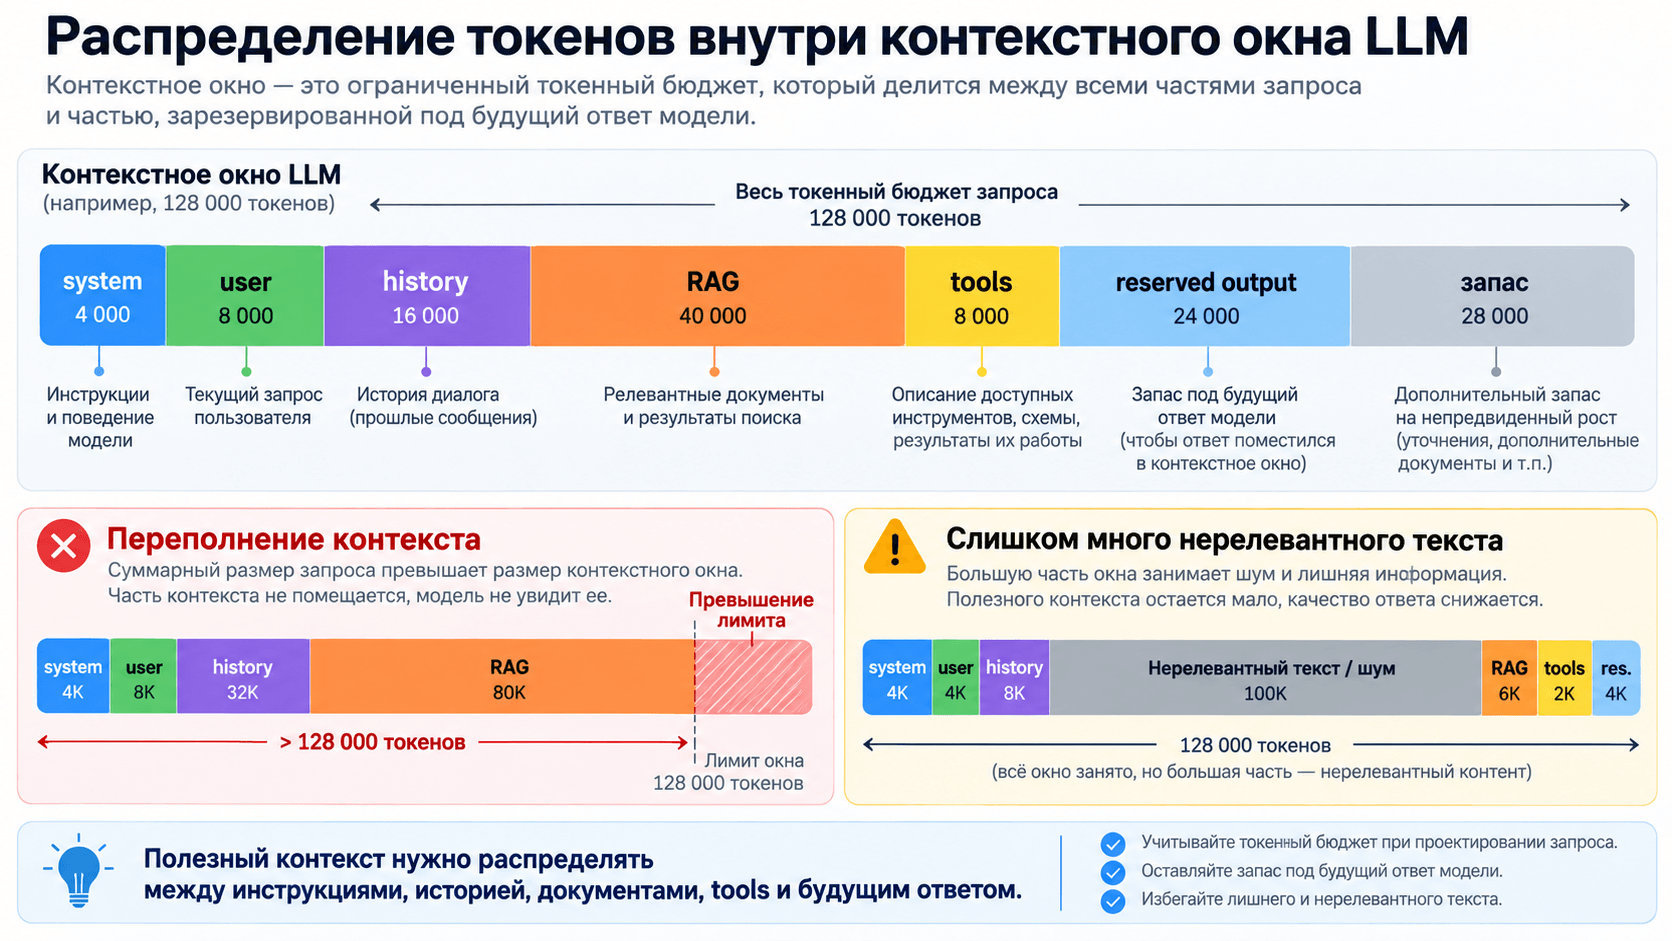
Прикладной бюджет удобнее делить на части.
Группа | Что входит | На что влияет |
|---|---|---|
Системные токены | инструкции, политика ответа, формат | постоянная нагрузка каждого запроса |
Пользовательские токены | вопрос и приложенный текст | объем полезного ввода |
История | предыдущие сообщения и ответы | растет с каждым ходом диалога |
RAG-контекст | найденные chunks и ссылки | качество основания, prefill, стоимость и KV cache |
Tools | описания функций, аргументы и результаты | особенно заметны в агентных системах |
Выходные токены | сгенерированный ответ | время decode и стоимость генерации |
Служебные токены | роли, разделители и шаблоны | зависят от runtime и модели |
Упрощенное условие для одного запроса выглядит так:
T_system + T_user + T_history + T_RAG + T_tools + T_output + T_service <= T_context
Слева находится бюджет запроса, справа предел контекстного окна. Некоторые API задают отдельный максимум выходных токенов, который меньше общего окна. Часть runtime резервирует место под ответ заранее. Точные правила проверяют по выбранной модели.
Что такое токены в контексте нейросетей
Контекст представляет последовательность токенов, доступную модели во время текущего вычисления. В нее попадает не вся история существования системы, а только то, что приложение передало в запросе или восстановило из внешней памяти.
Контекстное окно задает верхний лимит последовательности. Если бюджет превышен, приложение может:
отбросить старые сообщения;
сократить найденные документы;
сделать промежуточное резюме;
разбить задачу на несколько вызовов;
уменьшить разрешенную длину ответа;
вернуть ошибку без запуска модели.
Механическое заполнение всего окна редко полезно. Нерелевантный текст увеличивает вычисления и способен отвлекать модель от нужных фактов. В RAG качество retrieval и chunking часто важнее максимального числа переданных страниц. Связь фрагментов, эмбеддингов и поиска разобрана в статье как эмбеддинги работают в RAG.
На что влияет количество токенов
На стоимость облачного API
Провайдеры обычно тарифицируют ввод и вывод отдельно. У некоторых сервисов отдельную цену имеют кэшированный ввод, batch, reasoning или мультимодальные данные. Универсальная формула для текстового запроса выглядит так:
стоимость = input_tokens / тарифная_единица × цена_input + output_tokens / тарифная_единица × цена_output
На время до первого токена
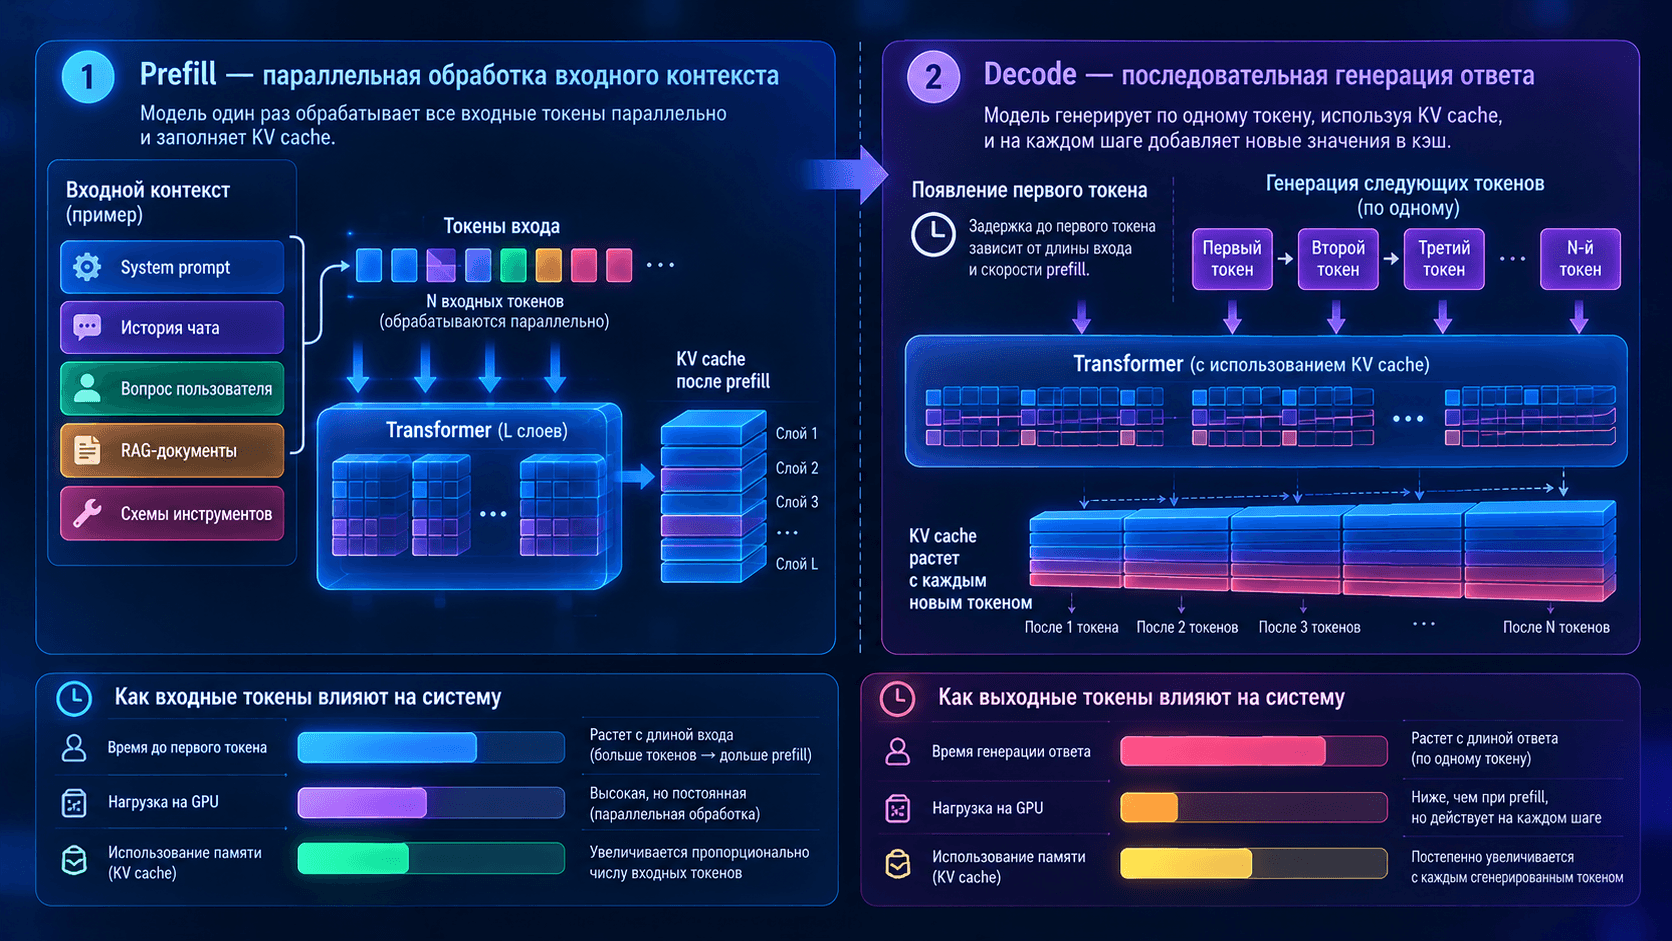
Во время prefill модель обрабатывает входную последовательность и строит KV cache. Длинный prompt увеличивает работу до появления первого фрагмента ответа. На TTFT также влияют batch, очередь, prefix caching, tensor parallelism, сеть и загрузка GPU.
На продолжительность генерации
Авторегрессионная LLM создает выход последовательно. Чем больше output tokens, тем дольше занят request slot. Скорость обычно измеряют в tokens per second, но показатели разных моделей нельзя сравнивать без учета токенизатора. Одинаковая строка может состоять из разного числа токенов.
На объем KV cache и VRAM
KV cache хранит key и value для уже обработанных позиций, чтобы не пересчитывать их на каждом шаге. Его размер растет с длиной последовательности, числом слоев, числом KV heads, размерностью head, batch и числом байтов на элемент.
Для простой архитектуры без дополнительных оптимизаций оценка выглядит так:
KV bytes ~= layers × tokens × 2 × kv_heads × head_dim × bytes_per_element × active_sequences
Множитель 2 соответствует K и V. У моделей с grouped-query attention число KV heads меньше числа attention heads, поэтому расход может быть ниже. Runtime также добавляет служебные структуры, fragmentation и резерв блоков.
Условный пример: 32 слоя, 32 KV heads, head dimension 128, 8 192 токена, BF16 или FP16 и одна активная последовательность. Арифметическая оценка дает около 4 ГиБ только для KV cache. Если архитектура использует 8 KV heads, при остальных равных параметрах оценка уменьшается примерно в четыре раза. Это не размер конкретной модели, а демонстрация зависимости.
Подробная методика вынесена в руководство как рассчитать VRAM для LLM с учетом весов, KV cache и параллельных запросов.
На параллельность и пропускную способность
Две системы с одинаковым GPU могут обслуживать разное число пользователей, если отличаются длины запросов и ответов. Короткий FAQ и анализ многостраничного документа создают разные профили нагрузки. Когда активные последовательности занимают больше KV cache, runtime уменьшает число одновременных запросов, ставит их в очередь или выгружает часть данных в более медленную память.
На качество ответа
Недостаточный бюджет приводит к усечению инструкции, истории или источников. Избыточный бюджет тоже не гарантирует качество. Если в контексте много похожих и противоречивых фрагментов, модели сложнее выбрать основание. Контроль токенов должен работать вместе с retrieval, ранжированием, дедупликацией и тестами качества.
Prefill и decode: почему входные и выходные токены нагружают сервер по-разному
LLM-инференс удобно разделить на две фазы.
Фаза | Что происходит | Основной фактор нагрузки | Пользовательская метрика |
|---|---|---|---|
Prefill | модель обрабатывает весь вход и создает KV cache | длина input, compute, очередь и cache reuse | TTFT |
Decode | модель последовательно создает новые токены | число active sequences, KV cache и пропускная способность памяти | ITL и output tokens/s |
Длинный вход способен ухудшить время до первого токена, даже если ответ короткий. Длинный ответ дольше занимает decode slot, даже если вопрос состоял из одной строки. По этой причине для серверного расчета нельзя использовать одно общее число «токенов в день».
Нужно знать как минимум распределение input length, output length, частоту запросов, concurrency и требования к задержке. Методика эксплуатационных измерений приведена в материале как измерить производительность LLM-сервера: TTFT, задержки и throughput.
Токены при обучении и инференсе
Фраза «модель обучена на триллионах токенов» относится к объему обучающего корпуса после токенизации. Это не контекстное окно и не число токенов одного запроса.
При предобучении модель многократно обрабатывает последовательности и изменяет веса. Вычислительная стоимость зависит от числа training tokens, размера модели, длины последовательности, batch, числа проходов и метода обучения. Повторные эпохи означают повторную обработку данных, поэтому число уникальных токенов корпуса и фактическое количество обработанных токенов могут отличаться.
При инференсе веса обычно не обновляются. Система обрабатывает input tokens и генерирует output tokens. Здесь на первый план выходят latency, throughput, KV cache, concurrency и стоимость обслуживания.
Токены в RAG, агентах и tool calling
Корпоративное приложение добавляет к вопросу пользователя несколько невидимых источников расхода.
RAG
Найденные chunks попадают во входной контекст. Если retrieval возвращает десять почти одинаковых фрагментов, система платит за них токенами, prefill и KV cache, но не получает пропорционального прироста качества. Нужны лимит, дедупликация, reranker и контроль полноты ответа.
ИИ-агенты
Описание tools может содержать длинные схемы аргументов. Каждый вызов добавляет результат инструмента, а следующий model call снова получает часть истории. Агент, который делает много шагов, иногда расходует на служебный контекст больше токенов, чем на финальный ответ.
Многоходовый чат
Если приложение пересылает всю переписку на каждом ходу, input растет. Для длинных диалогов используют обрезку, структурированное состояние, retrieval по истории или проверяемую суммаризацию. При этом нельзя удалить ограничения и факты, от которых зависит безопасность решения.
Мультимодальные запросы
Изображения, аудио и видео могут переводиться в собственные последовательности элементов. Правила подсчета и оплаты зависят от модели и API. Текстовый tokenizer не дает корректную оценку мультимодального запроса.
Как уменьшить расход токенов без потери качества
Удалите дубли из system prompt и шаблонов. Одна инструкция не должна повторяться в нескольких блоках.
Передавайте только нужную историю. Сохраняйте состояние задачи отдельно от дословного диалога.
Настройте RAG по реальным вопросам. Ограничьте top-k, применяйте metadata filters, reranker и дедупликацию.
Сократите tool schemas. Описания должны быть однозначными, но не содержать длинную документацию API целиком.
Задавайте разумный предел ответа. Модель не должна генерировать несколько страниц там, где нужен объект JSON или короткое заключение.
Используйте prefix caching, если runtime и повторяемый префикс это поддерживают. Кэш снижает повторный prefill, но не отменяет лимит контекста и расход KV cache активной последовательности.
Выбирайте модель по качеству на целевой задаче. Большое окно не компенсирует слабую работу с нужным языком или документами.
Проверяйте формат. Компактный JSON иногда полезен, но чрезмерно длинные имена полей и вложенные схемы тоже расходуют токены.
Сокращение ради одной метрики может повредить результату. Например, агрессивное резюме истории способно потерять точные числа или запреты. Каждое изменение проверяют на наборе реальных запросов: качество, TTFT, tokens per second, стоимость и доля ошибок.
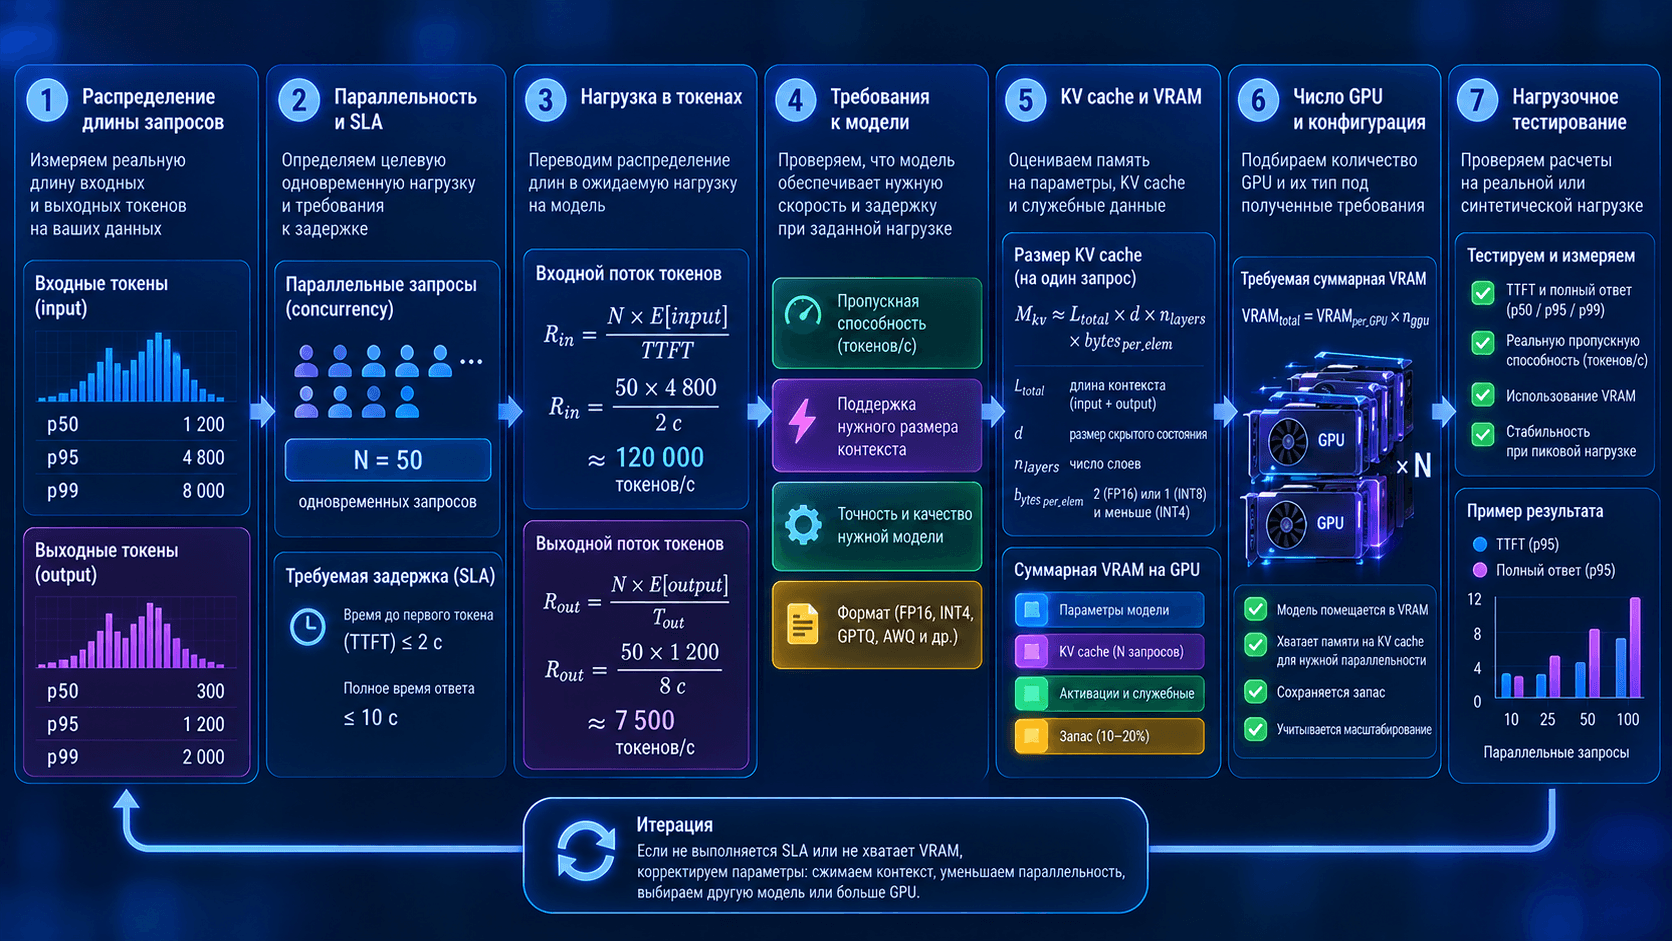
Как перевести токены в требования к LLM-серверу
Сначала нужен профиль нагрузки, а уже потом выбор GPU.
Соберите типичные запросы, длинные документы и пограничные случаи.
Посчитайте input и output тем токенизатором, который будет работать в production.
Зафиксируйте p50, p95 и p99 для входа и выхода.
Измерьте запросы в секунду и число одновременных активных последовательностей.
Задайте SLA: TTFT, ITL, общая задержка и допустимая очередь.
Определите модель, точность весов, runtime, tensor parallelism и правила batching.
Рассчитайте веса, KV cache, служебный запас VRAM и место под runtime.
Проведите нагрузочный тест на целевой версии ПО.
Грубые потоки можно описать так:
input tokens/s = requests/s × average input tokens
output tokens/s = requests/s × average output tokens
Эти формулы подходят для первого масштаба, но не заменяют тест. Средние значения скрывают длинный хвост, а prefill и decode используют GPU по-разному. Для команды со стабильным рабочим сценарием полезен отдельный расчет локальной LLM для 100 сотрудников.
Системы для production-serving собраны в категории серверов для инференса LLM. Компактный пилот и высокопараллельный сервис требуют разных платформ. Например, Dell PowerEdge XE9680 с восемью NVIDIA H200 относится к классу плотных многопроцессорных систем. Такая конфигурация оправдана только после проверки модели, tensor parallelism, токенного профиля и SLA.
Типичные ошибки при работе с токенами
Считать по словам или символам
Такой коэффициент годится только для грубой прикидки на конкретном корпусе. Лимиты и стоимость проверяют точным tokenizer.
Использовать счетчик другой модели
Даже близкие LLM способны делить русский текст, код и числа по-разному. Ошибка особенно опасна рядом с пределом контекста.
Не учитывать chat template
Системные сообщения, роли, tool schemas и служебные элементы увеличивают фактический input. Подсчет одной строки пользователя занижает бюджет.
Складывать заявленный контекст и максимальный ответ
У конкретного API выход может входить в общий предел или иметь отдельное ограничение. Правило нужно брать из действующей документации выбранной модели.
Считать длинный контекст бесплатным
Даже локальная модель не получает токены бесплатно. Их обработка требует GPU-времени, KV cache, электричества и снижает доступную параллельность.
Сравнивать tokens per second у разных токенизаторов
Метрика полезна внутри одинаковой модели и конфигурации. Между разными словарями одинаковое число токенов может соответствовать разному объему текста.
Проектировать по среднему запросу
Сервер может нормально работать на p50 и уходить в очередь на p99. Нужны распределения длины, одновременность и нагрузочный профиль.
FAQ
Что такое токен в нейросети?
Токен представляет элемент последовательности, которую обрабатывает модель. В текстовой нейросети это может быть слово, часть слова, знак, пробел или специальная метка. Токенизатор сопоставляет элементу числовой ID.
Что такое токены в нейросети простыми словами?
Это кусочки, на которые программа делит текст перед передачей модели. Нейросеть работает с их идентификаторами и векторами, а затем генерирует ответ по одному следующему токену.
Как работают токены в нейросетях?
Текст кодируется в token IDs, IDs превращаются в векторы, Transformer обрабатывает их в контексте, затем модель рассчитывает вероятности следующего токена. Выбранный элемент добавляется к последовательности, и цикл повторяется.
Токен всегда равен части текста?
Для текстовой LLM токен обычно соответствует фрагменту кодируемой последовательности, но он может быть служебным и не иметь обычного видимого написания. В мультимодальных моделях собственные элементы используются также для изображения или аудио.
Токен является готовым ответом нейросети?
Нет. Ответ состоит из последовательности сгенерированных токенов. Один токен представляет только один элемент этой последовательности.
Токен является числовой оценкой?
Нет. Токену соответствует числовой ID. Модель также рассчитывает вероятность следующего токена и создает векторы внутренних представлений, но ID, вектор и вероятность являются разными понятиями.
Почему количество токенов больше числа слов?
Редкие и длинные слова могут делиться на несколько подслов. Дополнительные токены создают знаки, пробелы, числа, код, роли сообщений и служебная разметка.
Как узнать точное количество токенов?
Используйте официальный tokenizer конкретной модели вместе с ее chat template. После API-вызова сверяйте предварительный счет с фактическими полями usage.
Входные и выходные токены считаются одинаково?
Обычно они кодируются одним словарем, но оказывают разную нагрузку и могут иметь разные тарифы. Вход обрабатывается на prefill, выход создается последовательно во время decode.
Чем больше контекстное окно, тем лучше модель?
Нет. Большое окно позволяет передать больше токенов, но не гарантирует точное использование каждой части контекста. Качество зависит от модели, задачи, позиции факта, retrieval и состава переданных данных.
Что подготовить для расчета локальной LLM
Для первичной оценки соберите обезличенную выборку запросов, фактические input и output tokens, пиковую параллельность, требования к TTFT и общему времени ответа, выбранную модель и планируемый runtime. Если используется RAG или tools, включите их служебный контекст в измерение.
Start Server может сопоставить этот профиль с объемом VRAM, KV cache, числом GPU, CPU, RAM, сетью и резервированием. Передать исходные данные для расчета можно через контакты Start Server. Результат нужно подтвердить нагрузочным тестом на той версии модели и ПО, которая пойдет в эксплуатацию.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


