LLM, или Large Language Model, это большая языковая модель: нейросеть, обученная находить закономерности в последовательностях токенов и продолжать их. Для генеративной LLM базовая операция выглядит просто: получить текстовый контекст, вычислить вероятности следующего токена, выбрать его и повторять расчет, пока ответ не завершится.
Из этой операции вырастают ответы на вопросы, пересказ документов, перевод, написание кода, классификация и извлечение данных. Модель не достает готовую фразу из обычной базы знаний. Она генерирует результат на основе параметров, сформированных при обучении, текущего запроса и переданного контекста. Поэтому ответ может быть убедительным по форме и неверным по содержанию.
Термин LLM обозначает именно модель, а не весь сервис. Чат-бот добавляет интерфейс и историю диалога. RAG подключает поиск по внешним документам. AI-агент дает модели инструменты и логику выполнения действий. Корпоративная система также включает контроль доступа, журналирование, мониторинг, защиту данных и вычислительную инфраструктуру.
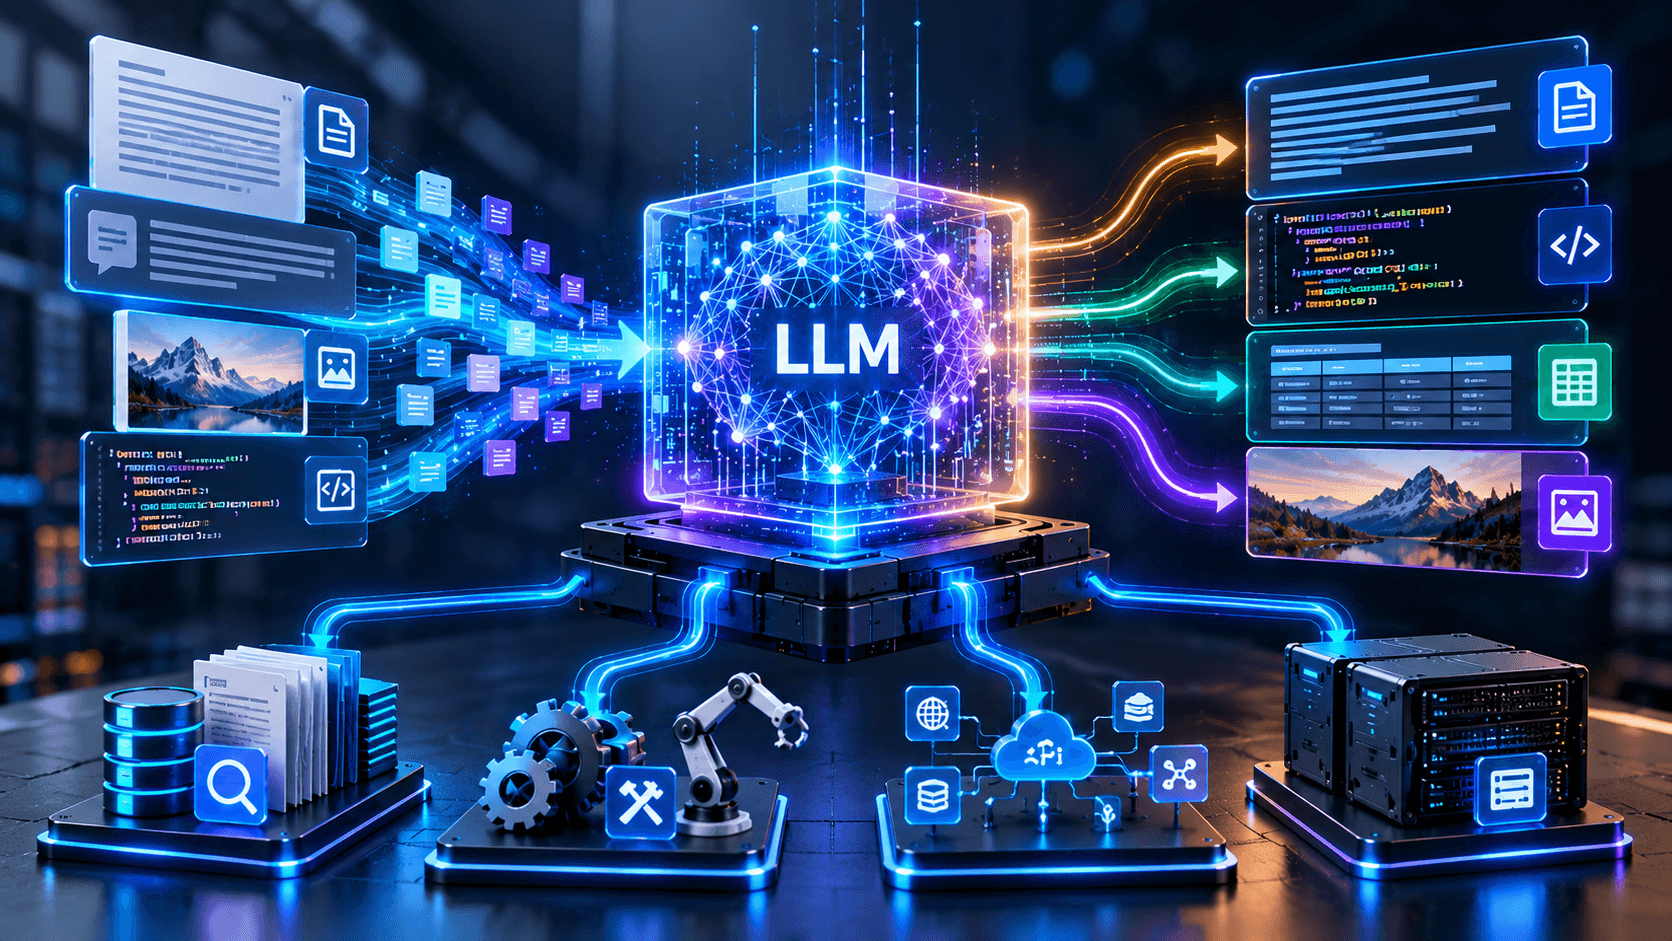
LLM простыми словами
Языковая модель оценивает, какое продолжение подходит к уже полученной последовательности. Если ввести начало фразы, модель рассчитает вероятности вариантов следующего токена. Выбранный токен добавляется к контексту, после чего цикл повторяется. Так LLM генерирует текст по одному элементу, хотя пользователь видит слова и предложения.
Токен не обязательно равен слову. Им может быть целое короткое слово, часть длинного слова, знак препинания, пробел или специальный служебный элемент. Точная токенизация зависит от словаря конкретной модели. Один и тот же текст разные LLM могут разделить по-разному, особенно если отличаются языки и алгоритмы токенизатора.
Слово «большая» не задает универсальную границу. Обычно оно указывает на значительный объем параметров, обучающих данных и вычислений, но единого числа, после которого модель официально становится LLM, нет. Малые языковые модели, или SLM, решают похожие задачи при меньшем размере и часто лучше подходят для ограниченного оборудования или узкой функции.
Где LLM находится среди AI, ML и нейросетей
LLM относится к искусственному интеллекту, машинному обучению и нейросетям одновременно, но эти понятия имеют разный масштаб.
Термин | Что означает |
|---|---|
AI, искусственный интеллект | широкая область методов и систем для прогнозирования, планирования, восприятия и генерации |
ML, машинное обучение | методы, которые строят поведение модели по данным |
Нейросеть | вычислительная модель из связанных слоев и параметров |
Языковая модель | модель закономерностей в последовательностях языка |
LLM | крупная языковая модель, переносящая выученные закономерности на широкий набор задач |
GPT | семейство генеративных предобученных Transformer-моделей, но не синоним всех LLM |
Чат-бот | интерфейс диалога и прикладная логика вокруг модели |
RAG | получение документов и добавление релевантных фрагментов в контекст |
AI-агент | система, где модель выбирает шаги и вызывает разрешенные инструменты |
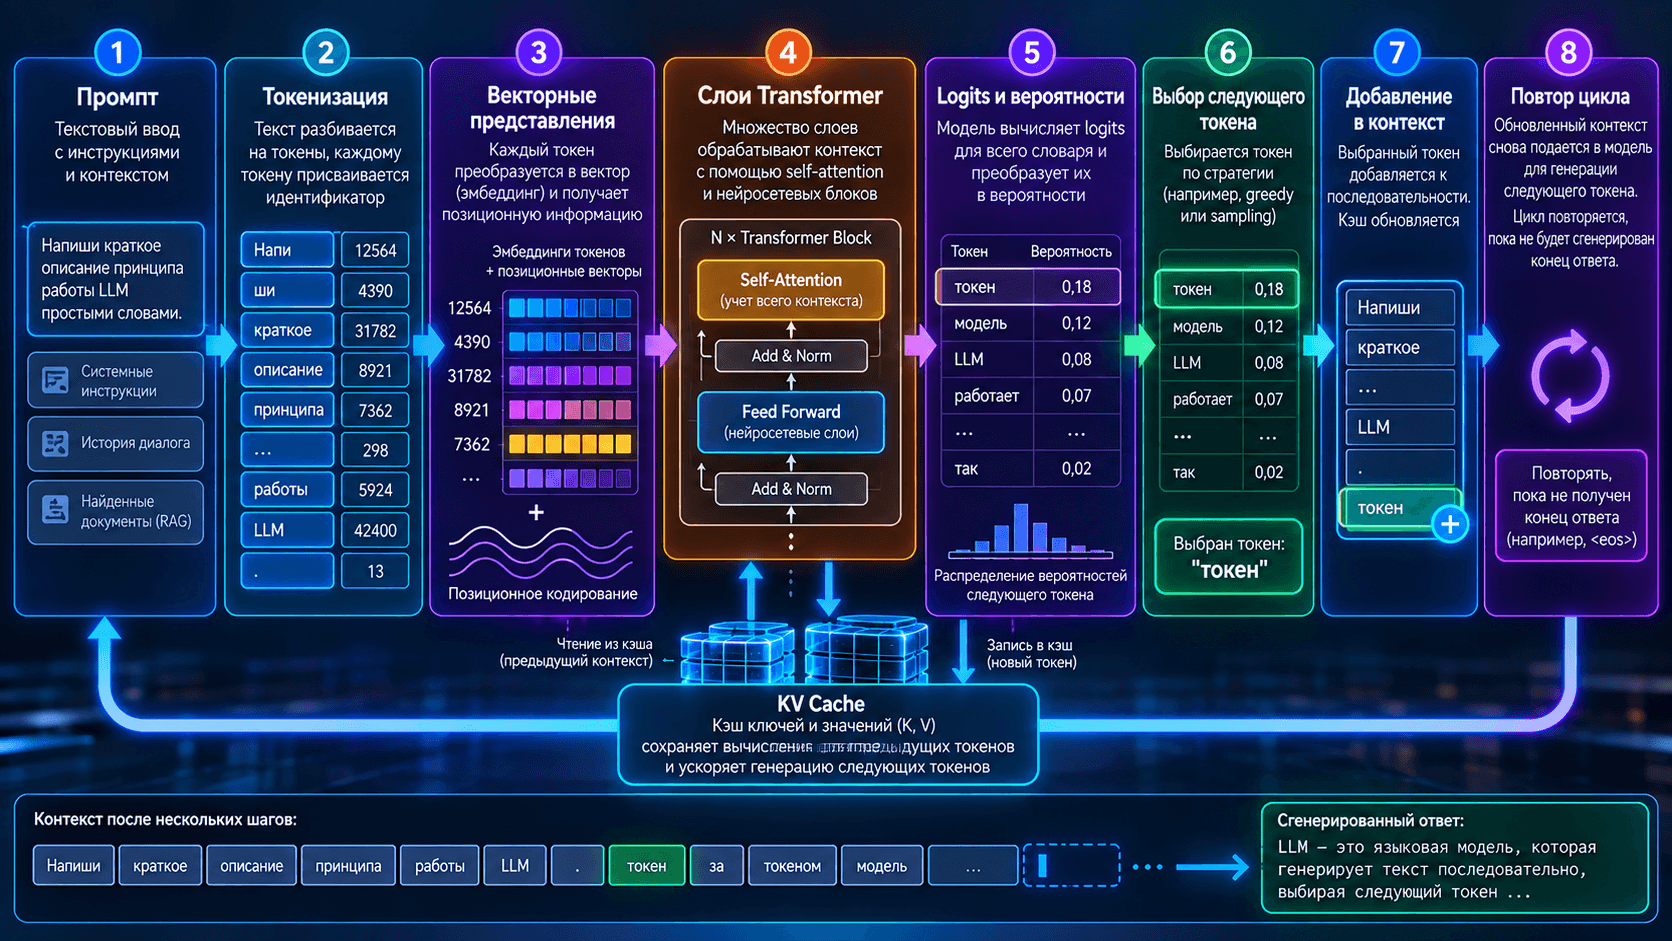
Как работает LLM: путь от запроса до ответа
Реализации различаются, но общий путь авторегрессионной генерации остается похожим.
1. Запрос превращается в токены
Промпт, системные инструкции, история и найденные документы собираются в единый ввод. Токенизатор делит его на элементы и сопоставляет каждому идентификатор. Число токенов влияет на стоимость API, время обработки, длину ответа и память, поэтому его считают токенизатором выбранной модели, а не по символам.
2. Идентификаторы получают векторные представления
Каждому токену соответствует числовой вектор. К нему добавляется информация о позиции. Embeddings поискового индекса и внутренние представления LLM не являются одним компонентом: в RAG отдельная модель кодирует запросы и документы, а генеративная LLM пишет ответ по найденным фрагментам.
3. Transformer сопоставляет элементы контекста
Современные LLM обычно основаны на Transformer. Self-attention вычисляет связи между позициями контекста, а последовательность слоев преобразует представление текста. Это обучаемая числовая операция, а не доказательство человеческого понимания.
4. Модель рассчитывает вероятности следующего токена
Выходной слой задает распределение вероятностей следующего токена. Sampling повышает разнообразие, а детерминированный выбор делает результат стабильнее. Temperature, top-p и ограничение длины меняют способ выбора, но не добавляют знаний и не гарантируют фактическую точность.
5. Цикл повторяется до завершения
Выбранный токен добавляется к последовательности, затем модель вычисляет следующий. Генерация заканчивается по специальному признаку, лимиту длины или правилу приложения.
При инференсе KV cache сохраняет промежуточные key и value для предыдущих токенов, чтобы не пересчитывать весь контекст на каждом шаге. Это ускоряет декодирование, но занимает память. Чем больше активных токенов и параллельных запросов, тем выше требования к KV cache. Подробный расчет вынесен в руководство как рассчитать VRAM для LLM с учетом весов, KV cache, контекста и параллельных запросов.
Из чего состоит LLM
Архитектура, параметры и контекст LLM описывают разные части системы.
Параметры и веса
Параметры представляют обучаемые числовые значения. Они кодируют статистические закономерности, а не список ответов. Их количество влияет на объем весов и вычислений, но качество также определяют данные, архитектура, контекст, токенизатор и настройка поведения.
Контекстное окно
Контекстное окно ограничивает число доступных токенов: инструкции, вопрос, историю, документы и уже созданную часть ответа. При переполнении приложение сокращает или удаляет данные. Постоянную память ассистента реализуют внешним хранилищем. Длинное окно не гарантирует одинаковое качество на любой позиции.
Слои Transformer
Типичный блок Transformer содержит attention, полносвязную часть, нормализацию и остаточные связи. В dense модели для токена работает весь основной слой. В Mixture of Experts, или MoE, маршрутизатор активирует часть экспертов, поэтому общее и активное число параметров различается.
Токенизатор и словарь
Словарь содержит токены и их идентификаторы. Универсального размера нет. Большой словарь может уменьшить число токенов для отдельных языков, но не гарантирует качество. Русский язык проверяют отдельно на целевых текстах.
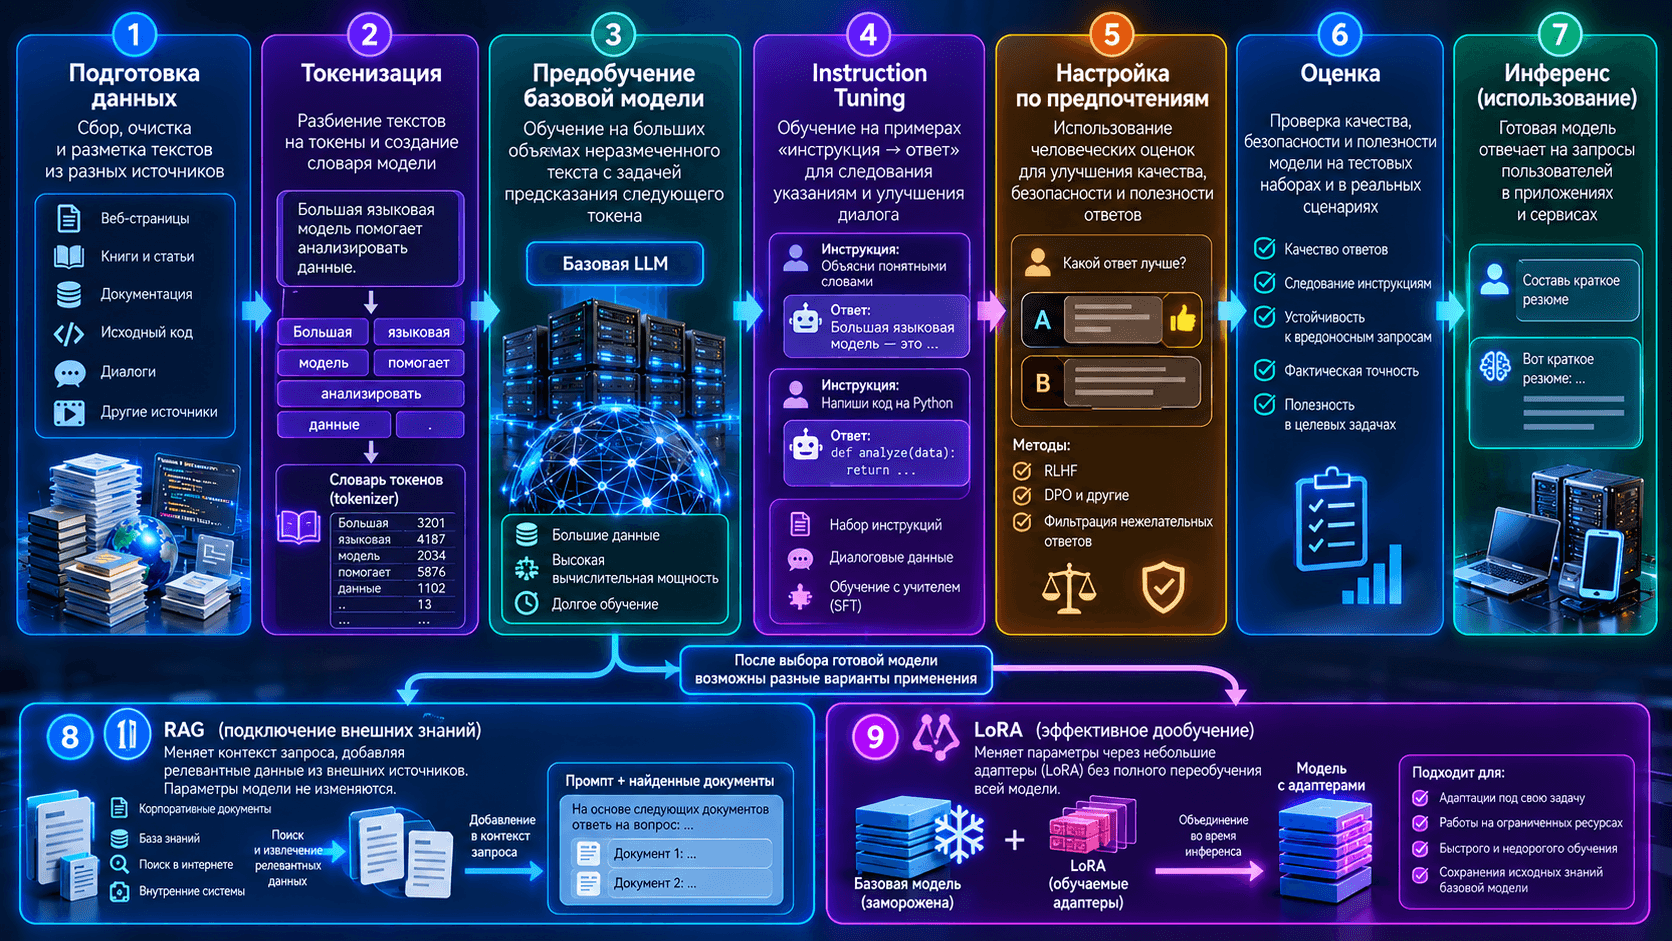
Как обучают большую языковую модель
Обучение LLM и запуск LLM представляют разные этапы. Во время обучения параметры изменяются. Во время инференса готовая модель применяет зафиксированные веса к новым запросам.
Подготовка данных
Сначала собирают и очищают корпуса текста и кода, удаляют дубликаты, фильтруют нежелательные данные, определяют языковой баланс и формируют обучающие выборки. Качество происхождения данных, лицензии и защита персональной информации не менее значимы, чем объем.
Предобучение
При causal language modeling модель учится предсказывать следующий токен. Ошибка между прогнозом и правильным продолжением распространяется назад по сети, оптимизатор обновляет параметры. Этот цикл повторяется на большом числе последовательностей.
Обучить LLM с нуля означает пройти дорогое предобучение базовой модели, а не просто загрузить документы компании. Для большинства организаций создание foundation model с нуля не требуется. Практическая задача чаще решается выбором готовой модели, RAG, промптами и ограниченным дообучением.
Instruction tuning и настройка поведения
Базовая модель продолжает текст, но не обязана удобно выполнять инструкции. Supervised fine-tuning обучает ее на примерах запросов и желаемых ответов. Дополнительная настройка по предпочтениям может использовать RLHF или другие методы. Конкретный конвейер зависит от разработчика модели.
Размер сам по себе не гарантирует полезное поведение. Исследование InstructGPT показало на своей тестовой выборке, что модель меньшего размера после настройки по человеческой обратной связи могла получать более высокие предпочтения оценщиков, чем гораздо более крупная базовая модель. Это не универсальный рейтинг, а подтверждение того, что данные и способ настройки имеют значение.
Дообучение под задачу
Полное fine-tuning обновляет множество или все доступные параметры и требует значительных вычислительных ресурсов. LoRA замораживает основные веса и обучает компактные низкоранговые матрицы. QLoRA сочетает адаптеры LoRA с замороженной квантованной базовой моделью, уменьшая требования к памяти.
Дообучение полезно для устойчивого формата, стиля, терминологии и повторяемого поведения. Оно не является надежной заменой актуальной базе документов. Практические требования к памяти раскрыты в руководстве по серверу для LoRA и QLoRA.
Типовые многопроцессорные платформы для этого контура собраны в категории серверов для обучения LLM. Число GPU, сеть и хранилище рассчитывают под выбранный способ настройки.
Что умеют LLM
Возможности LLM зависят от модели и качества постановки задачи. Чаще всего технологию применяют в следующих сценариях:
создание черновиков, писем, описаний и ответов;
суммаризация документов и переписки;
классификация обращений и маршрутизация заявок;
извлечение сущностей и преобразование текста в заданную структуру;
перевод и адаптация текста между языками;
поиск объяснений и ответы по переданному контексту;
генерация, анализ и рефакторинг кода;
подготовка запросов к другим системам под строгим контролем;
анализ данных, если приложение передает модели результаты вычислений и проверяет формат;
работа как управляющий компонент ассистента или агента.
LLM хорошо работает там, где допустим вероятностный результат и его можно проверить. Для расчета налогов, баланса, цены, прав доступа или команды удаления модель не должна быть единственным источником решения. Детерминированную операцию выполняет обычный код, а LLM помогает понять запрос, выбрать разрешенный инструмент или сформировать объяснение.
Почему LLM ошибается
Галлюцинациями LLM часто называют правдоподобные, но ложные ответы. NIST использует более точный термин confabulation: уверенно сформулированный ошибочный или ложный материал. Такая ошибка следует из самой задачи генерации: модель оптимизирует продолжение последовательности, а не автоматически сверяет каждое утверждение с реестром фактов.
Основные ограничения LLM:
Фактическая ненадежность. Модель может придумать дату, источник, характеристику, цитату или ссылку.
Ограниченная актуальность. Параметры отражают обучающие данные, а встроенный поиск есть не у каждой системы.
Чувствительность к формулировке. Порядок инструкций, примеры и лишний контекст способны изменить ответ.
Ограниченное контекстное окно. Документ может не поместиться целиком, а длинный ввод не гарантирует равномерного учета всех частей.
Недетерминированность. При sampling одинаковый запрос может давать разные результаты.
Смещения данных. Модель воспроизводит ошибки, перекосы и нежелательные шаблоны обучающего корпуса.
Риски конфиденциальности. Внешнему API нельзя передавать секретные данные без допустимого режима обработки и договорных оснований.
Prompt injection. В документе или веб-странице может находиться инструкция, которая пытается изменить поведение приложения.
Ошибки инструментов. Агент может выбрать неверный вызов, параметры или последовательность действий.
Необъяснимость. Уверенный текст не дает достоверной трассировки того, почему выбран конкретный факт.
LLM, RAG, дообучение и AI-агент: что выбрать
Эти подходы решают разные задачи и могут работать вместе.
Задача | Подход | Что меняется | Главный риск |
|---|---|---|---|
Получить ответ по актуальным документам | RAG | в промпт добавляются найденные фрагменты | поиск может вернуть нерелевантный или устаревший документ |
Закрепить стиль, формат или специализированное поведение | SFT, LoRA или QLoRA | меняются параметры либо адаптеры | переобучение и ухудшение поведения вне выборки |
Построить модель с собственной базовой компетенцией | предобучение или продолженное предобучение | изменяется большой объем весов | стоимость данных, вычислений и проверки |
Выполнить действие во внешней системе | AI-агент и tools | модель выбирает разрешенный инструмент и параметры | ошибочное или небезопасное действие |
Быстро проверить гипотезу | API готовой instruct-модели | меняется только прикладной слой | зависимость от провайдера и режима обработки данных |
RAG, Retrieval-Augmented Generation, объединяет генерацию с внешним поиском. Запрос преобразуется для retrieval, система находит фрагменты в индексе, добавляет их в контекст, затем LLM формирует ответ. Веса модели при обычном RAG не обновляются. Это позволяет обновлять базу знаний без нового обучения и хранить ссылки на документы.
Для корпоративного внедрения нужно оценивать весь конвейер: разбор файлов, embeddings, векторный или гибридный поиск, reranking, права доступа, генерацию и проверку цитат. Подробная методика приведена в руководстве как рассчитать требования к серверу для корпоративного RAG. Готовые аппаратные направления выделены в категории серверов для RAG-систем.
AI-агент добавляет цикл планирования и вызовы инструментов. Сама LLM не получает магическую способность отправлять письма или менять записи в CRM. Приложение предоставляет ей строго описанные функции, проверяет аргументы и исполняет разрешенные операции. Аппаратные требования к такому контуру разобраны в материале об инфраструктуре локальных AI-агентов.
Какие бывают LLM
Классификация LLM полезна только вместе с задачей. Одна модель может одновременно относиться к нескольким группам.
Базовые и instruct-модели
Base model ориентирована на продолжение последовательности. Instruct model дополнительно настроена выполнять инструкции и вести диалог. Для прикладного ассистента обычно начинают с instruct-варианта, а базовая модель интереснее для исследований и собственного конвейера настройки.
Текстовые и мультимодальные
Текстовая модель принимает текстовые токены. Мультимодальная система может обрабатывать изображения, аудио или видео, но слово «мультимодальная» не говорит о качестве конкретной функции. Распознавание таблиц, мелкого текста и схем проверяют отдельными тестами.
Большие и малые языковые модели
SLM требует меньше памяти и вычислений, быстрее запускается на ограниченной платформе и может быть достаточной для классификации, извлечения или узкого ассистента. Более крупная LLM обычно дает больший запас универсальности, но повышает стоимость и задержку. Выбор делают по минимальной модели, которая проходит приемочные тесты.
Закрытые API и модели с доступными весами
Облачные LLM предоставляются как сервис: инфраструктурой управляет поставщик, а клиент оплачивает использование и следует условиям обработки данных. Модель с доступными весами можно развернуть локально при соблюдении лицензии. Доступность весов не всегда означает open source в полном смысле, поскольку лицензия, данные и код обучения могут оставаться закрытыми.
Универсальные и специализированные
Универсальная модель покрывает широкий набор задач. Специализированная может быть настроена на код, конкретный язык или предметную область. Российская LLM или модель с заявленной поддержкой русского языка все равно требует проверки на терминологии компании, документах, извлечении сущностей и фактической точности.
Локальная LLM или облачный API
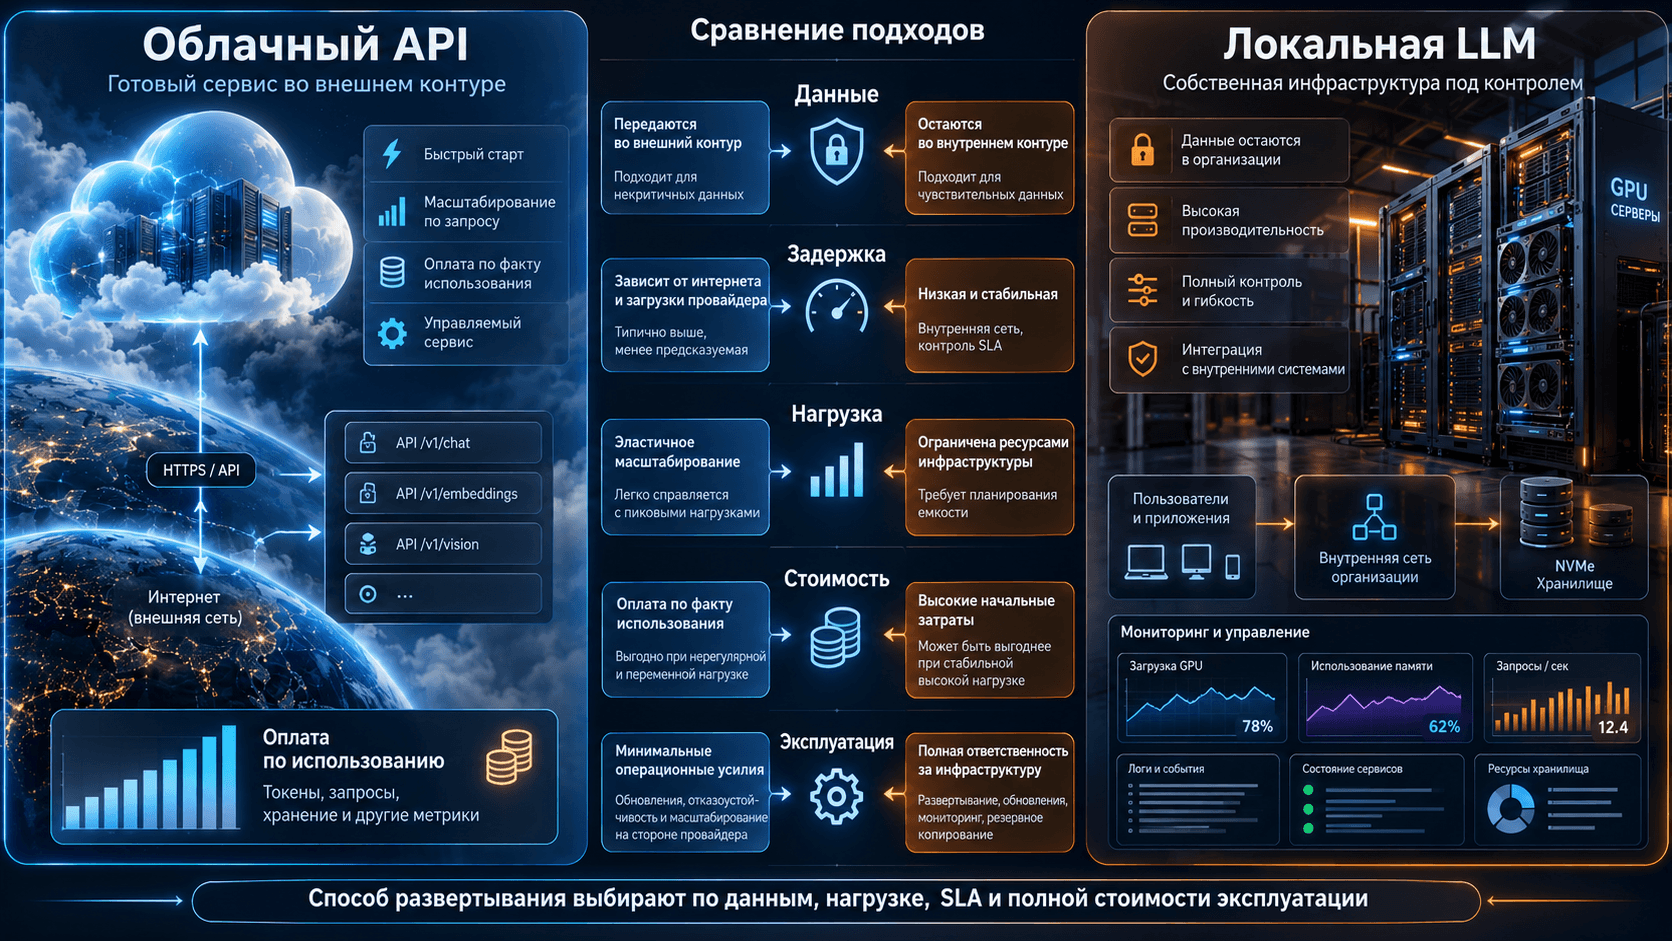
LLM API быстрее подключить для пилота: не нужно сразу покупать сервер, устанавливать serving и планировать GPU. Облачный сервис также проще масштабирует нерегулярную нагрузку. Цена и доступность зависят от провайдера, а данные проходят через его контур в соответствии с условиями сервиса.
Локальная LLM модель работает на инфраструктуре организации или в выделенном контуре. Это дает больше контроля над данными, версией модели, задержкой и емкостью, но переносит на владельца обновления, мониторинг, безопасность и расчет производительности.
Критерий | Облачный API | Локальная LLM |
|---|---|---|
Старт пилота | обычно быстрее | требуется развертывание модели и serving |
Капитальные затраты | минимальны на старте | нужны сервер, GPU и инфраструктура |
Переменная стоимость | зависит от объема токенов и тарифа | зависит от загрузки, электричества, поддержки и амортизации |
Контроль версии | определяется возможностями поставщика | версия и обновление контролируются владельцем |
Данные | передаются во внешний или выделенный контур по условиям сервиса | могут оставаться внутри локального контура |
Масштабирование | предоставляет сервис в пределах квот | требует запаса оборудования или расширения кластера |
Кастомизация | зависит от API | доступны собственный serving, квантование и адаптеры |
Эксплуатация | основная часть у поставщика | команда отвечает за весь стек |
Запуск LLM локально оправдан не только секретностью. Он бывает выгоден при устойчивой высокой нагрузке, строгой фиксации версии, требованиях к задержке или автономности. Для редких запросов и быстрого эксперимента API часто рациональнее. Для продакшена можно изучить отдельную категорию серверов для инференса LLM.
Планирование нельзя строить по числу сотрудников. Сто пользователей могут отправлять запросы раз в день или одновременно обрабатывать длинные документы. Методика перевода бизнес-нагрузки в токены, параллельность и SLA приведена в статье о локальной LLM для 100 сотрудников.
Какое оборудование нужно для LLM
Требования LLM зависят от режима. Инференс выполняет прямой проход и генерацию. Полное обучение дополнительно хранит градиенты, состояния оптимизатора и активации, поэтому требует намного больше памяти и межсоединений.
GPU и VRAM
GPU ускоряет матричные операции Transformer. VRAM хранит веса, KV cache, временные буферы и данные runtime. Грубая нижняя оценка размера весов выглядит так:
объем весов в байтах ≈ число параметров × битность / 8
Например, 8 миллиардов параметров при 16 битах занимают около 16 ГБ только для сырых весов. При 4 битах арифметическая оценка составляет около 4 ГБ. Реальный checkpoint и процесс требуют дополнительного места для служебных данных, масштабов квантования, буферов и KV cache. Качество и скорость квантованной модели проверяют на целевой задаче.
CPU и RAM
CPU обслуживает токенизацию, сетевые запросы, часть retrieval, подготовку batch и прикладную логику. При offload он также принимает часть вычислений или весов, но обмен с системной памятью может снизить скорость. LLM на CPU запустить можно, особенно малую и квантованную, однако приемлемая интерактивная задержка зависит от модели, пропускной способности памяти и длины контекста.
RAM нужна для ОС, serving, кэша файлов, загрузки checkpoint, offload, RAG и параллельных сервисов. Правило «RAM равна VRAM» ненадежно. Расчет делают по выбранному runtime и архитектуре развертывания.
NVMe, сеть и хранение
NVMe влияет на загрузку моделей, работу с индексами, кэш и конвейер обучения. Он не заменяет VRAM во время быстрого GPU-инференса. Для нескольких узлов критичны сеть, схема распределения модели и характер обмена. Высокая паспортная скорость GPU не поможет, если запросы задерживает retrieval, CPU или сеть.
Питание и охлаждение
Плотный GPU-сервер проверяют по мощности ускорителей, резервированию блоков питания, разъемам, тепловому пакету и воздушному потоку. Требования оценивают для стойки и помещения, а не только для одной карты.
Для инференса доступны разные масштабы. Компактный ASUS Ascent GX10 с 128 ГБ объединенной памяти представляет класс локальных систем для пилотов и ограниченных нагрузок.
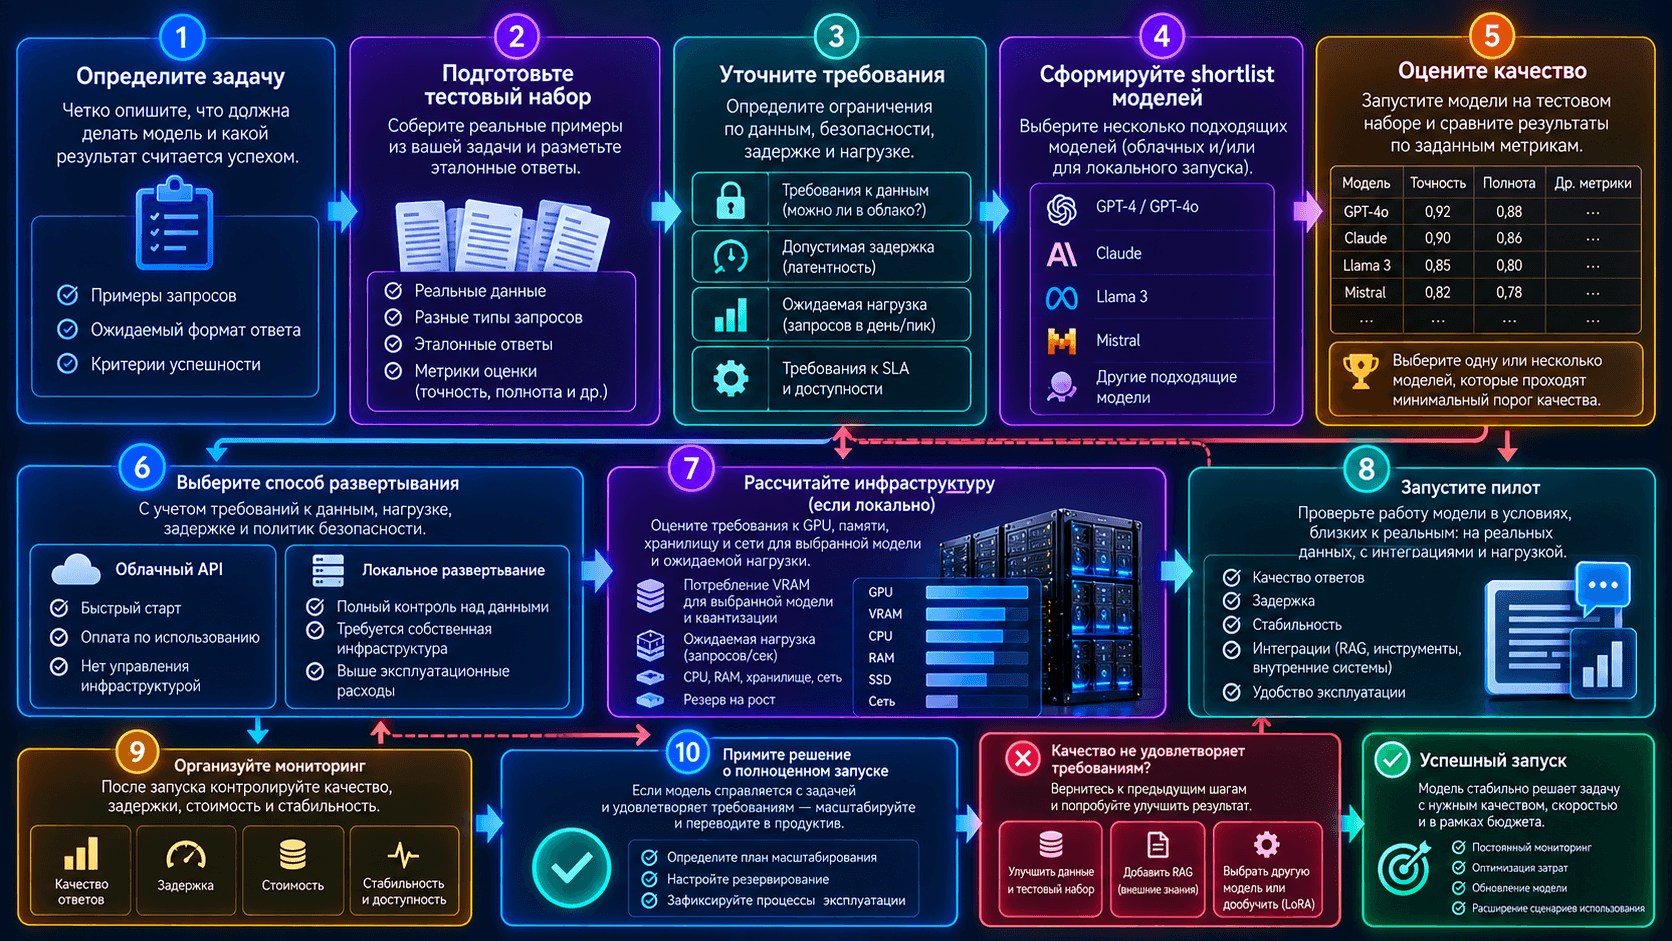
Как выбрать LLM для своей задачи
Запрос «какая LLM лучше» не имеет ответа без сценария и ограничений. Публичный LLM benchmark помогает сформировать короткий список, но его условия редко совпадают с корпоративными документами, языком, длиной контекста и требованиями к задержке.
Рабочий порядок выбора:
Опишите операцию. Что модель получает, какой результат должна вернуть, кто его проверяет и какой ущерб возможен при ошибке.
Соберите тестовый набор. Включите обычные, сложные, пограничные и нежелательные запросы на реальных обезличенных данных.
Зафиксируйте метрики. Оцените качество, долю неверных фактов, соблюдение формата, полноту, latency, throughput и стоимость запроса.
Сравните несколько моделей в одинаковых условиях. Используйте один шаблон промпта, одинаковый retrieval, длину ответа и параметры декодирования.
Выберите минимальную модель, которая проходит порог качества. Лишние параметры повышают требования к памяти и вычислениям.
Определите способ размещения. Сравните API, выделенное облако и локальную инфраструктуру по данным, SLA и полной стоимости.
Проведите нагрузочный тест. Измеряйте время до первого токена, скорость генерации, число одновременных запросов, хвостовую задержку и потребление памяти.
Настройте эксплуатацию. Нужны версии промптов и моделей, мониторинг качества, лимиты, журналирование и безопасный откат.
Сравнение LLM по одному числу tokens per second также ошибочно. Нужно фиксировать batch, длину входа и выхода, quantization, runtime, GPU, tensor parallelism и критерий качества. Подробная схема проверки приведена в материале как читать бенчмарки GPU для LLM.
Если одной GPU не хватает, модель можно распределить, но добавление ускорителей не дает линейного роста автоматически. На результат влияют NVLink или PCIe, сеть между узлами, parallelism, batch и коммуникационные накладные расходы. Для выбора масштаба используйте руководство сколько GPU нужно для LLM и когда выбирать сервер на 2, 4 или 8 ускорителей.
Типичные ошибки при внедрении LLM
Выбирать модель по числу параметров
Параметры влияют на размер, но не заменяют тест. Сравнивайте ответы на своих данных, включая русский язык, длинные документы и требуемый формат.
Путать RAG с дообучением
RAG передает актуальные документы во входной контекст. Дообучение меняет поведение модели. Если требуется ответ по изменяемому регламенту со ссылкой на источник, сначала рассматривают retrieval, а не обучение весов.
Считать контекст бесплатной памятью
Длинный промпт увеличивает prefill, расход KV cache и стоимость API. Нерелевантные фрагменты способны ухудшить ответ. Документы нужно отбирать, ранжировать и укладывать в контролируемый бюджет токенов.
Покупать сервер до выбора модели
Сначала определяют качество, bitness, runtime, контекст, параллельность и SLA. После этого рассчитывают VRAM, число GPU, RAM, CPU, NVMe и сеть. Обратный порядок создает риск простаивающего или недостаточного оборудования.
Оценивать только среднюю скорость
Пользователь чувствует время до первого токена, а сервис ограничивает хвостовая задержка под одновременной нагрузкой. Среднее значение скрывает очередь и редкие медленные запросы.
Давать агенту лишние права
Модель не должна самостоятельно выполнять необратимые операции без валидации. Инструменты ограничивают по функции, объектам и ролям, а критичные действия требуют подтверждения.
FAQ
Как расшифровывается LLM?
LLM означает Large Language Model, по-русски «большая языковая модель». Это нейросетевая модель, обученная работать с последовательностями токенов и генерировать продолжение с учетом контекста.
Что такое LLM в IT простыми словами?
Это программная модель, которая получает текст, оценивает вероятное продолжение и строит ответ токен за токеном. Чат, поиск по документам, память и доступ к другим сервисам добавляет приложение вокруг модели.
Что такое токен в LLM?
Токен представляет единицу, с которой работает модель. Это может быть слово, часть слова, символ или знак препинания. Токенизатор каждой модели делит текст по своим правилам.
Как LLM понимает смысл текста?
Модель преобразует токены в векторы и обрабатывает их слоями Transformer, обученными на больших массивах последовательностей. В практическом смысле она выявляет и применяет устойчивые связи. Это не доказывает наличие человеческого понимания или сознания.
Что такое параметры LLM?
Параметры представляют обучаемые числовые значения нейросети. Во время обучения они меняются так, чтобы модель лучше предсказывала токены. Большее число параметров увеличивает объем и вычисления, но не гарантирует лучшего ответа на конкретную задачу.
Что такое контекст LLM?
Контекстом называют токены, доступные модели в текущем запросе: инструкции, вопрос, история, документы и сгенерированная часть ответа. Максимальный размер задается контекстным окном, а реальное качество на длинном вводе проверяется отдельно.
Что такое RAG для LLM?
RAG сначала находит релевантные фрагменты во внешней базе знаний, затем передает их модели вместе с запросом. Это помогает работать с актуальными корпоративными данными и ссылаться на источники без изменения весов LLM.
Можно ли запустить LLM на обычном ПК?
Да, если модель и степень квантования помещаются в доступную RAM или VRAM, а требуемая скорость невысока. Малая локальная LLM на ПК подходит для эксперимента. Продакшен с длинным контекстом и параллельными пользователями требует отдельного нагрузочного расчета.
Можно ли запускать LLM на CPU без видеокарты?
Можно. Скорость зависит от размера модели, формата весов, пропускной способности памяти, runtime и длины запросов. CPU-инференс бывает приемлем для малых квантованных моделей и фоновой обработки, но интерактивный сервис часто выигрывает от GPU.
Почему LLM придумывает факты?
Модель выбирает статистически подходящее продолжение и не обязана иметь подтверждающий источник. Для снижения риска используют RAG, проверенные инструменты, ограничения формата, верификацию цитат и контроль человеком. Полностью исключить ошибки одной настройкой temperature нельзя.
Что лучше: локальная LLM или облачная?
Облачная модель удобнее для быстрого пилота и нерегулярной нагрузки. Локальная дает контроль над данными, версией и ресурсами, но требует оборудования и эксплуатации. Решение принимают по безопасности, качеству, задержке, параллельности и полной стоимости.
Нужно ли дообучать LLM на документах компании?
Не всегда. Для ответов по изменяемым документам обычно начинают с RAG. Дообучение выбирают, когда нужно устойчиво изменить формат, стиль или поведение и это подтверждено тестами. Часто эти подходы применяют вместе.
Подбор инфраструктуры для LLM
Чтобы рассчитать сервер для LLM, нужны не только название модели и число параметров. Зафиксируйте формат весов, runtime, длину входа и ответа, число одновременных запросов, целевое время до первого токена, скорость генерации, требования к доступности и правила работы с данными.
Start Server проектирует платформы для локального инференса, RAG и обучения: подбирает GPU и CPU, рассчитывает VRAM и RAM, проверяет PCIe и межсоединения, NVMe, сеть, питание и охлаждение. Начать можно с каталога AI-серверов, а финальную конфигурацию стоит выбирать после теста модели на вашей нагрузке.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


