Представим два результата:
Сервер A — 800 tok/s
Сервер B — 600 tok/s
На первый взгляд сервер A быстрее. Но без описания теста эти цифры почти ничего не доказывают.
Неизвестно:
какая модель использовалась;
какая revision;
одинаковая ли квантизация;
какова длина входа и ответа;
сколько запросов выполнялось одновременно;
как формировалась нагрузка;
использовался ли prefix cache;
где находился benchmark client;
сколько запросов завершилось ошибкой;
что именно в каждом тесте называется tok/s.
Поэтому хороший benchmark LLM-сервера начинается не с команды запуска.
Он начинается с протокола:
Главный принцип прост:
Сравнивать нужно не отдельные цифры, а воспроизводимые эксперименты.
Почему одного tokens/s недостаточно
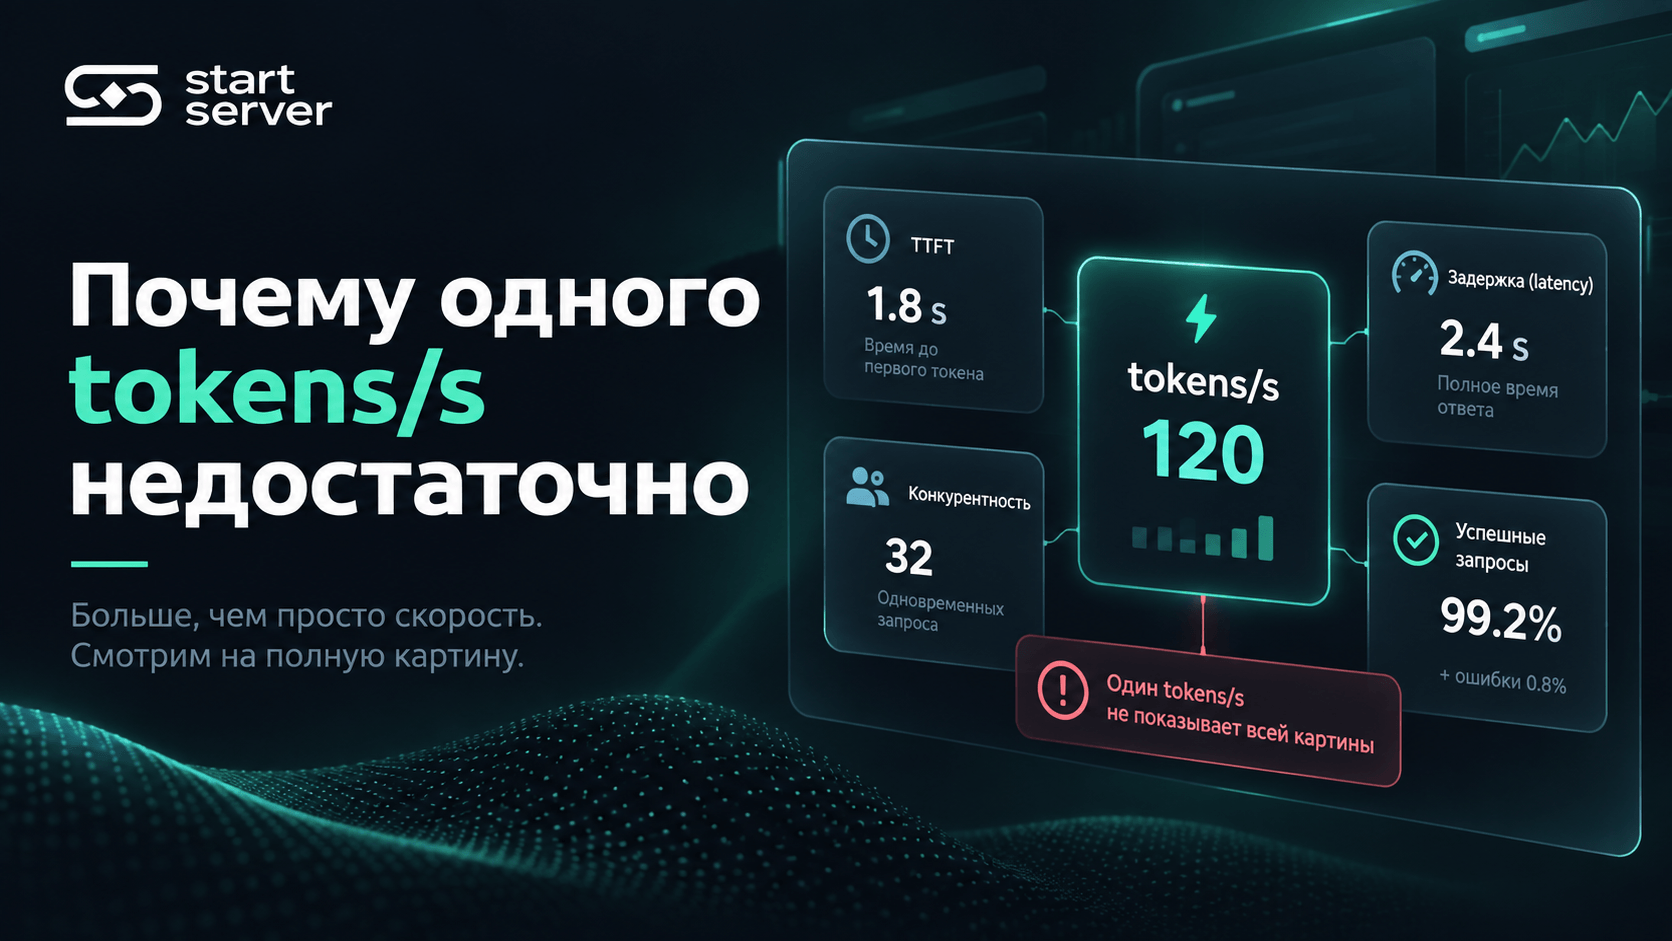
Tokens per second может обозначать разные показатели.
Например:
aggregate output throughput всего сервера;
total token throughput с учётом input и output;
скорость генерации отдельного запроса;
величину, рассчитанную из задержки между токенами.
Это разные метрики.
Поэтому таблица:
Server | Performance |
A | 800 tok/s |
B | 600 tok/s |
становится полезной только после ответа на три вопроса:
Какая нагрузка подавалась?
Какой latency получен?
Что именно означает throughput?
Сначала зафиксируйте System Manifest
До benchmark запишите конфигурацию системы.
Поле | Значение |
Server/platform | |
GPU SKU × количество | |
GPU topology | |
Driver/backend | |
Serving engine/version | |
Model ID/revision | |
Precision/quantization | |
Tensor/pipeline parallelism | |
Engine configuration | |
Prefix-cache configuration |
Это особенно важно для A/B теста.
Если одновременно меняются:
GPU;
serving engine;
model revision;
квантизация;
то эксперимент сравнивает уже не только GPU.
Benchmark client — тоже часть эксперимента
Online-serving latency часто измеряется с точки зрения клиента.
Поэтому фиксируйте:
Поле | Значение |
Benchmark tool/version | |
Client host | |
Расположение | localhost / LAN / remote |
Network path | |
Endpoint | |
Streaming | |
Command/config |
Результат с client на localhost нельзя молча считать эквивалентным тесту через удалённую сеть.
Это особенно важно для TTFT и end-to-end latency.
Workload — это не только название модели
Формулировка:
benchmark модели X
недостаточна.
На результат влияют как минимум:
input-length distribution;
output-length distribution;
тип запросов;
request rate;
concurrency;
характер arrivals;
cache reuse.
Поэтому workload тоже должен иметь собственный manifest.
Фиксируйте распределение input и output
Длинный prompt увеличивает prefill work.
Длинная генерация увеличивает decode work.
Поэтому нельзя напрямую сравнивать:
тест с короткими запросами
и:
тест с длинным контекстом
как одну и ту же нагрузку.
Минимальный профиль:
Поле | Значение |
Dataset/profile | |
Input-length distribution | |
Output-length distribution | |
Prefix pattern | |
EOS policy | |
Seed |
Лучше сохранять distribution, а не только среднее значение.
Dataset входит в benchmark identity
Есть несколько нормальных подходов.
Production trace
Обезличенная выборка реальных запросов.
Плюс — высокая близость к реальному traffic.
Минус — сложнее распространять и повторять.
Curated workload
Специально собранный representative набор.
Его проще контролировать между A/B runs.
Synthetic workload
Искусственные prompts и lengths.
Такой workload удобно воспроизводить и использовать для sweeps.
Но synthetic benchmark не следует выдавать за полную имитацию production traffic.
Request rate и concurrency — не одно и то же
Эти понятия часто смешивают.
Request rate
Сколько новых requests поступает в систему за единицу времени.
Concurrency
Сколько requests одновременно находятся in flight.
Например, одинаковые 10 RPS могут создать разный concurrency на двух системах, если их latency различается.
Поэтому:
10 RPS ≠ concurrency 10.
В benchmark protocol нужно фиксировать оба параметра, если они используются.
Что означает максимальный request rate
В инструментах вроде vllm bench serve режим с бесконечным request rate означает, что запросы подаются максимально агрессивно, фактически без обычных интервалов arrivals.
Такой сценарий полезен для:
saturation test;
peak throughput;
stress load.
Но это не автоматически representative production workload.
Он отвечает на вопрос:
Burstiness тоже влияет на результат
Одинаковый average RPS может выглядеть по-разному.
В одном workload запросы приходят равномерно.
В другом — короткими bursts.
Burst traffic способен увеличивать:
queueing;
TTFT;
tail latency.
Если production traffic имеет bursts, этот параметр полезно включить в test profile.
Что такое TTFT
TTFT — Time to First Token.
В online benchmark его полезно определять как:
время от отправки request benchmark-клиентом до получения первого output.
Это важная граница.
TTFT не равен чистому GPU prefill time.
Client-observed TTFT может включать:
network latency;
frontend/API processing;
queueing;
prompt processing;
генерацию первого output.
Поэтому при сравнении двух тестов нужно знать, где именно начинается и заканчивается measurement.
Что такое TPOT
TPOT — Time Per Output Token.
В актуальном vllm bench serve request-level TPOT рассчитывается как:
TPOT = (E2E latency − TTFT) / (output tokens − 1)
По смыслу это усреднённая decode latency на output token после первого.
TPOT полезен, когда нужно понять, с какой скоростью продолжается генерация после появления первого ответа.
Что такое ITL
В текущем vLLM ITL — Inter-Token Latency — строится по интервалам между последовательными streamed outputs.
Это другая measurement semantics.
Поэтому:
TPOT ≠ ITL.
При обычном decoding их значения могут быть близки, но это не делает определения одинаковыми.
Почему TPOT и ITL могут различаться
Представим, что один streamed chunk содержит несколько tokens.
Тогда:
ITL измеряет gap до следующего streamed output;
TPOT распределяет decode duration по фактическому числу output tokens.
Одинаковое название ITL в разных tools может означать разное
Это одна из самых опасных ловушек при сравнении чужих benchmark.
В vLLM:
ITL относится к интервалам между streamed outputs.
В текущем NVIDIA AIPerf метрика с названием Inter Token Latency по умолчанию использует request-level нормализованную формулу вида:
(request latency − TTFT) / (output sequence length − 1)
По смыслу она ближе к тому, что vLLM называет TPOT.
А реальные интервалы между streamed chunks в AIPerf вынесены в отдельную Inter Chunk Latency.
Вывод:
Название метрики не является её определением.
Перед сравнением результатов разных tools проверяйте:
формулу;
measurement boundary;
aggregation method.
E2E latency — отдельная метрика
End-to-end latency отвечает на вопрос:
сколько времени клиент ждёт полный response?
Она не заменяет:
TTFT;
TPOT;
ITL.
Эти метрики описывают разные части user experience.
Почему mean недостаточно
Предположим:
средний TTFT = 300 мс.
Это ещё не показывает, насколько стабильно система работает.
Для latency-sensitive workload обычно полезно смотреть percentiles:
p50;
p95;
p99 или другой tail percentile.
Но универсального требования:
любой benchmark обязан публиковать p99
нет.
Нужные percentiles определяются workload и SLO.
Throughput тоже нужно определить
Для online LLM benchmark полезно разделять несколько показателей.
Request throughput
Число успешно завершённых requests в секунду.
Output token throughput
Количество фактически сгенерированных output tokens в секунду.
Total token throughput
Input + output tokens в секунду.
Поэтому строка:
1500 tok/s
без указания типа throughput практически бесполезна.
Aggregate throughput — не скорость одного пользователя
Сервер может обрабатывать много requests одновременно и показывать высокий aggregate output throughput.
Это не означает, что отдельный request генерируется с такой же скоростью.
Поэтому:
Это разные характеристики системы.
Throughput нужно читать вместе с latency
При росте concurrency batching может повышать aggregate throughput.
Но одновременно могут ухудшаться:
TTFT;
TPOT;
E2E latency;
tail percentiles.
Поэтому корректный result выглядит не так:
throughput = N.
А так:
Failed requests — обязательная часть результата
Допустим, система показывает высокий throughput, но часть requests завершилась:
timeout;
error;
rejection.
Если опубликовать только tok/s, результат может выглядеть лучше, чем реальный service behaviour.
Поэтому рядом с performance metrics нужно показывать минимум:
Metric | Result |
Successful requests | |
Failed requests | |
Request throughput | |
Output token throughput | |
Total token throughput |
При необходимости можно дополнительно считать failure rate.
Почему failures особенно важны около saturation
Система может выглядеть быстрой по успешно завершившимся requests и одновременно уже сбрасывать часть нагрузки.
Поэтому capacity test не должен считать failures побочным логом.
Это часть результата.
Что такое goodput
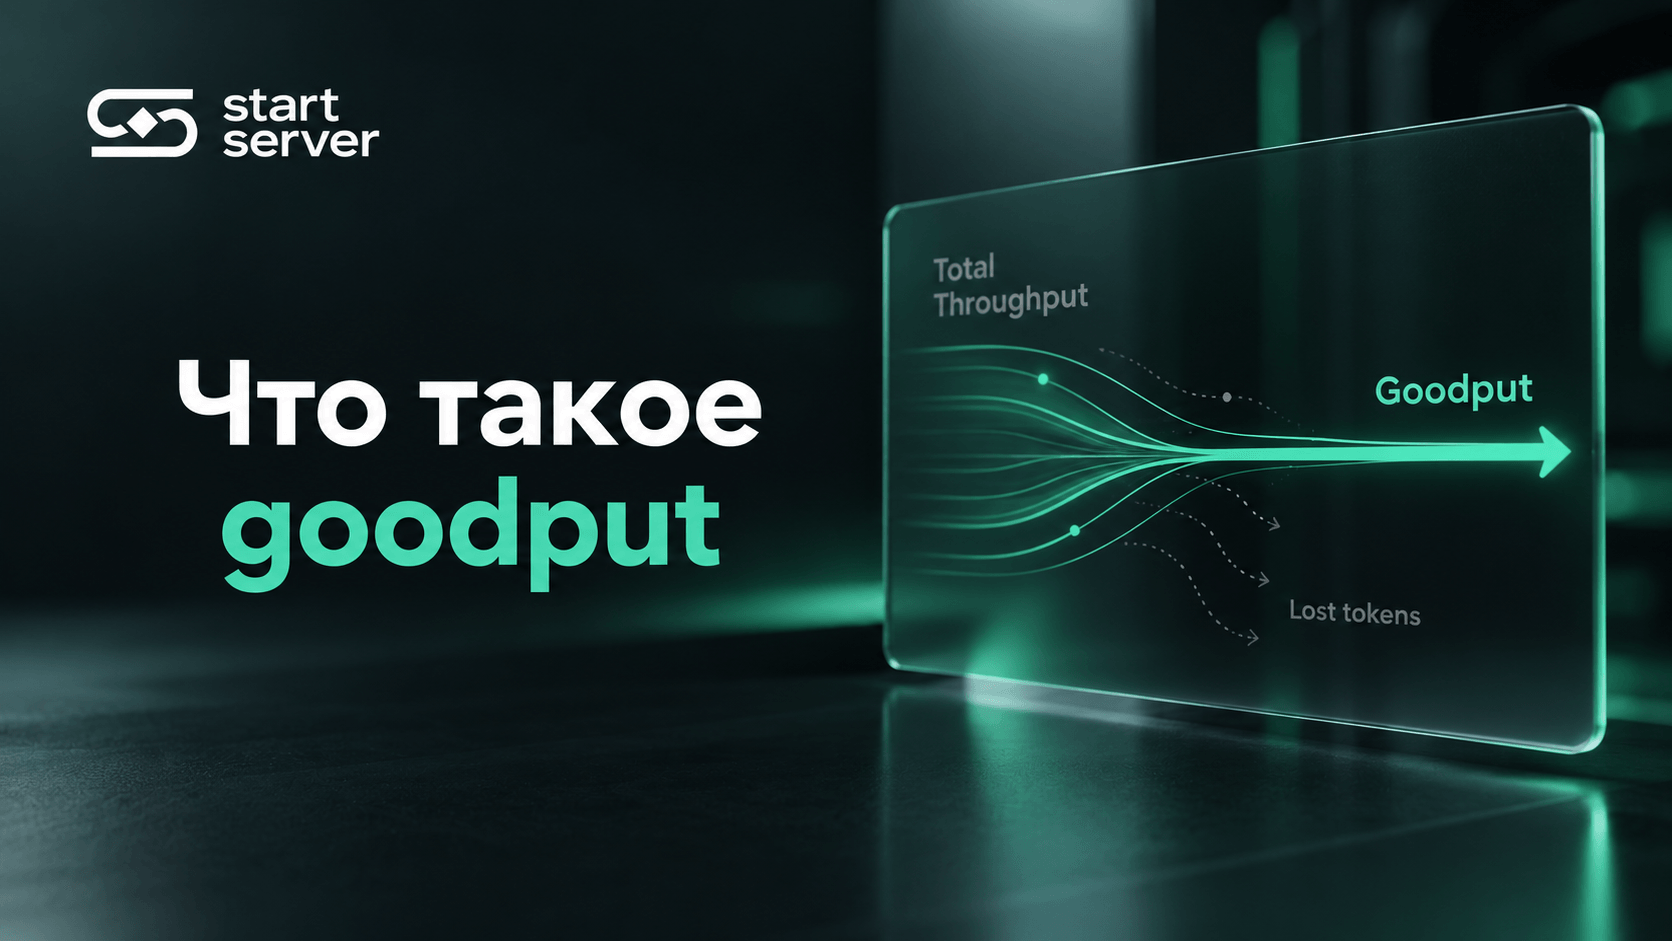
Если для workload определён latency SLO, полезно использовать goodput.
Упрощённо:
В текущем vLLM goodput можно задавать через ограничения на:
TTFT;
TPOT;
E2E latency.
Это отвечает на более прикладной вопрос:
не сколько requests система способна принять вообще, а сколько она обслуживает в рамках заданного SLO?
В других benchmark tools набор и названия SLO metrics могут отличаться, поэтому определения снова нужно фиксировать в protocol.
Peak throughput не равен SLO-compliant capacity
Представим, что сервер достигает максимального throughput только при глубокой очереди.
Если TTFT при этом превышает требования приложения, peak result может быть бесполезен для production.
Поэтому при наличии SLO лучше спрашивать:
какой goodput система обеспечивает при допустимой latency?
а не только:
какой maximum tok/s?
Warmup нужно определить заранее
Benchmark может измерять разные режимы.
Cold-start test
В measurement входят initial effects:
initialization;
compilation;
cache creation;
другие one-time операции.
Steady-state test
Система предварительно прогрета, а warmup находится вне measured window.
Оба сценария допустимы.
Но нельзя смешивать их результаты без явной маркировки.
Универсального числа warmup requests нет
Нельзя задать правило:
перед любым LLM benchmark выполнить ровно N warmup requests.
Benchmark tool может позволять указать количество warmups, но конкретное значение зависит от цели теста.
Protocol должен фиксировать:
был ли warmup;
сколько requests использовалось;
входили ли они в measured window.
Prefix cache может неожиданно ускорить повторный run
Это особенно важный источник benchmark error.
Synthetic workload часто воспроизводится через fixed random seed.
Если повторный run отправляет те же prompts, а сервер сохранил prefix cache, часть вычислений может быть переиспользована.
Тогда:
Run 2 быстрее Run 1,
хотя hardware и software не изменились.
Если cache reuse не был частью test design, результаты уже не независимы.
Fixed seed не означает independent runs
Fixed seed полезен:
он позволяет повторить synthetic workload.
Но именно поэтому второй запуск может снова содержать те же prefixes.
Получается важная граница:
Для независимых повторов нужно отдельно определить cache/reset policy.
Shared prefixes могут работать даже внутри одного run
Даже полный reset между A/B runs не гарантирует cache-neutral workload.
Если сами prompts внутри dataset имеют общий длинный prefix, cache hits могут возникать уже внутри одного benchmark.
Поэтому в Workload Profile полезно фиксировать:
характер shared prefixes.
Prefix caching не нужно всегда отключать
Prefix reuse — реальная serving optimization.
Если application постоянно использует:
общий system prompt;
повторяемый context;
одинаковый длинный prefix,
cache-aware benchmark может быть более representative, чем искусственно cache-neutral test.
Есть два валидных сценария.
Cache-neutral
Хотим исключить unintended reuse.
Cache-aware
Хотим воспроизвести реальный workload с shared prefixes.
Главное:
cache policy должна быть известна до теста.
Как контролировать cache effect
В зависимости от задачи можно:
менять seed;
reset/restart server;
использовать benchmark sweep с очисткой cache между runs;
сознательно сохранять prefix reuse.
Нет одного универсального способа.
Важно лишь, чтобы A и B тестировались по одной согласованной policy.
Сколько requests нужно запускать
Универсального числа нет.
Количество requests влияет на:
длительность benchmark;
стабильность средних;
количество observations для tail percentiles.
Поэтому в protocol фиксируются:
number of prompts;
run duration, если применимо;
repeat count.
Default benchmark tool не является методологической рекомендацией.
Сколько раз повторять benchmark
Некоторые инструменты или sweep workflows используют несколько повторов по умолчанию.
Но:
default = 3
не означает:
три запуска статистически достаточны для любого эксперимента.
Количество repeats должно соответствовать вариативности и цели теста.
Для capacity полезнее несколько load points
Если задача — найти границу capacity, одна точка часто даёт слишком мало информации.
Полезнее построить несколько runs:
Тогда видно, как одновременно меняются:
throughput;
TTFT;
TPOT;
failures.
Но load sweep не обязателен, если задача — проверить одну заранее согласованную acceptance point.
Порядок A/B runs тоже может влиять
При длительных тестах полезно продумать порядок.
Например:
A → B → A → B
может лучше выявить temporal drift, чем:
все A, затем все B.
Это методический вариант, а не обязательное правило.
Сохраняйте raw results
Финальная таблица — не единственный артефакт benchmark.
Полезно сохранять:
exact command/config;
result JSON;
metadata;
detailed per-request data, если нужны;
errors.
В vllm bench serve для этого существуют возможности сохранения result и detailed result.
Raw evidence позволяет позднее проверить:
actual output lengths;
outliers;
failed requests;
metric calculations.
Добавляйте metadata
К benchmark result полезно привязать:
experiment ID;
server/BOM ID;
driver;
serving engine version;
model revision;
cache policy.
Server-side metrics не заменяют client-side benchmark
Serving engine может отдельно показывать:
queue time;
prefill time;
decode time;
KV-cache utilization;
scheduler state.
Эти данные полезны для диагностики.
Но если пользовательский SLO измеряется со стороны клиента, server instrumentation — другой measurement point.
Практичная граница:
Client metrics
Что реально наблюдает benchmark client.
Server metrics
Почему такой результат мог получиться.
Не смешивайте их без явного обозначения.
Performance benchmark не доказывает качество модели
Это особенно важно, если A/B сравнение меняет:
quantization;
model revision;
speculative decoding;
другие approximation techniques.
Система может стать быстрее и одновременно изменить output behaviour.
Поэтому:
Performance qualification
Измеряет скорость и capacity.
Quality evaluation
Проверяет приемлемость model output.
Это разные эксперименты.
Как честно сравнить два LLM-сервера
Перед A/B выводом выполните Comparison Gate.
Параметр | Server A | Server B | Совпадает? |
Model/revision | |||
Precision/quantization | |||
Serving engine/version | |||
Input distribution | |||
Output distribution | |||
Dataset | |||
Endpoint | |||
Request rate | |||
Max concurrency | |||
Burstiness | |||
Warmup policy | |||
Cache policy | |||
Benchmark client | |||
Metric definition |
Несовпадение не обязательно делает experiment неправильным.
Но оно меняет допустимый вывод.
Например:
система A с engine X быстрее системы B с engine Y
может быть корректным conclusion.
А вот:
GPU A на 30% быстрее GPU B
требует гораздо более чистого design.
LLM Server Benchmark Protocol
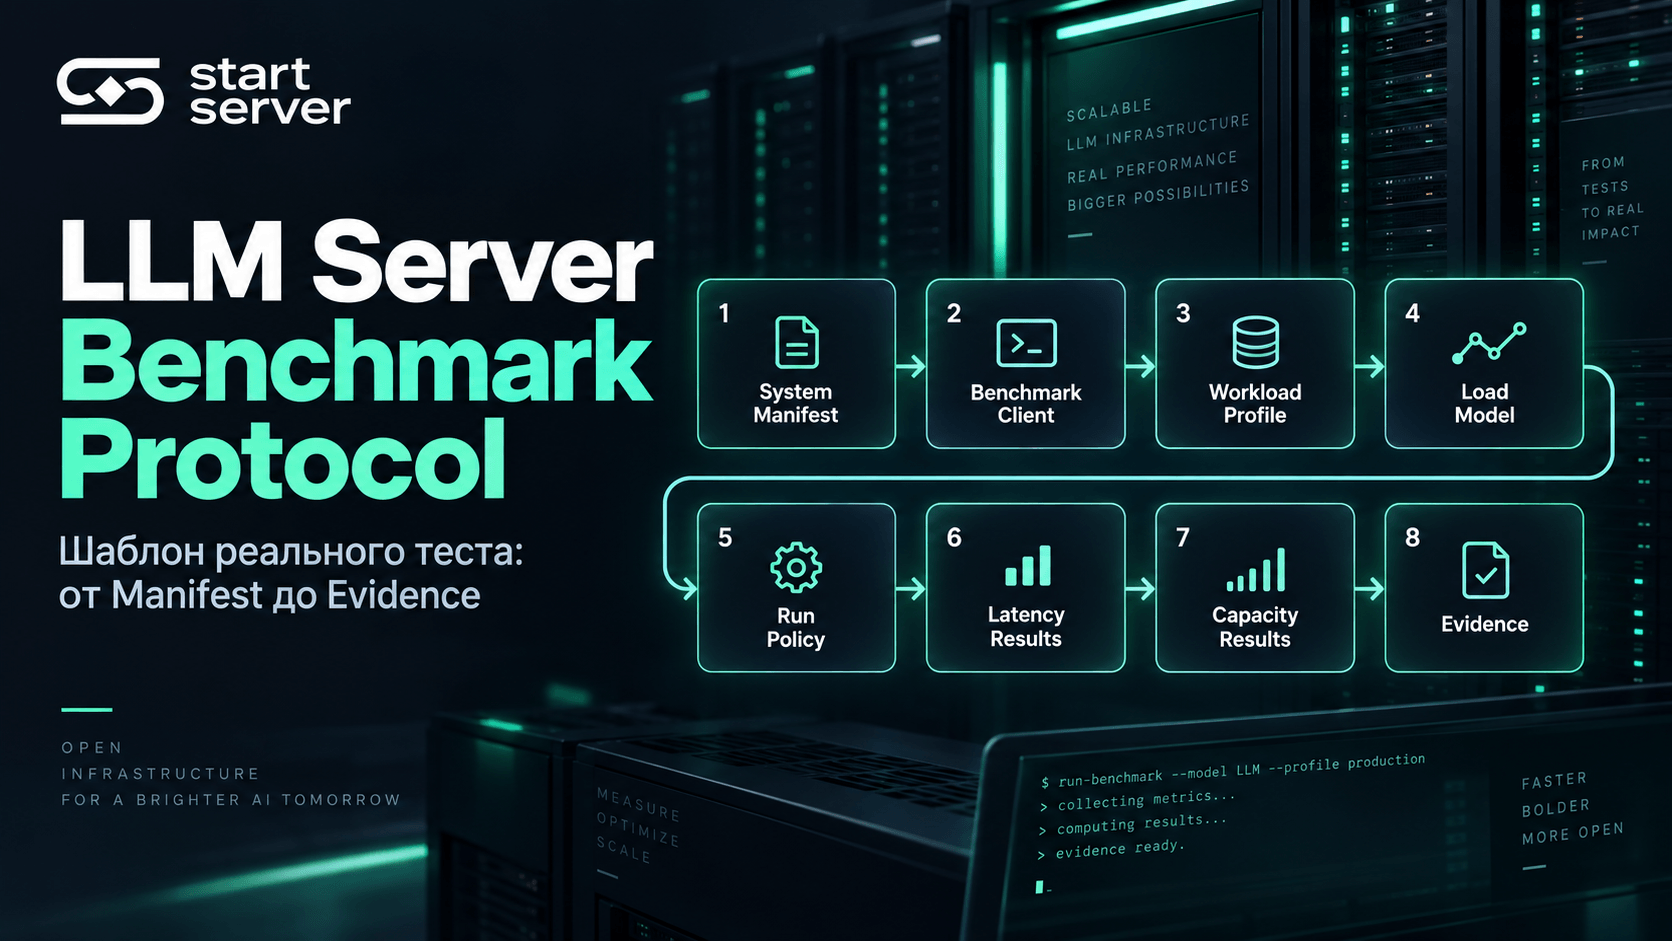
Ниже — шаблон для реального теста.
1. System Manifest
Поле | Значение |
Server/platform | |
GPU SKU × count | |
GPU topology | |
Driver/backend | |
Serving engine/version | |
Model/revision | |
Precision/quantization | |
Parallelism | |
Engine configuration | |
Prefix-cache configuration |
2. Benchmark Client
Поле | Значение |
Benchmark tool/version | |
Client host | |
Local / LAN / remote | |
Network path | |
Endpoint | |
Streaming | |
Benchmark config |
3. Workload Profile
Поле | Значение |
Dataset/profile | |
Dataset revision/path | |
Seed | |
Input-length distribution | |
Output-length distribution | |
Shared-prefix pattern | |
EOS policy | |
Request type |
4. Load Model
Поле | Значение |
Request rate | |
Max concurrency | |
Burstiness | |
Ramp/load schedule, если используется | |
Number of prompts |
5. Run Policy
Поле | Значение |
Cold / steady state | |
Warmup policy | |
Cache reset/reuse policy | |
Number of runs | |
Run order | |
Raw result | save / no |
Detailed result | save / no |
6. Latency Results
Metric | Mean | p50 | p95 | p99/other |
TTFT | ||||
TPOT | ||||
ITL | ||||
E2E latency |
7. Capacity Results
Metric | Result |
Successful requests | |
Failed requests | |
Request throughput | |
Output token throughput | |
Total token throughput | |
Goodput, если используется | |
Benchmark duration |
8. Evidence
Артефакт | Сохранён |
Benchmark config | |
System metadata | |
Result JSON | |
Detailed result | |
Errors | |
Relevant server logs |
Минимальный A/B protocol
Если полноценный research benchmark не нужен, оставьте минимум.
Зафиксировать
hardware configuration;
model/revision;
serving engine/version;
precision/quantization;
input/output profile;
request rate или concurrency;
warmup;
cache policy;
benchmark client/tool.
Измерить
TTFT;
E2E;
TPOT или другую точно определённую decode metric;
request/output throughput;
successful/failed requests.
Сохранить
exact command/config;
result JSON;
metadata.
Перед conclusion
Пройти Comparison Gate.
Даже такой сокращённый protocol значительно полезнее таблицы вида:
GPU X — N tok/s.
Как использовать benchmark при выборе GPU-сервера
Если performance target известен заранее, benchmark protocol можно определить ещё до заказа.
Вместо:
сервер должен быть быстрым для LLM
зафиксировать:
model/revision;
precision/quantization;
representative workload;
load model;
latency metrics;
throughput definition;
acceptance thresholds.
Сами thresholds должны происходить из требований проекта — например, workload/SLO или предварительных измерений.
Какой вопрос задавать поставщику
Не только:
сколько токенов в секунду выдаёт сервер?
Полезнее:
какой representative workload сервер обслуживает при согласованной latency и без недопустимого числа failed requests?
А если SLO уже определён:
После определения benchmark protocol можно переходить к подбору серверов для production LLM-инференса.
Главное
В LLM benchmark сравниваются не красивые цифры.
Сравниваются эксперименты.
До запуска нужно зафиксировать:
System
→ Model
→ Workload
→ Load Model
→ Warmup / Cache Policy
→ Metric Definitions.
После запуска сохранить:
Latency Distribution
Throughput
Successful / Failed Requests
Raw Evidence.
И только затем выполнить Comparison Gate.
Ключевые границы:
TTFT ≠ GPU prefill.
TPOT ≠ vLLM ITL.
vLLM ITL ≠ AIPerf ITL по определению.
Metric name ≠ Metric definition.
Output tok/s ≠ Total tok/s.
Aggregate tok/s ≠ per-user generation speed.
Request rate ≠ Concurrency.
Fixed seed ≠ Independent run.
Cache-neutral benchmark ≠ Cache-aware benchmark.
Peak throughput ≠ SLO-compliant capacity.
Throughput без failed requests ≠ полный результат.
Performance benchmark ≠ Quality evaluation.
Different serving stacks ≠ Pure GPU comparison.
Хороший benchmark — это эксперимент, который можно повторить, проверить и объяснить.
Поэтому публикационный результат должен содержать не только итоговую таблицу, но и:
Manifest + Workload + Run Policy + Results + Raw Evidence.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


