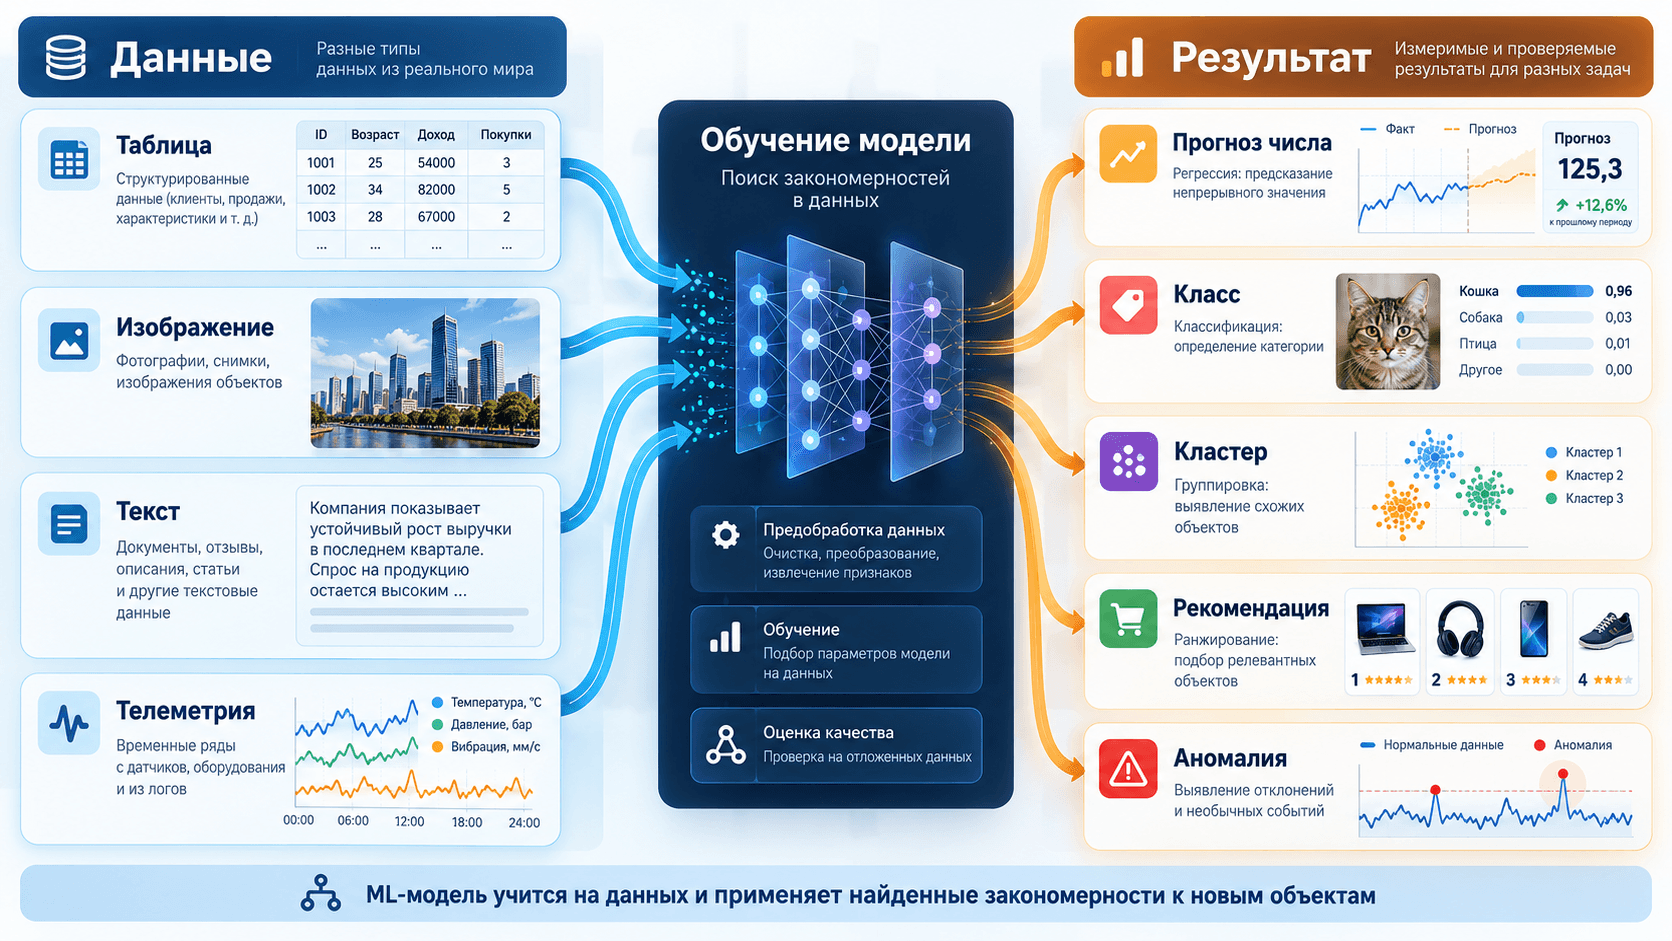
Машинное обучение, или Machine Learning, это способ создавать программы, которые находят закономерности в данных и используют их для прогноза, классификации, рекомендации или генерации результата. Разработчик не записывает отдельное правило для каждого возможного случая. Он задает данные, признаки, целевую функцию и процесс обучения, а алгоритм подбирает параметры модели.
Простой пример: системе нужно определять нежелательные письма. В обычной программе можно вручную составить список подозрительных слов и адресов. В ML-системе модель обучается на письмах с известными метками «спам» и «не спам», связывает признаки с ответом и затем оценивает новые сообщения. Порог, после которого письмо отправляется в спам, по-прежнему задают люди с учетом цены ошибок.
Машинное обучение не сводится к нейросетям. Линейная и логистическая регрессия, деревья, случайный лес, бустинг, SVM и k-NN тоже относятся к ML. Нейронные сети полезны для изображений, текста и аудио, но для небольшой таблицы первым кандидатом часто становится более простая модель.
Машинное обучение простыми словами
Суть машинного обучения можно выразить одной схемой:
данные + правильная постановка задачи + алгоритм обучения = модель, проверяемая на новых данных
Модель представляет математическую зависимость, полученную в процессе обучения. На вход она принимает признаки объекта, а на выходе возвращает прогноз. Признаком может быть температура оборудования, сумма операции, возраст документа, набор слов или пиксели изображения. Целевая переменная, или label, содержит то, что модель должна предсказать при обучении с учителем.
Обучение означает подбор параметров, уменьшающих ошибку на обучающих примерах. Инференс означает применение уже обученной модели к новым данным. Эти этапы нельзя смешивать: обучение обычно тяжелее по вычислениям, а для инференса важнее стабильная задержка, пропускная способность и доступность сервиса.
Искусственный интеллект, машинное обучение и нейросети
Понятия связаны как области разного масштаба.
Термин | Что означает | Пример |
|---|---|---|
Искусственный интеллект, AI | широкая область систем, выполняющих задачи восприятия, прогнозирования, планирования или генерации | экспертная система, оптимизатор маршрутов, ML-сервис |
Машинное обучение, ML | подход, при котором поведение модели формируется по данным | прогноз отказа по телеметрии |
Нейронная сеть | класс моделей из связанных вычислительных слоев с обучаемыми параметрами | распознавание объектов на изображении |
Глубокое обучение, Deep Learning | обучение многослойных нейронных сетей и представлений | компьютерное зрение, речь, LLM |
Data Science | более широкий процесс получения выводов из данных, включающий статистику, аналитику, эксперименты и ML | анализ причин оттока и построение прогноза |
Машинное обучение является частью искусственного интеллекта, а нейронные сети являются одним из классов ML-моделей. Глубокое обучение относится к нейронным сетям. При этом не вся аналитика использует ML, и не вся AI-система обязана обучаться по данным.
Большая языковая модель представляет частный класс глубоких нейронных сетей. Чат-бот вокруг нее дополнительно содержит интерфейс, правила, историю диалога и интеграции. Поэтому запросы «ИИ», «ML», «нейросеть» и «LLM» нельзя использовать как взаимозаменяемые термины.
Как работает машинное обучение
Работа начинается до выбора алгоритма. Если неверно определен объект прогноза или правильный ответ недоступен в момент принятия решения, даже технически точная модель окажется бесполезной.
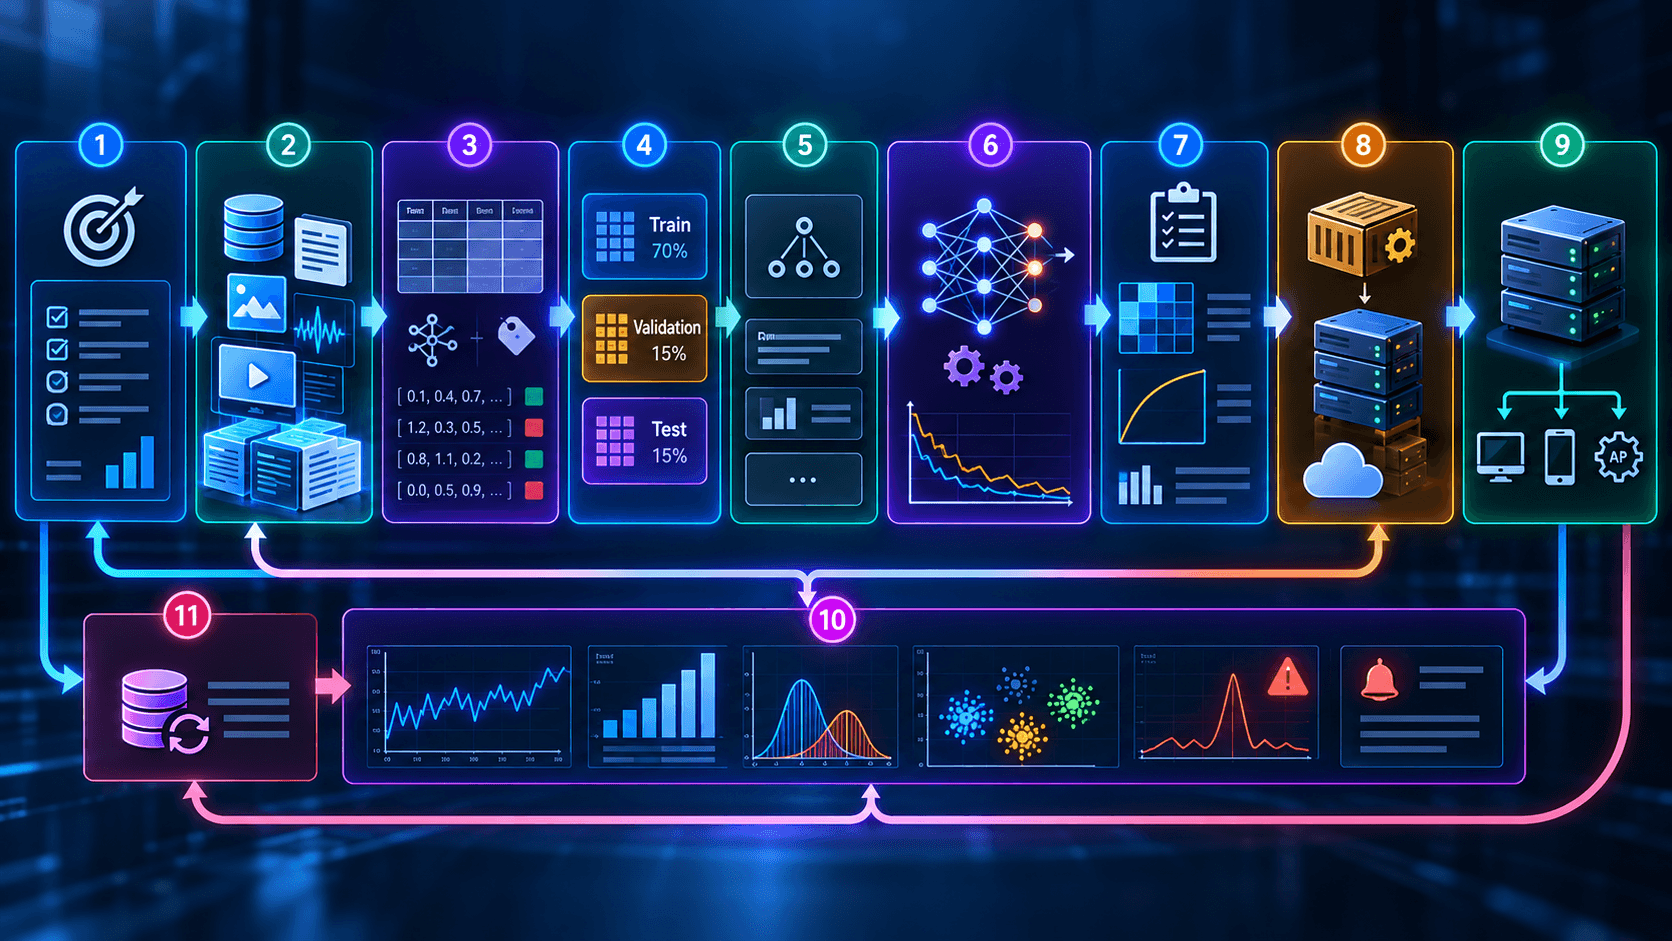
1. Постановка задачи и метрики
Команда определяет объект, момент прогноза, доступные данные, результат и цену ошибок. Формулировка «предсказать отказ» слишком общая: нужны тип оборудования, горизонт прогноза, допустимое число ложных тревог и действие после предупреждения.
Метрика модели и бизнес-метрика не всегда совпадают. Recall может показывать долю найденных отказов, а бизнес оценивает предотвращенный простой, стоимость проверки и число лишних выездов. Порог классификации выбирают по этому компромиссу.
2. Сбор и подготовка данных
Данные извлекают из транзакций, датчиков, журналов, документов и изображений. Проверяют схему, пропуски, дубликаты, выбросы, единицы измерения, права использования и временные границы. Разметка должна отражать результат, доступный в реальной эксплуатации.
Большой объем данных не гарантирует качество. Миллионы дублирующихся или смещенных примеров могут быть хуже небольшой репрезентативной выборки. Для редких событий важно, достаточно ли положительных случаев и покрывают ли они рабочие режимы.
3. Признаки и целевая переменная
Признаки описывают объект на момент прогноза. Label содержит правильный ответ для supervised learning. В модель нельзя передавать информацию, которая появляется только после события. Иначе возникает data leakage: тестовая метрика становится завышенной, но в продакшене такого признака нет.
Для табличных данных признаки часто проектируют явно. Глубокая нейросеть может сама обучать представления из изображений, текста или аудио, однако требования к данным и проверке никуда не исчезают.
4. Train, validation и test
Выборку разделяют на train, validation и test. На train алгоритм настраивает параметры, по validation выбирают признаки и гиперпараметры, а test оставляют для финальной независимой оценки.
Случайное перемешивание подходит не всегда. Для временного ряда тест должен имитировать будущее. Для данных о клиентах, пациентах или устройствах связанные записи одного объекта нельзя бездумно распределять между train и test. Иначе модель частично увидит тестовый объект при обучении.
5. Обучение и оптимизация
Алгоритм делает прогноз, вычисляет функцию потерь и меняет параметры, чтобы уменьшить ошибку. Конкретный процесс различается: линейная модель оптимизирует коэффициенты, дерево выбирает разбиения, нейросеть обновляет веса с помощью обратного распространения ошибки и оптимизатора.
Гиперпараметры задают устройство процесса: глубину дерева, силу регуляризации, learning rate, число соседей или размер batch. Их не следует подбирать по финальному test set, иначе тест перестает быть независимым.
6. Оценка, запуск и мониторинг
После проверки модель упаковывают вместе с обработкой признаков, схемой и зависимостями. В продакшене контролируют latency, ошибки сервиса, входные данные, распределение прогнозов, качество по новым меткам, возраст модели и различия между training и serving pipeline.
Если среда меняется, закономерности могут устареть. Тогда требуется новая оценка, переобучение или откат. Развертывание является началом эксплуатации модели, а не последней точкой проекта.
Основные виды машинного обучения
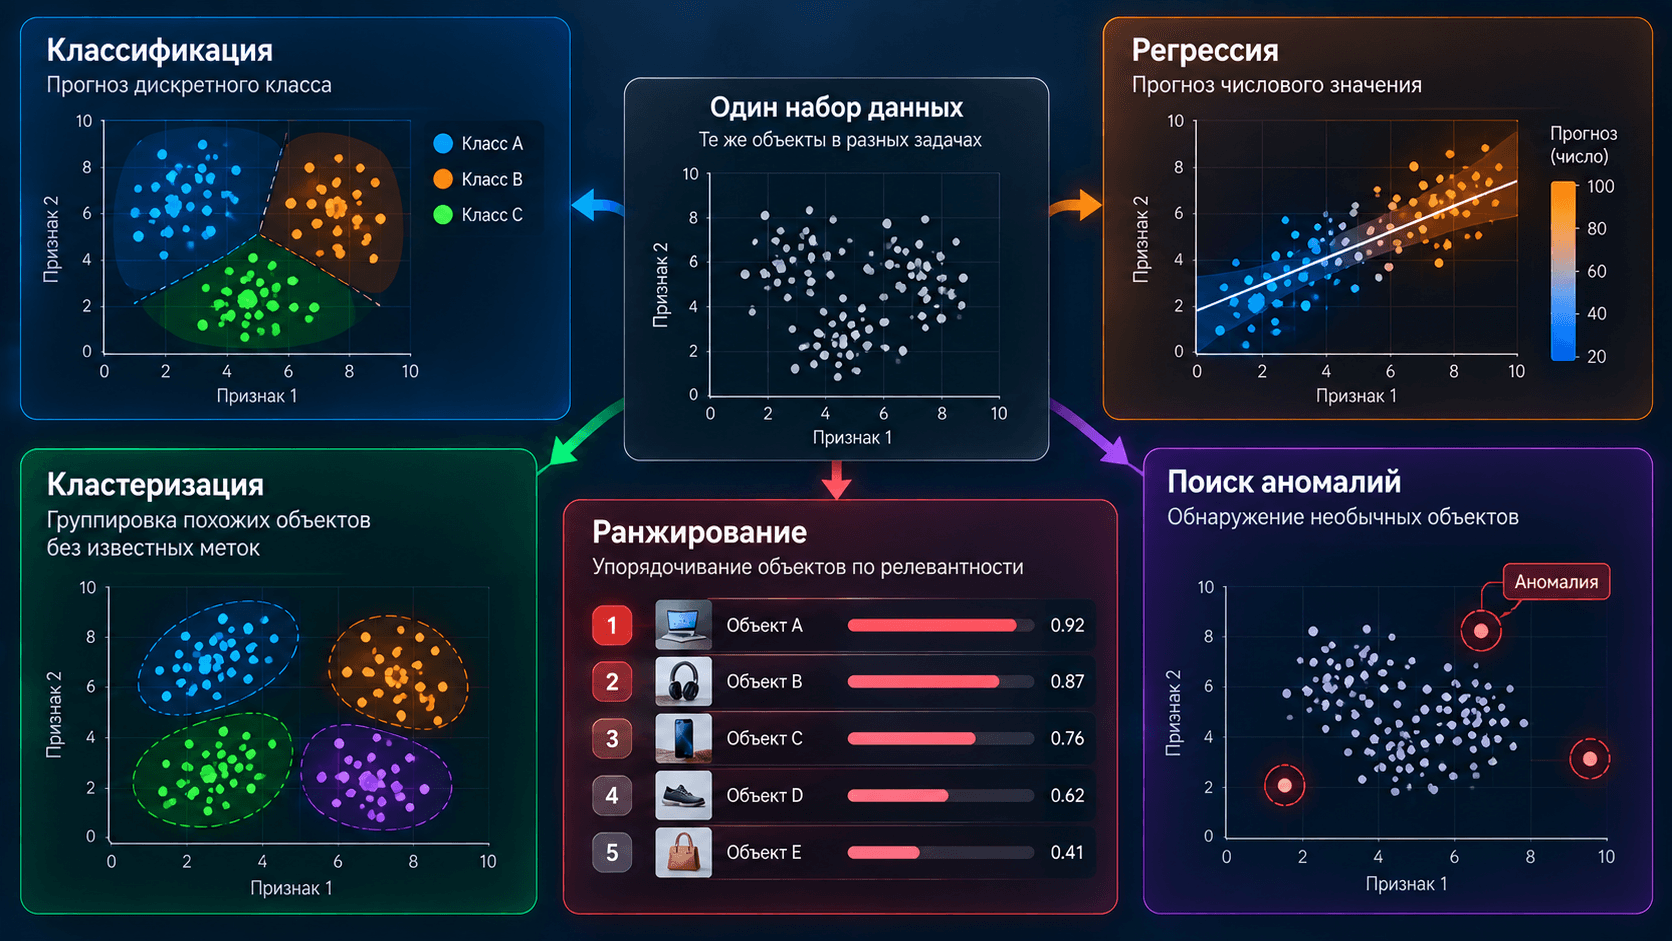
Виды ML правильнее различать по источнику обучающего сигнала. Классификация, регрессия и кластеризация описывают задачи. Дерево, линейная модель и нейросеть описывают классы моделей. Эти оси пересекаются, поэтому одна система имеет сразу несколько характеристик.
Обучение с учителем
Машинное обучение с учителем использует примеры с известными правильными ответами. Модель ищет зависимость между признаками и label, затем применяет ее к новым объектам.
Основные задачи supervised learning:
классификация возвращает категорию или вероятность класса;
регрессия прогнозирует числовое значение;
ранжирование упорядочивает объекты по релевантности или ожидаемой полезности.
Обучение без учителя
Машинное обучение без учителя получает данные без готового правильного ответа и ищет их внутреннюю структуру. Кластеризация группирует похожие объекты. Снижение размерности строит более компактное представление. Поиск аномалий выделяет необычные наблюдения, хотя он также может быть реализован supervised или semi-supervised методами.
Кластеры не получают бизнес-смысл автоматически. Алгоритм может разделить клиентов по статистическому сходству, но названия сегментов и пригодность разделения проверяет специалист предметной области.
Обучение с частичной разметкой
Semi-supervised learning использует небольшую размеченную часть вместе с большим объемом неразмеченных данных. Подход полезен, когда экспертная разметка дорогая, но сырые данные доступны. Слабая или ошибочная разметка способна распространять ошибки, поэтому контроль качества остается обязательным.
Self-supervised learning
Self-supervised learning создает обучающий сигнал из самих данных. Модель восстанавливает скрытую часть входа или предсказывает элемент последовательности, формируя представления для последующей адаптации. Это не то же самое, что self-training, при котором модель назначает псевдометки неразмеченным примерам.
Обучение с подкреплением
При reinforcement learning агент действует в среде, получает награды или штрафы и обучает стратегию поведения, или policy. Ключевыми становятся состояние, действие, награда, исследование среды и последствия во времени. Подход применяют в управлении, робототехнике, играх и последовательной оптимизации, но он не нужен для обычной классификации заявок.
Где находится генеративный AI
Генеративная модель создает контент или данные. Это характеристика результата, а не отдельный взаимоисключающий способ обучения. Одну модель можно последовательно обучать self-supervised методом, на размеченных инструкциях и на сигнале предпочтений.
Вид обучения | Какие данные нужны | Типичный результат | Пример задачи |
|---|---|---|---|
С учителем | признаки и правильные ответы | класс, число, score | спам, риск, прогноз спроса |
Без учителя | данные без labels | кластеры, представления, аномалии | сегментация, поиск структуры |
Semi-supervised | немного размеченных и много неразмеченных данных | прогноз для целевой задачи | классификация изображений при дорогой разметке |
Self-supervised | обучающий сигнал строится из самих данных | универсальные представления или базовая модель | предобучение текста и изображений |
С подкреплением | взаимодействия, состояния, действия и награда | policy | управление роботом или ресурсами |
Какие задачи решает машинное обучение
Тип задачи определяют по требуемому выходу, а не по названию алгоритма.
Задача | Что возвращает модель | Пример применения | Как проверяют |
|---|---|---|---|
Бинарная классификация | один из двух классов и часто вероятность | спам, дефект, подозрительная операция | precision, recall, F1, ROC-AUC или PR-AUC с учетом цены ошибок |
Многоклассовая классификация | один класс из нескольких | категория обращения или тип объекта | macro и weighted метрики, confusion matrix |
Регрессия | число | спрос, стоимость, длительность ремонта | MAE, RMSE и распределение ошибки |
Кластеризация | группу похожих объектов | сегменты клиентов или режимы оборудования | устойчивость кластеров, silhouette и предметная интерпретация |
Ранжирование | упорядоченный список | поиск и рекомендации | precision@k, recall@k, NDCG и продуктовая метрика |
Поиск аномалий | score необычности или сигнал | сбой датчика, необычная транзакция | recall на известных событиях, число ложных тревог, время обнаружения |
Прогноз временного ряда | будущие значения по времени | продажи, нагрузка, потребление | backtesting по времени, MAE, RMSE и сравнение с сезонным baseline |
Снижение размерности | компактное представление | визуализация, сжатие признаков, подготовка к кластеризации | сохранение полезной структуры и качество последующей задачи |
Генерация | новый текст, изображение, звук или данные | черновик ответа, синтетические примеры | задача-зависимые метрики и экспертная проверка |
Классификация и кластеризация отвечают на разные вопросы. Классификатор знает названия классов из разметки и предсказывает один из них. Кластеризатор получает объекты без labels и группирует их по выбранной мере сходства. Полученный кластер не обязан совпасть с существующим бизнес-сегментом.
Модели, методы и алгоритмы машинного обучения
Алгоритм обучения настраивает параметры, а полученная модель делает прогноз. В разговорной речи эти понятия смешивают, но при проектировании полезно разделять процедуру и результат.
Линейные модели
Линейная регрессия прогнозирует число как комбинацию признаков. Логистическая регрессия оценивает вероятность класса. Эти модели быстро обучаются, служат сильным baseline и часто проще интерпретируются. Они могут проигрывать на сложных нелинейных зависимостях без подходящих преобразований признаков.
Деревья решений и ансамбли
Дерево решений последовательно делит пространство признаков по условиям. Случайный лес обучает множество деревьев на разных подвыборках и объединяет их прогнозы. Бустинг строит ансамбль последовательно, исправляя ошибки предыдущих моделей.
Деревья и градиентный бустинг часто эффективны на табличных данных и моделируют нелинейные связи. Важность признака при этом не доказывает причинность.
Метод опорных векторов и ближайшие соседи
SVM строит разделяющую границу с максимальным зазором и может использовать kernel для нелинейных зависимостей. k-NN определяет прогноз по ближайшим объектам. Оба метода чувствительны к масштабу признаков, а стоимость k-NN при инференсе растет вместе с объемом хранимых примеров.
K-means и другие методы кластеризации
K-means ищет заданное число центров и относит объекты к ближайшему. Результат зависит от масштаба признаков, числа кластеров, инициализации и формы групп. Если данные имеют сложную геометрию или много выбросов, другой метод может подходить лучше.
Нейронные сети
Нейросеть состоит из слоев с обучаемыми весами. Глубокие архитектуры извлекают представления из текста, изображений, аудио и видео, но требовательны к данным, вычислениям и воспроизводимости.
Выбор алгоритма начинается с baseline. Для табличной классификации сравнивают линейную модель и деревья, для изображений часто используют предобученную архитектуру. Усложнение оправдано измеримым улучшением на независимых данных при приемлемой стоимости эксплуатации.
Примеры машинного обучения
Ниже приведены типовые постановки, а не заявления о результатах конкретных внедрений Start Server.
Финансы и антифрод
Модель классифицирует операцию или возвращает risk score по допустимым признакам. Нужно учитывать дисбаланс классов, задержку меток и адаптацию мошенников. Accuracy здесь опасна: при редких подозрительных операциях ответ «все безопасно» даст высокую точность без пользы.
Для соответствующих нагрузок на сайте выделена категория AI-серверов для финтеха и антифрода. Конфигурацию выбирают по объему потока, времени ответа, способу обучения и требованиям к данным.
Промышленность и техническое обслуживание
Машинное обучение анализирует телеметрию и оценивает риск отказа или отклонение режима. Сложность в том, что отказы редки, датчики меняются, обслуживание влияет на данные, а предупреждение должно оставлять время для действия.
Ритейл, логистика и прогнозирование спроса
Регрессионная модель или модель временного ряда прогнозирует спрос по истории, календарю, цене, промо и доступным внешним факторам. Проверку проводят на будущих периодах и сравнивают с простым сезонным baseline. Случайное перемешивание строк может дать нереалистично хороший результат.
Рекомендательные и поисковые системы
Модель ранжирует товары, документы или контент. Офлайн-метрика показывает качество на сохраненных взаимодействиях, но продакшен-эффект проверяют контролируемым экспериментом. Рекомендации меняют поведение пользователей, поэтому возникает feedback loop.
Компьютерное зрение
Модель классифицирует изображения, обнаруживает объекты, сегментирует области или ищет дефекты. Тестовый набор должен отражать реальные камеры, ракурсы, освещение, фон и редкие варианты объекта.
Текст, речь и документы
ML применяют для классификации обращений, распознавания речи, извлечения полей, поиска похожих документов и определения тематики. В задачах обработки естественного языка классические методы, embeddings и глубокие модели могут дополнять друг друга.
Для аналитических сценариев можно начать с категории серверов для Data Analytics. Она показывает диапазон платформ, но не заменяет профилирование конкретного pipeline.
Как оценивать модель
Метрика должна отражать цену разных ошибок. Одного универсального показателя качества нет.
Метрики классификации
Accuracy показывает долю правильных ответов, но может обмануть при дисбалансе. Precision измеряет долю верных положительных прогнозов, recall долю найденных положительных объектов, а F1 объединяет эти показатели. Конкретную цену false positive и false negative F1 не учитывает.
Метрики регрессии
MAE показывает среднюю абсолютную ошибку в единицах прогноза, а RMSE сильнее наказывает крупные отклонения. MAPE удобно читать как процент, но около нуля он нестабилен. Ошибку дополнительно проверяют по времени, сегментам и диапазонам цели.
Валидация и cross-validation
Кросс-валидация меняет обучающую и проверочную части, помогая оценить устойчивость. Разбиение должно сохранять структуру задачи: временная модель не обучается на будущем, а связанные записи одного клиента, пациента или устройства остаются в одной группе.
Преобразования обучают только на train fold. Иначе нормализация, отбор признаков или заполнение пропусков передаст в обучение информацию из validation. Pipeline помогает исключить такую утечку.
Baseline обязателен
Модель сравнивают с простым вариантом: медианой, прошлым периодом, частым классом, правилом или существующим процессом. Если сложный алгоритм не превосходит baseline по целевой метрике и стоимости, его внедрение не обосновано.
Ошибки и риски машинного обучения
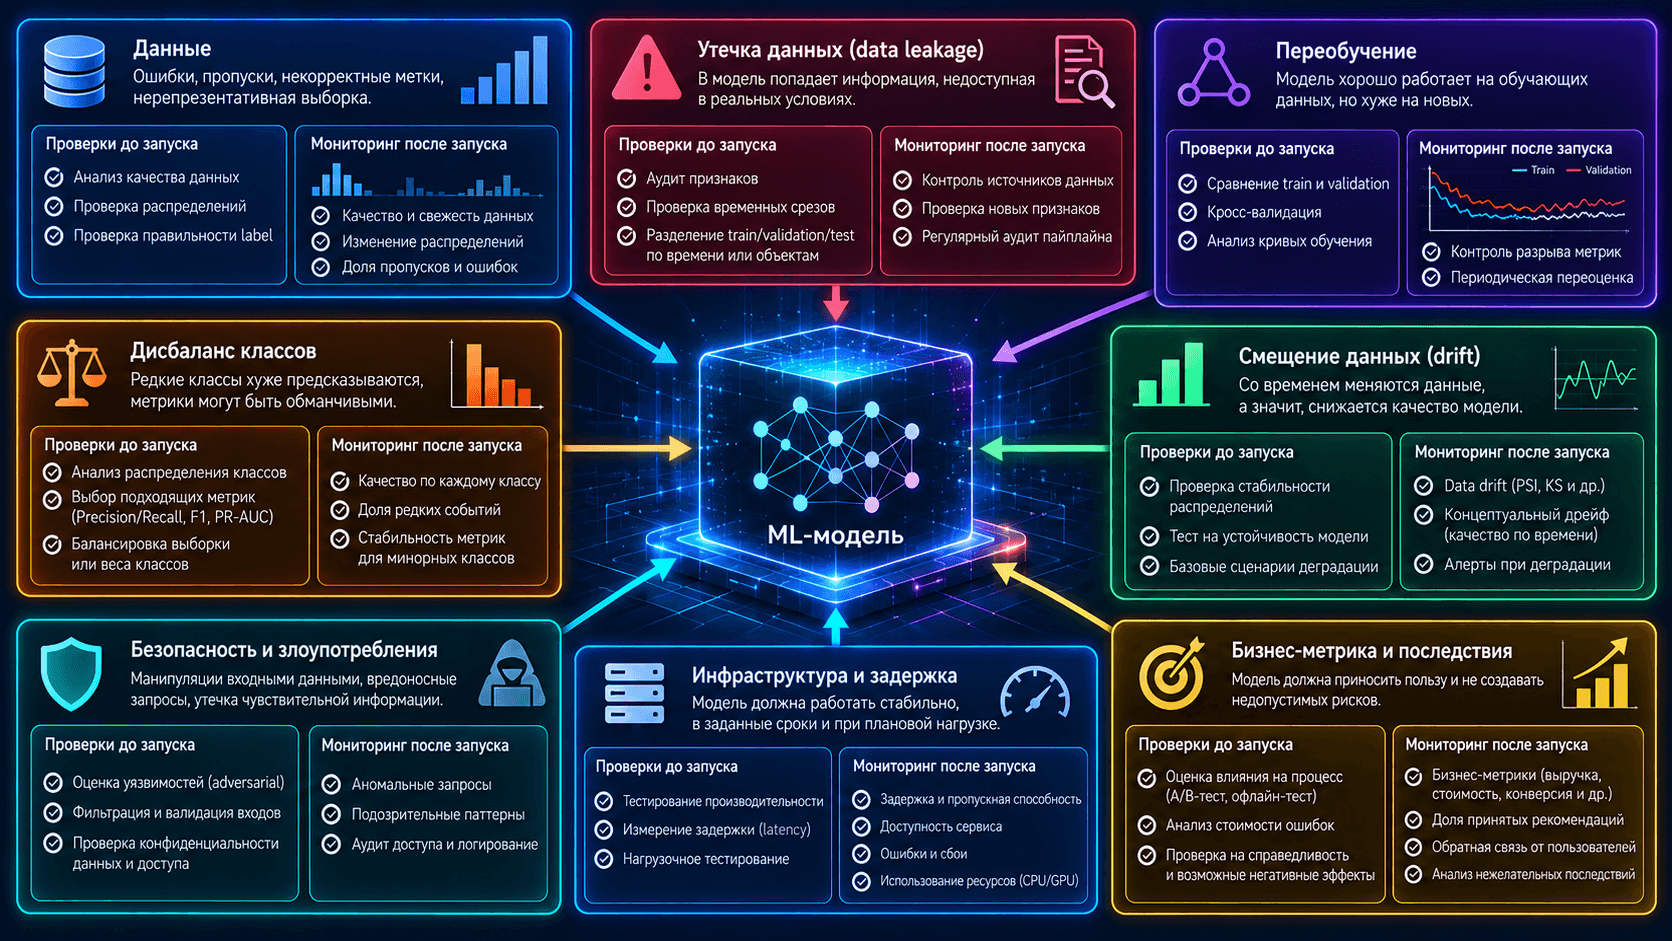
Переобучение
Переобученная модель хорошо работает на train, но плохо обобщает на новые данные. Причиной бывает избыточная сложность, малая выборка, утечка или неверное разбиение. Низкая train error сама по себе не является успехом.
Data leakage
Data leakage возникает, если модель получает информацию о будущем ответе: поле после события, дубликат в test или preprocessing по всему датасету. Утечка завышает offline-метрику, но не помогает после запуска.
Смещение данных и несправедливость
Исторические данные отражают старые процессы и решения. Признаки могут служить proxy для чувствительных характеристик. Оценивать нужно не только среднее качество, но и ошибки по значимым группам, последствия решения и возможность обжалования.
Drift и устаревание
Data drift означает изменение входов, concept drift изменение связи признаков с результатом. Даже при стабильном сервисе качество может снижаться, поэтому нужны отложенные метки, контроль срезов и правила переобучения или отката.
Безопасность и приватность
Датасет, модель и API требуют контроля доступа. Нужно учитывать загрязнение обучающих данных, обход модели специально подобранными входами и извлечение чувствительной информации. Система получает только необходимые данные и полномочия.
Невоспроизводимый эксперимент
Без версий данных, кода, зависимостей, параметров и seed сравнение моделей теряет смысл. Даже когда битовая повторяемость недостижима, условия и разброс результатов фиксируют.
NIST связывает доверие к AI-системе с надежностью, безопасностью, устойчивостью, прозрачностью, объяснимостью, приватностью и управлением вредными смещениями. Offline-метрика закрывает только часть этой картины.
Когда машинное обучение не нужно
ML добавляет вероятностное поведение, зависимость от данных и эксплуатационный цикл. Он может быть лишним, если:
задачу надежно решает короткое прозрачное правило;
нет достаточных данных или способа получить правильные ответы;
процесс меняется быстрее, чем можно собрать выборку и переобучить модель;
цена ошибки несовместима с достижимым качеством и контролем;
результат нельзя встроить в действие или рабочий процесс;
простой baseline уже выполняет требования;
стоимость разработки и эксплуатации выше ожидаемой пользы.
Нужен ли GPU для машинного обучения
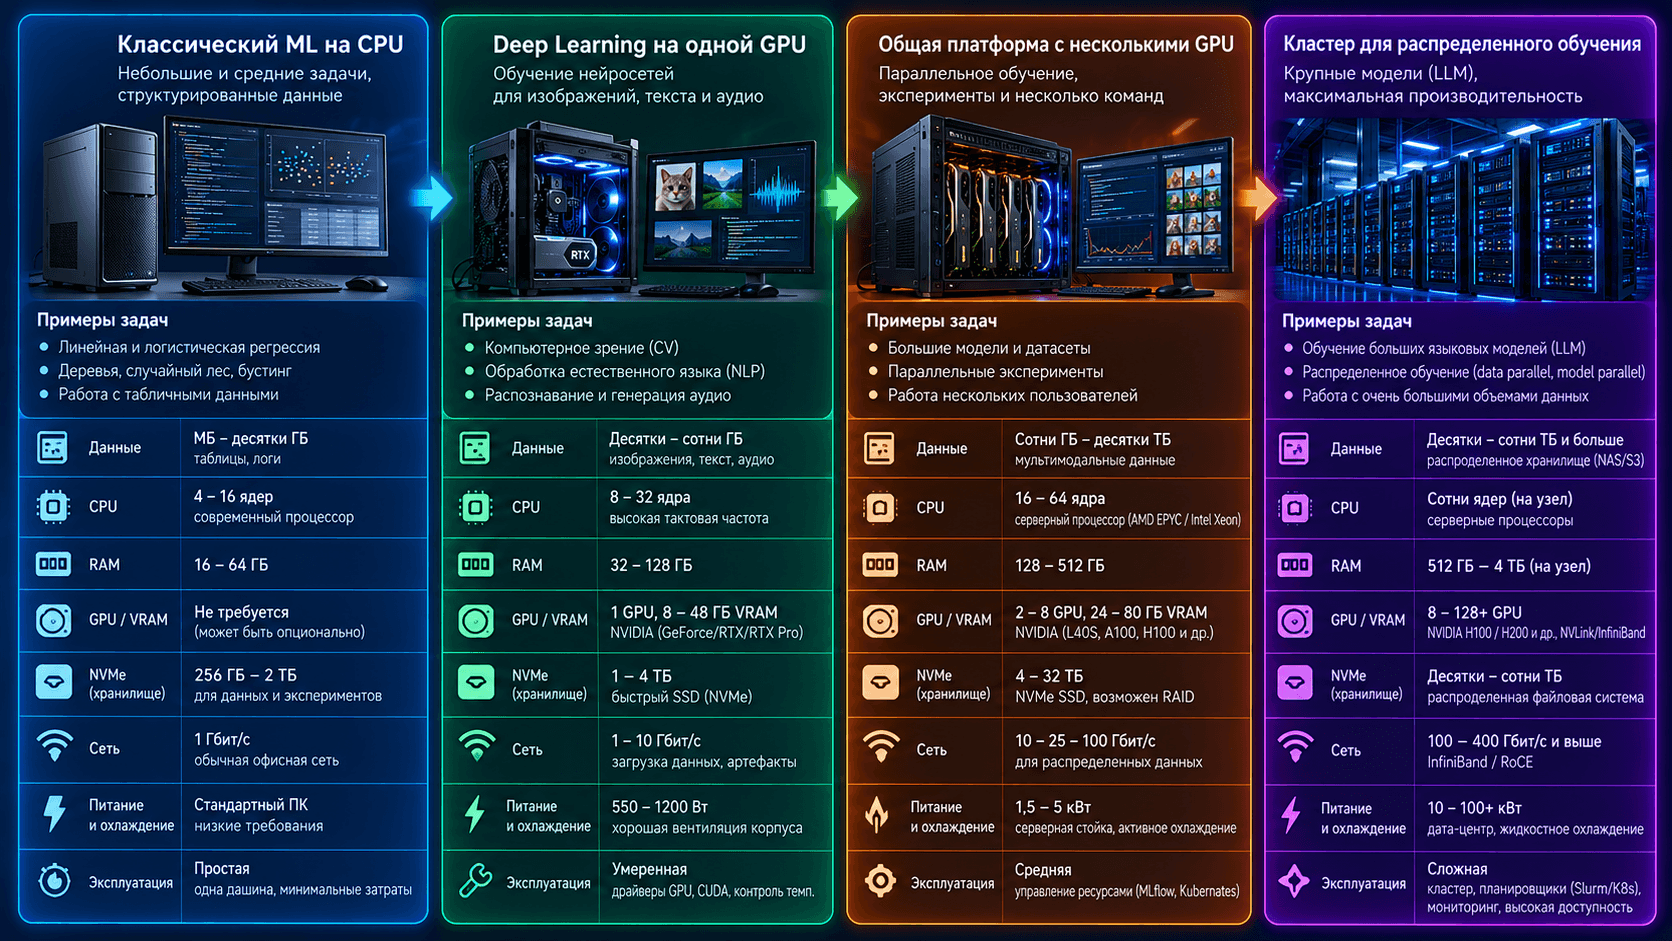
Не для каждой задачи. Линейные модели, деревья, случайный лес и многие варианты бустинга на табличных данных эффективно работают на CPU. Важнее могут оказаться RAM, число ядер и скорость подготовки данных.
GPU особенно полезен для глубокого обучения изображений, речи и текста. Он не исправляет плохую разметку, leakage или медленный pipeline. Если ускоритель ждет CPU, сеть или накопитель, более быстрая карта не устранит узкое место.
CPU, RAM и подача данных
CPU декодирует файлы, выполняет preprocessing, токенизацию и часть классических алгоритмов. RAM хранит рабочий набор, процессы DataLoader, подготовленные batch и кэш. Полный датасет не обязан помещаться в память, если pipeline читает его потоково. Подробный расчет приведен в статье сколько оперативной памяти нужно GPU-серверу для обучения и подготовки данных.
NVMe и хранилище
Хранилище оценивают по объему активного набора, размерам объектов, последовательному или случайному доступу, checkpoint и ресурсу записи. Один показатель ГБ/с не описывает датасет из миллионов мелких файлов. Эти различия разобраны в руководстве как выбрать NVMe SSD для обучения моделей.
Batch size и топология
Больший batch способен повысить загрузку GPU, но увеличивает память и не всегда ускоряет весь pipeline. Рабочую точку находят серией сопоставимых прогонов, как описано в методике эксперимента с batch size для обработки документов на GPU.
В многопроцессорном сервере имеет значение путь CPU, RAM, PCIe, GPU, NIC и NVMe. Потенциальную проблему NUMA нельзя объявлять узким местом без измерения. Для проверки используется отдельный контролируемый эксперимент влияния NUMA на подачу данных к GPU.
Рабочая станция, сервер или облако
Рабочая станция подходит для интерактивной разработки одного специалиста. Общий сервер нужен для длительных задач, нескольких пользователей, централизованного доступа, планировщика и мониторинга. Критерии собраны в сравнении рабочей станции и GPU-сервера для команды разработки.
Облако удобно для краткого пилота и нерегулярной нагрузки. Локальная платформа дает контроль над данными и емкостью, но требует капитальных затрат. Варианты сравнивают по выполненной работе и полной стоимости с помощью методики расчета TCO локального GPU-сервера и облака.
Компактный ASUS Ascent GX10 с 128 ГБ объединенной памяти показывает класс локальных систем для разработки и пилотов.
Для общей стоечной платформы с несколькими ускорителями можно рассматривать ASUS ESC4000A-E12 с поддержкой до четырех двухслотовых GPU. Оба варианта служат примерами формата, а не готовой спецификацией под любую модель.
Как начать ML-проект
Практическая последовательность выглядит так:
Зафиксируйте решение, которое будет принято по прогнозу модели.
Определите объект, момент прогноза, признаки и недоступные данные.
Выберите бизнес-метрику и стоимость разных ошибок.
Проверьте источники данных, права, разметку и репрезентативность.
Создайте train, validation и test по структуре реальной задачи.
Постройте простой baseline до сложной модели.
Сравните несколько алгоритмов в одинаковом pipeline.
Проведите error analysis по сегментам и пограничным случаям.
Измерьте обучение и инференс на репрезентативной нагрузке.
Спроектируйте deployment, мониторинг, обратную связь и откат.
Если одна платформа должна одновременно обучать модель и обслуживать production, нужно проверить конфликт ресурсов и SLA. Средняя GPU utilization не показывает свободную емкость. Практический порядок приведен в статье как разделить обучение и инференс на одном GPU-сервере.
FAQ
Что такое машинное обучение простыми словами?
Это способ настроить программу по примерам. Алгоритм находит зависимости в данных, а полученная модель прогнозирует результат для новых объектов.
Какие виды машинного обучения существуют?
По источнику сигнала выделяют обучение с учителем, без учителя, с частичной разметкой, self-supervised learning и обучение с подкреплением.
Какие основные задачи решает машинное обучение?
Это классификация, регрессия, кластеризация, ранжирование, поиск аномалий, прогнозирование временных рядов, снижение размерности и генерация.
Чем машинное обучение отличается от искусственного интеллекта?
Искусственный интеллект шире. Машинное обучение является подходом внутри AI, при котором модель формирует поведение по данным. AI-система может также использовать правила, поиск и оптимизацию.
Чем машинное обучение отличается от нейросети?
Нейросеть является одним классом ML-моделей. Линейные модели, деревья, случайный лес, бустинг и SVM тоже относятся к машинному обучению, но не являются нейросетями.
В чем разница между обучением с учителем и без учителя?
В supervised learning у примеров есть правильный ответ. В unsupervised learning готовых меток нет, поэтому алгоритм ищет кластеры, представления или аномалии.
Что такое модель машинного обучения?
Это математическая зависимость с параметрами, полученными из данных. Алгоритм настраивает модель, после чего ее применяют для инференса.
Какие алгоритмы машинного обучения бывают?
Распространены линейная и логистическая регрессия, деревья, случайный лес, бустинг, SVM, k-NN, k-means и нейронные сети. Единого алгоритма для всех задач нет, выбор проверяют относительно baseline.
Зачем нужны train, validation и test?
На train модель обучают, по validation выбирают параметры, а test оставляют для финальной независимой оценки. Настройка по test лишает его независимости.
Что такое переобучение модели?
Переобученная модель хорошо работает на train, но плохо обобщает на новые данные. Его снижают качественными данными, регуляризацией, ограничением сложности и корректной проверкой.
Сколько данных нужно для машинного обучения?
Универсального числа нет. Оно зависит от сложности задачи, разнообразия объектов, редких классов, шума разметки и предобученной модели. Важно покрытие рабочих случаев, а не только объем.
Нужен ли Python для машинного обучения?
Python популярен благодаря scikit-learn, PyTorch и TensorFlow, но ML не привязан к одному языку. Обученная модель может обслуживаться отдельным сервисом.
Нужна ли видеокарта для машинного обучения?
Для многих табличных моделей достаточно CPU. GPU полезен для глубоких нейросетей, изображений, текста и крупных batch. Решение принимают после измерения целевой нагрузки.
Подбор инфраструктуры для машинного обучения
Для расчета сервера нужны тип модели, объем и формат данных, размер рабочего набора, precision, batch size, длительность обучения, частота экспериментов, число пользователей, требования к инференсу и дальнейший рост.
Start Server подбирает CPU, GPU, RAM, VRAM, NVMe, сеть и платформу как единую систему. В каталоге AI-серверов представлены конфигурации разных классов, но финальную спецификацию стоит формировать после baseline, профилирования pipeline и нагрузочного теста.


