Суперкомпьютер представляет собой вычислительную систему высшего для своего времени класса производительности. Он решает одну большую задачу или множество связанных расчетов параллельно, используя большое число процессорных ядер, ускорителей и вычислительных узлов.
Большинство современных суперкомпьютеров выглядит не как один гигантский компьютер. Это стойки с серверами, объединенные высокоскоростной сетью и общей программной средой. В состав также входят параллельная система хранения, управляющие узлы, планировщик заданий, мониторинг, питание и охлаждение.
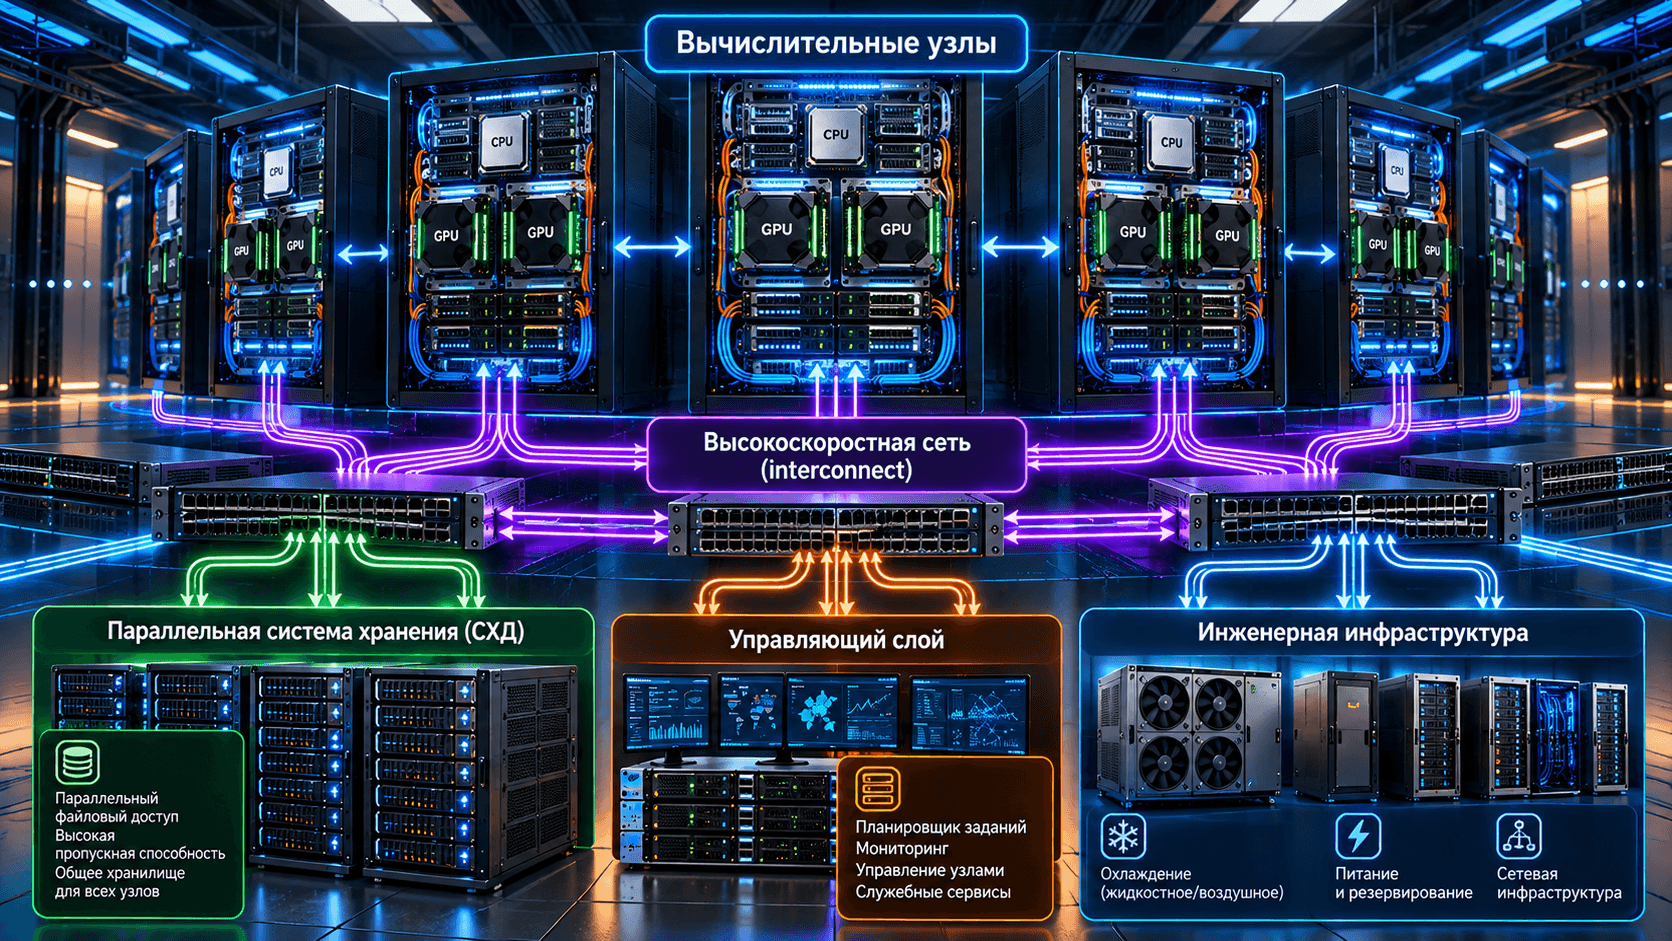
Что такое суперкомпьютер простыми словами
Обычный компьютер старается быстро выполнять задачи одного пользователя. Сервер обслуживает приложения, базы данных, файлы или сетевые сервисы. Суперкомпьютер ориентирован на вычислительные задачи, которым недостаточно одного узла: моделирование климата, аэродинамики и физических процессов, поиск новых материалов, обработку геномов, сейсмический анализ, обучение крупных моделей машинного обучения.
Жесткой вечной границы между мощным сервером и суперкомпьютером нет. Производительность растет, поэтому система, считавшаяся рекордной десять лет назад, может уступать новой стойке или даже одному серверу в отдельных операциях. Значение имеют четыре признака:
очень высокая производительность относительно систем своего поколения;
параллельное выполнение на большом числе ядер, ускорителей или узлов;
специализированная архитектура сети, памяти, хранения и ПО;
использование для задач, способных масштабироваться на выделенные ресурсы.
Чем суперкомпьютер отличается от обычного компьютера, сервера и кластера
Слова сервер, кластер и суперкомпьютер описывают разные стороны системы.
Система | Основная цель | Типичный масштаб | Что определяет результат |
|---|---|---|---|
Персональный компьютер | интерактивная работа одного пользователя | один узел | отзывчивость, производительность отдельных приложений, GPU и накопитель |
Сервер | предоставление вычислений, данных или сервисов клиентам | один или несколько узлов | SLA, CPU, RAM, I/O, сеть, надежность |
Кластер | совместная работа нескольких независимых узлов | от нескольких серверов до многих стоек | программная модель, сеть, распределение нагрузки и отказоустойчивость |
Суперкомпьютер | предельно быстрый расчет крупных параллельных задач | мощный общий узел, кластер или специализированная многостоечная система | time-to-solution, масштабирование, память, interconnect, СХД и ПО |
Мейнфрейм | большой поток транзакций и корпоративных операций | крупная централизованная система | надежность, I/O, изоляция и предсказуемая обработка транзакций |
Не каждый кластер является суперкомпьютером. Десять веб-серверов за балансировщиком образуют кластер, но не обязательно ускоряют один расчет. В HPC-кластере приложение делит работу между узлами и обменивается промежуточными данными через сеть.
Суперкомпьютер может состоять из серверов. При этом отдельный вычислительный узел, сеть и СХД выбирают как части одной архитектуры. Общая классификация серверов по назначению и форм-фактору раскрыта в отдельном материале.
Суперкомпьютер и квантовый компьютер
Квантовый компьютер использует другую вычислительную модель и не является более быстрым суперкомпьютером общего назначения. Квантовые алгоритмы потенциально дают преимущество для отдельных классов задач. Классический суперкомпьютер исполняет обычные цифровые программы и остается базовой платформой для моделирования, анализа данных и подготовки гибридных квантовых расчетов.
Как работает суперкомпьютер
Главная идея состоит в параллелизме. Большая задача разделяется на части, которые можно вычислять одновременно. Например, при моделировании атмосферы пространство разбивают на ячейки. Каждый процесс рассчитывает свой фрагмент, затем соседние процессы обмениваются граничными значениями и переходят к следующему временному шагу.
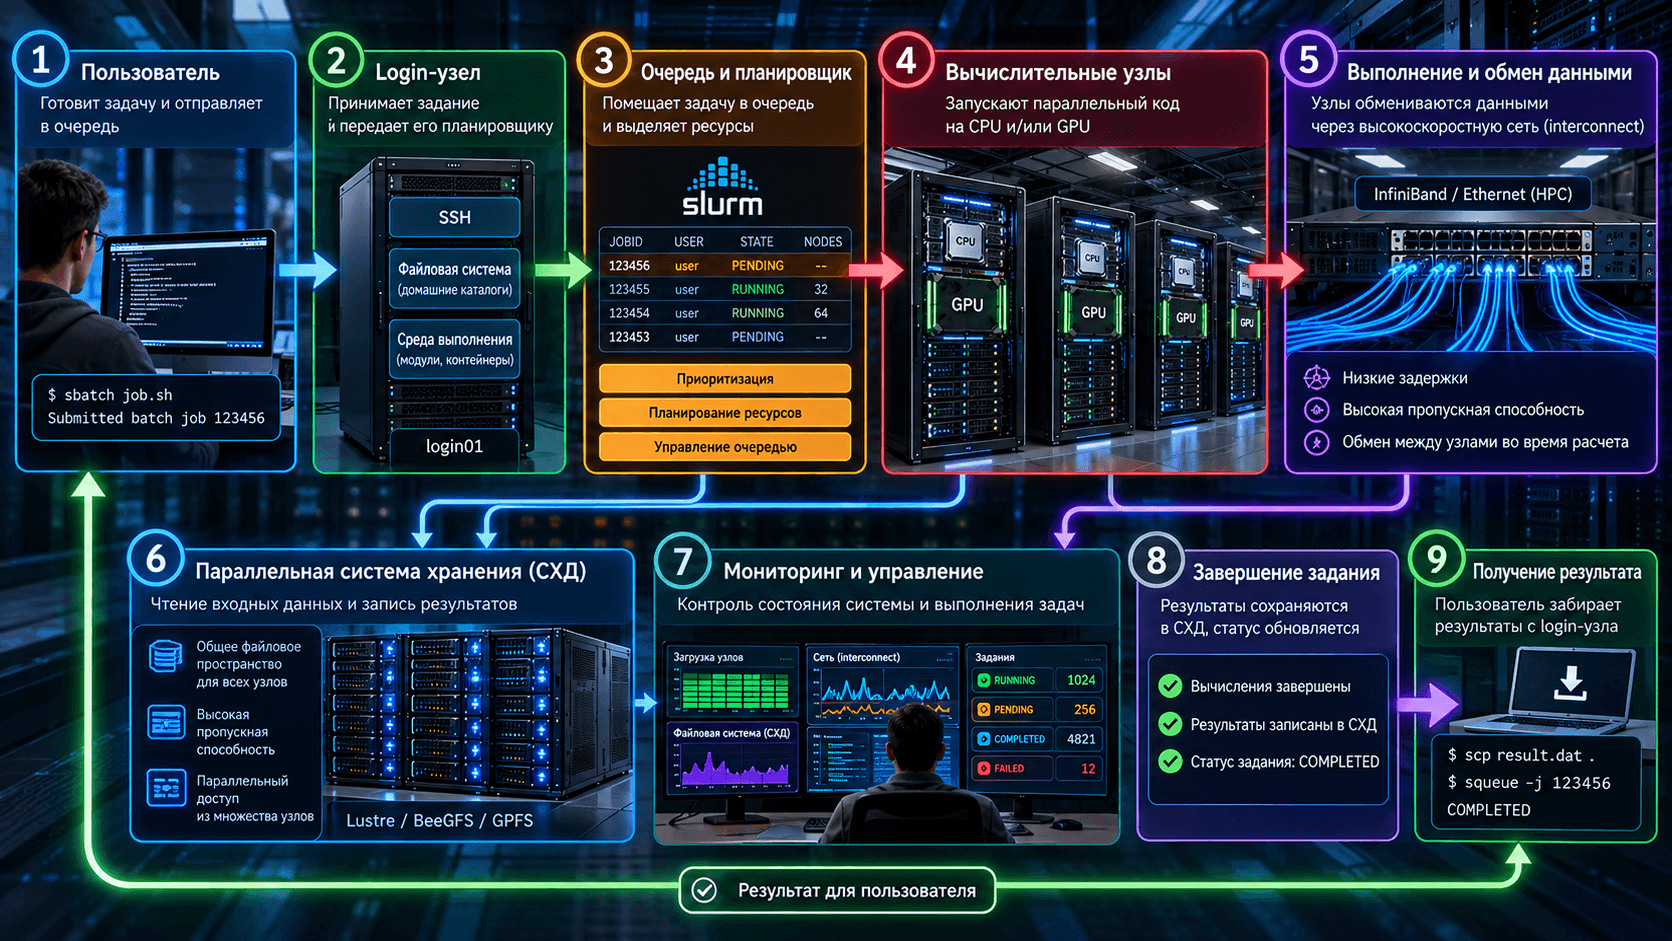
Типичный путь задания выглядит так:
Пользователь подключается к login-узлу, готовит входные данные, программу и описание требуемых ресурсов.
Планировщик помещает job в очередь и выделяет подходящие CPU, GPU, память и время.
Данные считываются из параллельной файловой системы либо staging-слоя.
Программа запускает процессы и потоки на вычислительных узлах.
Узлы обмениваются сообщениями через interconnect. В GPU-задачах дополнительно идет обмен между ускорителями внутри и между узлами.
Контрольные точки и результаты записываются в хранилище.
Мониторинг собирает загрузку, ошибки, температуру, энергопотребление и показатели задания.
Для обмена между процессами часто применяется MPI. Внутри узла используются потоки CPU, векторные инструкции, OpenMP, CUDA, HIP и другие модели. Планировщик, например Slurm, распределяет общие ресурсы между пользователями и заданиями.
Почему больше узлов не всегда означает быстрее
Если удвоить число узлов, приложение редко ускоряется ровно вдвое. Часть алгоритма может оставаться последовательной. Возрастают обмены, синхронизация и давление на память либо СХД. Маленькая задача перестает эффективно заполнять большую систему.
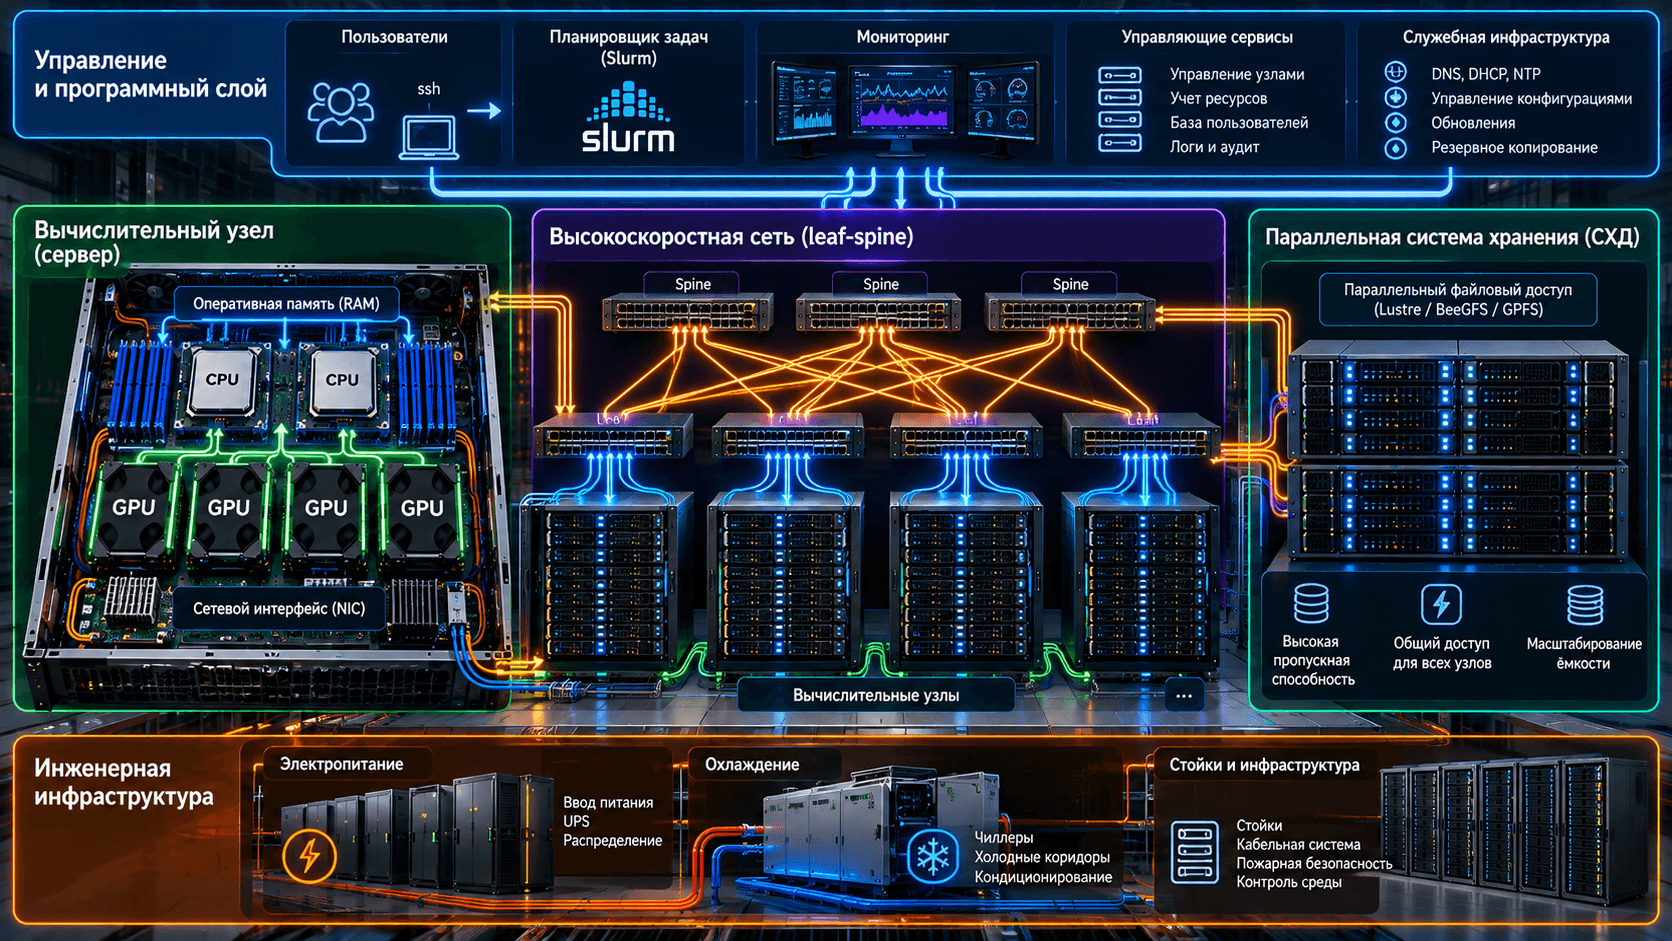
Из чего состоит суперкомпьютер
Вычислительные узлы
Compute node представляет собой серверный узел, на котором исполняется расчет. В нем находятся CPU, оперативная память, сетевые адаптеры и, если архитектура ускоренная, GPU либо другие ускорители. Узлы могут быть универсальными или разделяться по ролям: CPU, GPU, high-memory, visualization и service.
Один узел Frontier содержит CPU AMD EPYC, четыре ускорителя AMD Instinct MI250X, 512 ГБ DDR4 и локальные NVMe. Это пример конкретной архитектуры, а не обязательный шаблон для любого суперкомпьютера.
CPU, GPU и ускорители
CPU выполняет последовательные участки, сложную логику, управление, подготовку данных и многие приложения с нерегулярным доступом к памяти. GPU дает высокий throughput в массово-параллельной арифметике. Некоторые суперкомпьютеры используют только CPU, другие строятся на GPU, а гибридные системы распределяют этапы между ними.
Нельзя сравнивать CPU-систему и AI-ускоритель только по максимальным FLOPS. Значение зависит от FP64, FP32, BF16, FP8 или другого формата, разреженности и характера операций. Устройство и границы применимости ускорителя подробнее разобраны в статье что такое GPU и чем он отличается от CPU.
Иерархия памяти
Быстрый процессор бесполезен, если данные поступают слишком медленно. В суперкомпьютере используется несколько уровней:
регистры и кэши процессора;
локальная оперативная память узла;
HBM или другая память ускорителя;
локальный NVMe для временных данных;
общая параллельная файловая система;
долговременное и архивное хранение.
У каждого узла обычно свое адресное пространство. MPI-процессы явно обмениваются данными. Внутри отдельных модулей возможна когерентная память CPU и GPU, но она не превращает весь многотысячный кластер в один обычный компьютер с общей RAM.
Высокоскоростная сеть
Interconnect соединяет вычислительные узлы. Для HPC важны не только гигабиты в секунду, но и задержка, число сетевых интерфейсов, topology, adaptive routing, congestion control и производительность collective operations.
В системах применяются InfiniBand, HPE Slingshot, специализированные сети и Ethernet с RDMA. Ошибка в topology способна оставить дорогие процессоры без данных. Базовые принципы портов, fabric и пропускной способности раскрыты в материале как работает сетевой коммутатор.
Параллельная система хранения
СХД хранит входные наборы, checkpoints и результаты. Сотни узлов могут одновременно читать и записывать данные, поэтому обычный файловый сервер часто становится узким местом. Для разных задач критичны aggregate throughput, IOPS, операции с метаданными, число файлов, задержка и скорость восстановления.
Архитектуру нельзя выбирать только по емкости. Различия block, file и object storage, scale-up и scale-out объясняет статья система хранения данных: устройство, виды и архитектура СХД.
Управляющие и сервисные узлы
Login-узлы принимают подключения пользователей. Management-узлы управляют конфигурацией, мониторингом и развертыванием. Планировщик хранит очередь заданий и выделяет ресурсы. Отдельно могут работать узлы передачи данных, компиляции, лицензирования, визуализации и резервного копирования.
Пользователь не должен запускать тяжелый расчет на общем login-узле. Его задача состоит в подготовке и отправке job в вычислительную очередь.
Программный стек
В стек входят ОС, драйверы, компиляторы, MPI, библиотеки математики и обмена, контейнерная среда, планировщик, мониторинг и прикладное ПО. Совместимость версий влияет на результат не меньше оборудования.
Питание и охлаждение
Суперкомпьютер занимает от части стойки до машинного зала. Для него рассчитывают электрическую мощность, пусковые режимы, PDU, резервирование, массу, воздушное или жидкостное охлаждение, температуру теплоносителя, аварийные сценарии и мониторинг.
Граница между вычислительной системой и площадкой проходит не по дверце стойки. Если ЦОД не может отвести тепло или подать требуемую мощность, номинальная производительность оборудования недоступна. Устройство инженерного слоя описано в материале что такое ЦОД и как устроен центр обработки данных.
Виды суперкомпьютеров
Единственной классификации нет. Современные системы удобно разделять по вычислительной архитектуре и назначению.
CPU-суперкомпьютеры
Основную работу выполняют универсальные процессоры. Такой подход подходит кодам, которым нужны сложные ветвления, большая системная память или хорошая производительность на ядро. LineShine показывает, что CPU-only архитектура может занимать первое место TOP500.
GPU-ускоренные системы
Каждый узел сочетает CPU и несколько GPU. Ускорители выполняют плотную арифметику, моделирование, AI и другие параллельные kernels. CPU управляет программой и этапами, для которых GPU не подходит. Frontier, El Capitan и Aurora относятся к ускоренным архитектурам, хотя используют разные процессоры и GPU.
Векторные и специализированные системы
Векторная архитектура обрабатывает набор элементов одной инструкцией. Специализированные процессоры и межсоединения проектируют под конкретные требования производительности и энергоэффективности. Граница между векторным CPU, GPU и другим ускорителем меняется вместе с архитектурами, поэтому важнее поддержка реального кода.
AI-суперкомпьютеры
Так называют крупные GPU-системы и кластеры для обучения, дообучения и инференса моделей. В них особенно важны HBM, обмен между GPU, collective operations, пропускная способность СХД и low-precision вычисления.
AI PFLOPS в FP8 или FP4 нельзя напрямую сравнивать с FP64 HPL в TOP500. Это разные форматы и нагрузки. Например, NVIDIA GB300 NVL72 объединяет 72 GPU в rack-scale AI-системе, но ее заявленная AI-производительность не превращается автоматически в результат HPL.
Персональные и настольные суперкомпьютеры
Термин используют для мощных рабочих станций и компактных AI-узлов. Они полезны исследователю для разработки, прототипирования и локального запуска моделей. По масштабу сети, хранилища, надежности и производительности они не равны многостоечным системам TOP500.
Облачные суперкомпьютеры
HPC-ресурсы можно арендовать у облачного провайдера. Пользователь получает кластер, высокоскоростную сеть и хранилище на время. Такой вариант удобен для нерегулярных расчетов и быстрого старта. При постоянной загрузке, больших данных, лицензиях или требованиях локализации собственная инфраструктура может оказаться предсказуемее.
Как измеряют производительность суперкомпьютера
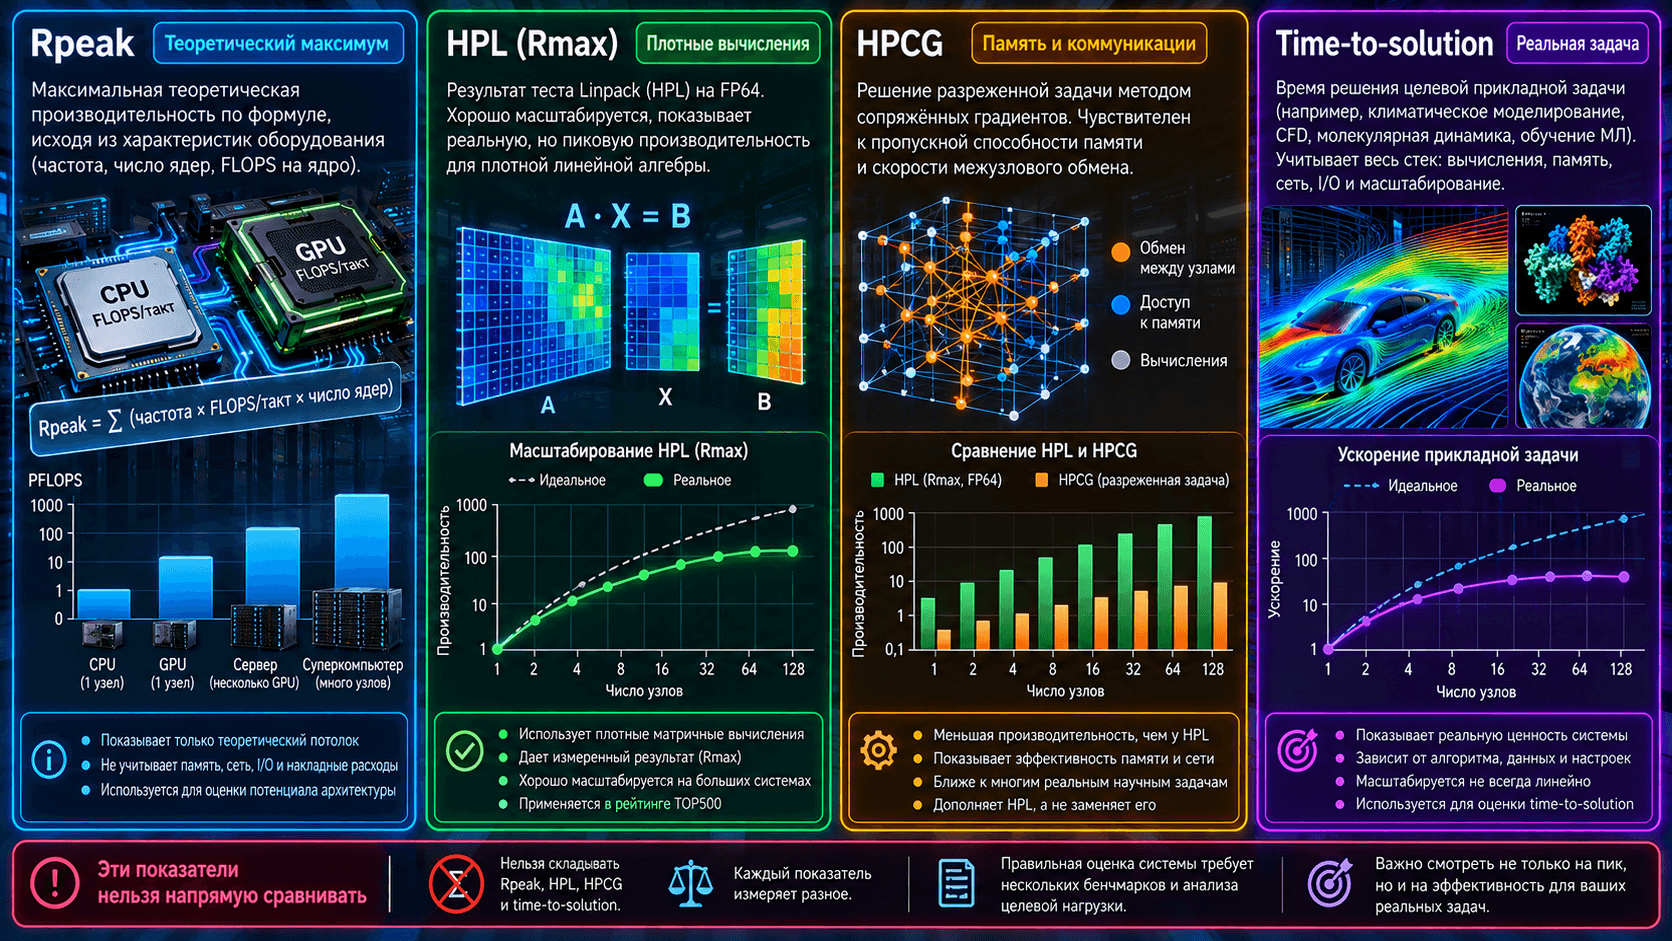
FLOPS, PFLOPS и EFLOPS
FLOP означает одну операцию с плавающей точкой. FLOP/s показывает число таких операций в секунду. Один PFLOP/s равен 10^15 операций в секунду, один EFLOP/s равен 10^18.
Без формата данных и метода измерения цифра неполна. FP64 нужен многим научным расчетам. AI часто использует BF16, FP8, FP4 или целочисленные форматы. Производительность в более низкой точности может быть намного выше, но она не отвечает на вопрос о скорости FP64-кода.
Rpeak и Rmax
Rpeak является расчетным теоретическим пиком по возможностям вычислительных блоков и частоте. Rmax показывает лучший измеренный результат HPL на системе. Rmax всегда следует читать вместе с benchmark, конфигурацией и датой.
HPCG и прикладные тесты
HPCG дополняет HPL. Он нагружает разреженное умножение матрицы на вектор, операции с векторами, глобальные скалярные произведения и локальные решатели. На результат сильнее влияют память и коммуникации.
Для проекта главными остаются показатели целевого приложения:
time-to-solution одной задачи;
число задач за сутки;
сильное и слабое масштабирование;
использование CPU и GPU;
memory bandwidth и объем памяти;
network latency и collective bandwidth;
I/O throughput и время checkpoint;
энергопотребление на полезный результат;
устойчивость длительных запусков.
Метрика | Что показывает | Чего не доказывает |
|---|---|---|
Rpeak | теоретический предел арифметики | достижимую скорость приложения |
HPL Rmax | измеренную FP64-производительность плотной линейной алгебры | скорость разреженного, memory-bound или I/O-bound кода |
HPCG | работу памяти, коммуникаций и разреженных kernels | результат любого solver или AI-модели |
AI FLOPS | throughput поддерживаемого формата и операции | FP64 HPL и качество модели |
Time-to-solution | время реальной задачи | универсальное превосходство во всех workloads |
Производительность на ватт | энергетическую эффективность теста | полный TCO и эффективность площадки |
Самые мощные суперкомпьютеры мира в 2026 году
TOP500 обновляется в июне и ноябре. На 13 октября 2026 года последней опубликованной редакцией остается список от июня 2026 года. Пять первых систем представлены ниже.
Место | Система | Архитектура | HPL Rmax | Rpeak |
|---|---|---|---|---|
1 | LineShine | LingKun, CPU LX2, LingQi | 2,1984 Эфлопс | 2,73582 Эфлопс |
2 | El Capitan | AMD EPYC и AMD Instinct MI300A, Slingshot 11 | 1,809 Эфлопс | 2,8211 Эфлопс |
3 | Frontier | AMD EPYC и AMD Instinct MI250X, Slingshot 11 | 1,353 Эфлопс | 2,05572 Эфлопс |
4 | Aurora | Intel Xeon CPU Max и Intel Data Center GPU Max, Slingshot 11 | 1,012 Эфлопс | 1,98001 Эфлопс |
5 | JUPITER Booster | NVIDIA Grace Hopper, InfiniBand NDR200 | 1,000 Эфлопс | 1,22628 Эфлопс |
LineShine показал 2,1984 Эфлопс в HPL и стал первой системой TOP500 с устойчивым результатом выше 2 Эфлопс. Он использует CPU-only архитектуру. Этот факт опровергает упрощенное утверждение, что современный суперкомпьютер обязательно строится на GPU.
Российские суперкомпьютеры в TOP500
В июньском TOP500 за 2026 год система Yandex Chervonenkis занимает 101-е место с HPL Rmax 21,53 Пфлопс. Galushkin находится на 134-м месте с 16,02 Пфлопс, Lyapunov на 161-м с 12,81 Пфлопс. Все три используют GPU NVIDIA A100 и InfiniBand, но отличаются конфигурацией и результатом.
Запросы о суперкомпьютерах Ломоносов и Ломоносов-2 относятся к комплексу МГУ. На странице TOP500 для Lomonosov 2 последним указан июнь 2025 года, когда система занимала 495-е место с HPL 2,478 Пфлопс. Отсутствие в новой редакции не доказывает остановку системы, поскольку TOP500 является рейтингом заявленных результатов, а не реестром всех работающих машин.
Для чего нужны суперкомпьютеры
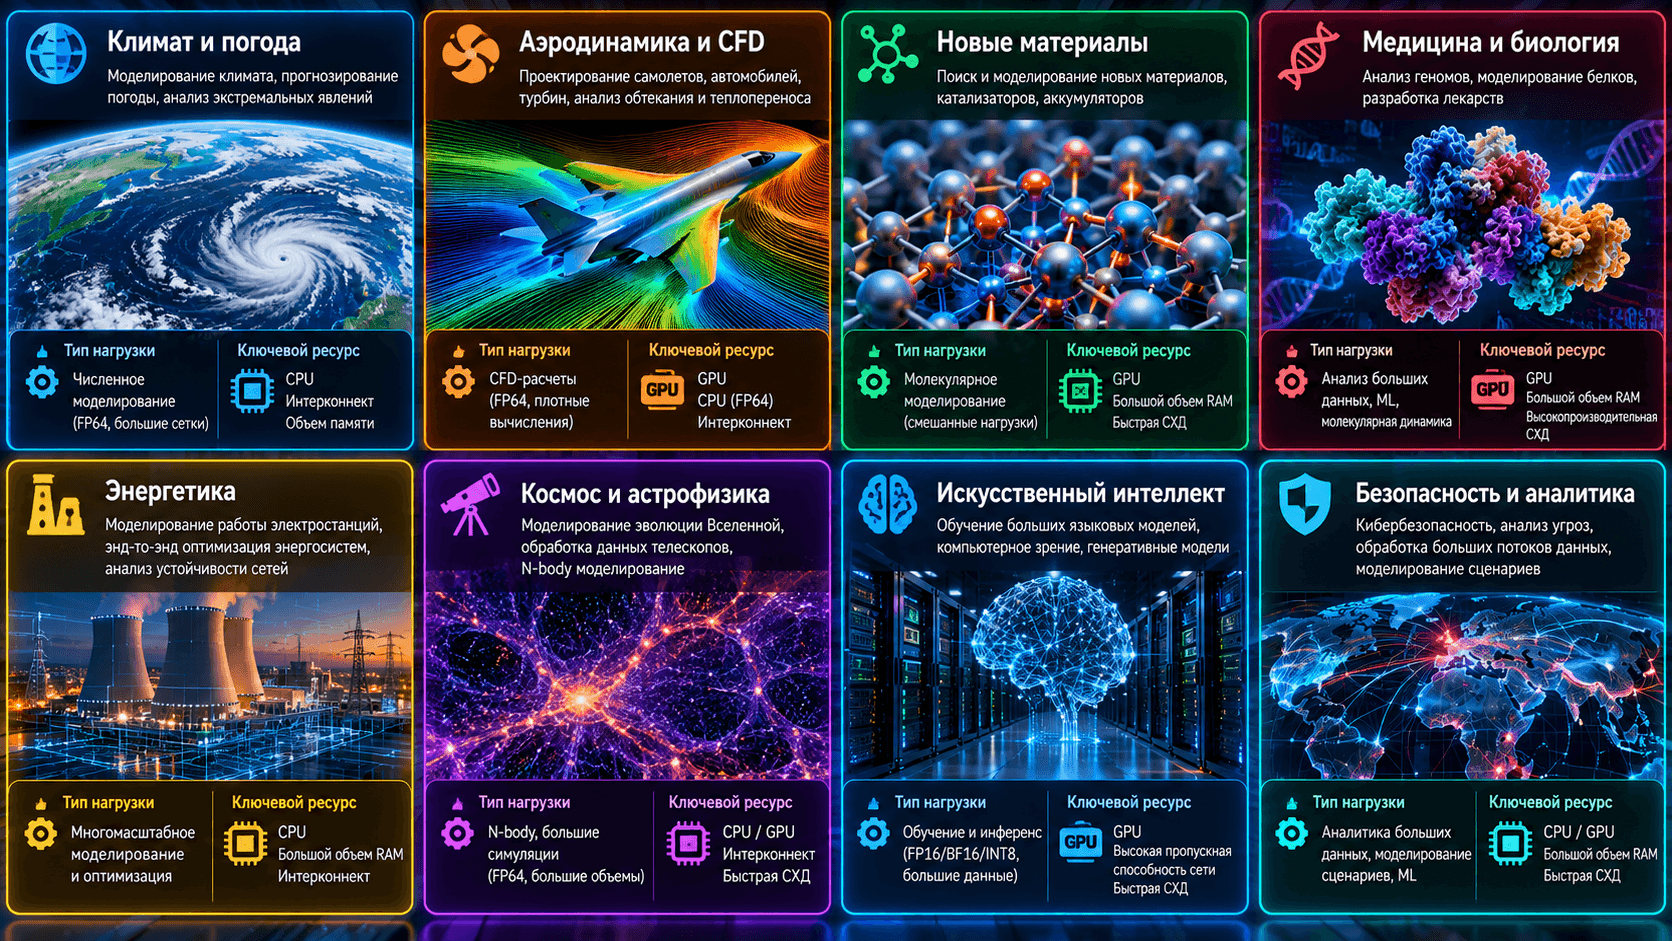
Погода и климат
Численные модели рассчитывают движение атмосферы и океана, перенос тепла, влаги и примесей. Чем выше пространственное разрешение и сложнее физика, тем больше вычислений, памяти и обменов между узлами.
Инженерное моделирование
CFD, прочность, электромагнетизм, горение и multiphysics помогают исследовать конструкцию до изготовления прототипа. Суперкомпьютер позволяет увеличить размер расчетной сетки, число вариантов и точность модели, если solver эффективно масштабируется.
Физика, химия и материалы
Молекулярная динамика, квантовая химия, физика плазмы и поиск материалов требуют большого числа математических операций. Расчеты помогают отбирать кандидатов для последующих экспериментов, но не заменяют физическую проверку.
Медицина и биоинформатика
HPC применяется для геномного анализа, молекулярного моделирования, обработки медицинских изображений и исследований лекарств. Архитектура зависит от workload: одни этапы требуют GPU, другие CPU, большой RAM или быстрого доступа к миллионам файлов.
Энергетика и геология
Сейсмическая обработка, моделирование месторождений, реакторов, сетей и новых источников энергии используют большие сетки и объемы данных. Здесь часто важны FP64, memory bandwidth и устойчивый ввод-вывод.
Космос и фундаментальная наука
Суперкомпьютеры моделируют эволюцию звезд и галактик, поведение частиц, турбулентность и сложные физические системы. Наблюдения телескопов и детекторов также требуют масштабной обработки данных.
Искусственный интеллект
Обучение крупной модели распределяется между GPU по данным, тензорам или этапам. Сеть переносит градиенты и активации, СХД подает датасет и принимает checkpoints. Для AI результат измеряется временем обучения, throughput, загрузкой GPU и качеством модели, а не только HPL.
Криптография и национальная безопасность
Системы применяются для моделирования, анализа, инженерных расчетов и исследований безопасности. Конкретные нагрузки и результаты могут не публиковаться. El Capitan, например, создан для задач NNSA, включая высокоточное моделирование и stewardship ядерного арсенала без подземных испытаний.
Когда организации нужен собственный суперкомпьютер
Название класса не должно быть первым пунктом технического задания. Сначала нужно доказать, что workload не помещается в один сервер, эффективно масштабируется и имеет экономически значимый срок выполнения.
Собственная HPC-система оправдана, если:
вычислительная загрузка регулярная и достаточно высокая;
время расчета влияет на выпуск продукта, исследование или принятие решения;
код масштабируется на несколько узлов;
объем данных делает облачную передачу медленной или дорогой;
есть требования к локализации, контролю доступа и воспроизводимости;
команда способна сопровождать ПО, очередь, мониторинг и пользователей;
площадка обеспечивает питание, охлаждение и сеть.
Как выбрать архитектуру суперкомпьютера
1. Описать workload
Нужны название и версия приложения, собственный или готовый код, размер задачи, тип solver, точность, объем входных данных, частота запусков и целевое время результата. Формулировка нужен мощный суперкомпьютер не позволяет выбрать оборудование.
2. Измерить базовую производительность
Профилируют CPU, GPU, RAM, memory bandwidth, I/O и сеть на текущей системе. Затем строят strong scaling curve хотя бы на нескольких размерах кластера. Это показывает, где дополнительные ресурсы перестают окупаться.
3. Выбрать вычислительные узлы
CPU и GPU подбирают под поддерживаемый код и тип арифметики. Одновременно рассчитывают RAM или HBM на задачу, локальные NVMe, число сетевых портов, PCIe-топологию и форм-фактор. Базовый состав платформы описан в статье серверное оборудование: что входит и как выбрать.
4. Рассчитать interconnect
Собирают профиль межузлового трафика, размер сообщений и collective operations. После этого выбирают скорость, topology, oversubscription, NIC или HCA, коммутаторы, кабели и резервирование. Каталог сетевого оборудования для AI и HPC показывает доступные классы компонентов, но финальная спецификация требует единой схемы fabric.
5. Спроектировать хранение
Считают рабочий набор, число файлов, поток чтения, размер checkpoint, частоту сохранения, окно восстановления и рост. СХД проверяют одновременно с вычислительной нагрузкой, иначе быстрые узлы будут простаивать.
6. Проверить площадку и эксплуатацию
Для каждой стойки нужны мощность, масса, охлаждение, сетевые трассы, PDU, мониторинг и план обслуживания. Отдельно задают пользователей, очереди, квоты, лицензии, резервное копирование и обновления.
7. Провести приемочные тесты
Приемка должна включать диагностику компонентов, burn-in, memory и GPU tests, MPI и collective benchmarks, сеть, СХД, отказные сценарии и целевое приложение. Паспортная мощность без повторяемого time-to-solution не подтверждает ценность системы.
Практическая отправная точка для подбора находится в разделе HPC-серверов для научных расчетов. Для rack-scale AI-нагрузок есть отдельная категория AI-суперкомпьютеров.
Пример многостоечной AI-системы
Суперкомпьютерный принцип хорошо виден в опубликованном проекте Start Server: многостоечный GPU-кластер для обучения собственной LLM.
В проект вошли 12 серверов и 96 GPU NVIDIA H200, сеть 400G InfiniBand, scale-out All-Flash СХД полезной емкостью около 1,5 ПБ и отдельный management-кластер. Расчетная мощность инфраструктуры составила около 350 кВт.
Типичные ошибки
Выбирать по пиковым FLOPS
Нужно сравнивать одинаковую точность, benchmark и реальный код. FP4 AI throughput нельзя поставить в одну таблицу с FP64 HPL без объяснения.
Покупать GPU без проверки приложения
Если solver не поддерживает ускоритель или основное время уходит на последовательный этап, дорогие GPU будут простаивать.
Недооценивать сеть
Увеличение числа узлов повышает объем обмена. Неподходящая topology или oversubscription обрывает масштабирование раньше вычислительного предела.
Проектировать СХД только по терабайтам
Емкость не показывает aggregate throughput, IOPS, metadata rate и время checkpoint. Профиль данных измеряется отдельно.
Считать рейтинг гарантией скорости
TOP500 ранжирует HPL. Прикладная программа с другой арифметикой, памятью и обменами может показать иной порядок систем.
Забывать про эксплуатацию
Планировщик, очереди, квоты, мониторинг, обновления, spare parts и специалисты являются частью решения. Система без эксплуатационной модели быстро теряет полезную загрузку.
Частые вопросы
Что такое суперкомпьютер кратко?
Это вычислительная система высшего для своего времени класса, предназначенная для быстрого решения крупных параллельных задач. Современный суперкомпьютер обычно состоит из множества узлов, сети, общей СХД и управляющего ПО.
Что делает суперкомпьютер?
Он делит расчет между множеством процессоров или ускорителей. Так выполняются моделирование, анализ больших научных данных, инженерные расчеты и обучение крупных AI-моделей.
Как работает суперкомпьютер?
Планировщик выделяет ресурсы, приложение запускает процессы на узлах, а процессы обмениваются данными через interconnect. Результаты и checkpoints записываются в параллельную систему хранения.
Чем суперкомпьютер отличается от обычного компьютера?
Масштабом параллелизма и всей инфраструктурой. Обычный ПК оптимизирован для интерактивной работы, а суперкомпьютер объединяет множество вычислительных ресурсов, сеть, СХД и программную среду ради минимального времени большой задачи.
Сколько процессоров и ядер у суперкомпьютера?
Фиксированного числа нет. Система может состоять из нескольких мощных узлов или миллионов учитываемых TOP500 cores. Сравнивать core count разных CPU и GPU напрямую некорректно.
Какой суперкомпьютер самый мощный в мире?
По HPL в июньском TOP500 за 2026 год первое место занимает LineShine с Rmax 2,1984 Эфлопс. После новой редакции рейтинга ответ может измениться.
Какой самый мощный российский суперкомпьютер?
Среди российских систем, опубликованных в TOP500 за июнь 2026 года, выше всех находится Yandex Chervonenkis: 101-е место и 21,53 Пфлопс HPL. Это утверждение относится к конкретной редакции добровольного рейтинга, а не ко всем непубличным системам страны.
Можно ли собрать суперкомпьютер дома?
Можно собрать небольшой вычислительный кластер из нескольких ПК или одноплатных систем и изучать MPI. Он не станет суперкомпьютером мирового класса: ограничениями будут сеть, питание, охлаждение, надежность и полезная производительность приложений.
Подходит ли суперкомпьютер для игр?
Обычно нет. Игры рассчитаны на один ПК и графический API, а не на распределенный запуск по тысячам узлов. Мощная игровая видеокарта и суперкомпьютер решают разные задачи.
Является ли AI-суперкомпьютер обычным HPC-кластером?
Он использует многие принципы HPC, но оптимизирован под GPU, HBM, low-precision операции, крупные модели и коллективный обмен. Его AI-производительность не следует напрямую сравнивать с FP64 HPL.
Сколько стоит суперкомпьютер?
Универсальной цены нет. Стоимость включает вычислительные узлы, сеть, СХД, стойки, ПО, лицензии, проектирование, интеграцию, питание, охлаждение и эксплуатацию. Сначала рассчитывают требуемый time-to-solution и масштаб, затем формируют спецификацию и TCO.
Что передать для расчета HPC-системы
Для предпроектной оценки нужны приложение и версия, исходный код или vendor requirements, тип и размер задач, текущие результаты, требуемое время расчета, точность, объем памяти, данные, число пользователей, частота запусков, лицензии и ограничения площадки.
Start Server может провести анализ нагрузки, спроектировать вычислительные узлы, сеть, СХД и management-контур, подготовить BOM и программу приемки. Результатом должен быть не абстрактно мощный суперкомпьютер, а система с измеримым временем решения вашей задачи и понятным планом масштабирования.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


