RAG-система, от Retrieval-Augmented Generation, сочетает поиск по внешней базе знаний с генерацией ответа языковой моделью. Перед вызовом LLM приложение находит релевантные фрагменты документов, помещает их в контекст и просит сформировать ответ на основе найденных материалов.
RAG не загружает всю базу знаний в веса модели и не гарантирует истинность ответа сам по себе. Качество зависит от документов, извлечения текста, chunking, metadata, embeddings, поиска, reranking, prompt, модели и процедуры оценки. Если retrieval не нашел правильный фрагмент, генератору часто не на что опереться.
Что такое RAG и какую проблему он решает
Языковая модель хранит знания в параметрах, полученных при обучении. Она не знает автоматически о закрытых регламентах компании, свежих версиях документации или изменениях в каталоге. Передавать все документы в каждый prompt дорого и часто невозможно из-за размера контекста.
RAG добавляет непараметрическую память в виде внешнего индекса. Модель получает только небольшую подборку материалов, связанную с вопросом. Это дает несколько преимуществ:
знания можно обновлять без полного обучения LLM;
доступ к документам можно контролировать на уровне поиска;
ответ можно сопровождать источниками;
retrieval и generation можно измерять отдельно;
одну модель можно использовать с несколькими коллекциями.
Из чего состоит архитектура RAG-системы
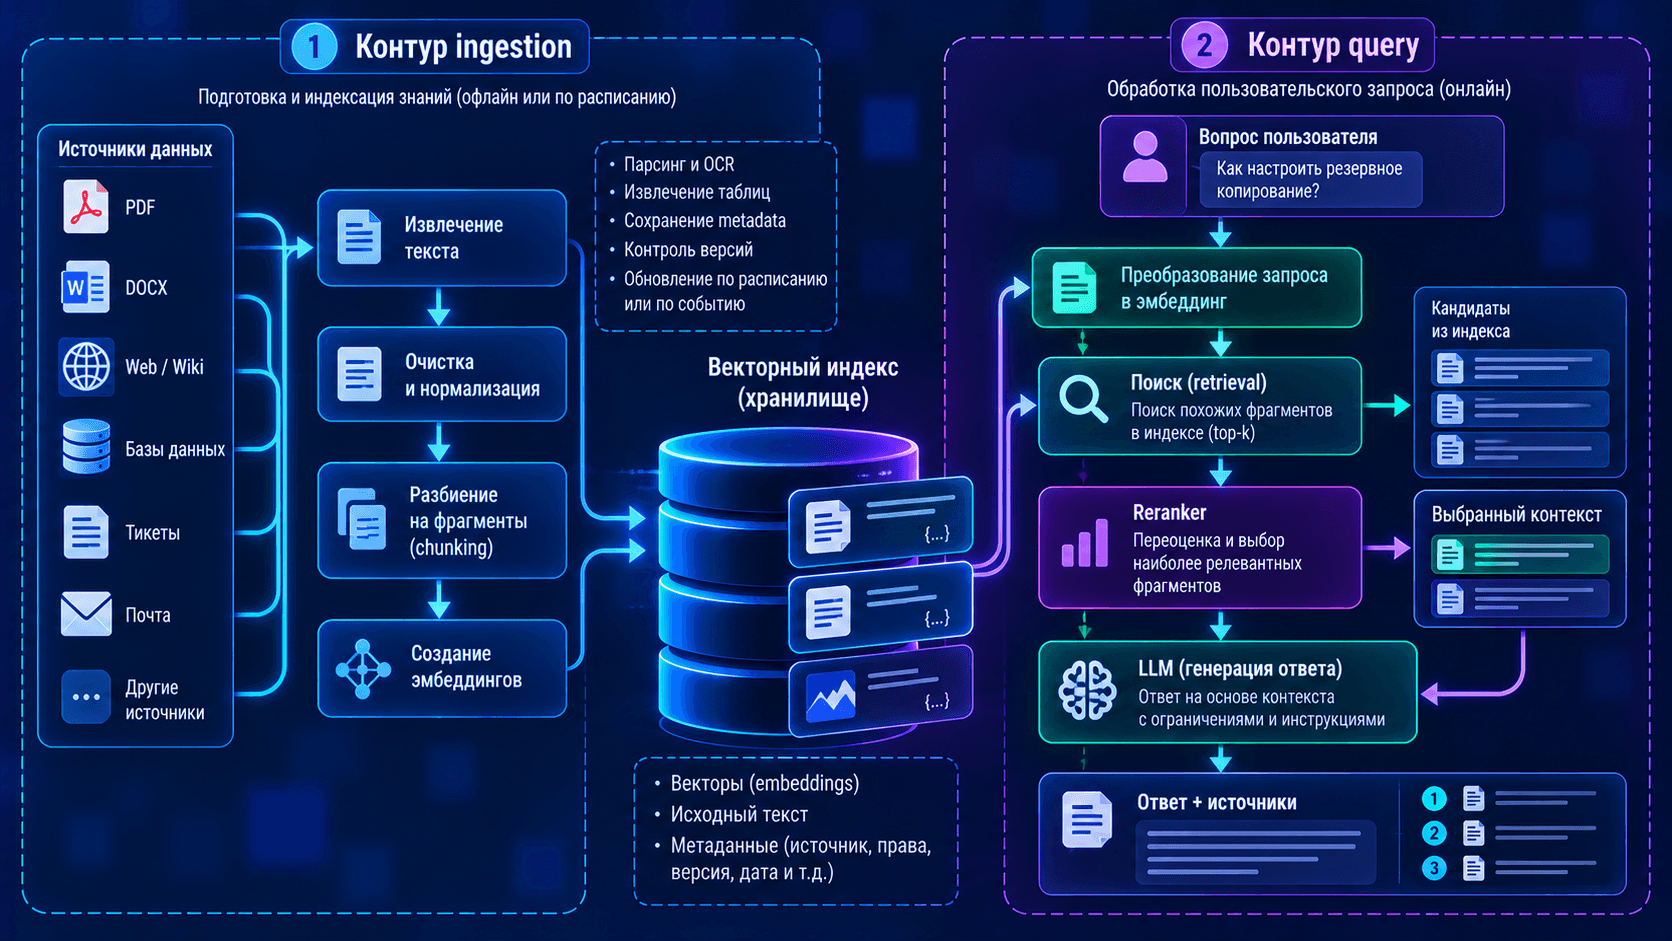
Источники данных
Источниками служат PDF, DOCX, HTML, wiki, базы данных, тикеты, почта, изображения, аудио и другие корпоративные системы. Для каждого источника нужны владелец, правила доступа, дата обновления, версия и политика удаления.
Конвейер ingestion
Ingestion получает документ, извлекает содержимое, нормализует его, делит на фрагменты, создает embeddings и записывает текст с metadata в индекс. Этот контур запускается по расписанию, событию или при изменении источника.
Парсер и OCR
PDF не всегда содержит линейный текст. Таблицы, колонки, сноски, сканы и подписи требуют layout-aware parsing и OCR. Ошибка здесь переносится во все последующие этапы. Красивый embedding не восстановит потерянную строку таблицы.
Chunking
Документ делят на chunks, которые можно найти и передать LLM. Маленький фрагмент точнее соответствует узкому вопросу, но способен потерять контекст. Большой сохраняет смысл, зато добавляет шум и расходует окно модели.
Стратегия может учитывать заголовки, абзацы, страницы, таблицы, код, семантические границы и overlap. Универсального размера chunk нет. Его выбирают экспериментом на реальных вопросах.
Embedding-модель
Embedding преобразует текст или другой объект в числовой вектор. Похожие по смыслу элементы оказываются ближе в выбранном пространстве. Модель для документов и запросов должна быть совместимой, поддерживать язык и длину входа.
Подробное объяснение векторов дано в статье эмбеддинги: что это и зачем нужны в RAG.
Индекс и хранилище
Vector database хранит embeddings и выполняет approximate nearest neighbor search. Рядом обычно сохраняются исходный текст, metadata, идентификатор документа, версия, права доступа и ссылка на источник. Не всякой системе нужна отдельная специализированная VDB: выбор зависит от масштаба, фильтрации, транзакционности и существующего стека.
Retriever
Retriever превращает вопрос в вектор, выполняет поиск и возвращает top-k кандидатов. Dense search находит семантическую близость. Keyword search силен на точных артикулах, кодах и именах. Hybrid search объединяет оба сигнала.
Reranker
Первичный retrieval оптимизирован на быстрый отбор. Reranker повторно оценивает меньший список пар «вопрос, фрагмент» и меняет порядок. Он способен улучшить relevance, но добавляет вычисления и latency.
Оркестратор и prompt builder
Оркестратор применяет фильтры доступа, выбирает коллекцию, формирует запрос к поиску, убирает дубли, собирает context и вызывает LLM. Здесь же задаются ограничения: отвечать только по источникам, признавать отсутствие данных, указывать citations и соблюдать формат.
Языковая модель
LLM синтезирует ответ по вопросу и найденным фрагментам. Более крупная модель не исправляет пустой или нерелевантный retrieval. Иногда компактной модели достаточно, если контекст точен и формат ответа ограничен.
Наблюдаемость и обратная связь
Нужно сохранять безопасный trace: версия индекса, запрос, найденные идентификаторы, scores, использованный context, версия prompt и модели, latency этапов, ответ и пользовательский feedback. Чувствительные данные маскируют по политике безопасности.
Как RAG-система отвечает на запрос
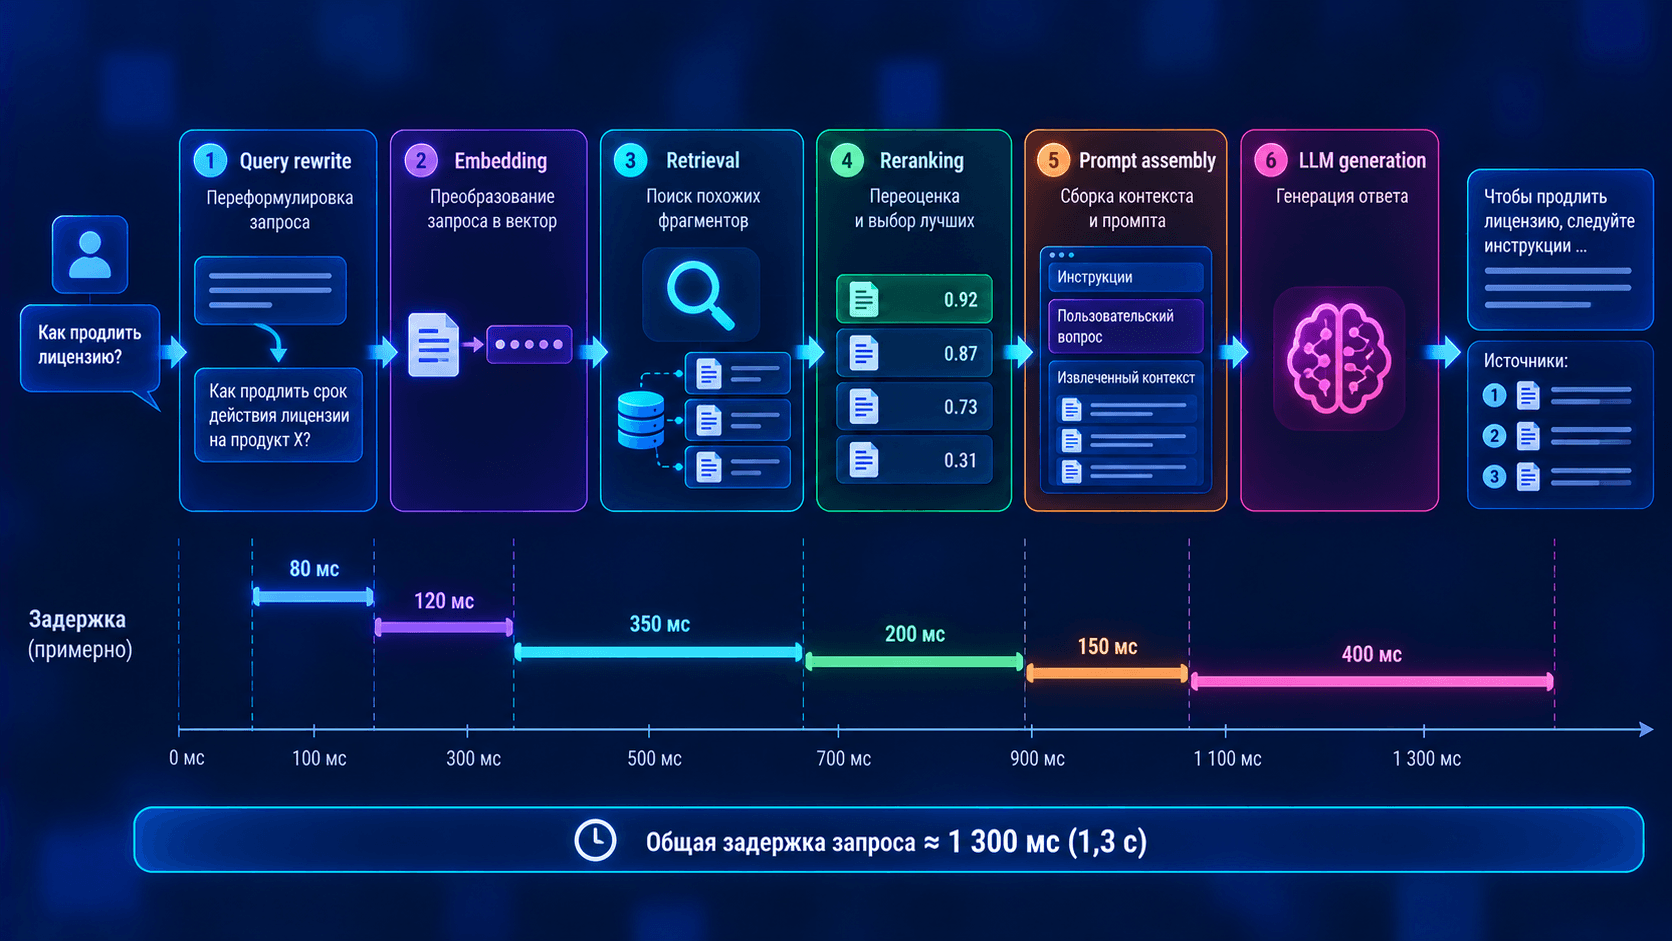
Пользователь проходит аутентификацию и отправляет вопрос.
Система определяет допустимые источники и фильтры.
При необходимости вопрос переписывается в самостоятельную поисковую формулировку.
Query embedding поступает в dense или hybrid search.
Retriever возвращает top-k chunks.
Reranker сортирует кандидатов и оставляет наиболее релевантные.
Prompt builder добавляет инструкции, вопрос, контекст и правила citations.
LLM генерирует ответ.
Приложение проверяет формат, прикрепляет источники и возвращает результат.
Метрики и feedback поступают в контур оценки.
Dense, keyword и hybrid search
Вариант | Сильная сторона | Слабая сторона | Когда применять |
|---|---|---|---|
Keyword | точные слова, артикулы, коды | хуже понимает перефразирование | каталоги, нормы, идентификаторы |
Dense | семантика и перефразирование | может пропустить точный редкий термин | вопросы на естественном языке |
Hybrid | сочетает точность и семантику | сложнее настройка и fusion | разнородная корпоративная база |
Стандартный RAG и agentic RAG
Стандартный pipeline выполняет фиксированную последовательность: поиск, сбор context, генерация. Он предсказуем, проще измеряется и подходит для прямых вопросов.
Agentic RAG дает модели инструменты и цикл принятия решений. Агент может разложить вопрос, обратиться к нескольким коллекциям, изменить запрос и выполнить повторный retrieval. Это полезно для multi-hop задач и неоднозначных вопросов, но повышает latency, стоимость и риск непредсказуемого пути.
Начинать лучше со стандартного RAG. Agentic-подход добавляют, когда набор ошибок показывает, что одного retrieval-step действительно недостаточно.
Как оценивать качество RAG
Оценка должна разделять retrieval и generation. Иначе хороший ответ на знакомый вопрос может скрыть слабый поиск, а плохая формулировка модели испортит оценку правильных источников.
Метрики retrieval
Метрика | Что проверяет |
|---|---|
Recall@k | попал ли нужный фрагмент в первые k результатов |
Precision@k | какая доля top-k действительно релевантна |
MRR | насколько высоко стоит первый релевантный результат |
NDCG | порядок нескольких результатов с разной релевантностью |
Coverage | для какой доли вопросов база содержит ответ |
Метрики ответа
Проверяют соответствие вопросу, опору на context, фактическую корректность, полноту, корректность citations, соблюдение формата и способность отказаться при отсутствии данных. LLM-as-judge полезен для масштаба, но его калибруют на человеческой разметке и не принимают за абсолютную истину.
Системные метрики
Измеряют p50, p95 и p99 end-to-end latency, время retrieval, reranking и generation, throughput, error rate, длину context, cache hit rate, utilization и стоимость запроса.
Главный набор представляет собой representative-вопросы с эталонными источниками и критериями ответа. Он включает простые вопросы, multi-hop, отсутствие ответа, конфликтующие версии и запросы без прав доступа.
Как сделать RAG-систему: этапы внедрения
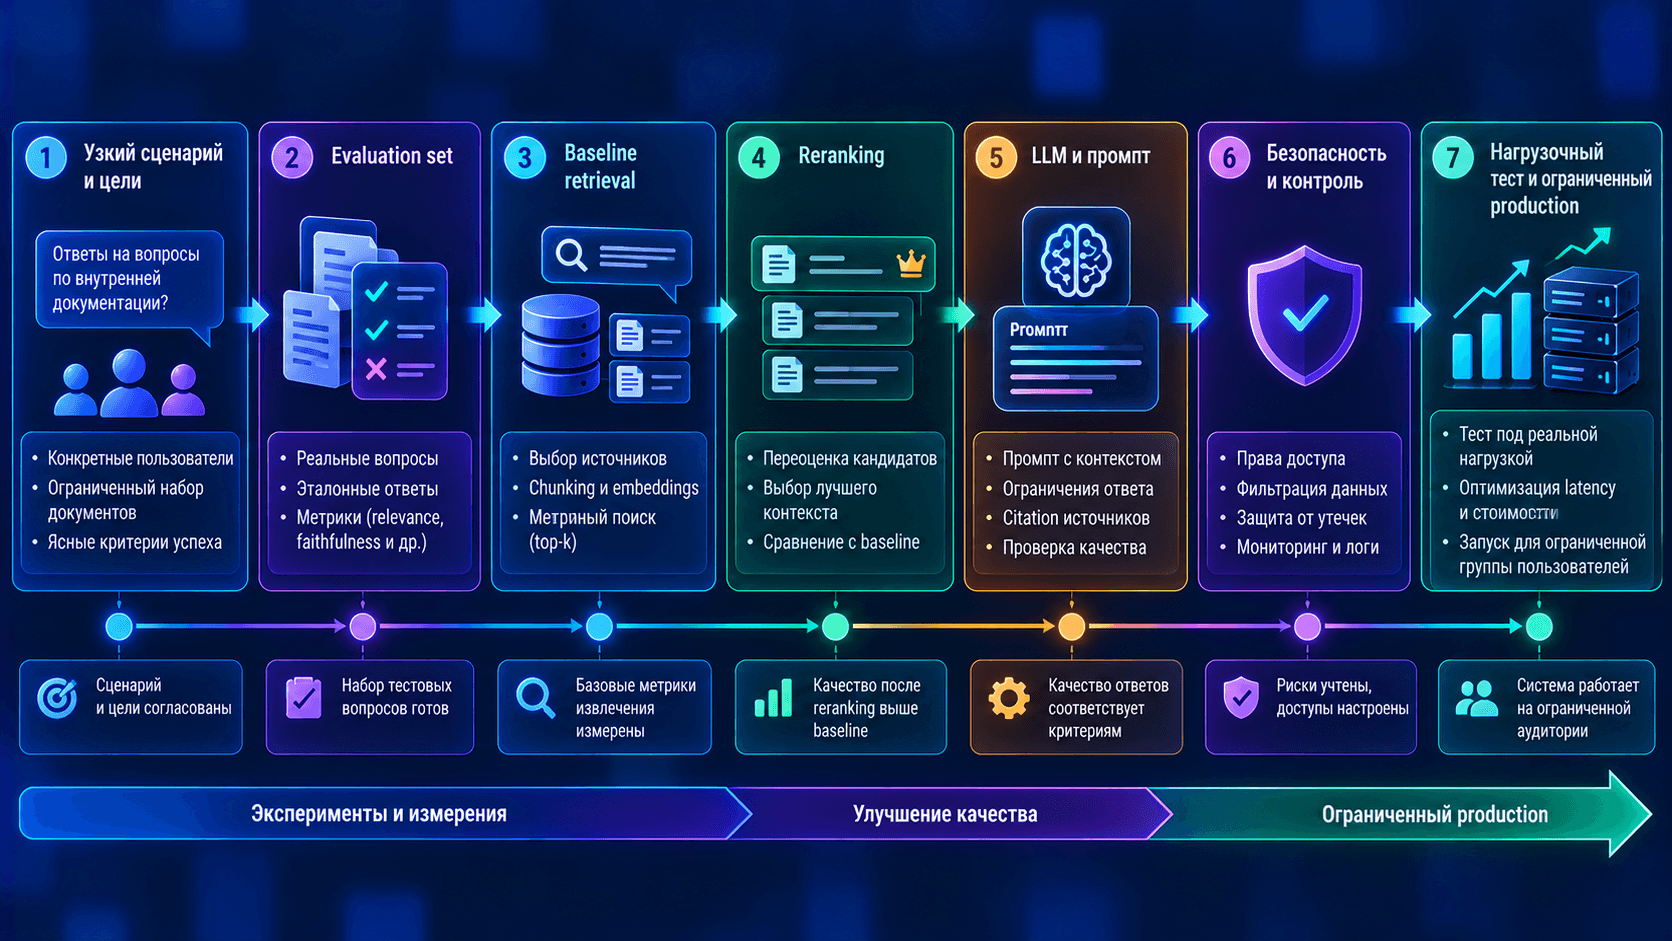
1. Ограничить сценарий
Выберите пользователей, источники, типы вопросов и действие после ответа. «Чат по всем данным компании» слишком широк для первого пилота.
2. Подготовить evaluation set
Соберите реальные вопросы и документы до настройки pipeline. Для каждого вопроса укажите, где находится ответ, какие формулировки допустимы и когда система должна отказаться.
3. Построить ingestion
Подключите один или два источника, настройте parsing, очистку, chunking, metadata и обновление. Сохраняйте связь фрагмента с документом и версией.
4. Настроить baseline retrieval
Сначала получите измеримый keyword или dense baseline. Затем сравните hybrid search, разные embedding-модели, chunking и top-k. Меняйте по одному фактору.
5. Добавить reranking
Reranker включают после измерения первого retrieval. Проверьте выигрыш Recall@k или NDCG и дополнительную latency.
6. Подключить LLM
Сформулируйте prompt, формат citations и правила отказа. Сравните несколько моделей на одинаковом retrieved context. Это отделит качество генератора от качества поиска.
7. Реализовать безопасность
Права применяют до возврата fragments. Нужны tenant isolation, журналирование, шифрование, защита от prompt injection в документах, фильтрация вывода и процедура удаления данных.
8. Провести нагрузочный тест
Измерьте ingestion throughput, время обновления индекса, concurrency запросов, p95 latency, расход памяти и деградацию при росте коллекции.
9. Запустить ограниченный production
Начните с группы пользователей, покажите citations и добавьте канал обратной связи. Ошибки классифицируйте по этапу: source, parse, chunk, retrieval, rerank, prompt или generation.
10. Настроить жизненный цикл
Определите владельцев данных и модели, SLA обновления, versioning, rollback, мониторинг, переоценку и правила изменения компонентов.
Локальная RAG-система или облачный сервис
Локальное развертывание дает контроль над документами, версиями моделей, логами и сетевым контуром. Оно подходит при требованиях к конфиденциальности, predictable-cost и интеграции с внутренними системами. Организация при этом отвечает за оборудование, обновления, резервирование и безопасность.
Облако ускоряет пилот и дает эластичные ресурсы. Нужно проверить место обработки данных, договорные условия, rate limits, стоимость embeddings и generation, доступность моделей и возможность переноса.
Оборудование для RAG
RAG состоит из разных профилей нагрузки:
parsing и OCR используют CPU, RAM, иногда GPU;
embedding требует batch-вычислений и памяти модели;
vector database зависит от RAM, NVMe, индекса и фильтрации;
reranker создает latency-sensitive inference;
LLM обычно предъявляет самые высокие требования к VRAM;
orchestration, API и monitoring работают на CPU-узлах.
Необязательно размещать все на одном GPU. Распределение CPU или GPU для retrieval-компонентов разобрано в статье CPU или GPU для embeddings и reranker.
Расчет сервера начинают с моделей, объема индекса, скорости ingestion, числа одновременных запросов, длины context и целевой p95. Подробная методика приведена в материале сервер для корпоративного RAG.
Классы решений собраны в категории AI-серверов для RAG-систем. Для закрытого корпоративного контура полезен также проект частного AI-кластера для LLM и RAG, но его параметры нельзя переносить на другой workload без расчета.
Типичные ошибки RAG-проектов
Выбирать LLM до инвентаризации документов.
Считать vector database готовой RAG-системой.
Использовать один размер chunk для текста, таблиц и кода.
Не хранить metadata и версию источника.
Не фильтровать retrieval по правам доступа.
Смешивать ошибки поиска и генерации в одной оценке.
Настраивать pipeline на демонстрационных вопросах.
Не включать вопросы без ответа в evaluation set.
Увеличивать context вместо улучшения retrieval.
Добавлять agentic RAG до измеримого baseline.
Не измерять p95 и p99 latency.
Игнорировать prompt injection внутри документов.
Не планировать обновление и удаление данных.
Покупать сервер по размеру LLM без расчета индекса, OCR и concurrency.
FAQ
Что такое RAG-система простыми словами?
Это приложение, которое сначала ищет материалы во внешней базе знаний, затем передает найденный context языковой модели для ответа.
Чем RAG отличается от обычной LLM?
LLM отвечает на основе prompt и своих параметров. RAG перед генерацией добавляет сведения из управляемых внешних источников.
RAG обучает языковую модель на документах?
Обычно нет. Документы индексируются отдельно, а нужные фрагменты добавляются в context при запросе. Fine-tuning решает другую задачу.
Как сделать RAG-систему?
Ограничить сценарий, собрать evaluation set, построить ingestion и baseline retrieval, проверить chunking и embeddings, добавить reranking и LLM, затем реализовать безопасность и нагрузочный тест.
Почему RAG дает неправильные ответы?
Причина может находиться в источнике, parsing, chunking, retrieval, reranking, prompt или generation. Диагностику проводят по trace каждого этапа.
Что важнее, embedding-модель или LLM?
Оба компонента влияют на результат. Если правильный fragment не найден, сильной LLM нечего цитировать. Если retrieval хорош, слабый генератор способен неверно собрать ответ.
Нужна ли vector database?
Нужен механизм хранения и поиска векторов, но не всегда отдельный продукт. Решение зависит от масштаба, фильтрации, существующей базы и эксплуатационных требований.
Что такое hybrid search в RAG?
Это объединение keyword и dense retrieval. Он помогает одновременно учитывать точные термины и семантическую близость.
Нужен ли GPU для RAG?
Не для всех компонентов. Vector search и orchestration могут работать на CPU. GPU чаще нужен для embeddings при большой нагрузке, reranker и локальной LLM.
Можно ли развернуть RAG без интернета?
Да, если модели, зависимости, индекс и источники доступны внутри контура. Нужно заранее решить обновление программного обеспечения и моделей.
Что передать для пилота RAG
Подготовьте список источников, 50-200 representative-вопросов, правила доступа, примеры желаемого ответа, требования к citations, число пользователей, SLA и ограничения контура. Start Server поможет построить тестовый профиль, разделить CPU и GPU-компоненты и рассчитать инфраструктуру. Отправить вводные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


