Спецификацию RAG-системы легко начать с GPU:
«Будет локальная LLM — значит сначала выбираем ускорители».
Это рискованный порядок.
RAG — не одна модель и не один workload. В production pipeline могут одновременно существовать:
обработка документов;
chunking;
embeddings;
vector database;
retrieval;
optional reranking;
сборка prompt;
LLM generation;
API и orchestration.
У каждого этапа свои требования к CPU, RAM, GPU, storage и network.
Поэтому проверять спецификацию лучше так:
Business Requirement → Actual Pipeline → Corpus / Ingestion → Vector Layer → Retrieval / Optional Reranking → Generation → Availability / Growth → Component Resource Model → Requirement-to-BOM Traceability → OK / UNDER / OVER? / UNKNOWN → Validation Plan → Hardware Specification.
Главный принцип:
Размер LLM — только один из входных параметров RAG-инфраструктуры. Мощный GPU не компенсирует недостающую RAM, медленный vector layer, I/O bottleneck или неверно рассчитанную нагрузку.
Не начинайте с SKU
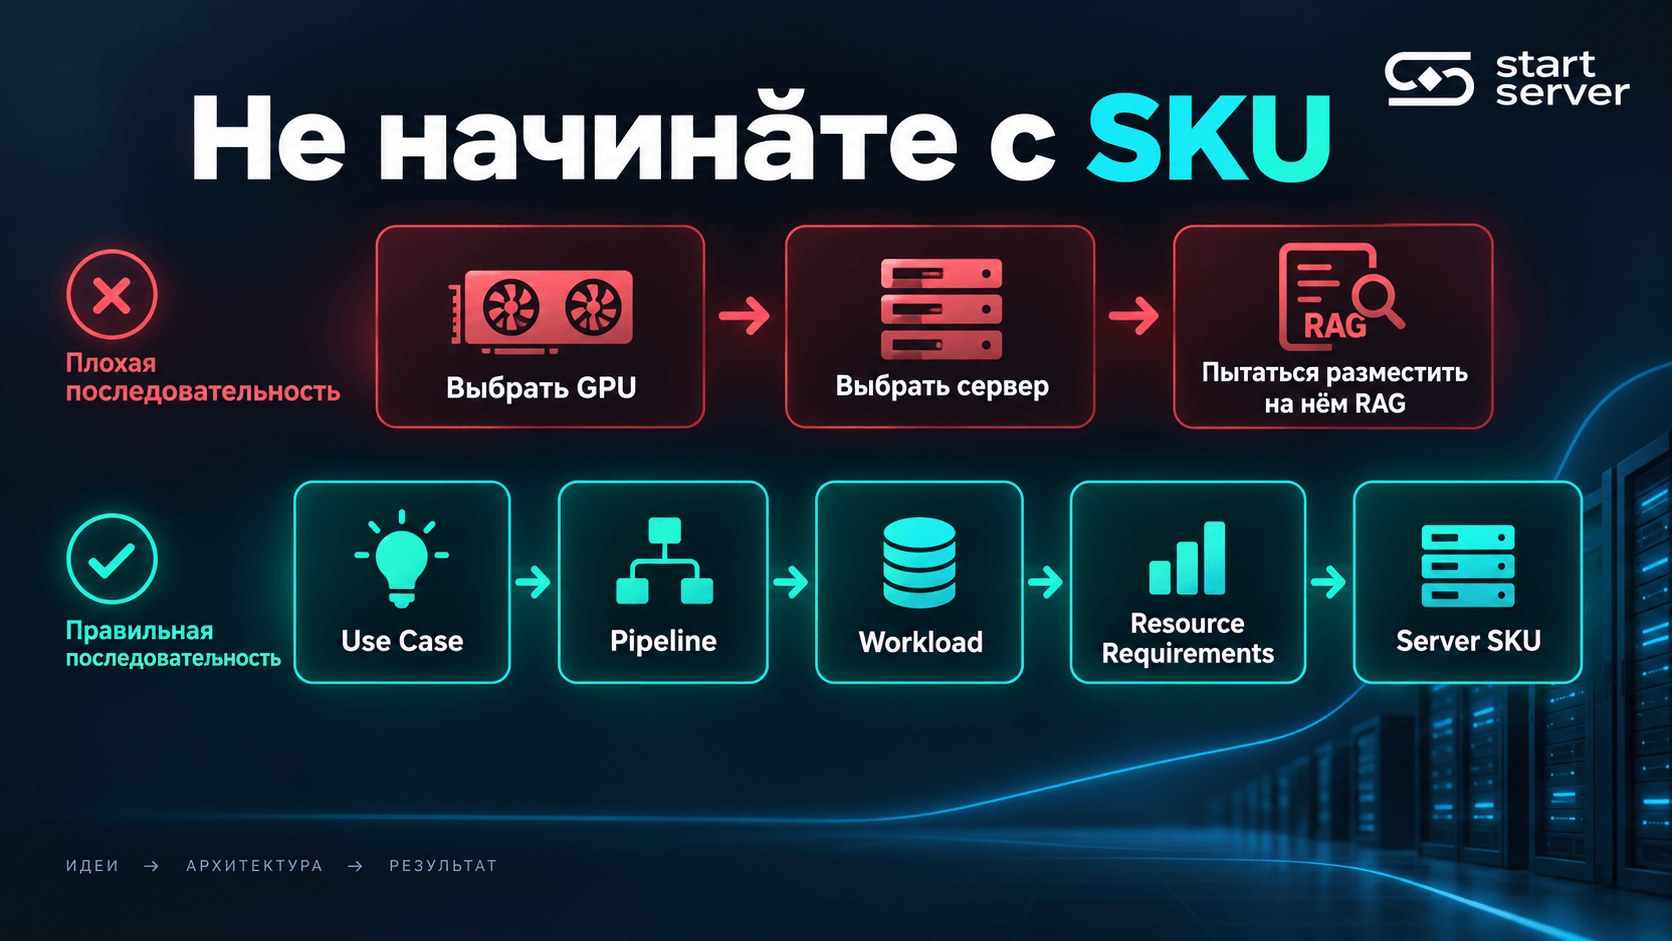
Плохая последовательность:
Выбрать GPU → выбрать сервер → попытаться разместить на нём RAG.
Сильнее:
Use Case → Pipeline → Workload → Resource Requirements → Deployment Model → Server SKU.
Это позволяет отличить:
реально необходимый ресурс;
запас на growth;
архитектурное требование;
необоснованную дорогую строку BOM.
RAG — это не обязательно один сервер
Фраза:
«Нам нужен RAG-сервер»
ещё почти ничего не говорит о hardware.
Один проект может разместить все stages на одном node.
Другой — разделить:
ingestion;
vector database;
reranking;
LLM inference.
Минимальная component map:
Stage | Тип нагрузки | Основные ресурсы |
|---|---|---|
Parsing / OCR | preprocessing | CPU, RAM, storage, иногда GPU |
Chunking | preprocessing | CPU, RAM |
Embedding | model inference | CPU/GPU, RAM/VRAM |
Vector storage/index | search/storage | RAM, CPU, storage |
Retrieval | online search | CPU, RAM, storage |
Reranking, если используется | model inference | CPU/GPU, RAM/VRAM |
Prompt assembly | application | CPU, RAM |
LLM generation | inference | GPU/VRAM, CPU, RAM |
API/orchestration | service | CPU, RAM, network |
Поэтому:
LLM Size ≠ Full RAG Server Requirement.
Шаг 1. Зафиксируйте business requirements
До обсуждения hardware нужно получить хотя бы:
Поле | Значение |
|---|---|
Use case | |
Источники знаний | |
Исходный объём данных | |
Рост данных | |
Частота обновления | |
Ingestion window | |
Языки / модальности | |
Active users | |
Peak request rate | |
Peak request concurrency | |
Latency SLO | |
Availability requirement | |
Data locality/security | |
Planning horizon |
Если параметр неизвестен, правильный статус:
UNKNOWN.
Не нужно заменять его «типичным» числом.
UNKNOWN — полезный результат аудита
Предположим, известно:
RAG будут использовать 2 000 сотрудников.
Из этого нельзя вывести:
нужно обслуживать 2 000 одновременных LLM sequences.
Нужно отдельно знать:
active users;
request arrival rate;
bursts;
simultaneous requests;
prompt lengths;
response lengths.
Поэтому:
Registered Users ≠ Concurrent Inference Requests.
UNKNOWN превращается:
в вопрос владельцу продукта;
в анализ существующей нагрузки;
в benchmark/load-test task.
Это сильнее выдуманного sizing assumption.
Шаг 2. Разделите ingestion и online query path
RAG обычно имеет как минимум два разных режима.
Ingestion
Documents → Parsing/OCR → Chunking → Embedding → Indexing.
Здесь важны:
документов или страниц в единицу времени;
объём daily/weekly updates;
окно обновления knowledge base;
embedding throughput;
indexing/write load.
Online query
Query → Query Embedding → Retrieval → Optional Reranking → Prompt → LLM → Response.
Здесь важны:
QPS;
concurrency;
retrieval latency;
reranking latency;
LLM latency;
end-to-end SLO.
Поэтому:
Ingestion Throughput ≠ Query Throughput.
Search-only benchmark недостаточен при continuous ingestion
Vector database под writes может выполнять:
запись новых данных;
построение индексов;
merge/optimization;
обслуживание query traffic.
В current Qdrant heavy update load способен конкурировать с search за CPU, memory и I/O; его optimizer также работает с сегментами и индексами в background.
Поэтому:
Search-Only Sizing ≠ Mixed Ingest/Search Sizing.
Если production постоянно обновляет knowledge base, validation должна воспроизводить этот режим.
Шаг 3. Переведите документы в количество vectors
Исходный объём файлов — плохой прямой sizing input для vector layer.
Например:
2 TB PDF
ещё не говорит:
сколько текста получится после parsing/OCR;
как он будет chunked;
сколько points/vectors будет создано;
какой embedding dimension;
какой payload будет храниться.
Правильная цепочка:
Source Documents → Parsed Content → Chunking → Stored Points/Vectors.
Поэтому:
Document Count ≠ Vector Count.
Chunking — это infrastructure variable
Chunk size и overlap влияют одновременно на:
количество vectors;
embedding workload;
vector storage;
ingestion duration;
retrieval granularity;
количество текста, которое потенциально попадёт в prompt.
Поэтому:
Chunking Strategy Is a Capacity Variable.
Она должна присутствовать в infrastructure specification, а не только в ML notebook.
Corpus & Index Card
Соберите:
Поле | Значение |
|---|---|
Vector DB / version | |
Source documents | |
Parsed content | |
Chunk size / overlap | |
Estimated points/vectors | |
Embedding model/revision | |
Dimensions | |
Original vector datatype | |
Quantization method, если есть | |
Sparse vectors, если есть | |
Payload | |
ANN/index configuration | |
Replication factor | |
Original-vector memory tier | |
Quantized-vector memory tier | |
Index memory tier | |
Growth horizon |
Первый arithmetic estimate vector footprint
Для original dense vectors:
Raw Vector Bytes = N × D × B
где:
N— число vectors;D— dimensions;B— bytes per dimension.
Current Qdrant capacity guidance использует аналогичную базу, дополнительно умножая number of points на replication factor для aggregate storage across replicas.
Но это только original vector data.
Не полный размер vector database.
Поэтому:
Raw Vector Size ≠ Vector Database RAM Requirement.
Replication — aggregate cluster factor
Если replication factor равен двум, это не означает автоматически:
каждый node использует ровно вдвое больше RAM.
Replication влияет на aggregate amount of replicated data, а фактическое распределение зависит от:
shards;
replicas;
node count;
placement.
В current Qdrant capacity model:
base = number_of_points × replication_factor
используется именно как total points across replicas.
Поэтому:
Replication Factor = Capacity + Availability + Read/Write Trade-off.
Не просто «умножитель RAM одного сервера».
Original vector datatype и quantization — разные вещи
Это принципиально.
Qdrant отдельно определяет datatype original vectors — например:
Float32;
Float16;
Uint8;
Turbo4.
И отдельно — quantization, которая создаёт additional quantized representation.
Поэтому:
Original Vector Datatype ≠ Quantization Method.
Например:
original vector stored as
uint8
и:
Float32 original + scalar quantization
— не одна и та же configuration.
Quantization не обязательно заменяет original vectors
Current Qdrant хранит quantized representation alongside the originals.
Следовательно:
Quantized Copy ≠ Replacement of Original Vectors by Definition.
Нельзя просто взять compression ratio и разделить на него весь disk footprint системы.
Останутся другие structures:
original vectors;
HNSW;
payload;
payload indexes;
identifiers;
operational data.
Quantization имеет quality trade-off
Compression может снизить memory footprint или ускорить search path, но approximation способна изменить retrieval quality.
Qdrant прямо рекомендует проверять recall/quality для используемых embeddings и quantization method.
Поэтому:
Lower Memory Footprint ≠ Free Capacity Gain.
И точнее:
Vector Compression Must Pass Retrieval-Quality Validation.
Vector database — это не только vectors
Помимо original embeddings могут существовать:
ANN indexes;
sparse indexes;
payload;
payload indexes;
quantized representations;
replication;
runtime/optimizer structures.
Именно поэтому formula:
N × D × bytes
— полезная арифметическая отправная точка, но не BOM для RAM/storage.
Шаг 4. Разведите persistent storage и RAM residency
Полезный вопрос:
Какие structures должны быть постоянно или часто доступны из RAM, а какие допустимо обслуживать с storage/page cache?
В current Qdrant v1.19+ есть per-structure memory tiers:
pinned;cached;cold.
Но эти semantics нужно version-pin.
Memory-Tier Semantics Must Be Version-Pinned.
Что означает cached
cached в current Qdrant означает memory-mapped data, которое Qdrant прогревает в OS page cache при startup.
Но OS может evict эти pages при memory pressure.
Поэтому:
Cached Data ≠ Guaranteed Permanent RAM Residency.
Это не то же самое, что:
данные навсегда закреплены в RAM.
Что означает pinned
Для поддерживаемых structures pinned означает heap-backed resident data, которое Qdrant не evict'ит.
Но current Qdrant прямо ограничивает applicability: например, dense vectors и payloads не поддерживают pinned и используют memory-mapped representations.
Поэтому нельзя давать универсальный совет:
«закрепите все vectors в pinned RAM».
Что означает cold
cold не pre-warm'ит данные в memory; page попадает в OS cache после фактического access.
Такой design позволяет уменьшить RAM budget, но больше зависит от storage behaviour.
Отсюда:
Vector Database Capacity ≠ RAM Only.
Enough TB ≠ Enough Storage Performance
Если часть search path обращается к disk-backed structures, важны:
read latency;
random I/O behaviour;
page-cache hit rate;
index placement.
Большой storage volume без подходящего I/O может не выполнить search SLO.
Поэтому:
Enough TB ≠ Enough Storage Performance.
Шаг 5. Определите actual retrieval architecture
Не каждый RAG использует одинаковую схему.
Возможны:
dense retrieval;
sparse retrieval;
hybrid retrieval;
direct retrieval→generation;
retrieve-and-rerank;
собственный ranking stage.
Поэтому:
RAG ≠ Mandatory Retrieve-and-Rerank Architecture.
Сначала фиксируется actual pipeline.
Потом sizing.
Если reranker есть, считайте его отдельно
Sentence Transformers описывает распространённый pattern:
Bi-Encoder Retrieval → Top-K Candidates → CrossEncoder Reranking.
CrossEncoder обычно медленнее bi-encoder, поскольку вычисляет score отдельно для каждой пары query-document, поэтому часто применяется к ограниченному candidate set.
Если architecture содержит такой reranker, у него собственная compute load.
Candidate count — прямой input reranker workload
Для reranker важно знать:
QPS;
candidates/query;
input length;
model;
batching.
Если на один query приходится:
10 pairs;
и:
200 pairs,
это разные workloads.
Поэтому в карточке лучше отдельно хранить:
Retrieval candidate count
и:
Reranker candidate count.
Retrieval Top-K не равно final prompt size
Например:
Retriever: 100
→ Reranker: 100
→ Keep: 10
→ Prompt builder: 5 chunks.
Значит, нужны разные поля:
Параметр | Значение |
|---|---|
Retrieval candidates | |
Rerank candidates | |
Final passages | |
Final prompt tokens |
Поэтому:
Retrieval Top-K ≠ Final Prompt Size.
Шаг 6. Отдельно спроектируйте generation layer
После retrieval начинается другая ресурсная задача — LLM inference.
Необходимые business inputs:
Поле | Значение |
|---|---|
Model/revision | |
Typical input tokens | |
Required maximum prompt/output envelope | |
Typical output tokens | |
Peak request concurrency | |
Request arrival rate | |
Latency SLO | |
Throughput requirement |
А уже затем выбирается runtime configuration.
Supported, configured и typical context — три разных значения
Current vLLM определяет max_model_len как model context length, включающую prompt и output.
Если parameter не задан, значение выводится из model configuration; режим auto/-1 может искать maximum length, помещающуюся в GPU memory.
Поэтому нельзя смешивать:
maximum, который поддерживает model architecture;
max_model_len, configured в runtime;typical production context.
Формула:
Supported Context ≠ Configured Context ≠ Typical Request Context.
Model maximum context не является sizing requirement сам по себе
Если model поддерживает большой context, это ещё не означает:
сервер обязан выдерживать этот maximum для всех production requests при максимальной concurrency.
Нужно знать actual workload:
System Prompt
User Prompt
Retrieved Context
Expected Output.
Поэтому:
Model Maximum Context ≠ Required Production Context.
Business concurrency и max_num_seqs — не одно и то же
Current vLLM описывает max_num_seqs как:
maximum number of sequences processed in a single scheduler iteration.
Это runtime scheduler/runner capacity parameter.
Не число пользователей.
И не прямой synonym всей service concurrency.
Поэтому:
max_num_seqs ≠ Number of Users.
max_num_seqs ≠ Entire Service Concurrency by Definition.
Не переводите concurrency в один runtime flag
Business side должна определить:
request rate;
simultaneous requests;
prompt length distribution;
output distribution;
latency target.
После этого engine configuration может включать:
max_model_len;max_num_seqs;token scheduler limits;
KV-cache budget;
parallelism;
admission/queue controls.
Например, current vLLM также имеет scheduler-level token budget controls, а deployment/API layer может иметь отдельные in-flight/queue limits.
Поэтому:
Concurrent Requests ≠ max_num_seqs Automatically.
Generation Card
Workload requirements
Поле | Значение |
|---|---|
Model/revision | |
Typical input tokens | |
Required max prompt/output envelope | |
Typical output | |
Peak request concurrency | |
Request arrival rate | |
Latency SLO | |
Throughput target |
Runtime validation
Поле | Значение |
|---|---|
max_model_len | |
max_num_seqs | |
Other admission/queue limits | |
Token scheduling budget | |
KV-cache configuration | |
Parallelism | |
Measured sustainable concurrency |
Главный итоговый parameter:
measured sustainable workload under required latency, а не одно runtime flag.
RAG меняет LLM input workload
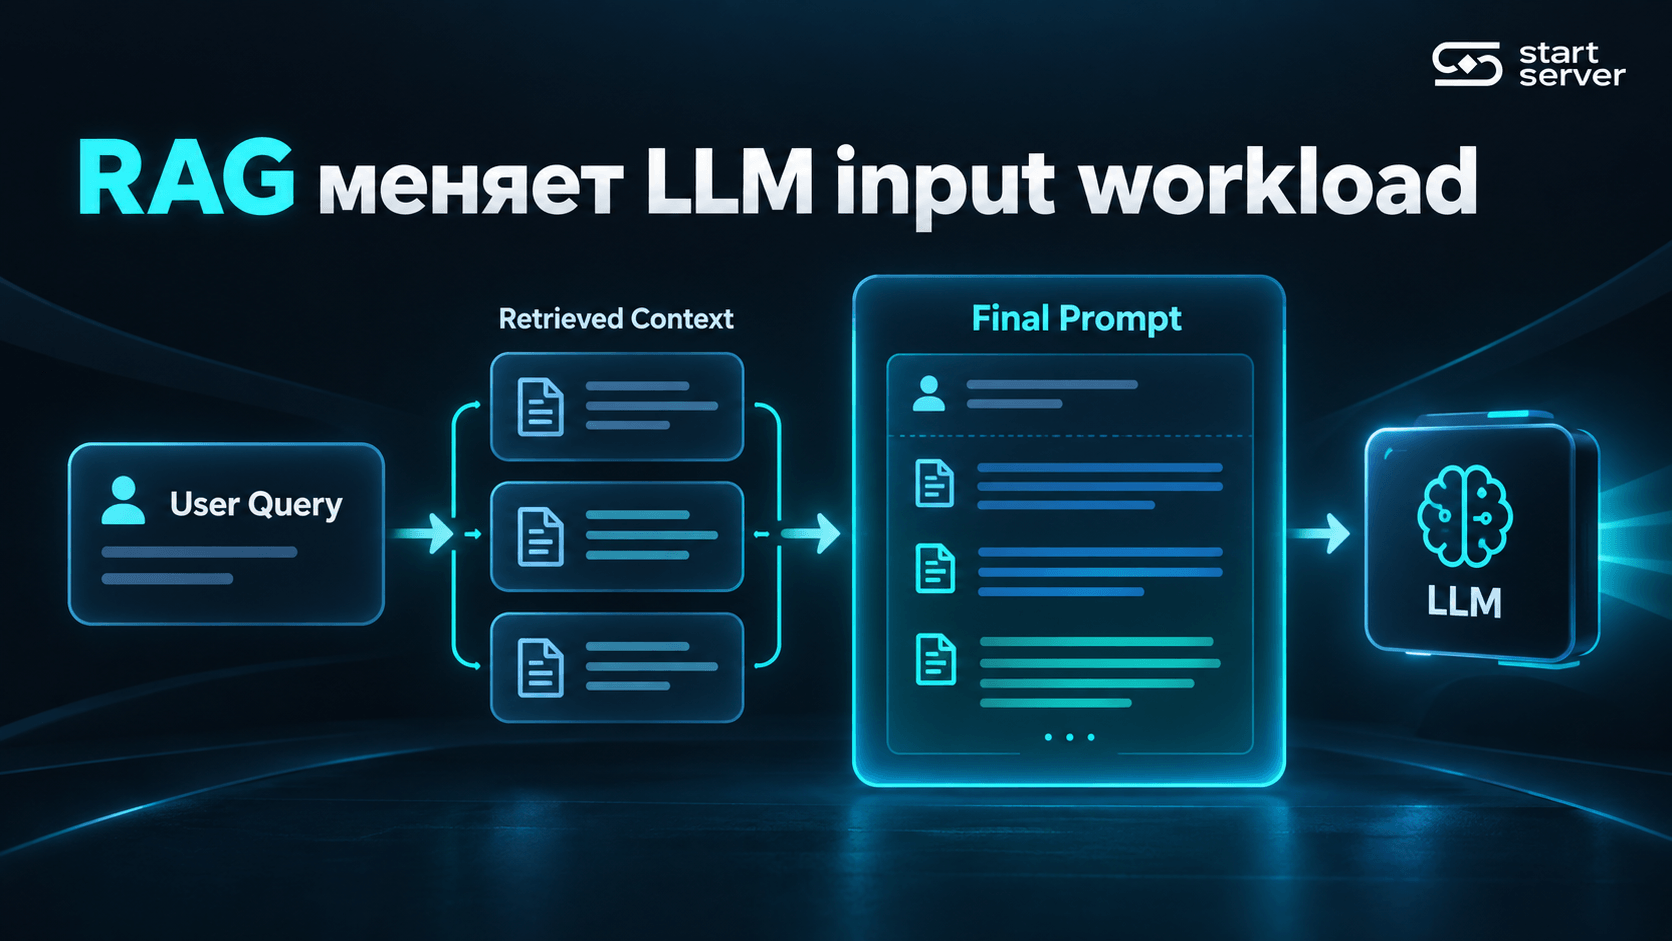
Retrieval добавляет passages к user prompt.
Следовательно:
Retrieval Policy → Final Prompt Tokens → Generation Workload.
Но учитывать нужно именно конечные tokens, а не просто number of chunks.
Пять больших chunks и пять коротких chunks — разные generation inputs.
Поэтому:
Final Prompt Tokens Are the Relevant Generation Input Variable.
Шаг 7. Постройте Component-to-Resource Matrix
Component | CPU | RAM | GPU/VRAM | Storage | Network | Главный driver | Evidence |
|---|---|---|---|---|---|---|---|
Parsing/OCR | docs/pages/s | ||||||
Embedding | chunks/s | ||||||
Vector DB | vectors/QPS | ||||||
Retrieval | QPS/latency | ||||||
Reranking, если есть | candidates/query | ||||||
LLM | context/concurrency | ||||||
API | request rate |
В Evidence:
Requirement;
Calculation;
Vendor Documentation;
Benchmark;
UNKNOWN.
Каждая дорогая строка BOM должна иметь traceability
Вопрос:
Какое requirement оправдывает этот resource?
Например:
Requirement | Resource consequence |
|---|---|
Большая local LLM | GPU/VRAM |
Высокая inference concurrency | GPU capacity / memory |
Large vector corpus | RAM/storage |
Frequent re-index | CPU/GPU + I/O |
Low search latency | RAM / storage performance |
Large rerank candidate set | reranker compute |
Node failure tolerance | replicas / nodes |
Если связь отсутствует:
Expensive Component without Requirement Traceability = Review Required.
Не обязательно удалить.
Сначала обосновать.
Проверяйте traceability в обе стороны
Каждый requirement тоже должен иметь architecture support.
Например:
система должна пережить отказ одного узла.
Но BOM содержит один node.
Тогда:
Requirement without Architecture Support = Specification Gap.
Поэтому audit идёт в обе стороны:
Requirement → Resource
и:
Resource → Requirement.
Шаг 8. Ищите не только UNDER, но и OVER?
Лучше использовать осторожные статусы:
OK — relation подтверждена;
UNDER — requirement не закрыт;
OVER? — resource выше текущего доказанного requirement и требует justification;
UNKNOWN — недостаточно данных.
Почему OVER?, а не жёсткий OVER?
Потому что запас может быть нужен для:
growth;
failover;
будущей модели;
длительного закупочного цикла;
operational headroom.
Gap Register
ID | Requirement | Resource/BOM | Status | Evidence | Next Action |
|---|---|---|---|---|---|
RAG-01 | OK / UNDER / OVER? / UNKNOWN | ||||
RAG-02 |
Это одна из самых полезных таблиц статьи.
Пример UNDER
Requirement:
выдерживать заданный peak request load.
Но нет:
model/concurrency benchmark;
подтверждённой VRAM capacity;
latency measurement.
Статус:
UNDER / UNKNOWN, в зависимости от имеющегося evidence.
Не:
«нужно ещё две GPU»
без измерений.
Пример OVER?
В BOM заложены отдельные GPU для ingestion.
Но ingestion:
выполняется раз в неделю;
имеет большое processing window;
не пересекается с online peak.
Это ещё не доказывает, что GPU лишние.
Но строка заслуживает вопроса:
можно ли использовать shared capacity без нарушения SLO?
Fast LLM Node ≠ Fast RAG System
Можно купить очень производительный inference node.
Но end-to-end latency будет определяться vector layer, если та:
RAM constrained;
storage constrained;
перегружена writes;
плохо индексирована.
И наоборот:
огромная RAM vector DB не ускорит generation, если bottleneck находится в LLM decode.
Поэтому:
каждый bottleneck нужно связывать со своим stage.
Шаг 9. Проверьте consolidation
Одна из архитектур:
Vector DB + Embedding + Reranker + LLM на одном сервере.
Это может сократить:
число nodes;
стоимость;
operational complexity.
Но добавить:
resource contention;
failure-domain coupling;
latency interference;
VRAM competition.
Поэтому:
Fewer Servers ≠ Automatically Better RAG Architecture.
И отдельный server на каждый component тоже не автоматически лучше
Обратная крайность может дать:
низкую utilization;
лишнюю стоимость;
лишние network hops;
сложность поддержки.
Решение зависит от:
temporal overlap workloads;
isolation requirement;
SLO;
fault domains.
Shared GPU требует mixed-load validation
Если одна GPU обслуживает:
embeddings;
reranker;
LLM,
нужно проверить именно совместную нагрузку.
Отдельные benchmarks каждого component не доказывают отсутствие interference.
Поэтому:
Shared GPU Requires Mixed-Load Validation.
Шаг 10. Availability requirement задайте до replica count
Не начинайте с:
replication factor = 3.
Сначала спросите:
какой failure должен переживаться;
какой downtime допустим;
нужен ли automatic failover;
какие components stateful;
какой planning scope.
После этого появляются:
replicas;
node count;
network;
storage overhead.
Replication меняет не только storage
На примере current Qdrant replicas:
увеличивают aggregate stored data;
могут обслуживать reads;
требуют replication writes;
влияют на availability topology.
Поэтому replica count — одновременно:
capacity decision
availability decision
performance trade-off.
Шаг 11. Storage проверяйте по capacity и performance отдельно
Первый вопрос:
сколько данных нужно хранить?
Второй:
как storage участвует в live query path?
При disk-backed/cold structures latency может зависеть от disk reads и page-cache behaviour.
Current Qdrant memory tiers прямо разделяют pre-warmed cached и on-demand cold memory-mapped data.
Поэтому:
Enough TB ≠ Enough Storage Performance.
Шаг 12. Не смешивайте vendor-specific mechanics и universal requirements
Например, Qdrant:
HNSW structures;
segments;
memory tiers;
optimizer behaviour
— свойства конкретного product/version.
В generic RAG specification лучше писать:
vector store должен выдерживать target read/write workload.
А Qdrant details использовать только если выбран именно Qdrant.
Формула:
Vendor-Specific Sizing Formula ≠ Universal RAG Sizing Formula.
Шаг 13. Разложите end-to-end latency
Пользователь не видит отдельно:
vector QPS;
reranker pairs/s;
LLM tokens/s.
Он видит полный request:
Query → Retrieval → Optional Rerank → Prompt → LLM → Response.
Поэтому:
LLM Throughput ≠ RAG End-to-End Performance.
E2E Latency Card
Stage | Target / Measurement |
|---|---|
Query preprocessing | |
Query embedding | |
Retrieval | |
Reranking, если есть | |
Prompt assembly | |
LLM prefill | |
Generation | |
Total E2E |
Эта таблица позволяет увидеть, какой component действительно определяет SLO.
Шаг 14. Разделите quality gates
«Quality» в RAG — не одна metric.
Retrieval quality
Например:
recall;
ranking metric;
task-specific retrieval success.
Answer quality
Качество финального ответа системы.
Operational quality
При необходимости:
freshness;
completeness;
coverage.
Поэтому уменьшение vector precision или candidate count нужно оценивать сначала на retrieval quality, а затем при необходимости на end-to-end RAG evaluation.
Меньше ресурсов ≠ лучше architecture
Можно снизить:
retrieval candidate count;
vector precision;
reranker size;
context;
LLM size.
Это может ускорить pipeline.
Но если падает required quality:
optimization не прошла acceptance.
Поэтому:
Lower Resource Usage ≠ Better Architecture if Quality Falls Below Requirement.
RAG Specification Review Pack
A. Requirement Card
Поле | Значение |
|---|---|
Use case | |
Corpus | |
Growth | |
Update pattern | |
Active users | |
Request rate | |
Peak concurrency | |
Latency SLO | |
Availability | |
Planning horizon |
B. Corpus & Index Card
Поле | Значение |
|---|---|
Vector DB/version | |
Chunking | |
Points/vectors | |
Embedding model | |
Dimensions | |
Original datatype | |
Quantization | |
Index | |
Payload | |
Replication | |
Memory tiers |
C. Online Query Card
Поле | Значение |
|---|---|
Query embedding | |
Retrieval candidates | |
Reranker, if any | |
Rerank candidates | |
Final passages | |
Final prompt tokens | |
LLM | |
Output | |
Peak concurrency | |
SLO |
D. Component Resource Matrix
CPU + RAM + GPU/VRAM + storage + network + evidence.
E. Gap Register
OK / UNDER / OVER? / UNKNOWN.
F. Validation Plan
Что можно рассчитать, а что нужно измерить.
Что отправлять в Validation Plan
Не все параметры стоит пытаться доказать spreadsheet'ом.
Полезно измерить:
Проверка | Что подтверждает |
|---|---|
Embedding throughput | ingestion window |
Vector search latency | retrieval SLO |
Mixed ingest + search | contention |
Reranker throughput | candidate capacity |
LLM workload | latency/concurrency |
RAG E2E | полный SLO |
Retrieval evaluation | quality |
Failure test | availability assumption |
Не заменяйте RAG test набором component benchmarks
Можно получить прекрасные показатели:
embeddings/s;
vector QPS;
reranking throughput;
LLM tokens/s.
Но full pipeline может не выполнить SLO из-за:
chaining latency;
contention;
queueing;
data movement.
Поэтому final validation желательно выполнять на:
Representative Corpus + Representative Queries + Fixed Pipeline + Target Load.
RAG Specification Decision Tree
Use case определён?
Нет
→ hardware sizing преждевременный.
Да ↓
Corpus / growth / update pattern определены?
Нет
→ vector/ingestion requirement UNKNOWN.
Да ↓
Chunking / vector count оценены?
Нет
→ vector capacity UNKNOWN.
Да ↓
Vector datatype / index / replication определены?
Нет
→ RAM/storage model неполна.
Да ↓
Actual retrieval architecture определена?
Нет
→ online pipeline неполна.
Да ↓
Reranker используется?
Да
→ определить candidate workload.
Нет
→ не добавлять fictitious reranker resource.
↓
LLM / actual context / business concurrency определены?
Нет
→ inference requirement UNKNOWN.
Да ↓
Availability/growth заданы?
Нет
→ node count/headroom неполны.
Да ↓
Каждый expensive component связан с requirement?
Нет
→ OVER? / UNKNOWN.
Да ↓
Каждый requirement поддержан architecture/resource?
Нет
→ UNDER.
Да ↓
Каждый material UNKNOWN имеет calculation/benchmark action?
Нет
→ specification не готова.
Да ↓
Переход к конкретным server SKU.
Что нельзя придумывать
До появления реального case study нельзя писать:
«Заказчик хотел восемь GPU, а аудит сократил конфигурацию до четырёх».
Нельзя придумывать:
клиента;
corpus;
QPS;
vector count;
LLM;
initial BOM;
rejected options;
savings;
benchmark results.
Текущая статья — methodology.
Не fictional project history.
Когда можно вернуть case-study формат
Заголовок:
«Разбор проекта RAG: какие требования изменили спецификацию сервера»
можно использовать, когда доступны:
разрешённый project brief;
original requirements;
initial BOM;
rejected variants;
calculations;
benchmark evidence;
final BOM;
комментарий архитектора;
разрешение на публикацию.
Тогда структура будет:
Original Requirement
→ Initial Specification
→ Missing Assumptions
→ Rejected Alternatives
→ Measurements / Calculations
→ Revised Architecture
→ Final Specification
→ Verification.
Связь с расчётом количества GPU для LLM
Отдельный GPU-sizing расчёт отвечает на вопрос:
сколько GPU нужно и как разместить модель.
Но сначала в RAG specification нужно определить:
какая generation workload вообще требуется.
Только после этого имеет смысл переходить к детальному GPU topology и model placement.
Связь с расчётом VRAM
Детальный VRAM sizing обычно учитывает:
weights;
KV cache;
context;
concurrency.
Аудит RAG specification должен сначала подготовить корректные inputs для такого расчёта:
exact model;
реальный context envelope;
concurrency;
runtime assumptions.
Связь с диагностикой memory failure
Диагностика memory failure отвечает на вопрос:
почему уже работающий inference получает OOM или другой memory-related failure?
А здесь задача другая:
найти sizing gaps до закупки.
То есть operational troubleshooting и pre-purchase specification review не следует смешивать.
Связь с приёмкой поставленного GPU-сервера
На этапе specification review проверяется:
корректна ли согласованная specification?
После поставки уже проверяется:
соответствует ли ей реально поставленный server?
Связка:
Specification Validation → Delivered-System Acceptance.
Связь с batch-size experiment
RAG specification может определить target:
embedding workload должна обработать corpus в заданное ingestion window.
Но подбор batch size для конкретного pipeline остаётся отдельным controlled experiment.
Не нужно превращать sizing article в batch-tuning guide.
Связь с испытанием отказоустойчивости
Здесь сначала определяется:
какой availability requirement существует?
А controlled failover test уже отдельно проверяет:
fault domains;
redundancy;
routing;
recovery;
surviving capacity.
То есть:
Availability Requirement → Failure Validation.
Что подготовить для аудита RAG specification
Область | Что нужно |
|---|---|
Use case | ожидаемый результат |
Corpus | объём, тип, growth |
Updates | frequency / ingestion window |
Chunking | strategy |
Embeddings | model/dimensions/datatype |
Vector DB | product/version/config |
Retrieval | candidates/filters |
Reranking | model/candidates, если есть |
LLM | model/revision |
Context | typical + required maximum |
Load | request rate/concurrency |
SLO | latency/availability |
Current BOM | CPU/RAM/GPU/storage/network |
После этого можно обсуждать hardware как следствие требований.
CTA: Разобрать требования вашего RAG проекта.
Главное
Проверка RAG specification начинается не с вопроса:
«Какую GPU купить?»
Сначала нужно определить actual pipeline.
Retrieve-and-rerank — хороший пример того, почему это важно: Sentence Transformers описывает CrossEncoder как более дорогую per-pair модель, которую часто используют для reranking ограниченного top-k candidate set, но этот pattern не является обязательным для каждого RAG.
Vector layer имеет совершенно другой resource model.
Current Qdrant считает aggregate original-vector storage через число points, replication factor, dimensions и original datatype; datatype original vectors при этом отделён от quantization, а quantization создаёт additional compressed representation.
Размещение этих structures тоже нельзя описывать простой формулой «всё в RAM»: current Qdrant v1.19+ различает pinned, cached и cold, причём cached pages могут быть evicted OS, а pinned поддерживается не всеми data structures.
Generation layer снова требует другого языка.
Current vLLM определяет max_model_len как configured prompt+output context, а max_num_seqs — как scheduler/runner limit на число sequences в iteration, а не как число пользователей или прямой business concurrency metric.
Поэтому правильная последовательность:
Business Requirement
→ Actual Pipeline
→ Corpus / Growth / Ingestion
→ Chunking / Vector Count
→ Original Datatype / Index / Optional Quantization
→ Memory / Storage Placement
→ Retrieval / Optional Reranking
→ Final Prompt Distribution
→ LLM Workload / Runtime Validation
→ Availability / Growth
→ CPU + RAM + GPU + Storage + Network
→ Requirement-to-BOM Traceability
→ OK / UNDER / OVER? / UNKNOWN
→ Representative Validation
→ Final Hardware Specification.
Ключевые правила:
LLM Size ≠ Full RAG Server Requirement.
Ingestion Throughput ≠ Query Throughput.
Document Count ≠ Vector Count.
Chunking Strategy Is a Capacity Variable.
Raw Vector Size ≠ Vector Database RAM Requirement.
Original Vector Datatype ≠ Quantization Method.
Quantized Copy ≠ Replacement of Original Vectors by Definition.
Vector Database Capacity ≠ RAM Only.
Cached Data ≠ Guaranteed Permanent RAM Residency.
Search-Only Sizing ≠ Mixed Ingest/Search Sizing.
RAG ≠ Mandatory Retrieve-and-Rerank Architecture.
Retrieval Top-K ≠ Final Prompt Size.
Registered Users ≠ Concurrent Inference Requests.
Supported Context ≠ Configured Context ≠ Typical Request Context.
Model Maximum Context ≠ Required Production Context.
Concurrent Requests ≠ max_num_seqs Automatically.
max_num_seqs ≠ Entire Service Concurrency by Definition.
Fewer Servers ≠ Automatically Better RAG Architecture.
Fast LLM Node ≠ Fast RAG System.
Enough TB ≠ Enough Storage Performance.
LLM Throughput ≠ RAG End-to-End Performance.
Lower Resource Usage ≠ Better Architecture if Quality Falls Below Requirement.
Expensive Component without Requirement Traceability = Review Required.
Requirement without Architecture Support = Specification Gap.
Главный вывод:
Хорошая RAG specification — это не максимально мощный hardware. Это traceable architecture, где каждый значимый CPU, RAM, GPU, storage и network resource связан с измеримым requirement, implementation-specific assumptions привязаны к версии software, а каждый UNKNOWN превращён в calculation или benchmark task до закупки.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


