Общий GPU-сервер для университета нельзя корректно рассчитать только по количеству студентов, исследователей или лабораторий.
Десять пользователей могут запускать короткие эксперименты по одной GPU на несколько минут. Другая группа из тех же десяти человек — многосуточные расчёты сразу на четырёх ускорителях. Количество пользователей одинаковое, а требования к инфраструктуре совершенно разные.
Поэтому расчёт общего GPU-ресурса лучше строить так:
Главный вопрос не:
Сколько пользователей выдержит GPU-сервер?
А:
Какие задания будут поступать, сколько ресурсов им требуется одновременно, как долго они выполняются и сколько могут ждать своей очереди?
Почему количество пользователей не определяет размер сервера
Для общей вычислительной инфраструктуры основным объектом является задание, а не пользователь.
Один исследователь может запустить несколько десятков небольших экспериментов. Другой — одно обучение, которому нужны четыре GPU на сутки.
Например:
Класс нагрузки | Характер задания |
Учебная работа | короткий запуск, небольшой ресурс |
Интерактивный эксперимент | небольшой job с требованием быстрого старта |
Обучение модели | одна или несколько GPU на несколько часов |
Научный расчёт | длительное пакетное задание |
Крупное обучение | несколько GPU одновременно |
Slurm также распределяет ресурсы между заданиями: каждое из них запрашивает определённые CPU, память, GPU и другие ресурсы, после чего планировщик определяет возможность и время запуска. GPU могут учитываться как отдельные GRES/TRES, в том числе по типам.
Поэтому перед выбором сервера нужно составить профиль типовых заданий.
Какие данные собрать по каждому классу задач
Практический профиль может выглядеть так:
Параметр | Значение |
Класс задачи | |
Исследовательская группа / проект | |
Запусков за период | |
GPU на одно задание | |
Требуемый тип GPU | |
Минимальная VRAM | |
CPU | |
RAM | |
Длительность p50 | |
Длительность p95 | |
Требуется несколько GPU | да / нет |
Интерактивная задача | да / нет |
Можно безопасно прервать | да / нет |
Вместо:
у нас 40 пользователей,
получается значительно более полезное описание:
в обычный день запускаются 20 коротких одногпу-заданий, пять длинных и два задания, которым одновременно нужны четыре GPU.
Такой профиль уже можно использовать для расчёта общей инфраструктуры.
Что такое GPU-hours
Для оценки объёма выделенного GPU-ресурса удобно использовать GPU-hours.
Для уже завершённого задания:
Например:
4 GPU × 6 часов = 24 GPU-hours.
Для планирования будущей нагрузки фактического времени ещё нет, поэтому используют измеренную или обоснованно ожидаемую длительность: например, исторические p50/p95 по аналогичному классу задач.
Для группы однотипных заданий предварительный расчёт выглядит так:
GPU-hours за период = число заданий × GPU на задание × ожидаемая длительность
GPU-hours намного полезнее количества пользователей, но и этого показателя недостаточно для выбора сервера.
Почему одинаковые GPU-hours могут требовать разного оборудования
Сравним два сценария.
24 задания × 1 GPU × 1 час = 24 GPU-hours
и:
1 задание × 4 GPU × 6 часов = 24 GPU-hours
Объём выделенного GPU-времени одинаков.
Но второму заданию необходимо получить четыре GPU одновременно.
Если в системе регулярно освобождается только одна-две карты, небольшие задания будут запускаться, а крупная работа может долго оставаться в очереди.
Поэтому для sizing нужно сохранять одновременно:
GPU-hours + GPU/job + длительность + профиль поступления заданий.
Сводить всю нагрузку к одной цифре «GPU-hours в месяц» нельзя.
Выделенное GPU-время и загрузка GPU — разные показатели
Предположим, заданию выделена одна GPU на десять часов.
Это означает:
10 allocated GPU-hours.
Но из этого не следует, что вычислительные блоки GPU были загружены на 100% все десять часов.
Приложение могло часть времени:
ждать CPU;
загружать данные;
выполнять подготовку;
синхронизироваться;
ожидать storage или сеть.
Поэтому необходимо разделять:
занятость выделенного ресурса — сколько времени GPU была закреплена за заданиями;
фактическую utilisation — насколько интенсивно устройство действительно использовалось.
Slurm может отдельно учитывать выделенные GPU как TRES и при соответствующей конфигурации собирать для обычных NVIDIA GPU показатели использования памяти и GPU.
Как оценить доступный объём GPU-времени
Для однородного пула полноразмерных GPU теоретическую ёмкость можно оценить:
Available GPU-hours = число GPU × время, когда они доступны для планирования
Например:
8 GPU × 24 часа = 192 GPU-hours в сутки.
Если задания получили за это время 144 GPU-hours:
144 / 192 = 75% занятости выделяемого ресурса.
Но 192 GPU-hours — именно теоретическая ёмкость при полной доступности всех восьми ускорителей. Обслуживание, недоступность узлов и другие эксплуатационные ограничения уменьшают фактическое окно.
Кроме того, даже 75% занятости не говорят, хорошо ли работает инфраструктура.
Оставшиеся ресурсы могли простаивать потому, что системе требовалось собрать четыре свободные GPU одновременно для крупного задания.
Разные типы GPU лучше учитывать отдельно
Если инфраструктура содержит разные ускорители, не стоит автоматически складывать их в одну универсальную величину.
Например:
50 H100-hours + 50 A100-hours = 100 одинаковых GPU-hours.
Арифметически это сумма, но для capacity planning она скрывает различие ресурсов.
Практичнее учитывать потребление по типам GPU отдельно либо использовать внутренние billing weights.
Slurm позволяет учитывать разные TRES и задавать им собственные веса при расчёте billable usage. Эти веса затем могут влиять на fair-share.
При этом billing weight — это правило внутреннего учёта, а не физический коэффициент производительности.
Час H100 нельзя автоматически переводить в часы другой GPU одной универсальной формулой.
Зачем общему GPU-серверу очередь
Когда несколько групп одновременно запрашивают ограниченный ресурс, планировщик должен определить, какое задание может стартовать сейчас, а какое будет ждать.
На решение влияет не только наличие свободной GPU.
Имеют значение:
требуемое число GPU;
тип GPU;
CPU и RAM;
приоритет;
лимиты;
резервирование;
другие условия запуска.
Поэтому ситуация:
в очереди 30 pending jobs
сама по себе не означает:
необходимо докупить GPU.
Fair-share, лимиты и reservation — разные механизмы
Для общего GPU-сервера особенно важно не смешивать три понятия.
Fair-share
Fair-share отвечает прежде всего на вопрос:
кому дать более высокий относительный приоритет, когда несколько групп конкурируют за ресурс?
Slurm учитывает выделенную пользователю или account долю вычислительных ресурсов и их предыдущее потребление. При этом официальная документация отдельно подчёркивает: fair-share не является фиксированным allotment, после достижения которого доступ к системе прекращается.
Поэтому fair-share нельзя определять как:
лаборатории положено ровно 100 GPU-hours в месяц.
Жёсткие лимиты
Лимиты отвечают на другой вопрос:
сколько ресурса пользователь, проект или отдельное задание вообще может занять?
Slurm позволяет задавать ограничения на уровне QOS и associations. В частности, можно ограничивать число одновременно работающих и отправленных заданий, объём TRES и максимальное время работы.
Reservation
Reservation нужен, когда ресурс должен быть доступен определённой группе в определённое время.
Например:
для лабораторного занятия;
заранее запланированного эксперимента;
демонстрации;
работы, привязанной к внешнему оборудованию.
Slurm позволяет резервировать ресурсы на заданный период и ограничивать доступ к reservation определёнными пользователями или accounts.
Практическая схема:
Fair-share → кто получает более высокий относительный приоритет
Limit → сколько максимум можно занять
Почему fair-share не является автоматической GPU-квотой
Само включение fair-share ещё не означает, что дорогие GPU автоматически будут правильно учитываться относительно CPU и других ресурсов.
В Slurm по умолчанию вычислительное потребление fair-share связано с CPU-time. Другие ресурсы можно включать через TRES billing policy — например, назначить отдельные веса CPU, памяти и GPU.
Поэтому университету нужно отдельно определить:
что именно считается потреблением общего ресурса?
Если разные GPU имеют разную внутреннюю ценность, это тоже должно быть частью policy.
Но такие коэффициенты нельзя выдавать за реальные отношения производительности ускорителей.
Зачем нужны жёсткие лимиты
Fair-share регулирует относительное положение заданий в очереди, но не заменяет ограничения.
Общему серверу обычно приходится отвечать на вопросы:
Может ли один пользователь занять все GPU?
Сколько заданий он может запустить одновременно?
Сколько GPU разрешено одной задаче?
Как долго может работать одна job?
Сколько заданий пользователь может накопить в очереди?
Slurm позволяет применять подобные resource limits через associations и QOS.
Конкретные значения должны определяться по профилю задач организации.
Универсальное правило вроде:
каждому студенту одна GPU максимум на два часа
нельзя переносить между университетами без измерений.
Когда нужен reservation
Reservation полезен, когда простого высокого приоритета недостаточно и требуется заранее обеспечить вычислительное окно.
Например, в пятницу с 14:00 до 16:00 на сервере должна пройти практическая работа с группой студентов.
Или конкретному проекту нужны несколько ускорителей во время запланированного эксперимента.
Priority и reservation — разные механизмы.
Priority влияет на относительный порядок конкурирующих jobs.
Reservation заранее выделяет определённый ресурс и временной интервал для заданной группы.
Полная GPU или разделённый ресурс
После описания классов заданий появляется следующий вопрос:
нужно ли выдавать задаче целую GPU или ускоритель можно разделить?
Единого ответа нет.
Для больших заданий естественным вариантом может быть целая GPU.
Для небольших workload можно рассматривать аппаратное или программное совместное использование.
Но правильная последовательность такая:
а не:
сначала выбрали MIG → затем ищем задачи для него.
Когда нужна полная GPU
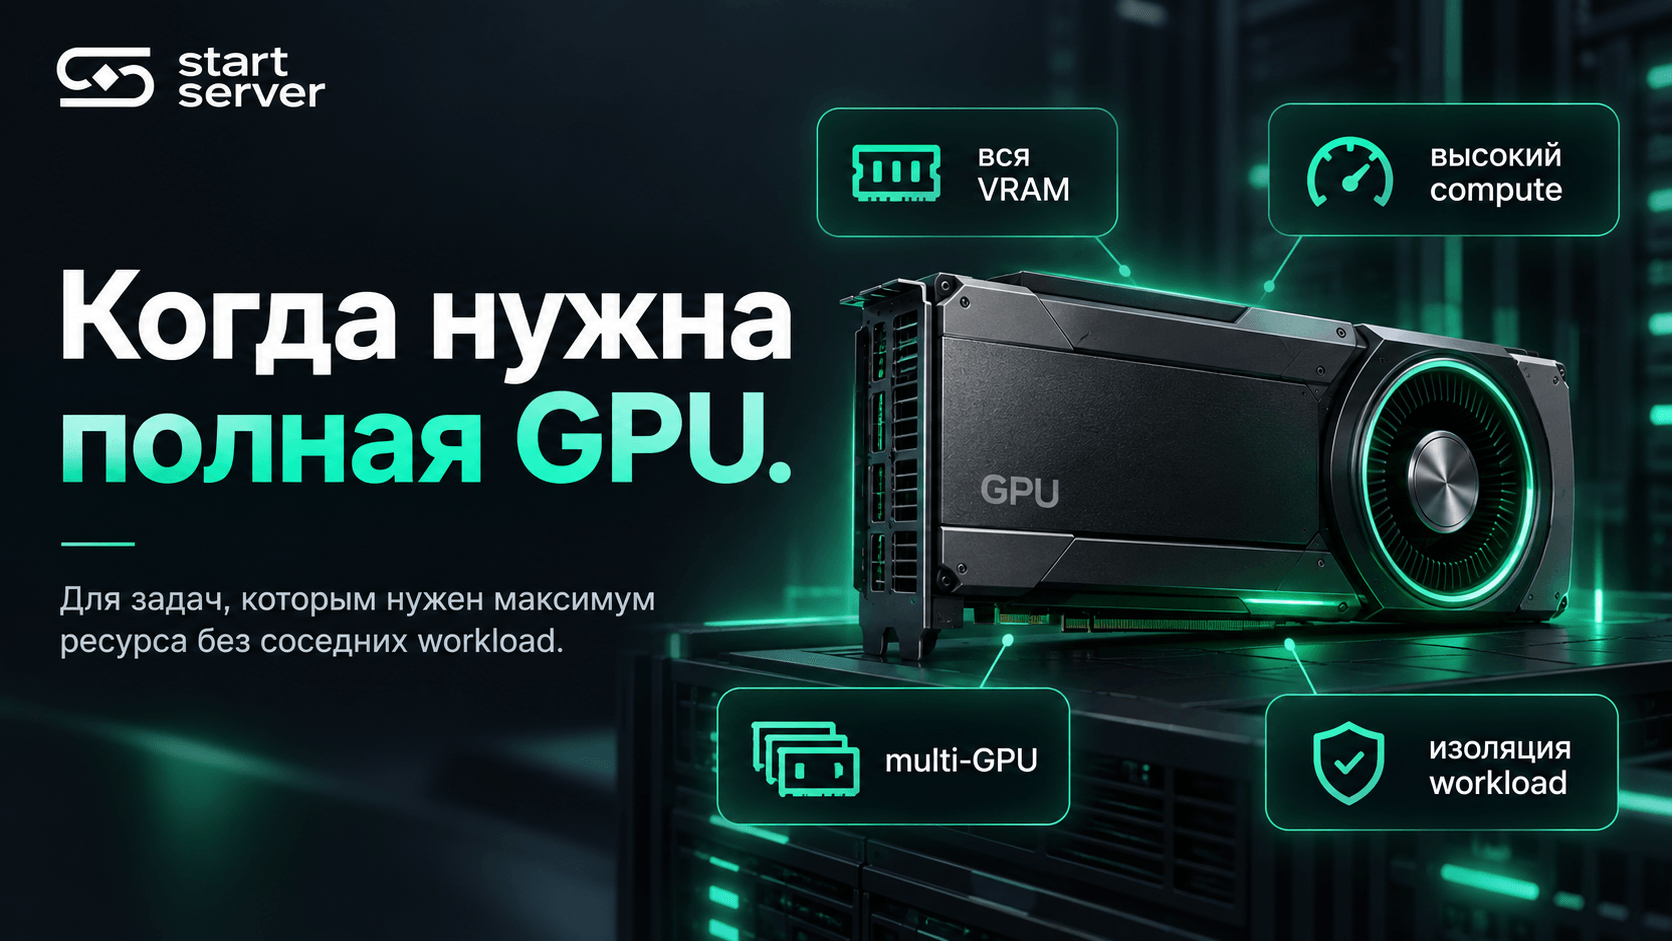
Полная GPU естественна для задач, которым требуется:
большая часть или вся VRAM;
значительная часть вычислительного ресурса;
несколько GPU одновременно;
отсутствие соседних workload на том же ускорителе.
Такой режим также проще интерпретировать с точки зрения accounting.
Но он может расходовать ресурс неэффективно, если небольшое приложение занимает целую GPU, фактически используя лишь небольшую её часть.
Что такое MIG
На поддерживаемых NVIDIA GPU технология Multi-Instance GPU аппаратно разделяет ускоритель на несколько изолированных instances с выделенными вычислительными и memory resources.
Это позволяет небольшому workload получить часть GPU вместо всего устройства.
Но есть важные ограничения.
MIG доступен только на поддерживаемых моделях NVIDIA GPU. А размер instance выбирается не произвольно: драйвер предоставляет определённый набор GPU Instance Profiles.
Поэтому нельзя рассуждать так:
задаче нужно примерно 17% GPU — создадим раздел ровно на 17%.
Нужно сопоставить требования workload с реально поддерживаемыми MIG-профилями и проверить производительность.
Как Slurm работает с MIG
Slurm умеет рассматривать созданные MIG instances как отдельные GPU-ресурсы и различать MIG разных размеров по типам GRES.
Но есть важное ограничение:
Slurm ожидает, что MIG devices уже сконфигурированы, и сам не выполняет динамическое изменение MIG-разметки под каждый новый job.
Поэтому набор MIG-профилей является частью архитектуры общего GPU-пула.
Scheduler не стоит воспринимать как систему, которая произвольно отрежет каждому новому заданию ровно столько GPU, сколько оно запросило.
MIG и time-slicing — не одно и то же
Кроме аппаратного разделения существуют механизмы совместного доступа к одной GPU во времени.
Например, NVIDIA GPU Operator поддерживает time-slicing для Kubernetes: несколько workload чередуют выполнение на одной физической GPU.
Это отличается от MIG.
Для time-slicing NVIDIA прямо указывает:
между replicas нет такой изоляции памяти, как у MIG;
нет fault isolation между этими replicas;
запрос нескольких time-sliced ресурсов не гарантирует пропорционально большую долю вычислительной мощности.
Поэтому нельзя писать:
восемь shared replicas = каждому гарантированно по 1/8 GPU.
Time-slicing является примером программного совместного доступа. В Slurm существуют собственные механизмы совместного использования GPU, поэтому конкретный вариант зависит от выбранного scheduler и runtime.
Почему маленькую задачу не всегда стоит запускать на целой GPU
Представим учебное приложение, которое использует небольшую часть памяти и вычислительных ресурсов.
Если каждое такое задание получает целую GPU, занятость устройств заданиями может быть высокой, а реальная utilisation — низкой.
Но простой запуск нескольких процессов на одном ускорителе тоже не гарантирует хорошего результата.
Они могут конкурировать за:
VRAM;
memory bandwidth;
вычислительные блоки;
cache;
другие ресурсы устройства.
Поэтому число jobs, которые целесообразно размещать на одной GPU, должно подтверждаться benchmark.
Универсальной формулы:
четыре небольших приложения = четыре пользователя на одну GPU
не существует.
Почему крупное задание может ждать при свободных GPU
Представим пул из восьми GPU.
На разных узлах или в разные моменты остаются отдельные свободные карты, но заданию нужны четыре GPU одновременно в подходящей конфигурации.
Суммарный свободный GPU-time есть, а запустить конкретное задание нельзя.
Поэтому общая сумма GPU-hours плохо отражает такую ситуацию.
Для capacity planning обязательно нужно сохранять:
Почему pending jobs не всегда означают нехватку оборудования
GPU могут быть свободны, а задание всё равно остаётся в очереди.
Возможные направления проверки:
Ситуация | Что проверить |
GPU заняты, очередь устойчиво растёт | фактический дефицит capacity |
GPU свободны, job не запускается | лимиты, priority, reservation |
Свободны отдельные GPU, крупная job ждёт | требуемое число одновременных GPU |
Свободна GPU другого типа | требования задания к типу ресурса |
Доступен MIG instance, требуется full GPU | соответствие формы ресурса |
GPU свободна, но нет CPU/RAM | другие требования job |
Slurm показывает reason для pending job через squeue, но этот показатель лучше использовать как отправную точку диагностики: у задания могут одновременно существовать несколько ограничивающих условий.
Поэтому pending reason нужно сопоставлять с запросами job, лимитами и состоянием пула.
Как измерять время ожидания
Для каждой категории заданий полезно отслеживать:
p50 queue wait
и:
p95 queue wait.
Одного среднего недостаточно.
Например, большинство небольших заданий может стартовать быстро, а крупные multi-GPU jobs — ждать несколько суток. Среднее значение частично скроет проблему.
Кроме того, желательно отделять обычное ожидание ресурса от времени, когда задание вообще ещё не имело права стартовать из-за dependency или hold.
Slurm хранит момент Eligible, когда job становится доступной для запуска, поэтому для scheduler wait логично ориентироваться на интервал:
Start − Eligible
для запущенных заданий.
Для руководителя инфраструктуры это можно сформулировать проще:
сколько уже готовое к запуску задание реально ждало вычислительный ресурс.
Почему реалистичная длительность задания помогает очереди
Пользователь часто перестраховывается и указывает максимально допустимый wall time.
Но scheduler использует сведения о длительности при планировании свободных окон.
Если короткое задание гарантированно завершится до момента, когда ресурс потребуется более приоритетной задаче, его можно разместить в этом окне.
Поэтому разумная верхняя оценка времени выполнения помогает планированию лучше, чем привычка всегда запрашивать максимальное разрешённое время.
Это не гарантирует определённый прирост утилизации — эффект зависит от реального состава очереди.
Accounting — обязательная часть общего GPU-сервера
Общую инфраструктуру трудно развивать без систематического учёта.
Нужно понимать:
какая группа получила ресурс;
сколько GPU-времени было выделено;
сколько заданий завершилось;
сколько они ждали;
по каким причинам jobs оставались pending;
как меняется спрос со временем.
Slurm accounting позволяет хранить и анализировать информацию о заданиях и выделенных ресурсах, а fair-share опирается на данные о прошлом потреблении.
Правильный цикл управления выглядит так:
Правила общего сервера не должны оставаться неизменными после первой настройки.
Какие показатели смотреть
Для каждого класса заданий и исследовательской группы полезен набор:
Показатель | Что показывает |
Completed jobs | сколько заданий завершено |
Allocated GPU-hours | сколько GPU-времени выделено |
p50 queue wait | типичное ожидание |
p95 queue wait | задержка тяжёлой части очереди |
Pending reasons | почему jobs не стартуют |
GPU utilisation | фактическую загрузку, где она доступна |
GPU memory use | использование памяти, где доступно |
Reservation use | как используется зарезервированный ресурс |
Для MIG есть важное ограничение: Slurm может учитывать сам факт выделения MIG instance, однако стандартные gpumem и gpuutil metrics через описанный NVML accounting path для MIG недоступны.
Это не означает, что utilisation MIG невозможно измерять вообще. Но путь такой telemetry нужно проектировать отдельно.
Высокая загрузка GPU не является единственным критерием успеха
Интуитивная цель:
держать GPU на 100% постоянно
слишком проста для общей университетской инфраструктуры.
Можно получить очень высокую utilisation и одновременно:
заставить интерактивные задания ждать часами;
систематически задерживать одну исследовательскую группу;
не иметь возможности запустить крупный multi-GPU job;
срывать зарезервированные вычислительные окна.
И наоборот, часть GPU может сознательно оставаться свободной из-за отсутствия спроса или правил reservation.
Поэтому качество работы общего сервера оценивают не одним процентом загрузки, а сочетанием:
использования ресурса + времени ожидания + завершённой работы + выполнения policy.
Калькулятор нагрузки общего GPU-сервера
Для предварительного sizing удобно заполнить четыре блока.
1. Профиль заданий
Параметр | Значение |
Класс задачи | |
Группа / проект | |
Jobs за период | |
GPU/job | |
Тип GPU | |
VRAM | |
CPU | |
RAM | |
Duration p50 | |
Duration p95 | |
Multi-GPU | |
Можно прервать |
2. Объём и пик нагрузки
Параметр | Значение |
GPU-hours за период | |
Peak requested GPU | |
Jobs в пиковом окне | |
Максимальный GPU/job | |
Целевой p50 wait | |
Целевой p95 wait |
Для прогноза:
Это объёмная метрика, а не полный sizing сервера.
3. Политика доступа
Параметр | Значение |
Группа / account | |
Fair-share | |
Максимум GPU/job | |
Максимум GPU/user | |
Максимум running jobs | |
Максимальное время задания | |
Reservation | |
Preemption |
Не все ограничения обязательны.
4. Способ выделения GPU
Параметр | Значение |
Full GPU | |
MIG profile | |
Другой shared mode | |
Требуется изоляция памяти | |
Допустимо совместное выполнение |
5. Результат пилота
Метрика | Значение |
Completed jobs | |
p50 queue wait | |
p95 queue wait | |
Allocated GPU-hours | |
Занятость выделяемого GPU-time | |
GPU utilisation | где доступно |
Jobs blocked by limits | |
Jobs blocked by resources | |
Результат | PASS / FAIL |
Как провести пилот
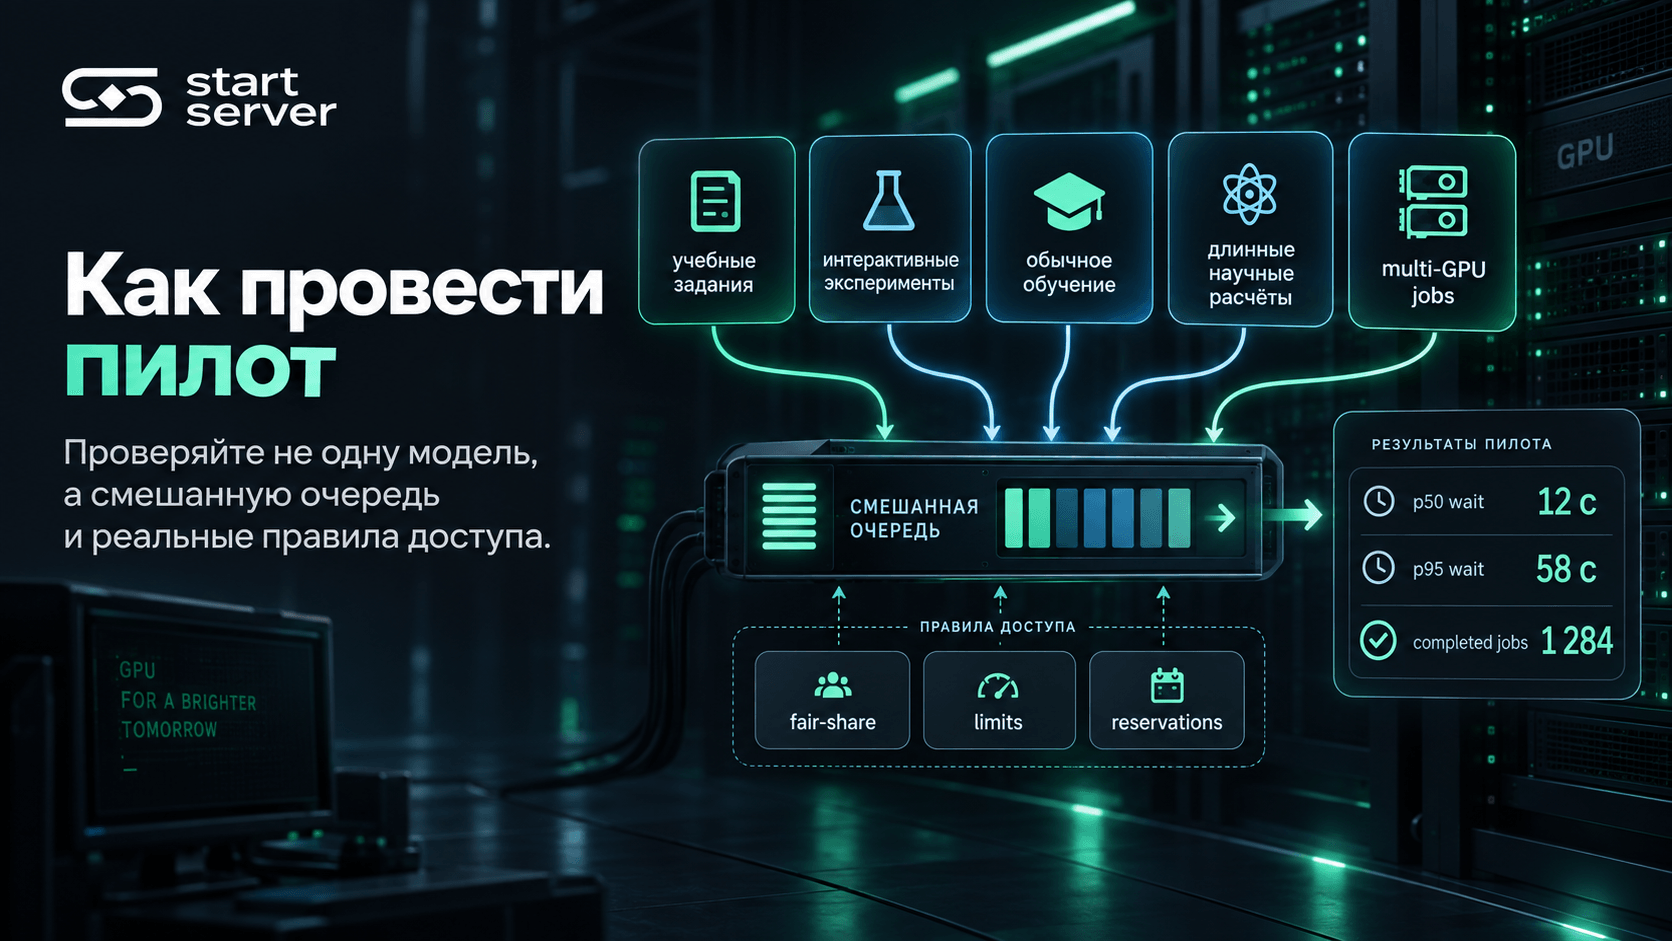
Общий GPU-сервер нельзя проверять одной моделью или одним синтетическим тестом.
Нужна смешанная очередь, похожая на рабочую.
Она может содержать:
короткие учебные задания;
интерактивные эксперименты;
обычное обучение;
длинные научные расчёты;
multi-GPU jobs;
небольшие shared workloads.
Одновременно фиксируются действующие правила:
После этого измеряется не только скорость отдельных приложений, но и поведение общей очереди.
Как отделить нехватку GPU от проблемы policy
Это один из главных результатов пилота.
Возможная нехватка capacity
На неё могут указывать ситуации, когда спрос устойчиво превышает доступный объём GPU-time, а задания регулярно ждут именно отсутствия нужного вычислительного ресурса.
Также физическим ограничением может быть невозможность одновременно выделить столько GPU, сколько требует крупная job.
Возможная проблема policy
Другой сценарий:
GPU простаивают;
задания находятся в pending;
пользователи упираются в лимиты;
reservation удерживает ресурс;
доступная GPU не соответствует требуемому типу;
правила fair-share дают нежелательный результат.
В таком случае покупка дополнительного ускорителя не обязательно устранит проблему.
Поэтому решение о расширении сервера нужно принимать после анализа причин очереди, а не только её длины.
Какие данные нужны для подбора инфраструктуры
Перед переходом к конкретной конфигурации полезно подготовить итоговый профиль:
Данные проекта | Значение |
Исследовательские группы | |
Классы заданий | |
Jobs за период | |
GPU/job | |
Требуемые GPU types | |
Duration p50/p95 | |
GPU-hours за период | |
Peak requested GPUs | |
Максимальный multi-GPU job | |
Целевой p95 wait | |
Fair-share requirements | |
Жёсткие лимиты | |
Reservations | |
Full GPU / MIG / shared mode | |
Требования к изоляции | |
Accounting requirements |
После этого вопрос:
Сколько GPU нужно 30 исследователям?
можно заменить на измеримое требование:
Необходимо обслуживать такой набор заданий, с таким количеством GPU на job, длительностью и пиковым спросом, сохраняя заданное время ожидания и правила доступа исследовательских групп.
Главное
Общий GPU-сервер для университета рассчитывают не по числу пользователей.
Сначала описывают реальные задания:
сколько GPU они требуют → сколько работают → как часто приходят → сколько могут ждать.
GPU-hours показывают объём выделенного ресурса, но не заменяют размер задания, пиковый спрос и фактическую utilisation.
После этого проектируют правила доступа:
fair-share влияет на относительный приоритет;
жёсткие лимиты ограничивают потребление;
reservation гарантирует ресурс в определённое время;
full GPU, MIG или другой shared mode определяют способ выделения ускорителя.
Финальную инфраструктуру нужно проверить на смешанной очереди и анализировать вместе:
p50/p95 времени ожидания, GPU/job, allocated GPU-hours, utilisation, pending reasons и выполненные задания.
Только такой подход позволяет отличить реальную нехватку оборудования от проблемы scheduler policy.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


