NVIDIA H200 представляет data center GPU архитектуры Hopper с 141 ГБ памяти HBM3e и пропускной способностью 4,8 ТБ/с. Ускоритель выпускается в вариантах H200 SXM и H200 NVL. Оба рассчитаны на обучение, инференс и HPC, но отличаются форм-фактором, мощностью, способом межсоединения и классом серверной платформы.
Главная особенность H200 относительно основной H100 80 GB состоит в более емкой и быстрой памяти. Это помогает размещать крупные LLM, увеличивать batch или KV cache и ускорять memory-bound вычисления. Реальный выигрыш зависит от модели, precision, software stack и bottleneck, поэтому характеристики не заменяют benchmark целевого workload.
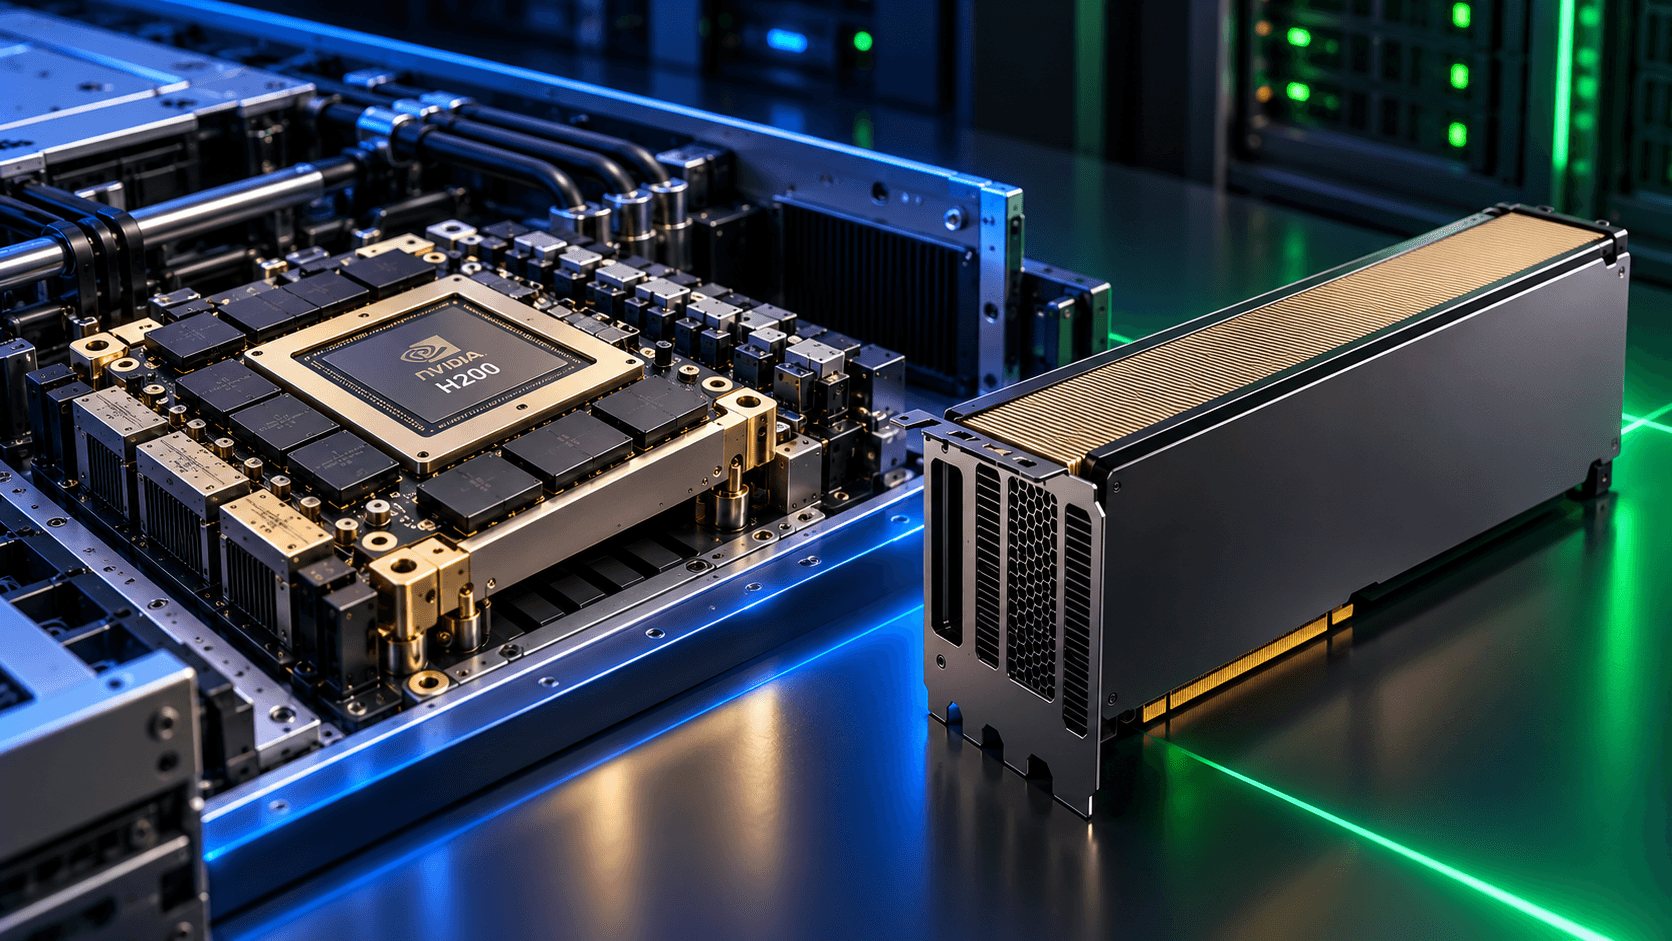
NVIDIA H200: основные характеристики
Характеристика | H200 SXM | H200 NVL |
|---|---|---|
Архитектура | NVIDIA Hopper | NVIDIA Hopper |
GPU memory | 141 ГБ HBM3e | 141 ГБ HBM3e |
Memory bandwidth | 4,8 ТБ/с | 4,8 ТБ/с |
FP8 Tensor Core, с sparsity | 3 958 TFLOPS | 3 341 TFLOPS |
BF16 или FP16 Tensor Core, с sparsity | 1 979 TFLOPS | 1 671 TFLOPS |
TF32 Tensor Core, с sparsity | 989 TFLOPS | 835 TFLOPS |
Max TDP | до 700 Вт, настраивается | до 600 Вт, настраивается |
Form factor | SXM | PCIe, dual-slot, passive |
Межсоединение | NVLink до 900 ГБ/с на GPU | 2-way или 4-way NVLink bridge до 900 ГБ/с на GPU |
PCIe | Gen5 до 128 ГБ/с | Gen5 до 128 ГБ/с |
MIG | до 7 instances | до 7 instances |
Тип систем | HGX H200 на 4 или 8 GPU, DGX H200 | MGX и сертифицированные системы до 8 GPU |
Почему HBM3e важна для LLM и HPC
Для LLM память хранит веса, activations и KV cache. Если модель не помещается на одном GPU, ее приходится квантовать, выгружать часть данных или разделять между устройствами. Каждый вариант меняет скорость и сложность.
Memory bandwidth влияет на операции, ограниченные переносом данных. Autoregressive decode LLM часто ближе к memory-bound режиму, чем крупный training matrix multiplication. В HPC benefit зависит от arithmetic intensity конкретного solver.
141 ГБ не полностью доступны приложению: часть памяти занимает context CUDA, framework, kernels и buffers. При MIG память делится на instances с заданными профилями. Для подбора используют измеренный peak и запас, а не ровно 141 ГБ.
Пошаговый расчет разобран в статье как рассчитать VRAM для LLM.
H200 SXM
SXM является модулем для специализированной GPU baseboard. H200 SXM нельзя установить в обычный PCIe slot. В HGX H200 несколько модулей соединяются NVLink через NVSwitch, что дает предсказуемую all-to-all topology для model parallelism и collective operations.
H200 SXM выбирают, когда нужны:
четыре или восемь тесно связанных GPU;
высокая мощность на accelerator;
NVSwitch fabric внутри узла;
крупное обучение или multi-GPU inference;
единая серверная платформа HGX или DGX.
Недостатки связаны с плотностью и инфраструктурой. Сервер дороже и сложнее, требует совместимой baseboard, мощного питания, рассчитанного охлаждения и сервисной модели всей системы.
H200 NVL и запрос «H200 PCIe»
Официальная PCIe-версия H200 называется H200 NVL. Это пассивно охлаждаемая dual-slot карта с TDP до 600 Вт. Она подключается через PCIe Gen5 и в поддерживаемых системах может использовать 2-way или 4-way NVLink bridge.
H200 NVL дает больше гибкости, чем SXM:
можно строить серверы с разным числом карт;
доступны партнерские MGX и сертифицированные системы;
карту проще обслуживать отдельно;
air-cooled design подходит большему числу стоек, если шасси рассчитано на 600 Вт GPU.
Гибкость не означает совместимость с любым сервером. Нужны физическое место, PCIe Gen5 x16, соответствующий slot spacing, питание, firmware support и достаточный airflow. NVLink bridge также зависит от spacing и квалификации системы.
Товарная карточка NVIDIA H200 NVL 141 ГБ HBM3e показывает конкретный ускоритель.
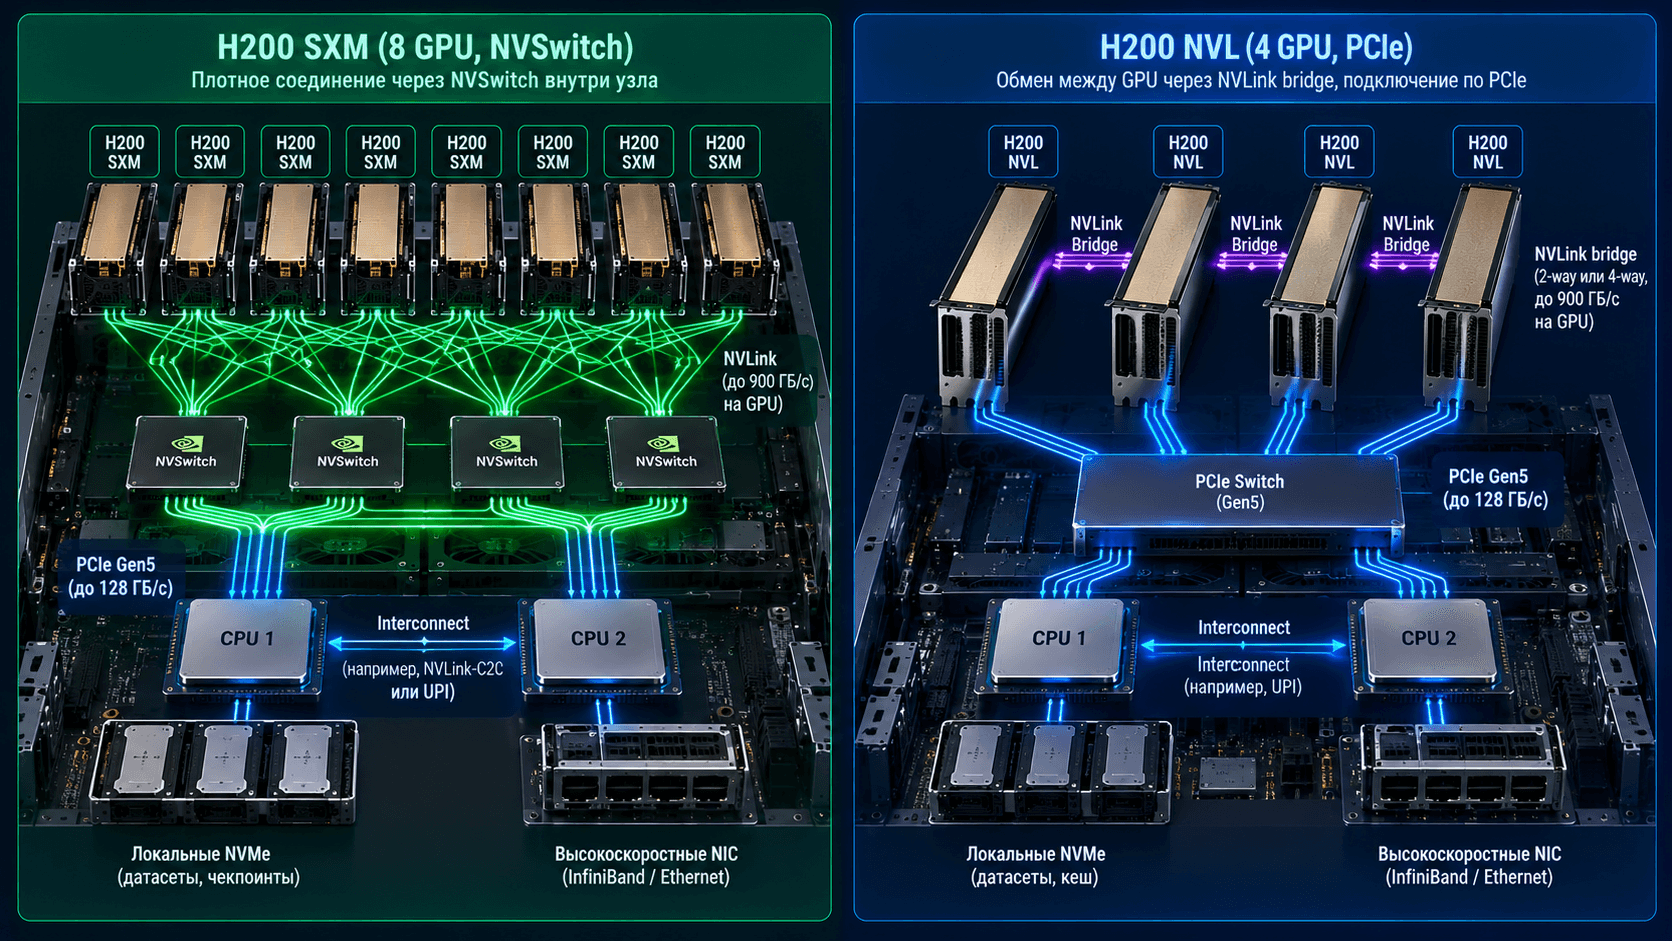
H200 SXM или H200 NVL: что выбрать
Условие | Предпочтительный класс |
|---|---|
8-GPU модельный parallelism с интенсивным обменом | H200 SXM на HGX или DGX |
2 или 4 GPU с более гибкой конфигурацией | H200 NVL при подтвержденной bridge topology |
Независимый inference на каждом GPU | H200 NVL или SXM, сравнить стоимость системы |
Существующая квалифицированная PCIe-платформа | H200 NVL, после проверки power и airflow |
Требуется NVSwitch all-to-all внутри 8-GPU узла | H200 SXM |
Ограничение по мощности и air-cooled rack | H200 NVL может быть удобнее, но площадку все равно рассчитывают |
NVIDIA HGX H200
HGX H200 представляет 4-GPU или 8-GPU compute platform для серверов партнеров. В 8-GPU варианте суммарная память составляет 1 128 ГБ HBM3e. Производитель сервера добавляет CPU, RAM, storage, NIC, BMC, power и cooling.
При сравнении HGX H200 предложений нужно фиксировать:
Точную baseboard и topology.
CPU и распределение system memory.
Число и скорость cluster NIC.
Локальные NVMe и boot mirror.
Air или liquid cooling.
Максимальную и рабочую power envelope.
Firmware, driver и support matrix.
Rails, cables, optics и пусконаладку.
NVIDIA DGX H200
DGX H200 является готовой системой NVIDIA на восьми H200. Официальная конфигурация включает 1 128 ГБ GPU memory, четыре NVSwitch, два Intel Xeon Platinum 8480C, 2 ТБ RAM, восемь U.2 NVMe для data cache и ConnectX-7 network.
DGX подходит организациям, которым нужен согласованный hardware и software stack NVIDIA. Партнерский HGX может дать иной выбор CPU, storage, network или сервиса. Сравнивать следует полный BOM, поддержку и workload benchmark.
Карточка NVIDIA DGX H200 показывает состав системы, а обзор линейки NVIDIA DGX помогает сопоставить H200 с B200, B300, Spark и Station.
Серверы NVIDIA H200 NVL
H200 NVL применяется в системах до восьми PCIe GPU. Варианты на 2 или 4 карты подходят для LLM inference, fine-tuning и HPC, которым не нужен 8-way NVSwitch. Восьмикарточная PCIe-платформа требует особенно внимательной проверки PCIe topology и airflow.
Пример 4-GPU класса: Supermicro SYS-212GB-FNR с четырьмя H200 NVL. Пример 8-GPU класса: Gigabyte G494-ZB1-AAP2 с восемью H200 NVL.
Это примеры классов, а не взаимозаменяемые конфигурации. Нужно сравнить CPU, RAM, topology, storage, NIC, power и qualification.
H100 или H200
H100 и H200 основаны на Hopper. H200 главным образом увеличивает memory capacity и bandwidth. Это особенно полезно, когда H100 80 GB не помещает модель, ограничивает KV cache или упирается в memory bandwidth.
H100 может быть рациональнее, если:
модель помещается с нужным batch;
workload ограничен compute, а не памятью;
H100 доступен быстрее или дешевле;
используемая сертификация еще не включает H200;
measured cost per result лучше.
H200 или ускоритель другого семейства
AMD Instinct MI300X предлагает другой объем памяти и программную платформу ROCm. Сравнение нельзя свести к HBM или peak FLOPS. Нужно запускать одинаковую модель, precision, framework и SLA. Отдельный материал AMD MI300X или NVIDIA H200 дает процедуру такой проверки.
Blackwell B200 и B300 относятся к следующему поколению NVIDIA и меняют compute, memory и interconnect. H200 сохраняет ценность для стабильного Hopper stack и доступных квалифицированных систем. Решение зависит от срока поставки, software readiness и стоимости результата.
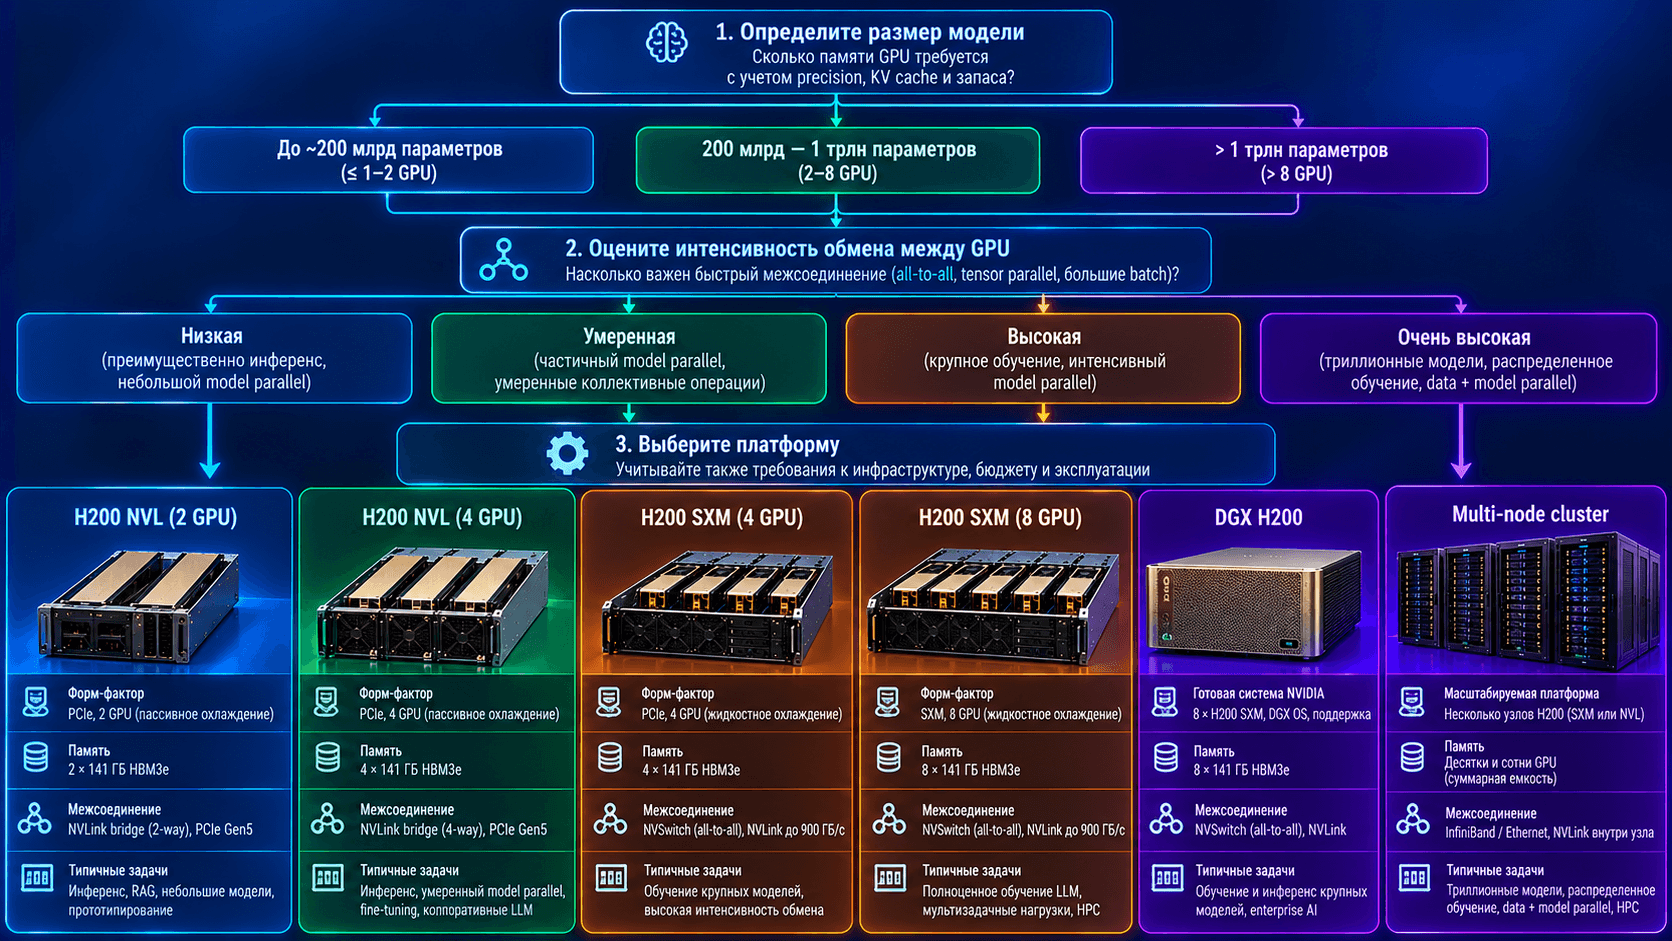
Как выбрать сервер NVIDIA H200
1. Определить точную модель и режим
Зафиксируйте architecture, parameter count, revision, training или inference, precision, context, batch и concurrency.
2. Посчитать память
Измерьте weights, activations, optimizer states, KV cache и buffers. Добавьте запас на fragmentation и рост.
3. Проверить коммуникации
Поймите, как приложение использует tensor, pipeline, data или expert parallelism. Это определит ценность NVLink и NVSwitch.
4. Сравнить SXM и NVL
Сопоставьте topology, GPU count, power, cooling, сервис и стоимость всей системы. Не сравнивайте отдельно цену карты и готового 8-GPU узла.
5. Проверить software stack
Зафиксируйте driver, CUDA, framework, NCCL, inference runtime, container image и custom extensions. Для MIG проверьте profiles и orchestration.
6. Проверить ЦОД
Нужны rack depth, масса, power feeds, PDU, inlet temperature, airflow или liquid loop, network ports и service clearance.
7. Выполнить acceptance benchmark
Измеряйте end-to-end latency, throughput, scaling efficiency, peak memory, power, temperature, storage и network. Сравнение проводят при одинаковом качестве результата.
От чего зависит цена NVIDIA H200
Цена H200 определяется не только ускорителем. В предложение входят server platform, CPU, RAM, NVMe, NIC, optics, power supplies, cooling, software, support, логистика, монтаж и тестирование. У SXM GPU стоимость оценивают как часть HGX или DGX системы.
Для корректного сравнения коммерческих предложений запросите:
точный SKU ускорителя и сервера;
SXM или H200 NVL PCIe;
число GPU и topology;
рабочий power limit;
CPU, RAM и storage;
network adapters, cables и optics;
software licenses и support term;
срок, гарантию и программу приемки.
Типичные ошибки
Считать H200 NVL и SXM одной взаимозаменяемой картой.
Искать отдельную «H200 PCIe», не уточняя обозначение NVL.
Планировать установку SXM в обычный PCIe-сервер.
Считать 141 ГБ полностью свободными приложению.
Складывать VRAM нескольких GPU без model parallelism.
Оценивать LLM по peak FP8 с sparsity.
Не проверять NVLink bridge и slot spacing.
Устанавливать пассивную 600-Вт карту без квалифицированного airflow.
Не анализировать NUMA и PCIe topology.
Сравнивать H100 и H200 без одинакового workload.
Покупать 8-GPU узел для немасштабируемого приложения.
Не согласовывать power и cooling до поставки.
FAQ
Что такое NVIDIA H200?
Это data center GPU архитектуры Hopper с 141 ГБ HBM3e и bandwidth 4,8 ТБ/с для AI training, inference и HPC.
Сколько памяти у NVIDIA H200?
Обе основные версии, H200 SXM и H200 NVL, имеют 141 ГБ HBM3e на GPU.
Что такое NVIDIA H200 NVL?
Это dual-slot PCIe-версия H200 с TDP до 600 Вт и поддержкой 2-way или 4-way NVLink bridge в квалифицированных системах.
NVIDIA H200 PCIe и H200 NVL это одно и то же?
В актуальной официальной линейке PCIe form factor представлен как H200 NVL. При закупке нужно указывать полный SKU.
Чем H200 SXM отличается от H200 NVL?
SXM устанавливается на специализированную baseboard и используется с NVSwitch в HGX или DGX. NVL является PCIe-картой и дает более гибкие серверные конфигурации.
Что означает H200 SXM5?
Так обычно уточняют поколение SXM-модуля Hopper. Совместимость определяет конкретная HGX baseboard или готовая система, а не один разъем.
Сколько GPU в NVIDIA HGX H200?
Официальные server options включают платформы на четыре или восемь H200 SXM. Восьмипроцессорный узел имеет 1 128 ГБ суммарной HBM3e.
Что такое NVIDIA DGX H200?
Это готовая 8-GPU система NVIDIA с H200 SXM, NVSwitch, двумя Xeon, 2 ТБ RAM, локальными NVMe и высокоскоростной сетью.
Подходит ли H200 для LLM?
Да, особенно для memory-intensive inference, long context и моделей, которым тесно в 80 ГБ. Скорость и экономику проверяют на конкретной модели.
Как купить NVIDIA H200 без ошибки?
Зафиксировать NVL или SXM, точный сервер, topology, power, cooling, software, support и acceptance test. Не покупать отдельный SXM-модуль без совместимой платформы.
Что передать для подбора H200
Укажите модель и revision, precision, training или inference, context, batch, concurrency, peak VRAM, число параллельных задач, software stack и параметры площадки. Start Server поможет сравнить H200 SXM и NVL, подобрать сервер и подготовить нагрузочную приемку. Передать данные можно через контакты Start Server.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


