Идея выглядит логично: в сервере уже стоят NVIDIA A100, производительности перестало хватать — значит, покупаем H100 и меняем ускорители.
Иногда такой сценарий действительно возможен. Но начинать модернизацию со списка цен на H100 — плохая идея.
Сначала нужно ответить на два вопроса:
какие именно A100 установлены — PCIe или SXM и какая точная модель сервера используется.
От этих двух параметров зависит почти всё остальное.
Для PCIe-сервера переход на H100 иногда возможен в существующей платформе, если производитель официально валидировал такую конфигурацию. А вот A100 SXM и H100 SXM относятся уже к разным поколениям интегрированной GPU-платформы. Здесь замена ускорителей быстро превращается в вопрос совместимости HGX/baseboard, питания, охлаждения и interconnect.
Поэтому правильнее спрашивать не:
Влезет ли H100 вместо A100, а:
Короткий ответ: можно ли заменить A100 на H100
Ситуация | Предварительный вывод |
A100 PCIe, а точный server SKU официально поддерживает нужную H100 | Модернизация потенциально возможна |
Серия сервера упоминает H100, но конкретная конфигурация не проверена | Этого недостаточно |
H100 поддерживается, но допустимое количество GPU отличается | Нужен новый sizing workload |
Установлены A100 SXM/HGX | Это уже не обычная замена PCIe-карты |
Power или thermal limits не выполняются | Потребуются изменения платформы |
Есть старые CUDA extensions или собственные kernels | Нужен отдельный software audit |
Точная модель сервера неизвестна | Покупать H100 пока рано |
Первое правило модернизации получается довольно простым:
GPU нужно подбирать к существующей платформе, а не платформу мысленно подгонять под купленную GPU.
Сначала определите: A100 PCIe или A100 SXM
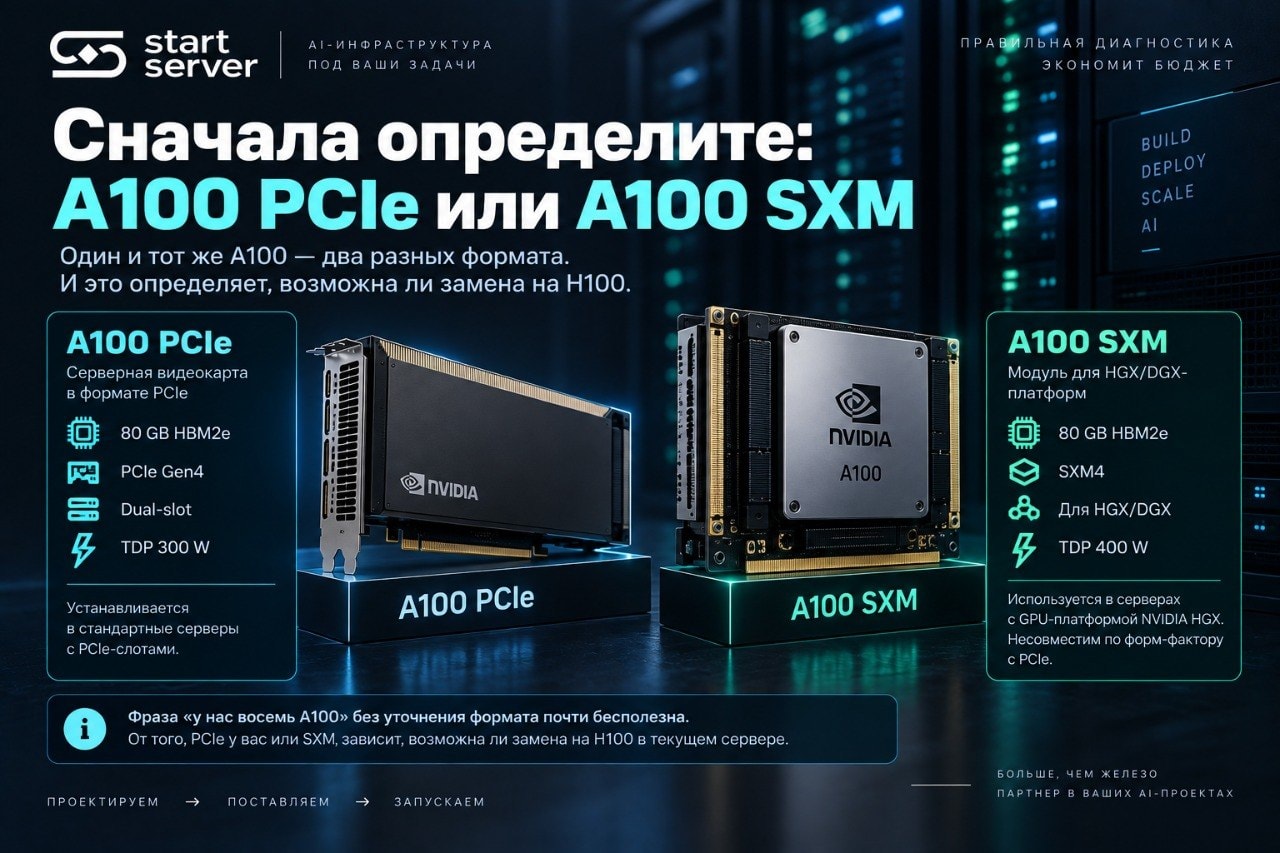
NVIDIA выпускает A100 80 GB в двух принципиально разных вариантах.
Для A100 PCIe NVIDIA указывает 80 GB HBM2e, PCIe Gen4, dual-slot исполнение и максимальный TDP 300 W.
A100 SXM также имеет 80 GB HBM2e, но является модулем для HGX/DGX-платформ. Для стандартного SXM-исполнения NVIDIA указывает 400 W TDP.
И это не косметическое различие.
Если у вас A100 PCIe
Нужно выяснить, допускает ли конкретный сервер H100 PCIe, в каком количестве и при каких ограничениях.
Если у вас A100 SXM
Проверять приходится уже поколение всей GPU-платформы.
Именно поэтому фраза «у нас восемь A100» для начала аудита почти бесполезна.
Нужно знать каких именно.
Почему A100 SXM → H100 SXM нельзя считать обычным drop-in upgrade
A100 относится к поколению SXM4, H100 — к SXM5. Одновременно NVIDIA увеличила NVLink bandwidth и существенно подняла максимально допустимую мощность GPU: для стандартной A100 SXM 80 GB указано 400 W, для H100 SXM — до 700 W. H100 также получила NVLink до 900 GB/s против 600 GB/s у A100.
Параметр | A100 SXM | H100 SXM |
Архитектура | Ampere | Hopper |
Поколение SXM | SXM4 | SXM5 |
GPU memory | 80 GB | 80 GB |
Max TDP | 400 W* | до 700 W |
NVLink | до 600 GB/s | до 900 GB/s |
Compute capability | 8.0 | 9.0 |
* Для стандартного A100 SXM 80 GB; NVIDIA отдельно описывает CTS-варианты с другим thermal envelope.
Разница между верхними пределами стандартных SXM GPU составляет:
700 − 400 = 300 W
на один ускоритель.
Для восьми GPU:
8 × 300 = 2400 W.
Но это важно трактовать правильно.
2,4 кВт — не прогноз того, насколько больше сервер будет постоянно потреблять из розетки. Это разница между суммами максимальных power envelopes восьми ускорителей.
Зато она очень хорошо показывает, почему старый HGX A100 нельзя автоматически считать подходящей платформой для восьми H100.
Меняются не только модули. Меняются требования к питанию, охлаждению и самой HGX-инфраструктуре.
С PCIe проще — но наличие слота ничего не доказывает
PCIe-сценарий выглядит гораздо привлекательнее.
A100 PCIe — серверная dual-slot карта с TDP 300 W. Для H100 PCIe 80 GB NVIDIA в product brief указывает dual-slot исполнение, PCIe Gen5 и максимальный TDP 350 W.
На бумаге возникает очевидная мысль:
Было PCIe, стало PCIe. Значит, заменяем.
Вот здесь как раз чаще всего и требуется документация производителя сервера.
Слоты в корпусе показывают, что физически можно разместить.
Qualification matrix показывает, что производитель действительно валидировал.
Это не одно и то же.
Реальный пример: четыре A100 не обязательно означают четыре H100
В актуальном Qualified Platform List Supermicro для SYS-621H-TN12R сейчас указано:
до 4 NVIDIA A100 PCIe;
до 3 NVIDIA H100 PCIe.
Причём ограничения отличаются и по CPU: для рассматриваемой A100-конфигурации Supermicro указывает CPU до 300 W при 25 °C, для H100 — до 250 W при той же максимальной температуре.
Это очень показательная ситуация.
Представим сервер с четырьмя A100.
Если просто купить четыре H100, исходя из количества занятых double-width слотов, можно обнаружить уже после покупки, что производитель валидировал другую конфигурацию.
Причём проблема не обязательно в том, что четвёртая карта физически «не помещается».
Причиной могут быть thermal limits, питание, CPU configuration или другие ограничения платформы.
Поэтому у вопроса совместимости есть два уровня:
Поддерживает ли сервер H100 вообще?
И только после этого:
Что проверить до покупки H100
Вот практический чек-лист, с которого имеет смысл начинать проект.
Что проверить | Почему это важно | Что нужно получить |
Точный server SKU | Названия серии недостаточно | Полную модель сервера |
Hardware revision | Возможны разные аппаратные версии | Ревизию, если применимо |
A100 PCIe или SXM | Определяет сценарий миграции | Точное исполнение |
Exact GPU SKU | 40/80 GB и исполнения различаются | Полную модель A100 |
H100 в OEM qualification list | Наличие слота ≠ поддержка | Подтверждение exact GPU |
Допустимое число H100 | Может отличаться от A100 | Валидированный GPU count |
CPU/TDP restrictions | GPU support может зависеть от CPU | Допустимую CPU-конфигурацию |
PSU | Нужно обеспечить платформу целиком | Валидированную схему питания |
GPU power delivery | Могут понадобиться другие штатные опции | Подходящие кабели/модули |
Cooling / airflow | Достаточного PSU мало | OEM thermal configuration |
Risers и topology | Влияют на расположение GPU | Поддерживаемую схему |
NVLink / NVSwitch | Важно для multi-GPU | Требуемую topology |
BIOS/BMC/firmware | H100 может требовать обновлений | Minimum versions OEM |
Driver/CUDA | Нужна Hopper support | Поддерживаемые версии |
Custom CUDA code | sm_80 и sm_90 — разные targets | PTX или новая сборка |
Workload benchmark | Совместимость ≠ результат | Проверку вашей задачи |
Эту таблицу можно использовать буквально как основу технического запроса поставщику.
Если половина полей пока неизвестна, обсуждать количество H100 ещё рано.
Почему нельзя просто сложить TDP и посмотреть на PSU
Сложить TDP полезно — но только как первый фильтр.
GPU не единственные потребители сервера. Есть CPU, память, NIC, накопители, вентиляторы, контроллеры. Кроме того, блоки питания обычно работают с резервированием, а производитель может устанавливать собственные лимиты на определённые сочетания CPU и GPU.
Пример Supermicro хорошо это показывает: ограничение для H100-конфигурации связано не только с самой GPU, но и с допустимым TDP процессоров.
Поэтому вопрос:
У нас два PSU по 2 кВт. Хватит?
нельзя решить одной арифметикой.
Нужен другой вопрос:
Валидировал ли OEM именно такую CPU + GPU + PSU + thermal configuration?
Охлаждение способно остановить апгрейд даже при достаточном питании
Серверные H100 PCIe используют пассивное охлаждение. Это не значит, что им не нужно охлаждение вообще.
NVIDIA прямо указывает, что пассивный радиатор H100 PCIe рассчитан на airflow самого сервера и карта должна эксплуатироваться в заданных thermal limits.
Поэтому при модернизации проверяются:
fan configuration;
направление и объём airflow;
соседние устройства;
CPU TDP;
температура входящего воздуха;
штатные thermal kits;
требования производителя сервера.
Иногда именно здесь заканчивается идея дешёвого апгрейда.
PSU способен отдать мощность — а корпус не способен штатно отвести тепло.
PCIe Gen4 и Gen5 тоже не дают ответа сами по себе
A100 PCIe относится к Gen4, H100 PCIe — к Gen5.
Но из этого нельзя автоматически вывести:
H100 не работает в сервере с предыдущим поколением PCIe.
И нельзя без OEM-документации утверждать противоположное:
Просто будет работать медленнее.
Для готового сервера нас интересует не теоретическая обратная совместимость интерфейса в вакууме, а поддержка конкретной accelerator configuration производителем системы.
Поэтому PCIe generation записываем в аудит, но не используем как единственный verdict.
Для multi-GPU нужно проверить topology, а не только число карт
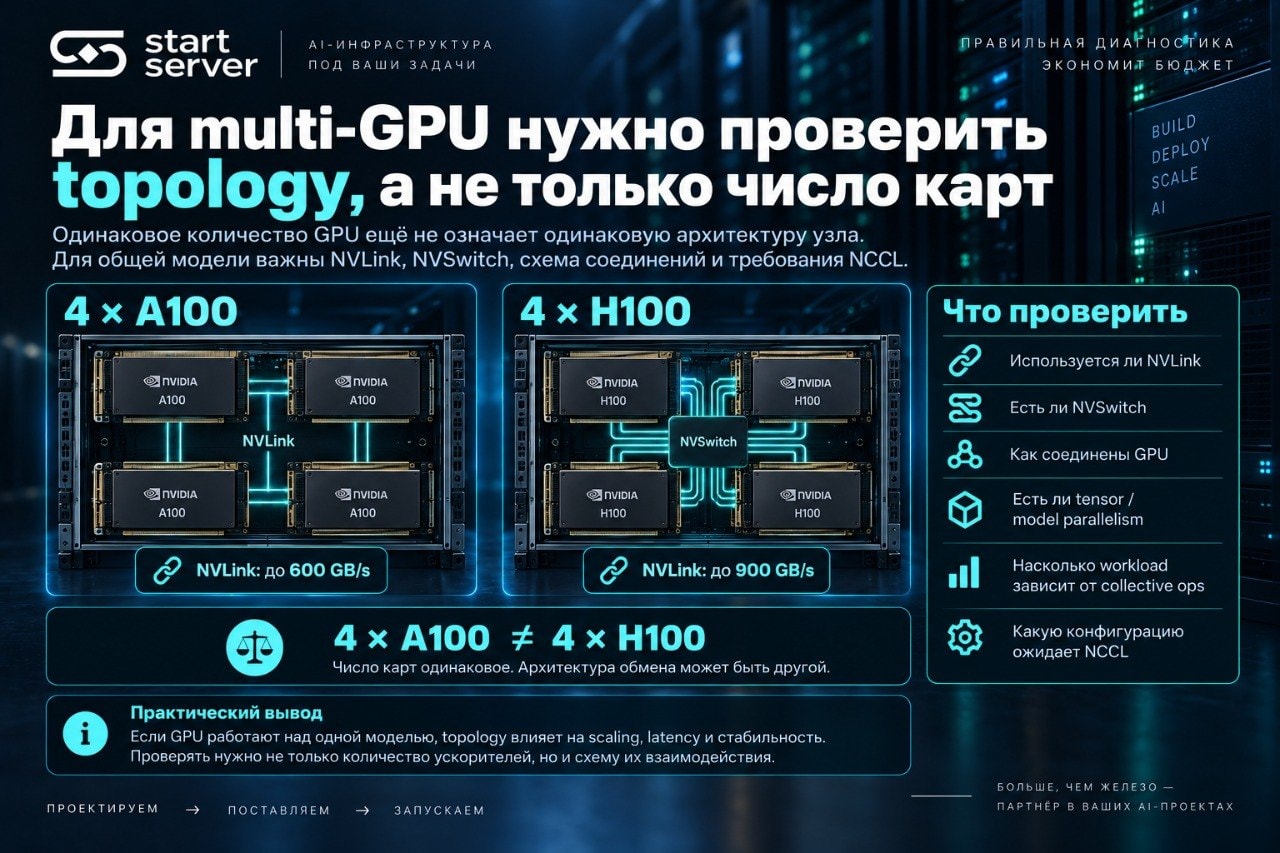
Если четыре A100 обслуживали четыре независимые задачи, изменение topology может быть не самым важным фактором.
Если же они вместе работают над одной моделью или training job, всё сложнее.
Нужно понимать:
используется ли NVLink;
присутствует ли NVSwitch;
как соединены GPU;
используется ли tensor/model parallelism;
насколько workload зависит от коллективных операций;
какую конфигурацию ожидает NCCL.
A100 и H100 относятся к разным поколениям NVLink. Для A100 NVIDIA указывает до 600 GB/s, для H100 SXM — до 900 GB/s.
Поэтому:
4 × A100 и 4 × H100
— это ещё не полное описание двух вычислительных узлов.
Число карт одинаковое. Архитектура обмена может быть другой.
С железом разобрались. Теперь — ПО
Переход A100 → H100 обычно не означает переписывание всего приложения.
Но и предполагать полную бинарную совместимость нельзя.
A100 имеет compute capability 8.0, H100 — 9.0. NVIDIA подтверждает это в актуальной таблице CUDA GPU Compute Capability.
Наиболее важная проблема возникает с собственными или старыми CUDA binaries.
Старый sm_80 binary может не работать на H100
CUDA-приложение может содержать готовый machine-code cubin и/или PTX.
NVIDIA Hopper Compatibility Guide устанавливает довольно конкретное правило:
cubin, собранный для compute capability 8.x, не поддерживается как бинарник на GPU compute capability 9.0.
PTX устроен иначе — он forward-compatible. Если в приложении присутствует подходящий PTX, CUDA Driver может JIT-скомпилировать его в код для Hopper. Если нет ни совместимого cubin, ни PTX, запуск kernel завершается ошибкой.
Практический пример гораздо понятнее документации.
Компания много лет использует собственный CUDA extension.
Его когда-то собрали только под:
sm_80.
На A100 всё работает.
После установки H100 этот компонент может потребовать пересборки.
А современный container, где есть Hopper-compatible binaries или подходящий PTX, способен перенестись значительно спокойнее.
Что проверить в программном стеке
Компонент | Что проверить |
NVIDIA Driver | Поддержку H100 |
CUDA | Версию runtime/toolkit |
PyTorch / TensorFlow | Поддерживаемую версию |
vLLM / TensorRT-LLM | Hopper support и используемые kernels |
Container image | CUDA base image и native libraries |
Custom CUDA extensions | sm_90 или подходящий PTX |
FlashAttention | Версию и поддержку Hopper |
Triton kernels | Architecture-specific assumptions |
NCCL | Совместимость и новая GPU topology |
MIG | Профили и orchestration |
Monitoring | GPU metrics и alerts |
Особенно внимательно стоит смотреть на то, что было собрано внутри компании и давно не обновлялось.
Нужно ли пересобирать всё ПО под H100
Нет.
NVIDIA прямо указывает, что приложение, содержащее подходящий PTX, может работать на Hopper без обязательной пересборки. А если приложение содержит только несовместимые cubin, rebuild уже понадобится.
Причём даже рабочий PTX — ещё не обязательно лучший вариант с точки зрения производительности.
NVIDIA отмечает, что JIT-компилированный PTX может не использовать все возможности новой архитектуры так эффективно, как native binary, собранный непосредственно под Hopper.
Поэтому миграцию разумно делить на две части.
Сначала — совместимость.
Приложение должно корректно работать.
Потом — оптимизация.
Только после этого имеет смысл смотреть на Hopper-specific возможности, FP8, batch size, kernels и новый режим parallelism.
Иначе можно потратить неделю на оптимизацию системы, которая ещё не прошла обычную функциональную приёмку.
nvidia-smi увидел H100 — апгрейд ещё не закончен
После физической установки ускорителей стоит пройти хотя бы четыре группы проверок.
Область | Что подтвердить |
Hardware | Все GPU видны, нет PCIe/NVLink ошибок, температуры и power limits нормальны |
Software | Driver, CUDA, framework, контейнеры и extensions работают |
Workload | Исходная задача запускается и выдаёт корректный результат |
Performance | Throughput, latency, VRAM, scaling и стабильность соответствуют цели |
И здесь есть очень важное правило.
Сравнивать A100 и H100 нужно на одной и той же задаче.
Если апгрейд делается для LLM inference:
тот же checkpoint;
та же precision;
тот же context;
тот же concurrency;
те же критерии latency/throughput.
Если для training — тот же training workload.
Иначе получится benchmark H100, но не проверка того, решила ли модернизация реальную проблему.
Когда существующий сервер имеет смысл оставить
После аудита обычно получается один из трёх сценариев.
Модернизация действительно возможна
Точная модель сервера поддерживает нужные H100, количество GPU подтверждено, питание и охлаждение соответствуют требованиям, программный стек переносим.
Тогда существующую платформу есть смысл рассматривать дальше.
H100 поддерживается, но сервер становится другим
Допустим, меняется допустимое количество GPU или thermal configuration.
Это уже не апгрейд «1 A100 → 1 H100».
Нужно заново проверить memory capacity, parallelism, производительность и экономику всего узла.
Фактически требуется новая платформа
Это особенно актуально для SXM/HGX, где между A100 и H100 меняется поколение интегрированной GPU-платформы.
В таком случае имеет смысл сравнивать:
стоимость и риски глубокой модернизации
против
готового H100-сервера нового поколения.
Не потому, что новый сервер автоматически лучше.
Просто именно эти два варианта уже являются технически сопоставимыми.
Аудит A100 → H100 за десять шагов
Зафиксируйте точный server SKU и hardware revision.
Определите исполнение и точный SKU установленных A100.
Найдите H100 в актуальной OEM qualification документации именно для этой платформы.
Проверьте допустимое количество H100 и связанные ограничения CPU/temperature.
Проверьте PSU, GPU power delivery, risers и cooling.
Для multi-GPU workloads зафиксируйте PCIe/NVLink/NVSwitch topology.
Проверьте необходимые версии BIOS, BMC и firmware.
Проведите аудит driver, CUDA, framework, контейнеров и custom CUDA binaries.
После установки сначала добейтесь функциональной совместимости и стабильности.
Повторите исходный workload и измерьте эффект модернизации.
Так можно ли заменить A100 на H100?
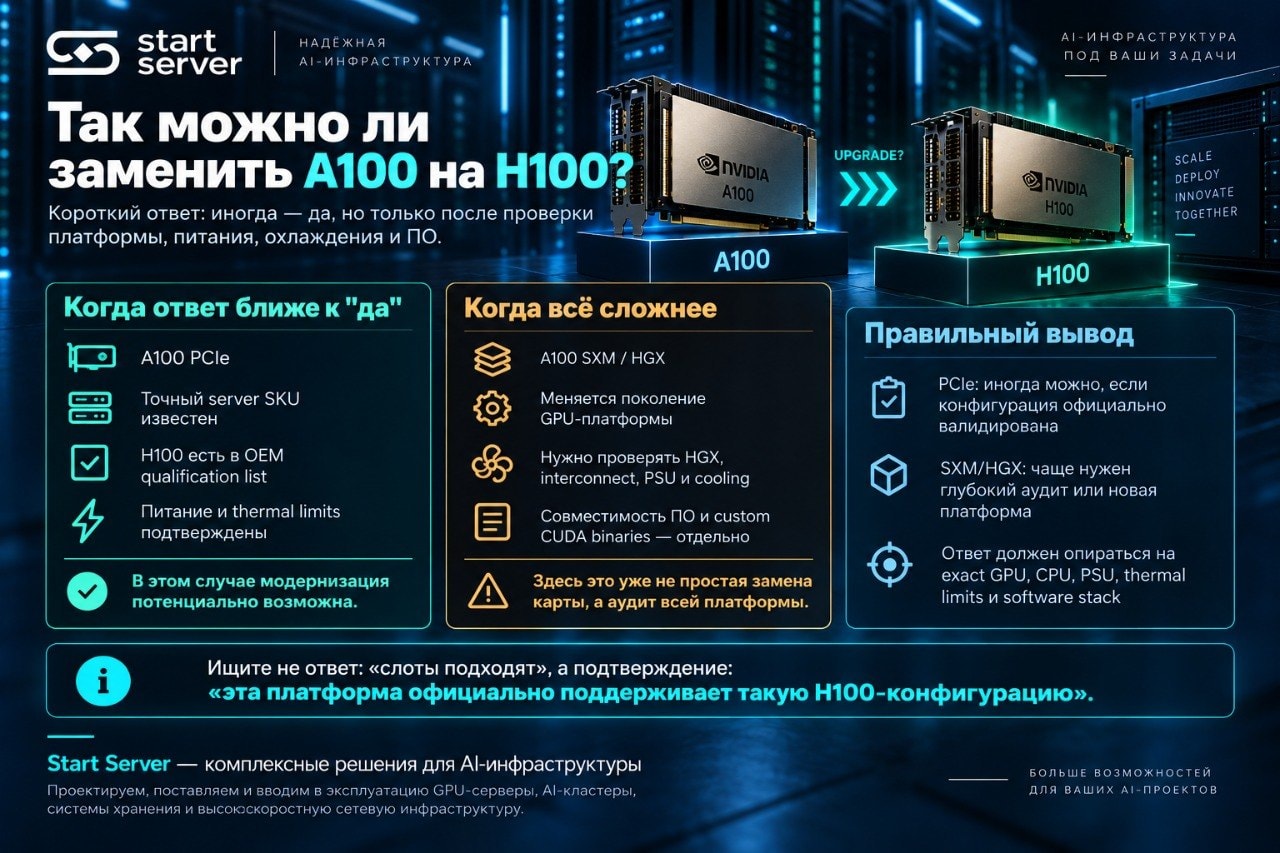
Если речь об A100 PCIe — иногда да. Но ответ должен подтверждаться документацией конкретного сервера: поддержкой exact GPU, нужного количества ускорителей, питания и thermal configuration.
Если речь об A100 SXM/HGX — задача существенно глубже. A100 и H100 относятся к разным поколениям SXM, отличаются power envelope и interconnect. Такой переход правильнее рассматривать как аудит GPU-платформы, а не простую замену модулей.
И отдельно проверяется ПО.
Современный CUDA-стек может перенестись достаточно спокойно. Старый собственный binary только под sm_80 — уже совсем другая история.
Поэтому перед заказом H100 полезно получить не ответ:
«В корпусе есть подходящие слоты».
А гораздо более конкретный:
«Эта модель сервера официально поддерживает именно такую H100-конфигурацию, при таких CPU, PSU и thermal limits, а текущий software stack проверен для Hopper».
Вот после этого модернизацию уже можно считать проектом, а не экспериментом.
Проверить возможность модернизации сервера
Для первичного аудита нужны производитель и точная модель сервера, установленное количество и исполнение A100, конфигурация CPU/PSU и текущая вычислительная задача.
По этим данным можно определить, поддерживает ли существующая платформа H100, сколько GPU допустимо установить и какие изменения потребуются по питанию, охлаждению, firmware и программному стеку.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


