Сервер для локального AI-помощника программиста нельзя корректно подобрать только по количеству разработчиков.
Команда из 100 человек может использовать AI в основном для короткого автодополнения кода. А может одновременно вести длинные диалоги по нескольким файлам, запускать агентные задачи и искать контекст в крупных корпоративных репозиториях. Численность команды одинаковая, а нагрузка на инфраструктуру — разная.
Поэтому расчёт лучше начинать не с GPU, а со сценариев работы:
активные разработчики → автодополнение → чат и правка кода → агентный режим → работа с репозиториями → смешанная нагрузка → сервер.
Почему число разработчиков не определяет сервер
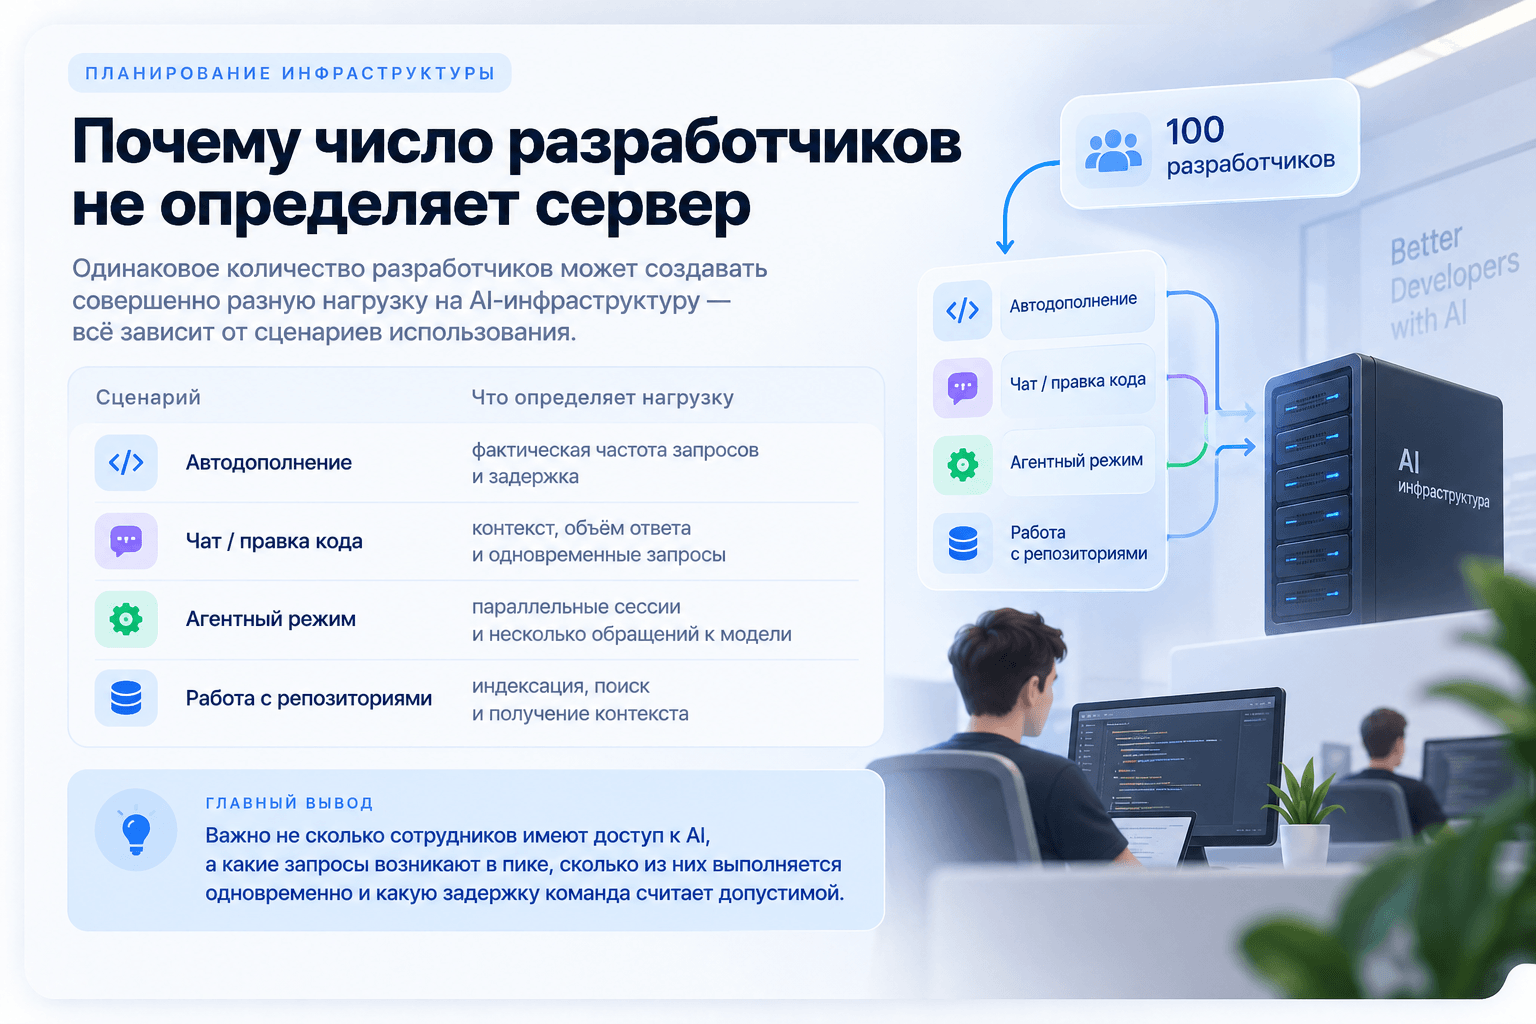
Фраза:
«У нас 100 программистов»
сама по себе почти ничего не говорит о требуемой производительности AI-инфраструктуры.
Из 100 человек одновременно активно использовать помощника могут 20, 50 или почти все. Кроме того, функции coding assistant создают разные типы нагрузки.
Сценарий | Что определяет нагрузку |
Автодополнение | фактическая частота запросов и задержка |
Чат / правка кода | контекст, объём ответа и одновременные запросы |
Агентный режим | параллельные сессии и несколько обращений к модели |
Работа с репозиториями | индексация, поиск и получение контекста |
Современные coding assistants могут даже использовать разные модели для этих функций. Например, Continue выделяет автодополнение в отдельную модельную роль и использует для него модели, обученные на специальной FIM-задаче — заполнении кода между фрагментами до и после курсора.
Поэтому первый полезный показатель — не общее число пользователей, а:
пиковое число одновременно активных разработчиков.
После этого нагрузку нужно разделить по сценариям.
Автодополнение и чат — разные нагрузки
Автодополнение кажется просто короткой версией обычного вопроса к LLM, но для инфраструктуры это не одно и то же.
При автодополнении разработчик печатает код и ожидает подсказку непосредственно в редакторе.
Здесь особенно важны:
частота запросов и время появления подсказки.
В чате пользователь может передать несколько файлов, длинную историю разговора или попросить сгенерировать большой фрагмент кода.
Здесь сильнее влияют:
размер входного контекста, объём ответа и число одновременно выполняющихся запросов.
Поэтому показатель:
«запросов к LLM в сутки»
слишком грубый.
Одно нажатие клавиши не равно одному запросу к модели
При расчёте автодополнения легко сделать ошибку:
разработчик печатает пять символов в секунду — значит создаёт пять запросов к LLM.
Реальный IDE-клиент работает иначе.
Например, Continue использует debounce: при быстром наборе запрос не отправляется после каждого нажатия. Также используется кеширование — ранее рассчитанная подсказка может быть показана повторно без нового обращения к модели.
Поэтому нагрузку нельзя считать по скорости печати.
Нужен другой показатель:
сколько запросов фактически дошло до model endpoint после всей клиентской логики.
Лучший источник этих данных — пилотная эксплуатация, логи model gateway или репрезентативный trace рабочей IDE.
Как оценить нагрузку автодополнения
Для первого приближения можно использовать:
Требуемый RPS автодополнения = активные пользователи × измеренные запросы на одного активного пользователя в секунду
Ключевое слово — измеренные.
Допустим, пилот показал:
40 одновременно активных пользователей;
в выбранный пиковый период — в среднем 0,2 фактического запроса в секунду на активного пользователя.
Предварительная оценка:
40 × 0,2 = 8 RPS.
Число 0,2 приведено только как пример арифметики и не является типичным значением для разработчика.
Почему tokens/s недостаточно для автодополнения
Предположим, сервер показывает:
100 generated tokens/s.
Означает ли это, что автодополнение будет комфортным?
Не обязательно.
Пользователь ждёт не паспортную скорость генерации, а появление готовой подсказки в редакторе.
Полный путь может выглядеть так:
IDE → выбор контекста → сеть → очередь inference → обработка prompt → генерация → постобработка → отображение подсказки.
Continue, например, может искать релевантные фрагменты кодовой базы до обращения к модели и выполняет фильтрацию и постобработку полученной подсказки перед показом пользователю.
Поэтому полезно разделять две величины.
Пользовательская задержка
Время от фактического запуска запроса автодополнения до появления готовой подсказки в IDE.
Задержка inference-сервера
Время внутри пути обслуживания модельного запроса: очередь, обработка контекста, получение первого токена и последующая генерация.
Быстрый inference ещё не гарантирует такую же быструю подсказку в IDE, если задержка возникает на других этапах.
TTFT, генерация и очередь — разные показатели
Для LLM-serving полезно различать несколько составляющих задержки.
TTFT, Time to First Token — время до первого токена.
Inter-token latency / TPOT — скорость появления последующих токенов.
Queue time — сколько запрос ожидал начала обработки.
vLLM, например, отдельно предоставляет метрики TTFT, inter-token latency, времени на output token, queue time, размеров prompt и generation, числа работающих и ожидающих запросов и использования KV-cache.
Это позволяет отличить:
сама модель отвечает медленно
от:
запрос долго ждёт своей очереди.
Есть ещё одно важное ограничение: названия latency-метрик не полностью стандартизованы между инструментами. В vllm bench serve, например, TTFT измеряется на стороне benchmark-клиента от отправки запроса до первого полученного output. Поэтому при сравнении результатов нужно смотреть не только на название метрики, но и на точки её измерения.
Как считать чат и правку кода
Для чата и генерации изменений профиль ближе к обычному production LLM inference.
Перед выбором сервера полезно собрать:
Параметр | Что измеряем |
Пиковая частота запросов | запросов/с или запросов/мин |
Конкурентность | одновременно выполняющиеся запросы |
Входной контекст | input tokens |
Ответ | output tokens |
TTFT | время до первого токена |
Генерация | скорость последующего ответа |
Полная задержка | время выполнения запроса |
Количество разработчиков и здесь остаётся лишь исходной бизнес-величиной.
Почему одного среднего контекста недостаточно
Coding-запросы могут сильно отличаться.
Один пользователь спрашивает:
объясни эту функцию.
Другой:
сравни реализацию в пяти файлах и предложи рефакторинг.
Третий продолжает длинный диалог, в который уже вошли инструкции и найденные фрагменты репозитория.
Поэтому показатель:
средний prompt — 4000 токенов
может скрывать тяжёлую часть нагрузки.
Для pilot полезнее фиксировать распределение, например:
p50 input tokens;
p95 input tokens;
p50 output tokens;
p95 output tokens.
Или заранее разделить запросы на несколько классов.
В нагрузочном тесте нужно воспроизводить не только средний запрос, но и тяжёлую часть рабочего профиля.
Почему очередь нужно проверять под нагрузкой команды
Сервер может быстро отвечать одному разработчику и заметно замедляться при нескольких десятках одновременных обращений.
При этом сама скорость вычисления модели не обязательно изменилась — часть запросов просто ждёт свободной ёмкости.
vLLM отдельно показывает количество работающих и ожидающих запросов, queue time и использование KV-cache.
Поэтому тест:
один пользователь → максимальные tokens/s
не подтверждает производительность сервера для команды.
Нужен benchmark при проектной конкурентности.
Агентный режим — это не один запрос
Агентный режим меняет модель нагрузки ещё сильнее.
Пользователь может поставить задачу:
найди причину ошибки, исправь код и запусти тесты.
После этого выполняется не один prompt-response.
Упрощённая цепочка может выглядеть так:
В Continue Agent mode модель получает инструменты для работы с кодовой базой, а результат вызова инструмента автоматически возвращается ей как новый контекст, после чего модель может продолжить работу.
Следовательно:
одна агентная задача не равна одному LLM-запросу.
Для расчёта здесь удобнее использовать агентную сессию.
Как измерять агентную нагрузку
Для pilot стоит выбрать несколько повторяемых типов задач.
Класс задачи | Что считается завершением |
Исправление бага | нужные тесты проходят |
Небольшой рефакторинг | изменения применены, проверки проходят |
Создание тестов | тесты созданы и выполняются |
Анализ ошибки | получен проверяемый вывод |
По каждой сессии фиксируют:
Параметр | Значение |
Обращений к LLM | |
Вызовов инструментов | |
Входных токенов | |
Выходных токенов | |
Общее время | |
Результат задачи | success / fail |
После накопления данных можно считать p50/p95.
Не стоит заранее назначать:
одна агентная задача = пять вызовов модели
или:
одна сессия = 20 000 токенов.
Медленный агент не всегда означает слабую GPU
Агентная сессия может ждать не только LLM.
Время может уходить на:
чтение файлов;
поиск;
запуск тестов;
сборку;
работу внешнего инструмента;
файловые операции;
выполнение команд.
Поэтому:
агент выполняет задачу пять минут
ещё не означает, что серверу нужна более мощная GPU.
Для диагностики полезно разделять как минимум:
model time
и:
tool / execution time.
Если GPU и inference pool большую часть сессии свободны, ограничение находится в другом месте.
Почему агентные задачи могут мешать автодополнению
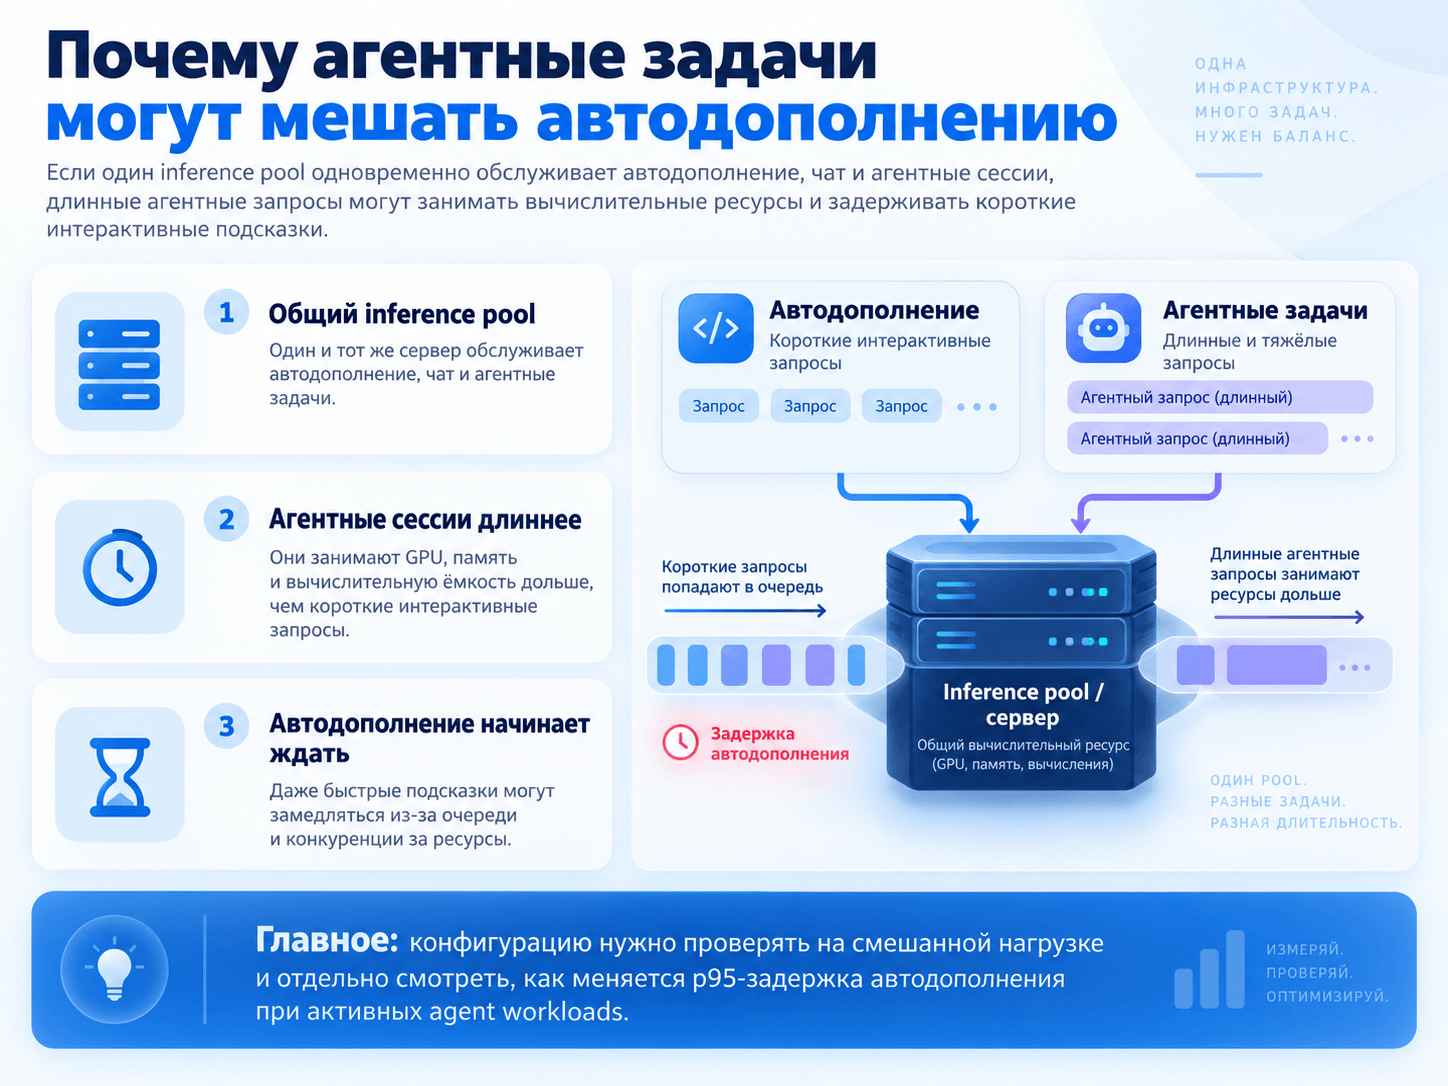
Представим, что один inference pool одновременно обслуживает:
частые короткие запросы автодополнения;
длинные диалоги;
несколько тяжёлых агентных сессий.
Даже если каждый режим отдельно проходит benchmark, при совместной работе ситуация может измениться.
Длинные запросы занимают вычислительную ёмкость и память, а короткие интерактивные запросы начинают ждать.
Поэтому отдельные тесты — это только первый этап.
Особенно важно смотреть, как меняется пользовательская p95-задержка автодополнения в момент активных chat и agent workloads.
Размер репозитория не равен контексту модели
Ещё одна частая ошибка:
у нас миллионы строк кода — значит модель должна получить весь репозиторий в prompt.
Repository-aware помощник обычно работает иначе.
Упрощённая схема:
репозиторий → индекс / поиск → выбранный контекст → prompt → модель.
Например, Continue описывает custom code RAG через разбиение кода на части, создание embeddings, сохранение их в векторной базе и последующий поиск релевантных фрагментов.
Следовательно:
размер репозитория ≠ размер одного LLM-контекста.
Большая кодовая база создаёт отдельную нагрузку на индексацию и поиск, но не обязана целиком помещаться в context window.
Индексация репозитория — отдельная нагрузка
Конкретная реализация зависит от выбранного coding assistant.
Один стек может использовать:
embeddings и vector search;
текстовый индекс;
code graph;
комбинацию нескольких механизмов.
Поэтому нельзя универсально утверждать:
индексирование кода — это GPU embedding workload.
Например, в Continue один из вариантов code RAG действительно строится как:
chunking → embeddings → запись в vector database.
Но это лишь одна архитектура.
Для sizing нужно сначала определить фактический repository/indexing layer проекта.
Первичная индексация и обновления — разные нагрузки
Полное построение индекса и его дальнейшее обновление следует считать отдельно.
Первичная индексация
Вопрос:
за какое время полный рабочий индекс должен быть готов?
Обновления
Вопрос:
насколько быстро изменения в коде должны становиться доступными для поиска и AI-контекста?
Continue в своём примере code RAG отдельно описывает incremental indexing: при изменении файла в production-варианте можно переиндексировать изменённый файл, а не всю кодовую базу.
Как считать первичную индексацию
Единица зависит от конкретной архитектуры.
Для embedding-based pipeline это могут быть:
файлы;
chunks;
tokens.
Тогда предварительная формула:
Требуемая скорость индексации = объём для индексации / доступное окно
Но для другого типа индекса единица будет другой.
Практическая таблица:
Параметр | Значение |
Репозиториев | |
Индексируемая область | |
Тип индекса | |
Файлов / chunks / tokens | |
Окно первичной индексации | |
Измеренное время построения | |
Объём обновлений | |
Время появления обновлений | |
Размер индекса |
Repository workload не стоит искусственно переводить в tokens/s основной LLM.
Нужен ли отдельный сервер для автодополнения
Универсального ответа нет.
Возможны разные архитектуры.
Общий inference pool
Автодополнение, чат и агентные запросы используют общие ресурсы.
Это проще с точки зрения инфраструктуры.
Но нужно проверить, сохраняется ли требуемая скорость автодополнения под длинными запросами.
Разделение нагрузок
Например:
автодополнение → отдельная специализированная модель
чат и агенты → другой inference pool
Технически разные модели для разных ролей вполне возможны: Continue, например, отдельно настраивает autocomplete-модель.
Но из этого не следует, что разделение обязательно.
Критерий выбора — результаты смешанного нагрузочного теста.
Как проверить смешанную нагрузку
Финальный benchmark должен воспроизводить реальную работу команды.
В один и тот же период происходят:
Полезно контролировать:
Режим | Что проверяем |
Автодополнение | фактический RPS + p95 пользовательской задержки |
Чат / правка | конкурентность + TTFT + генерация |
Агент | параллельные сессии + время выполнения |
Репозиторий | задержка поиска + обновления индекса |
Вся система | очереди, ошибки и загрузка ресурсов |
Если каждый режим отдельно проходит тест, но при запуске агентов автодополнение начинает заметно задерживаться, конфигурация ещё не прошла production-проверку.
Что означает «локальный AI» для кода компании
Self-hosted inference позволяет направлять запросы к собственной модели и контролируемому endpoint. Continue, например, поддерживает подключение самостоятельно размещённых моделей.
Но этого недостаточно, чтобы автоматически утверждать:
исходный код никогда не передаётся за пределы инфраструктуры.
В систему могут входить и другие компоненты:
embeddings;
reranker;
repository search;
telemetry;
MCP и другие инструменты;
logging;
интеграции с внешними сервисами.
Показательно, что для offline-сценария Continue имеет отдельную конфигурацию, где кроме локального model provider требуется отдельно учитывать сетевую работу самого клиента.
Кроме того, даже пример custom code RAG может использовать внешний endpoint для embeddings, хотя основная chat-модель при этом может быть локальной.
Поэтому корректный тезис звучит так:
Что проверить для закрытого контура
До внедрения полезно составить карту потоков данных.
Компонент | Что проверить |
Chat-модель | куда передаётся prompt |
Автодополнение | какой endpoint получает код |
Embeddings | локальный или внешний сервис |
Reranker | где выполняется |
Поиск по репозиторию | где находится индекс |
MCP / tools | какие внешние системы вызываются |
Telemetry | что и куда передаётся |
Logging | сохраняются ли prompts и код |
Аутентификация | кто имеет доступ |
Интеграция с Git-системой | как помощник получает код |
Только после проверки всей схемы можно формулировать конкретные требования к изоляции.
Калькулятор нагрузки AI-помощника программиста
Для предварительного sizing удобно собрать четыре профиля.
1. Команда
Параметр | Значение |
Всего разработчиков | |
Активно в пике | |
IDE / клиенты | |
Пиковый рабочий интервал |
2. Автодополнение
Параметр | Значение |
Активных пользователей в пике | |
Фактический aggregate RPS | |
Input tokens p50/p95 | |
Output tokens p50/p95 | |
Целевая p95 пользовательской задержки | |
Измеренная p95 задержки | |
Результат | PASS / FAIL |
Для первого приближения:
Для окончательного теста предпочтительнее использовать фактический командный trace.
3. Чат / правка кода
Параметр | Значение |
Пиковая частота запросов | |
Пиковая конкурентность | |
Input tokens p50/p95 | |
Output tokens p50/p95 | |
TTFT target | |
Generation target | |
Полная задержка | |
Результат | PASS / FAIL |
4. Агентный режим
Параметр | Значение |
Классы задач | |
Сессий/час | |
Параллельных сессий в пике | |
LLM calls/session p50/p95 | |
Tool calls/session p50/p95 | |
Input/output tokens/session | |
Model time | |
Tool/execution time | |
Полное время сессии | |
Критерий успеха | |
Результат | PASS / FAIL |
5. Репозитории
Параметр | Значение |
Репозитории | |
Индексируемая область | |
Тип индекса | |
Окно первичной индексации | |
Объём обновлений | |
Задержка поиска | |
Размер индекса | |
Результат | PASS / FAIL |
После этого отдельные профили объединяются в смешанный тест.
Как провести benchmark автодополнения
Лучший вариант — использовать traces пилотной группы.
Нужно сохранить:
фактический поток запросов после debounce и cache;
число активных пользователей;
распределение input/output;
модель и её версию;
inference backend;
клиент и его настройки.
Измерять следует как минимум:
aggregate RPS;
p50/p95/p99 пользовательской задержки;
серверный TTFT;
queue time;
ошибки;
загрузку ресурсов;
проектный критерий качества подсказок.
Как проверить чат и правку кода
Нагрузочный профиль должен включать не только средний запрос, но и несколько типовых классов:
короткие;
обычные;
тяжёлые с большим контекстом.
Измеряются:
конкурентность;
распределение input/output;
TTFT;
скорость генерации;
полная задержка;
queue time;
критерий качества.
При сравнении TTFT разных инструментов необходимо убедиться, что показатель измеряется от одинаковых точек.
Как проверить агентный режим
Agent benchmark должен измерять не отдельный запрос, а выполнение задачи целиком.
Для каждой категории фиксируют:
продолжительность сессии;
обращения к модели;
вызовы инструментов;
суммарный input/output;
время модели;
время внешних действий;
ошибки и повторы;
успешность результата.
Практический capacity-вопрос звучит так:
сколько параллельных агентных сессий система может поддерживать при допустимом времени выполнения и требуемом качестве?
Почему качество тоже входит в sizing
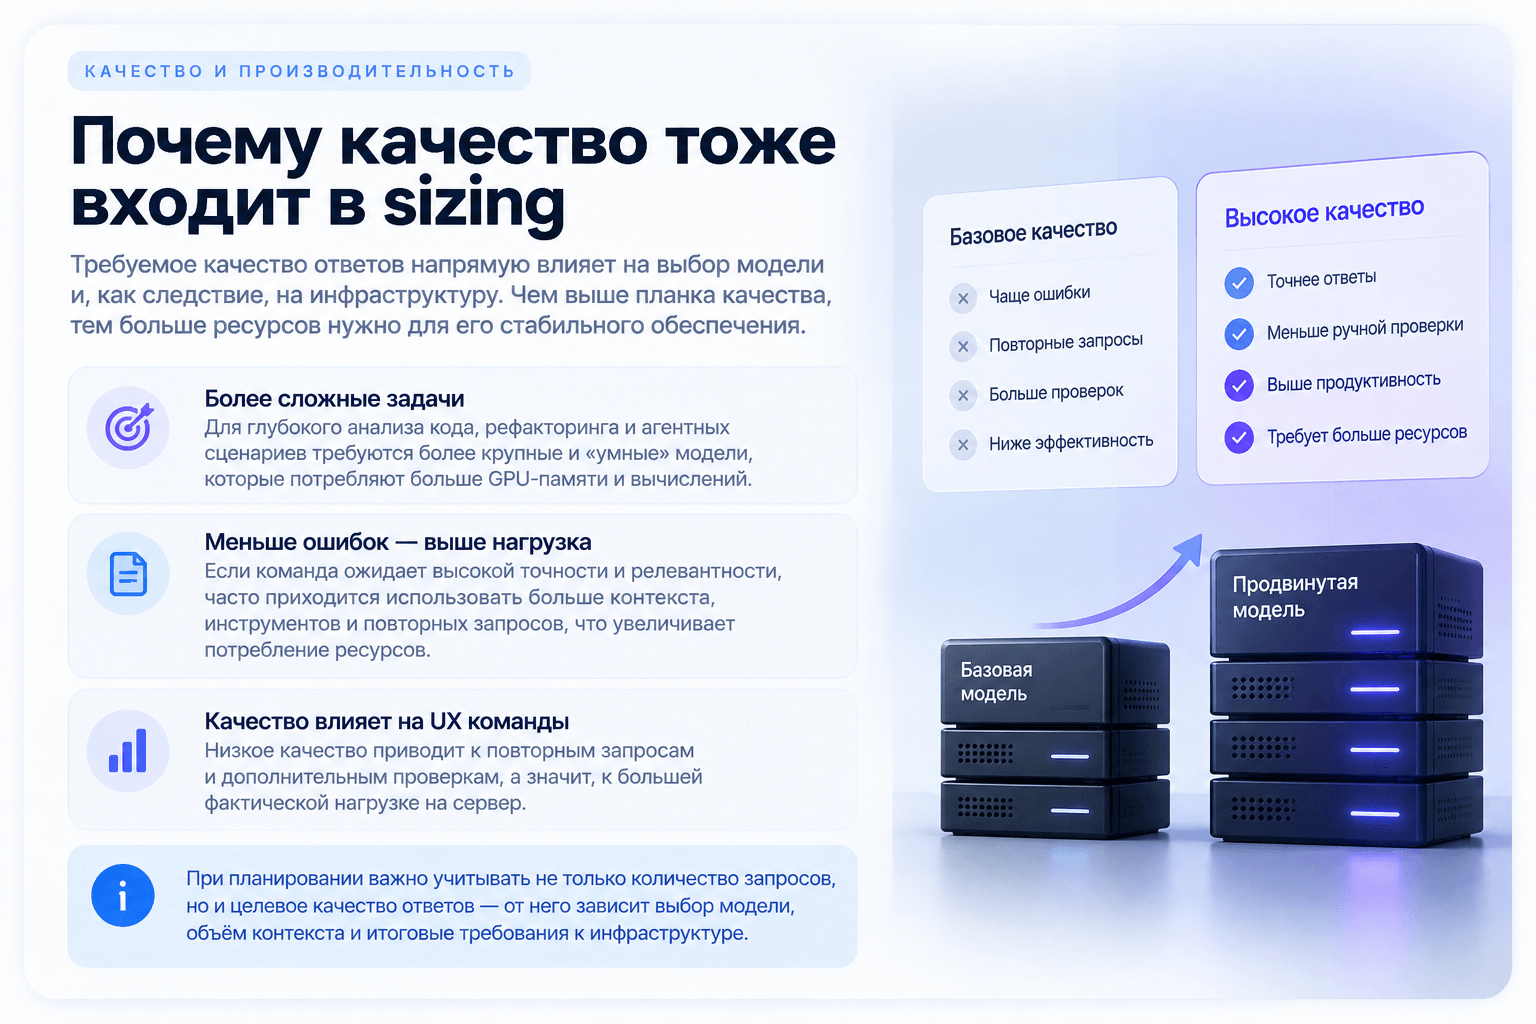
Самое быстрое автодополнение бесполезно, если разработчики регулярно отклоняют подсказки.
Высокий throughput чата также не помогает, если модель плохо понимает используемые технологии или внутренние API.
Поэтому performance benchmark нужен вместе с проектным quality gate.
Например:
Режим | Возможный критерий |
Автодополнение | доля полезных или принятых подсказок |
Чат | корректность ответов на тестовый набор задач |
Правка кода | корректность изменений |
Агент | успешное завершение определённого класса задачи |
Retrieval | релевантность найденного кода |
Здесь нет универсального процента, который подходит всем компаниям.
Как найти узкое место
Если система не проходит нагрузочный тест, симптомы помогают выбрать направление проверки.
Симптом | Что проверить |
Автодополнение быстрое в одиночку и медленное в пик | очередь и конкурентность |
tokens/s высокие, подсказка появляется поздно | TTFT, очередь, retrieval и клиентский путь |
Чат замедляется на больших запросах | входной контекст и prefill |
Агенты ухудшают автодополнение | общий inference pool и планирование |
Агент медленный при свободной GPU | tools, тесты, CPU, storage |
Первичная работа с repo долгая | построение индекса |
После больших merge возникает пик | обновление индекса |
GPU свободна, поиск кода медленный | repository/search layer |
Вторая GPU почти не изменила задержку | bottleneck вне model inference |
Таблица диагностическая: она показывает, что проверять дальше, а не автоматически доказывает причину.
Какие данные нужны для подбора сервера
Перед переходом к конкретной конфигурации полезно заполнить итоговый профиль:
Данные проекта | Значение |
Всего разработчиков | |
Пиковое число активных | |
Aggregate autocomplete RPS | |
Autocomplete p95 user latency | |
Chat concurrency | |
Chat input/output tokens | |
TTFT target | |
Параллельные agent sessions | |
LLM calls/session | |
Tokens/session | |
Repository scope | |
Тип индекса | |
Окно initial indexing | |
Update workload | |
Модели и версии | |
Inference backend | |
Требования к изоляции | |
Смешанный профиль нагрузки |
После заполнения вопрос:
Какая GPU нужна для 100 разработчиков?
можно заменить на измеримые требования:
Нужно обслуживать X фактических запросов автодополнения в секунду при заданной пользовательской p95-задержке, Y одновременных chat-запросов с определённым контекстом и Z агентных сессий, одновременно поддерживая поиск по корпоративным репозиториям.
Главное
Сервер для локального AI-помощника программиста нельзя рассчитывать только по количеству разработчиков или размеру coding-модели.
Нужно отдельно описать четыре нагрузки.
Автодополнение — фактический поток запросов и полная задержка до появления подсказки в IDE.
Чат и правка кода — контекст, конкурентность, TTFT и объём генерации.
Агентный режим — параллельные сессии, несколько model/tool cycles и полное время выполнения задачи.
Работа с репозиториями — первоначальная индексация, обновления и поиск релевантного кода.
Сначала эти профили проверяют отдельно.
После этого сервер тестируют на смешанной нагрузке, которая действительно отражает рабочий день команды.
Именно такой benchmark позволяет обоснованно ответить на вопрос:
сколько разработчиков сможет комфортно работать с системой?
Паспортный tokens/s одной GPU такого ответа не даёт.
Получить консультацию
Оставьте заявку и наш менеджер свяжется с вами для консультации


